posts/forgestencil-agent-speedup-harness.md
ForgeStencil 最狠的,不是 97.7 倍加速
Agent 最容易作弊的地方,不是写代码,是给自己打分。
改完一段 CUDA,挑一个对自己有利的输入,避开已经高度优化的基线,跑一轮最漂亮的数字,再把失败样本安静地塞回日志深处。一条「性能提升 38 倍」的喜报就这么长出来了。
代码可能没撒谎,图表也没撒谎。只是测量方法替它撒了。
面壁智能和 OpenBMB 刚开源的 ForgeStencil,最显眼的成绩确实很凶。两个 LLM Agent 自动研究、生成、集成 CUDA 模板算子,跑进 100 个油气勘探、电磁仿真、医学影像、气候模拟和天体物理软件,中位端到端加速 1.41 倍,几何平均 2.05 倍,单个应用最高 97.7 倍。
好家伙,AI 不只帮程序员补函数,已经开始进科学计算软件里拧 GPU 的螺丝了。
但我把官方中文说明来回看了一遍,真正让我觉得有点子牛逼的,并不是 97.7 倍,而是另外几行很不适合做宣传海报的设计。
同一个二进制,单开关切换原版和优化版。用应用自己的正确性检查。原版与优化版交错运行,多轮取中位。所有标准算例都算,最终报几何平均。任意一项不满足,结果就标成未验证,不进成绩单。
这套东西不负责让 Agent 更聪明。
它负责让 Agent 没那么容易骗过人,也没那么容易骗过自己。
两个 Agent 很热闹,真正托底的是那套脚手架
ForgeStencil 把任务拆给两个角色。
Kernel Agent 负责研究模板算子的优化策略。这里的 Stencil,也就是模板计算,会反复用一个数据点周围的邻居更新它,在流体模拟、天气预测、地震分析这类科学计算里到处都是。它不只改一行 CUDA,而是在规划、写代码、性能分析之间循环,尝试 tiling、算子融合、内存布局、占用率和 host 侧重构。
App Agent 再把这些成果接进真实软件。它要找到热点,选择合适的优化手法,生成应用专用算子,验证数值正确,再完成集成。项目把每个应用需要的来源记录、拉取脚本、补丁和测量配置放进独立目录,100 个应用包都能沿着同一条路径复现。
听起来像一个很标准的多 Agent 故事,一个负责研究,一个负责交付,彼此接力,收工时皆大欢喜。
可多 Agent 只是舞台上的演员。真正决定这场戏能不能上生产的,是台下那套 harness,也就是让 Agent 真正干活的工程脚手架。
它保存来源,应用来自哪里,基于哪个版本,原始字节的哈希是什么。它保存变更,第三方源码不直接塞进仓库,只留拉取脚本和集成补丁。它规定切换方式,原版和优化版只能通过一个 USE_OURS 开关分开。它规定如何测量,两个路径在同一程序里交错跑,减少节点负载、时钟波动和共享 GPU 抖动造成的偏差。
更关键的是,它不另造一套看起来很专业的正确性测试,而是调用真实程序自己的校验与计时器。端到端测量脚本负责把这些规则变成固定流程,Agent 不能因为某个结果不好看,就临时换一把尺子。
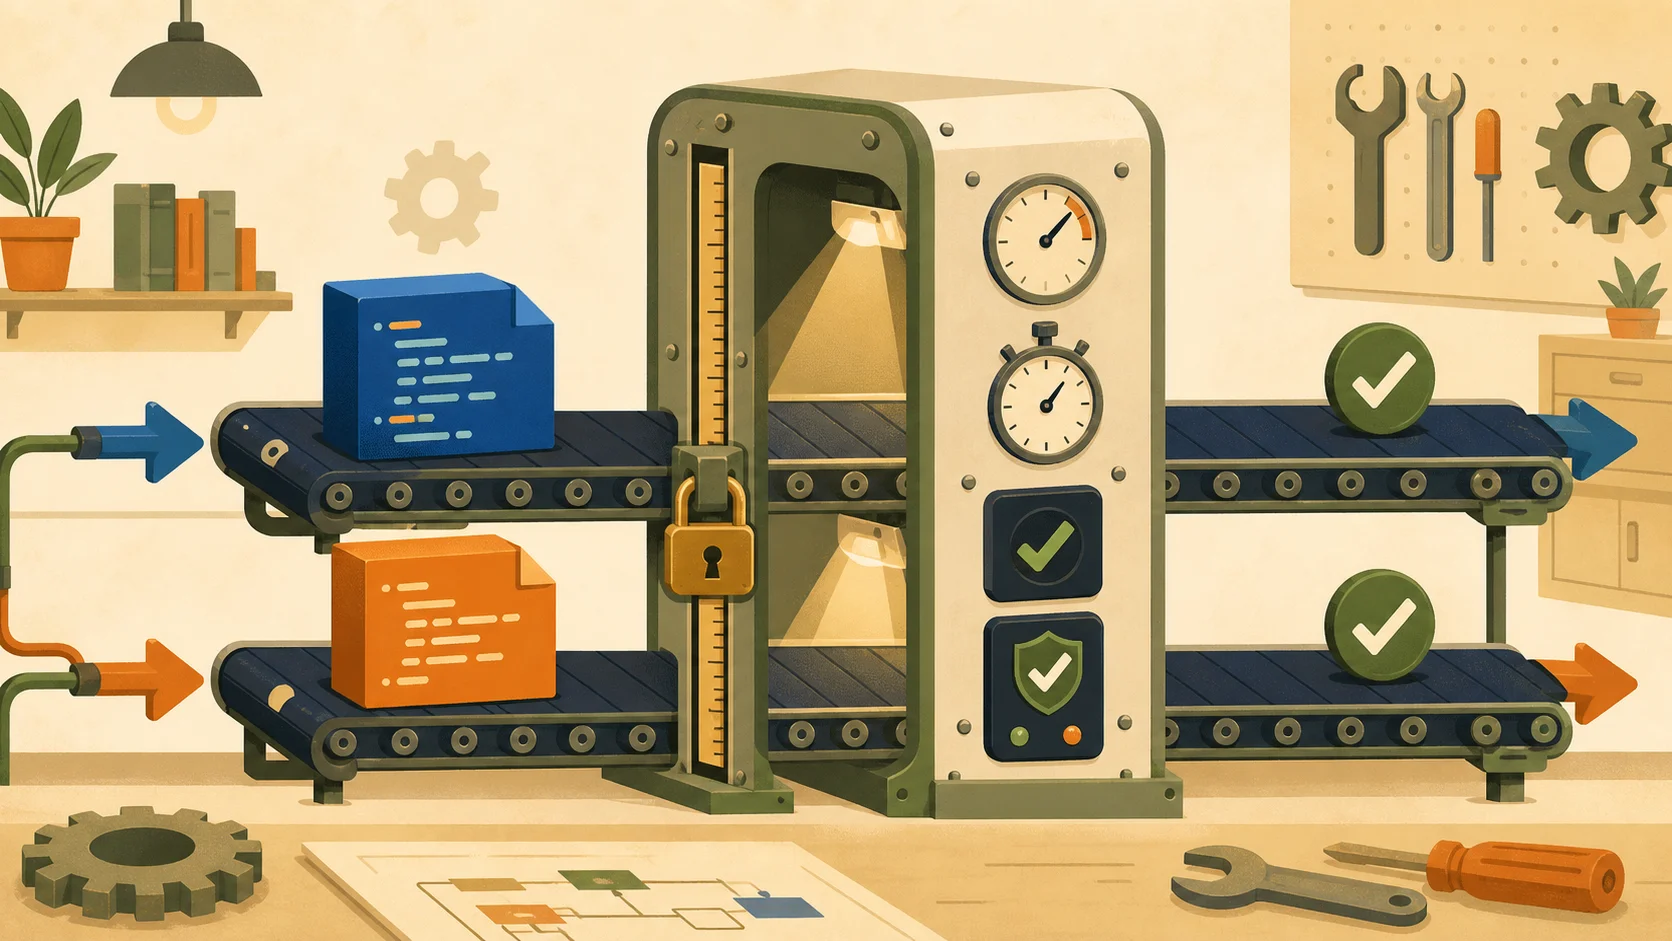
图一,同一把尺子、同一套闸门,Agent 只能改代码,不能改评分方法
很多朋友可能不知道,性能优化里最危险的 bug,往往不是程序崩了,而是程序跑得飞快,答案却悄悄错了一点。
科学计算更麻烦。你把浮点精度换掉,把边界条件削掉,把迭代次数偷掉,数字能漂亮得像开了挂。若验证只盯着吞吐,不盯数值语义,Agent 越会优化,事故可能越隐蔽。
ForgeStencil 的做法很朴素。原程序认什么叫对,优化版就得过同一套检查。若某个上游自检只允许一定误差,它就遵守那套容差。若检查失败,这条加速不算。
不是哥们,这才是把 Agent 接进工程系统时该有的顺序。
先定义什么叫不能错,再让它放开手脚。
97.7 倍很爽,1.00 倍才让成绩单可信
营销稿最爱拿最大值。
ForgeStencil 的 100 个应用里,pathfinder 加速 97.7 倍,bspline_vgh 达到 58.4 倍,haccmk 达到 36.2 倍。数字很炸,不过项目自己也把原因说得很直白,这些巨大收益大多来自原程序存在结构性空间,比如太多细碎 kernel 启动、host 端频繁同步、占用率不足,或者能够做大规模融合。
它不是发明了一颗普适的魔法算子,扔进任何代码都能起飞。
面对已经被厂商 SDK 或专家手工调过的代码,结果通常只有 1.0 到 1.5 倍。sw4lite 是 1.00 倍,hpgmg_fv 是 1.02 倍,cloverleaf 是 1.01 倍。100 个应用里,有 43% 达到 1.5 倍以上,也有 11% 连 1.05 倍都没到。
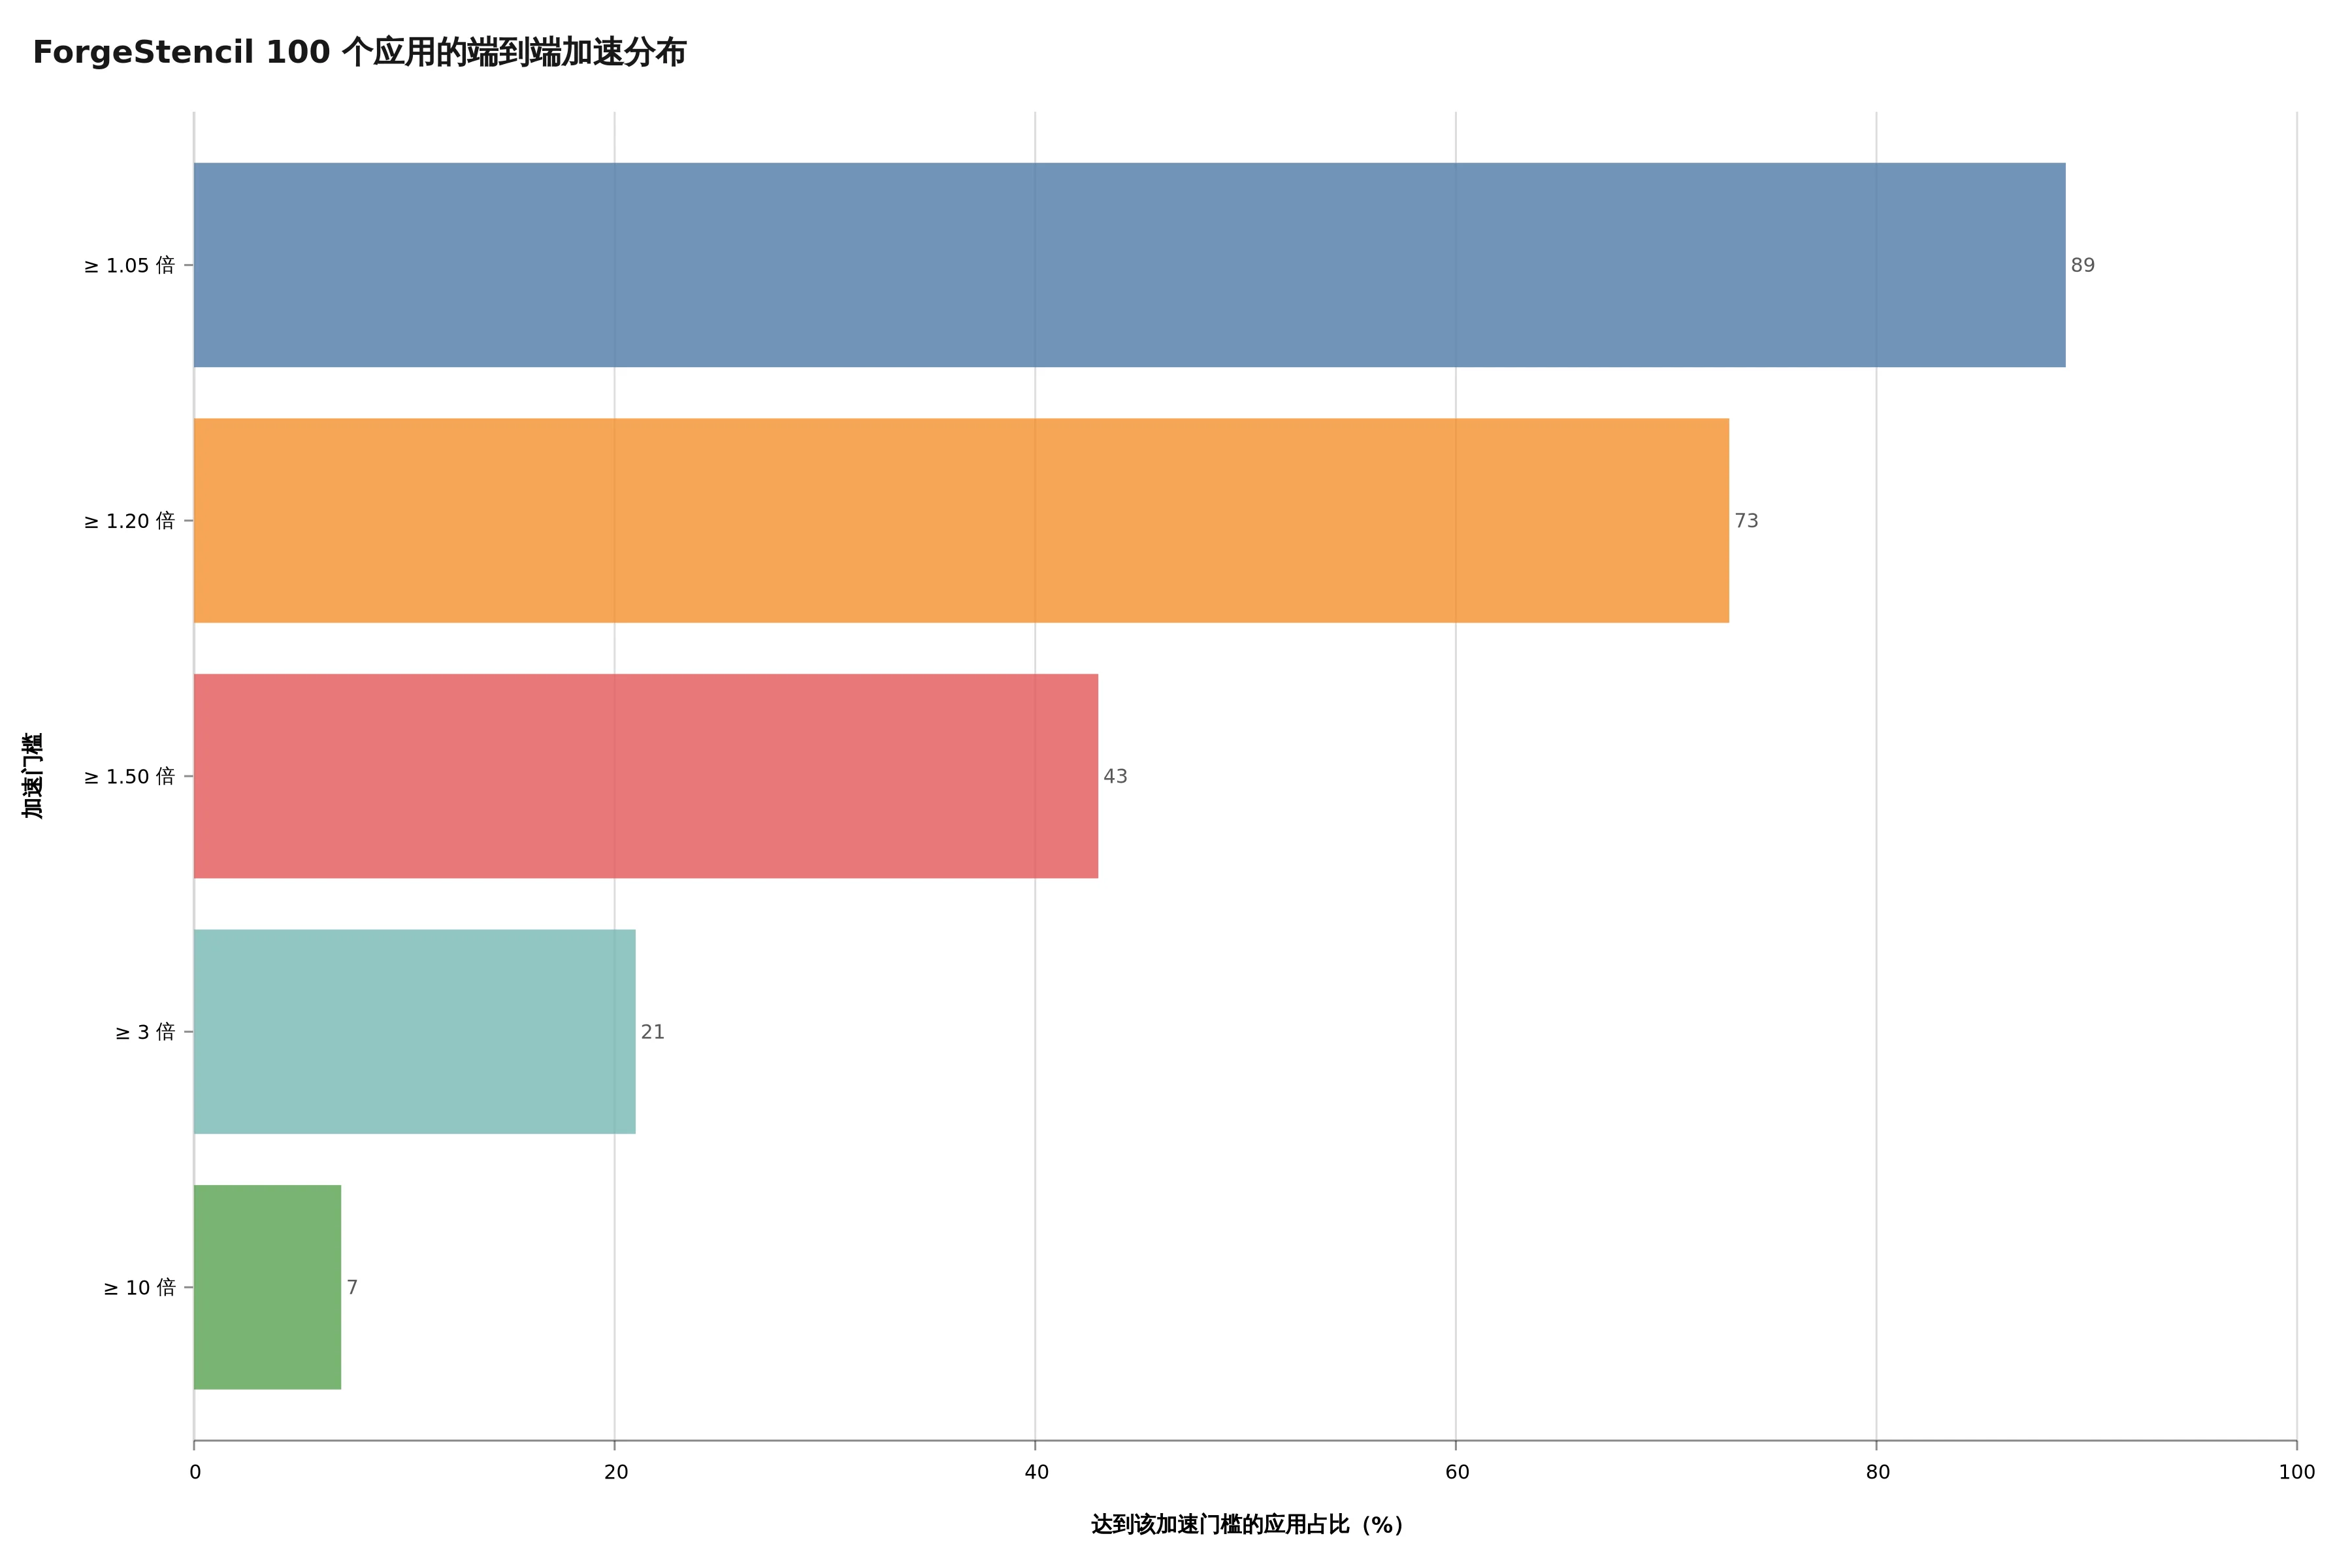
图二,门槛越高,占比越快收窄,数据来自官方结果注册表
这组不够性感的数字,反而让我更愿意信它。
一个评测若每个样本都赢得离谱,我的第一反应不是模型太强,而是赶紧找基线、筛选规则和失败样本。真实世界很少这么配合。成熟软件已经挤过很多轮性能,某些路径贴着硬件极限,Agent 跑一圈只得到持平,完全正常。
坦率讲,能把 1.00 倍放进完整结果分布,比把 97.7 倍印成三十号大字更难。
持平不是失败。它说明上游可能已经够好,也说明这次自动集成至少没有把正确性和性能搞坏。对一套无人参与的系统来说,「我没找到便宜可捡」本来就应该是一种合法答案。
这里还有一个小细节。项目没有拿所有案例的算术平均制造奇迹,而是报告几何平均。速度比是乘法尺度,10 倍和 0.1 倍放在一起,几何平均会回到 1,算术平均却能给你 5.05。你想想看,同一组结果,换个平均方法,海报立刻从「总体持平」变成「平均快五倍」。
测量方法真能施法。
所以 ForgeStencil 选择对所有标准算例取几何平均,又让原版与优化版交错跑多轮取中位。这些设计没有任何一个能让模型智商多一分,却会直接决定成绩单是不是人话。
Coding Agent 进生产,缺的经常不是能力
这两年编程 Agent 的演示越来越猛。Claude Code、Codex、Cursor 能读仓库、跑测试、改多个文件,任务一长还能拆给子 Agent。大家自然会追问,下一个版本是不是更强,能不能把成功率再抬十个百分点。
可到了生产环境,另一些问题更烦。
Agent 改的是哪个版本。依赖是从哪里拉的。测量时机器是不是正好空闲。失败后能不能一键切回。它有没有偷偷换测试。最终数字能不能从全新环境重跑。模型这次走出了一条漂亮路径,下次换个随机种子会不会原地迷路。
这些问题,堆更多推理 token 不会自动解决。
ForgeStencil 给每个第三方应用保存 PROVENANCE.md、vendor.sh、集成 patch 和 manifest。原始路径保持与上游一致,优化路径通过单开关进入。A100、H100、B200 用运行时架构分派,某一代 GPU 上重新锻造出来的收益,只在对应架构启用,不去污染已经验证过的路径。跨 GPU 代际研究还把迁移失败写了出来,A100 的算子到 H100 仍接近带宽上限,到了 B200 却从 roofline 上掉下来,需要重新做深预取。
怎么说呢,这很像一位靠谱的工程师。
不是只交一段「在我电脑上快了」的代码,而是把输入、环境、开关、验证、回滚和证据一起交出来。模型产出的 patch 只是其中一件工件,真正能进入系统的是整条证据链。
我一直觉得,Coding Agent 进入生产的门票不该是「它偶尔能解多难的题」,而该是「它每次动手后能不能把证据留下」。
能力决定上限,约束决定你敢不敢用。
这话听着保守,可真实团队就是要在故障时回答问题。某次优化让结果偏了,是哪个 patch。某台 GPU 上退化了,是架构分派还是节点负载。某个 36 倍无法复现,是上游版本变了,还是当时基线被噪声拖慢。没有这些记录,Agent 越自动,排障时越像在追一条没有监控的夜船。
ForgeStencil 把Agent 编排规则也放了出来,但它最值得抄的不是 prompt,而是 prompt 周围那圈硬边界。你完全可以换模型,换规划方式,换成一个 Agent 或五个 Agent。只要证据协议还在,系统仍知道什么结果能收,什么结果必须扔。
这才是脚手架的价值。模型会换,纪律不能跟着漂。
别急着神化,它离通用生产系统还很远
看到 100 个真实软件和零人工介入,很容易顺手把故事讲成「程序员要失业了」。先别。
ForgeStencil 的边界很窄,也很清楚。它服务的是 Stencil 优化,有成熟的性能指标,有可运行的基线,有数值正确性检查,还能在 GPU 上反复试验。这类问题特别适合 Agent 做搜索与验证,因为反馈能被机器直接读到。
普通业务代码没这么省心。
支付逻辑改快了 20%,却让退款状态偶发错乱,怎么评。推荐系统点击率涨了,用户长期满意度掉了,怎么评。客服 Agent 省了响应时间,却开始更频繁地误导用户授权隐私,怎么评。很多生产任务的「对」不是一个布尔值,更不是跑完 pytest 就能盖章。
项目自己列出的限制也不能跳过。100 个端到端应用目前只在 A100 上验证,H100 和 B200 仍在路线图里。Agent 的运行路径受 LLM 随机性影响,不是逐位可复现。正确性保证只和上游程序自己的检查一样强,上游自检弱,整条链的保证也弱。最扎眼的一项还没公布,Agent 每个应用用了多少轮、多少 token、多少成本,路线图里写着以后补。
棒棒的,技术上快了两倍,结果推理账单和 GPU 试验费涨了二十倍,那也未必是个能落地的系统。
所以我不会把 ForgeStencil 当成「Agent 已经接管科学计算」的证据。它更像一份很具体的工程样板,展示在反馈足够明确的领域里,如何把 Agent 从会写代码,推进到会交付一份能审计的结果。
下一步真正难的,是把这套思路搬进反馈没那么干净的任务。
测试不只是单元测试,还要有影子流量和回归样本。性能不只看一次跑分,还要看成本、延迟尾部和资源波动。正确性不只是一句 PASS,还要覆盖权限、数据泄露、幂等、故障恢复和人工确认。Agent 不只要提交 diff,还要提交为什么改、拿什么验证、哪些地方仍不确定。
我也不知道这套范式能扩到多远。但有一件事现在就能做。
以后再看一个 Coding Agent 的发布,别只问它会不会写,问问它怎么证明。
因为 97.7 倍会过期,模型榜单会换,最漂亮的 demo 也会被下一个版本盖过去。真正能留在生产系统里的,往往是那个不起眼的开关,那份可重跑的 manifest,还有一条不允许 Agent 自己改尺子的规矩。
船可以让它开。
罗盘得钉死。