posts/gemini-agentic-video-audit.md
Gemini 视频省 88% Token,抽检反而要加码
88%、66%、7%。
Google 昨天给 Gemini 上线智能体视频理解时,把三个数字摆在了一起。官方测试里,Token 消耗最高降低 88%,分析成本最高降低 66%,准确率最高提升 7%。
好家伙,少花钱,还更准。
这类发布最容易让人直接打开预算表,把视频分析那一栏乘上 0.34。先忍一下。真正值得盯的,不只是 Gemini 少看了多少帧,而是它开始自己决定看什么。
Google 的发布说明写得很直白。过去的静态模式默认按 1 FPS,也就是每秒抽一帧,把固定采样的画面放进上下文。新的智能体模式会沿着时间线搜索,在画面、音频和转录文本之间挑线索,遇到可疑片段再调整帧率和分辨率重看。
以前是开发者决定采样策略,模型负责回答。现在连采样策略也交给模型了。
这一手确实有点子牛逼。
一段 90 分钟的发布会,问题只是其中三项新功能,整段按固定频率读取很浪费。先扫转录文本,定位几个时间段,再回去看幻灯片和听原话,显然更像人处理资料的方式。Google 给出的适用场景也很具体,包括亚秒级片段检索、长视频里找一个细节、异常检测,以及动作和物体计数。
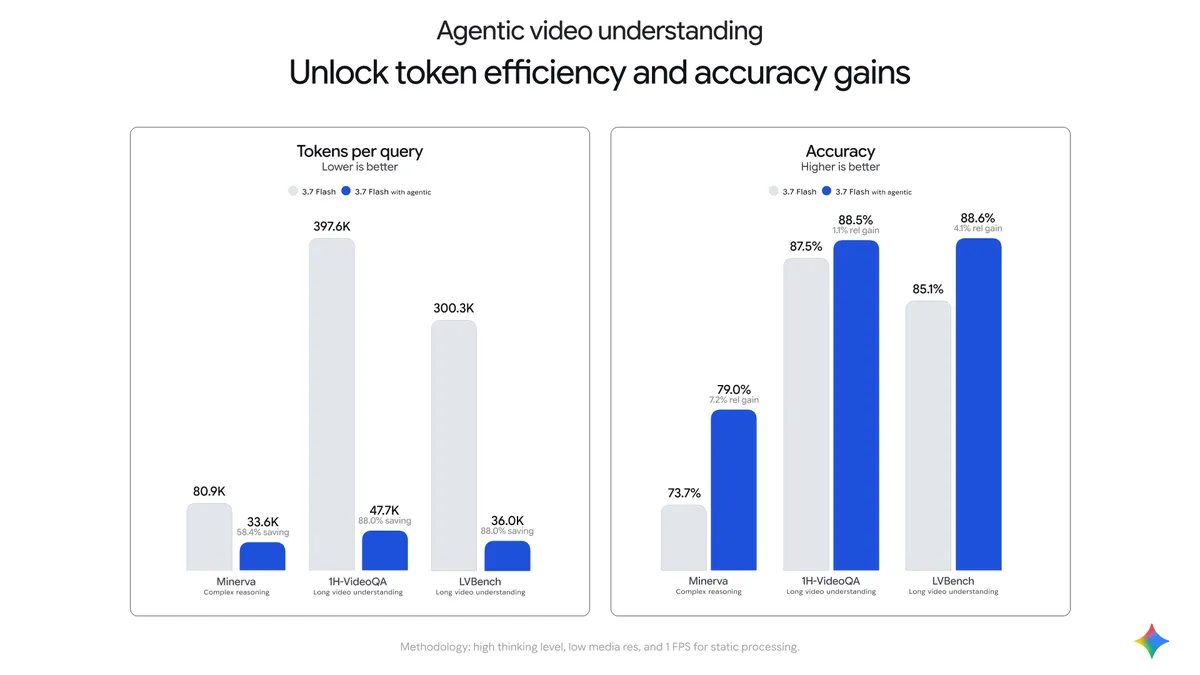
图,Google 官方基准里,三组任务都减少了 Token,准确率同时上升
代码改动甚至小得有点离谱。在 Gemini API 的视频文档里,只要给视频输入多放一个配置。
{
    'type': 'video',
    'uri': video_file.uri,
    'processing': 'agentic'
}
功能不另收费,仍走标准 Gemini API Token 价格。支持 Gemini 3.7 Flash、3.6 Flash 和 3.5 Flash-Lite,也能直接处理公开 YouTube 视频。
到这里,通稿差不多写完了。
但做生产系统的人会马上遇到另一个问题。两次请求给同一段视频、同一个问题,模型可能挑了不同片段,走了不同证据路径,结果却都长得很像。你到底该验哪个?
静态抽帧很笨,但它有一个朴素的好处。给定视频、帧率和起止时间,输入基本可复现。第 312 帧在不在上下文里,能查。模型漏掉关键动作时,也能沿着采样链往回找。
智能体模式聪明得多,输入却不再是一包预先确定的帧。它会先判断哪里值得看,再加载片段,可能读字幕,可能听音频,也可能在半秒钟的动作上提高帧率。错误不只会发生在回答阶段,还会提前发生在找证据阶段。
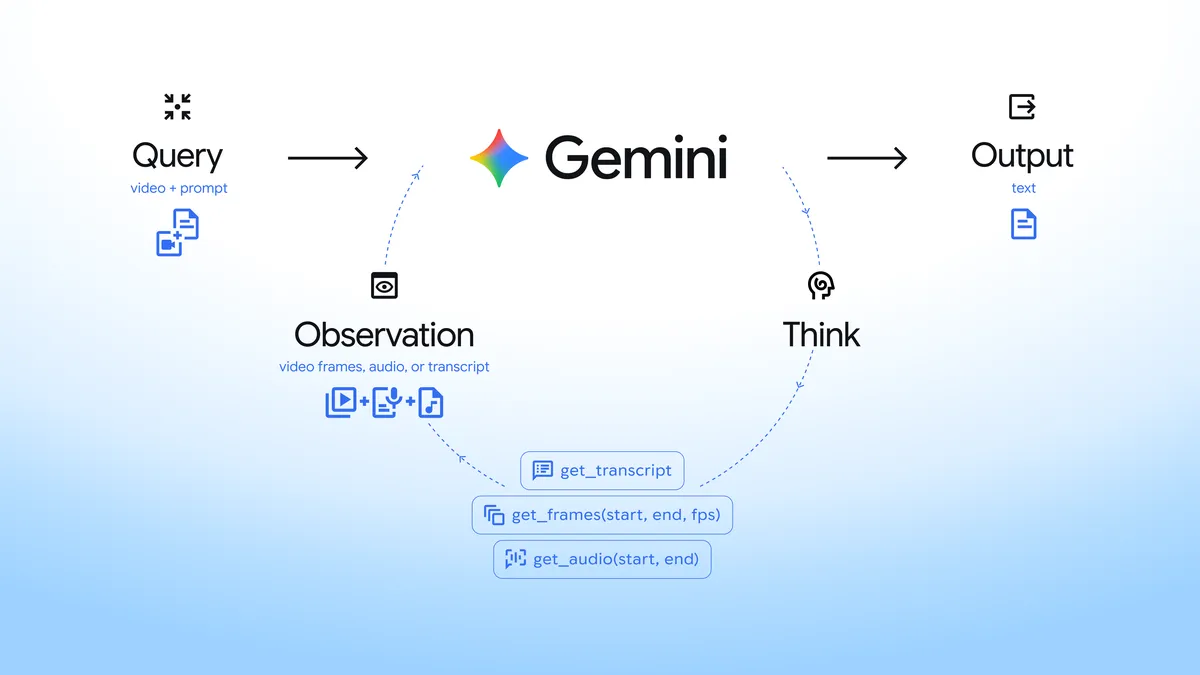
图,模型不再一次读完整段视频,而是在推理过程中按需调用视频工具
这就是 88% 背后的工程账。
少看的那 88% 里,当然大部分是无关内容。可只要关键证据也被归进无关,后面的推理再漂亮都没用。视频里的人在 12 分 03 秒把红色零件换成蓝色,模型只看了 12 分 02 秒和 12 分 04 秒,最终答案可能非常笃定,也非常错。
这不是在挑 Google 的刺。任何带搜索、检索、工具调用的 Agent 都有同一类风险。系统把计算集中到更可能有用的地方,收益来自选择,风险也来自选择。
我还没有拿自己的视频工作负载跑出 88% 这个数字,所以不会把它写进成本承诺。官方原话一直带着最高二字,而且基准覆盖的是特定模型、问题与视频。你的视频长度、字幕质量、语言、镜头密度和提问方式一变,账单都可能跟着变。
更稳的做法,是把智能体模式和静态模式当成两条轨道,而不是一次开关升级。
第一条轨道跑业务流量。长课程检索、会议重点定位、素材粗筛、公开发布会问答,这些任务要的是在大量内容里尽快找到相关片段。智能体模式很合适,省下来的 Token 也最容易兑现。
第二条轨道跑验收样本。保留一组人工标过时间点的视频,里面既有长时间无关内容,也有一闪而过的关键动作、画外音、字幕冲突和重复物体。每次换模型、改提示词或升级 SDK,都同时跑智能体与静态基线。
这里别只比最终答案。
至少记下视频文件哈希、模型版本、完整提示词、处理模式、Token 用量、总耗时、最终答案,以及人工标注的证据时间段。Gemini 的返回里还会出现 processing_call 和 processing_result。按官方说明,看到这些步骤可以确认动态视频处理确实被调用。把步骤也存下来,别让它们只在一次请求日志里闪一下就没了。
然后把验收拆成两层。
第一层看答案对不对,用任务级指标。摘要有没有漏主结论,计数有没有偏差,异常有没有报出,时间点是否落在容许范围里。
第二层看证据找没找对。让输出同时给出时间点和简短依据,再跟人工标注比。最终答案碰巧答对,证据却来自错误片段,这种样本不能算稳。它只是运气暂时站在你这边。
很多团队的评测只盯第一层。上线后最难查的事故,往往就藏在第二层。用户问为什么,系统只能摊手说模型看过视频。看过哪段,不知道。用的字幕还是画面,不知道。下次还能不能看到,也不知道。
一时间无语凝噎。
抽检比例也别固定。普通课程摘要可以低一点,支付操作、设备异常、质检缺陷、身份核验这类高代价任务要高一点。更关键的是按风险分层。凡是答案依赖亚秒动作、模糊字幕、多人同框或跨很远时间段拼接,都自动进更严格的抽检队列。
这里还有一个很实用的分流规则。Google 的开发者文档建议,长视频或需要定位特定时刻的查询优先尝试智能体模式。少于 5 分钟、对延迟敏感,或者要求覆盖整段视频的逐帧精度,静态模式仍然更合适。
别为了新功能,把所有视频都塞进同一条路。
假设一个常见场景。你在做工厂质检,十分钟录像里要找一次安全门开启。用智能体模式先定位候选时间段很划算,但最终判定最好回到静态高帧率或专用视觉模型复核。让一个便宜的搜索器负责缩小范围,再让确定性更强的检查器负责盖章。
如果是两小时访谈里找嘉宾谈价格的片段,风险就低得多。直接用智能体模式,要求返回时间点和原话,再让人点开确认。这里多跑一遍全片静态处理,反而把省下来的账单又烧回去了。
同一个视频,不同问题也该走不同模式。
问主要观点,智能体模式。问第 18 秒到第 23 秒每个动作的先后顺序,静态模式。问全片出现了多少次品牌标识,先看你能不能接受漏检,再决定是否交给会跳着看的模型。
模型选择的不只是帧,也是你的风险预算。
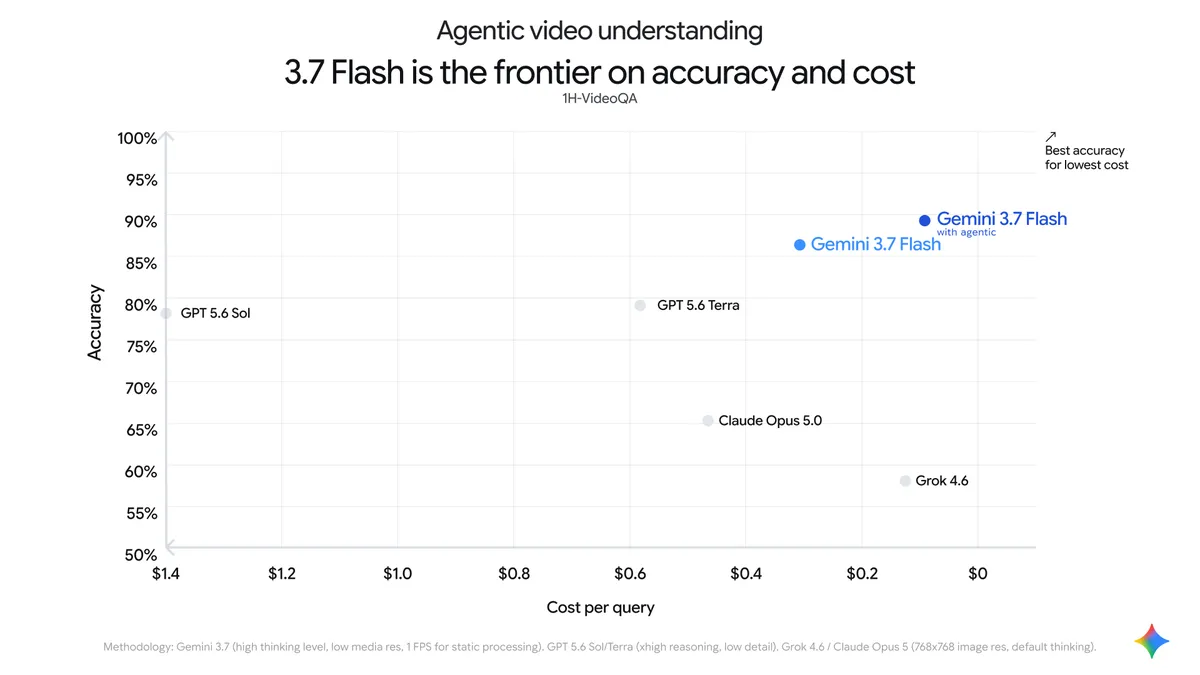
图,官方 1H-VideoQA 测试显示智能体模式向更低成本与更高准确率移动,具体工作负载仍需自测
Google 还计划把这项能力放进 Gemini 应用,并在未来几个月接入 YouTube 的 Ask YouTube。对普通用户来说,体感可能只是长视频问答更快、更准。对开发者来说,变化大得多。过去写在预处理脚本里的抽帧、转录搜索和局部重采样,正在被收进模型内部的 Agent 循环。
代码少了,责任没少。
坦率讲,我很喜欢这次更新。视频理解长期有个笨重的前置成本,先把整段内容拆碎、编号、抽帧、转录,再祈祷问题刚好落在采样点上。现在模型终于会自己翻进度条,像一个知道去哪找资料的同事。
但同事会说自己查了哪一页,生产系统也得留下类似的东西。
所以别急着把成本乘上 0.34。先挑 30 到 50 条真实任务做一轮双轨对照,分别记录答案质量、证据命中、Token、延迟与人工复核时间。要是 Token 真降了,抽检工时却翻上去,财务表上那条绿线只是换了个地方变红。
厉害的新能力,应该配得上更细的验收。
Gemini 已经学会自己决定看哪里。接下来轮到我们决定,哪些地方绝不能只看一眼。