posts/gemini35-transcribe-audit.md
Gemini 3.5 词错率 2.6%,原话却更难追
2.6%。
这是 Google 刚发布的 Gemini 3.5 Transcribe 在非流式场景里的平均词错率。流式版本是 4.0%,支持 85 种以上语言,能认自定义词表,能给最多三名说话人分轨,还能把「周二见,不,改成周三」整理成最终那句干净的话。
好家伙,语音转写终于不只是在听写,它开始顺手当编辑了。
这个变化很爽。会议纪要不用再挂着一串「嗯、啊、那个」,客服录音能直接变成可搜索文本,语音 Agent 也少吃一点口语噪声。Google 还把实时版做进 Live API,走 WebSocket 双向流,官方给出的延迟是亚秒级。预录音频则走 Interactions API,带说话人归属和词级时间戳。
但我盯住的不是 2.6%。
我盯住的是「自动清理」四个字。
当模型会删除填充词、理解自我纠正、自动加标点,输出就不再只是录音的机械投影。它是一份经过判断的文本。判断大多时候是对的,错的时候却可能特别隐蔽,因为句子读起来依然顺滑,甚至比当事人说得还像回事。
嘶,这就有意思了。
词错率很重要,但它没替你回答「原话是什么」
词错率,也就是 WER(Word Error Rate),衡量替换、漏掉和多写了多少词。数字越低,普通识别准确度通常越好。Google 引用 Artificial Analysis 的结果给出 4.0% 和 2.6%,同时说最终转写完成时间较 Chirp 3 改善了 70%。在 FLEURS 多语言基准上,流式和非流式的词错率又分别是 5.50% 与 5.04%。
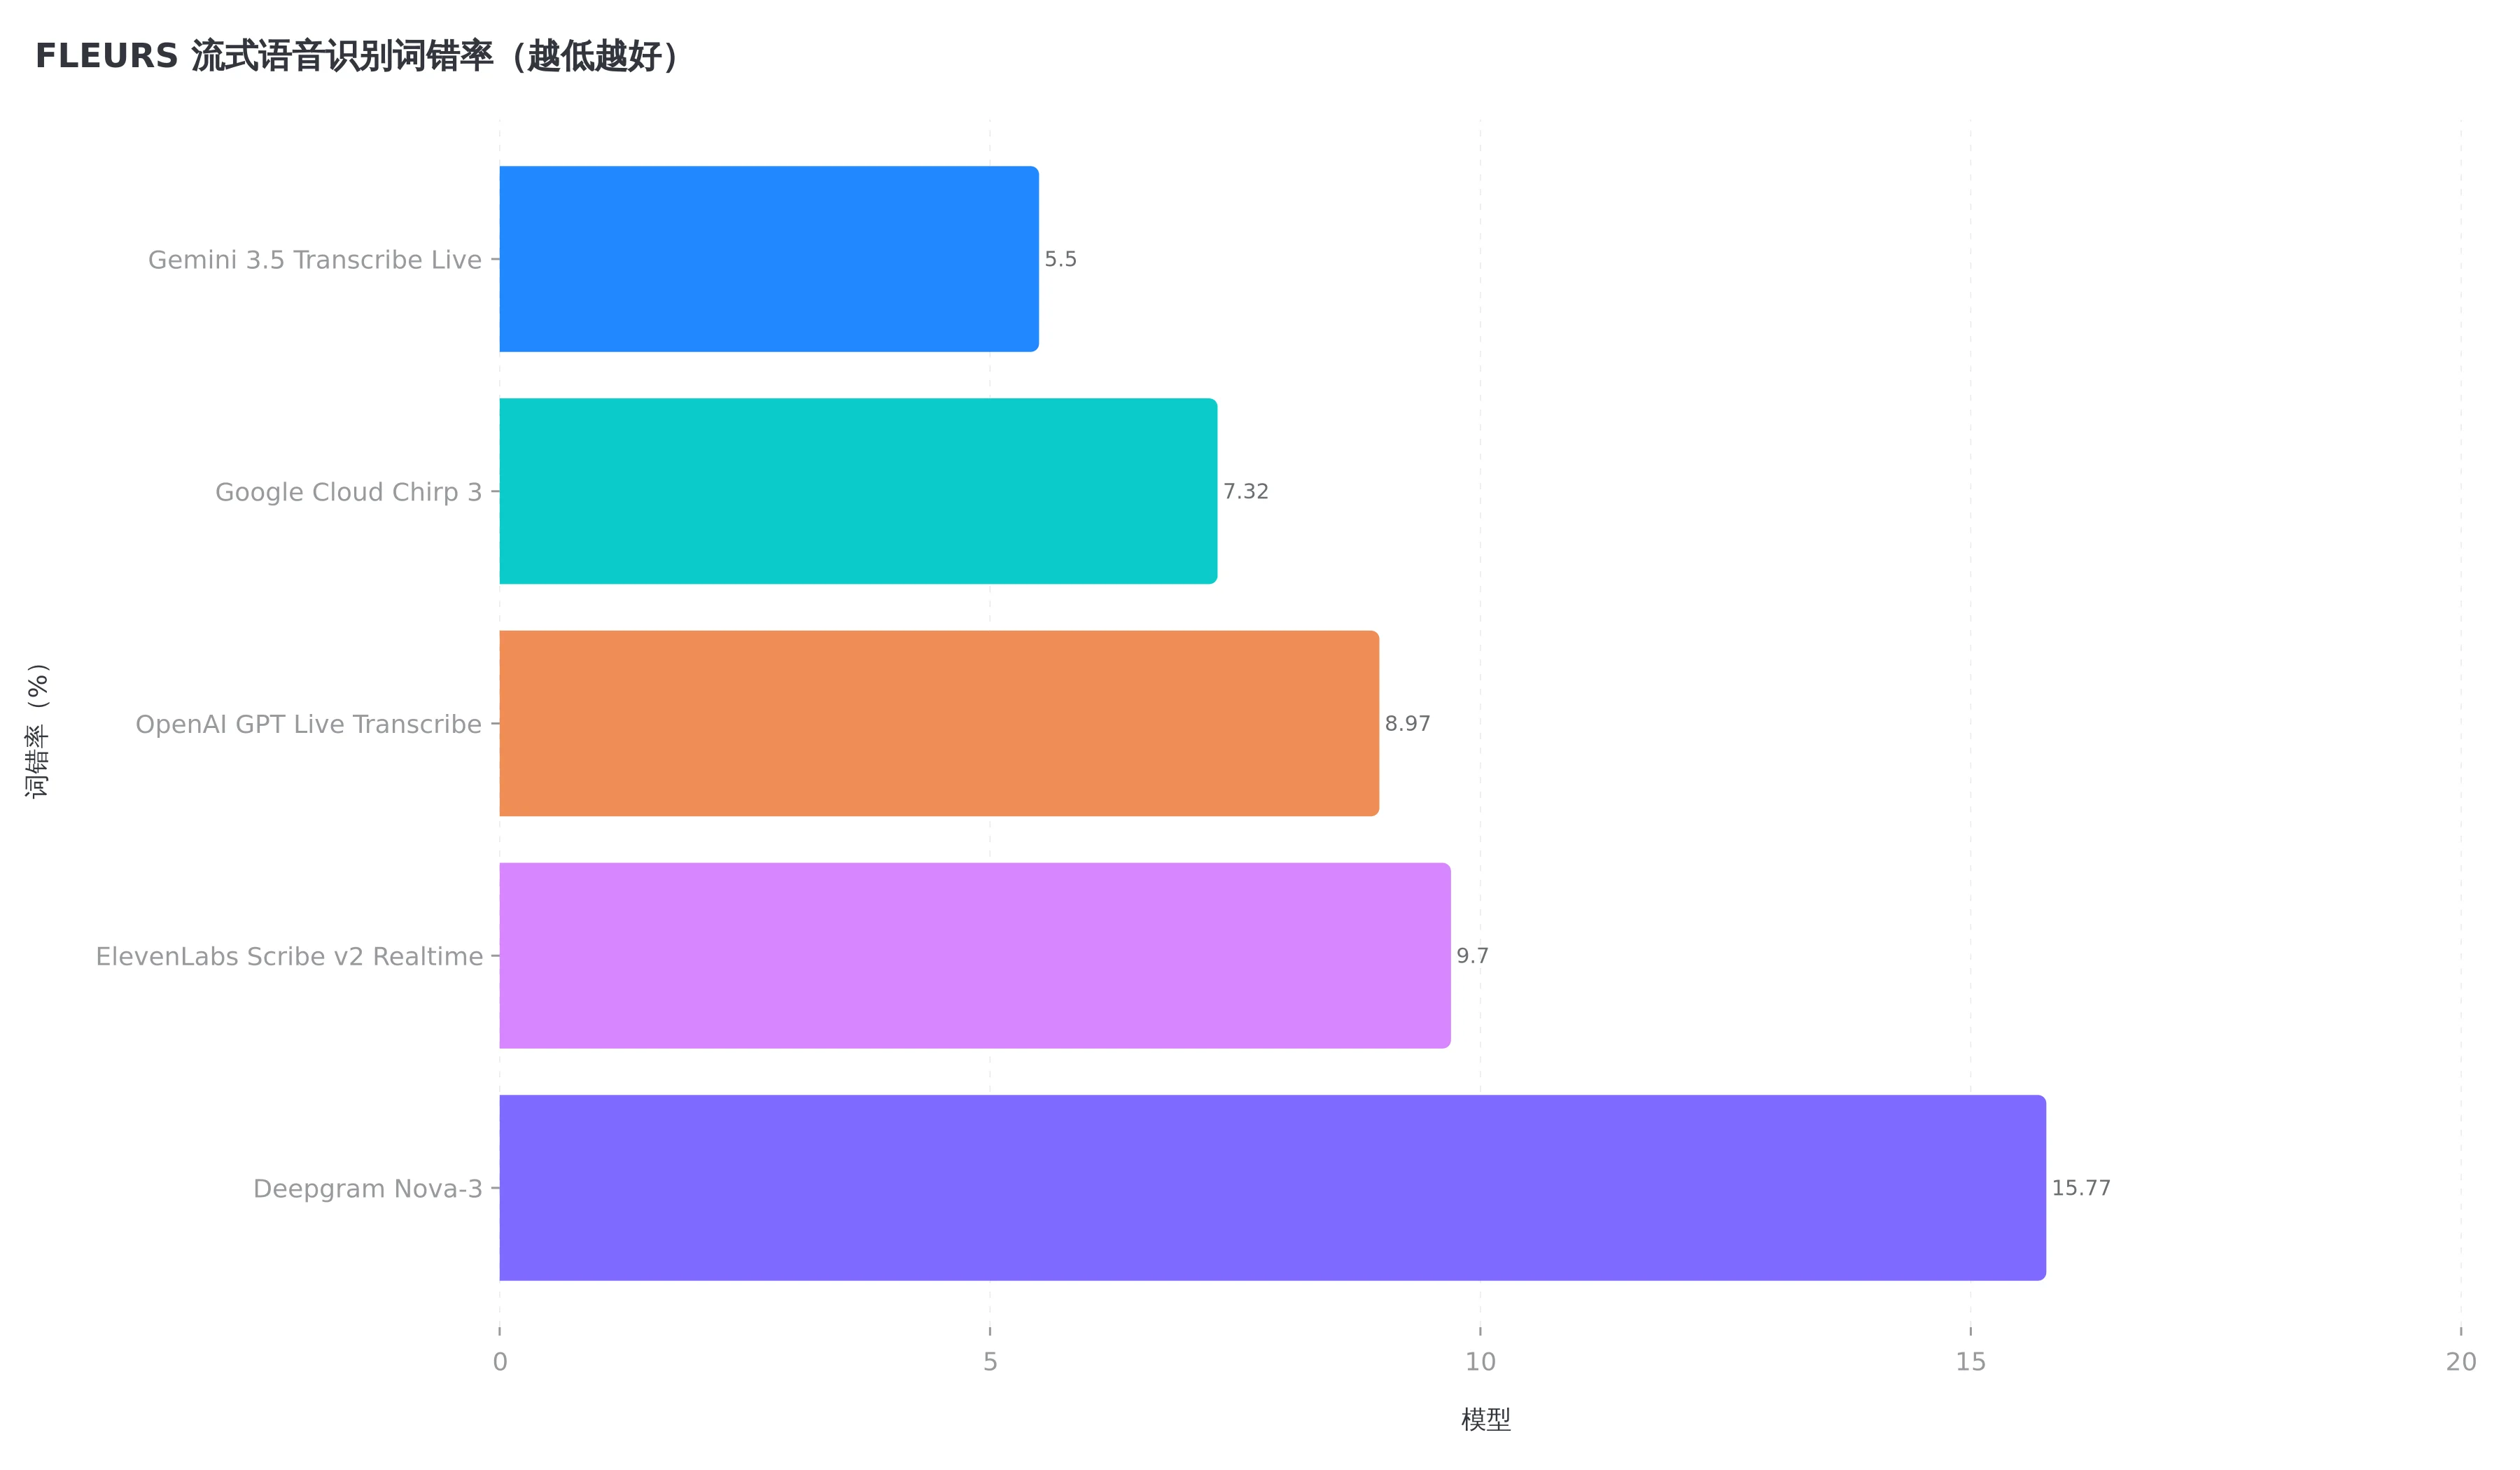
同一个模型,换数据集、语言、噪声和工作方式,数字就会变。很多朋友看到榜单第一反应是「可以替换旧 ASR 了」,我建议先把鼠标从部署按钮上挪开一点。
WER 统计不了所有业务风险。
订单号里的一个字母、药名里的一个音节、金额里的一个零,对整体词错率影响都很小,对业务却可能是整场事故。说话人分离也一样,一段十分钟会议里只错绑一句话,平均指标依旧漂亮,那句话若刚好是承诺交付日期,后面的人就要对着错误纪要开会了。
还有一类更麻烦的错,模型没有认错字,而是替你做了编辑选择。
假设客服说「这个应该能退,我确认一下,不,系统里显示不能退」。清洁稿若只留下最后一句,对处理工单很方便。质检人员若要判断客服是否先做了承诺,就必须回到完整话语顺序。再假设语音 Agent 收到「给供应商转五百,不,五十」,实时流里的中间结果和最终结果都可能是语法正确的,动作系统却只能相信完成纠正后的那一版。
不是模型不够聪明,是「方便阅读」和「忠实留痕」原本就不是同一个任务。
一段音频,最好别只留一份文本
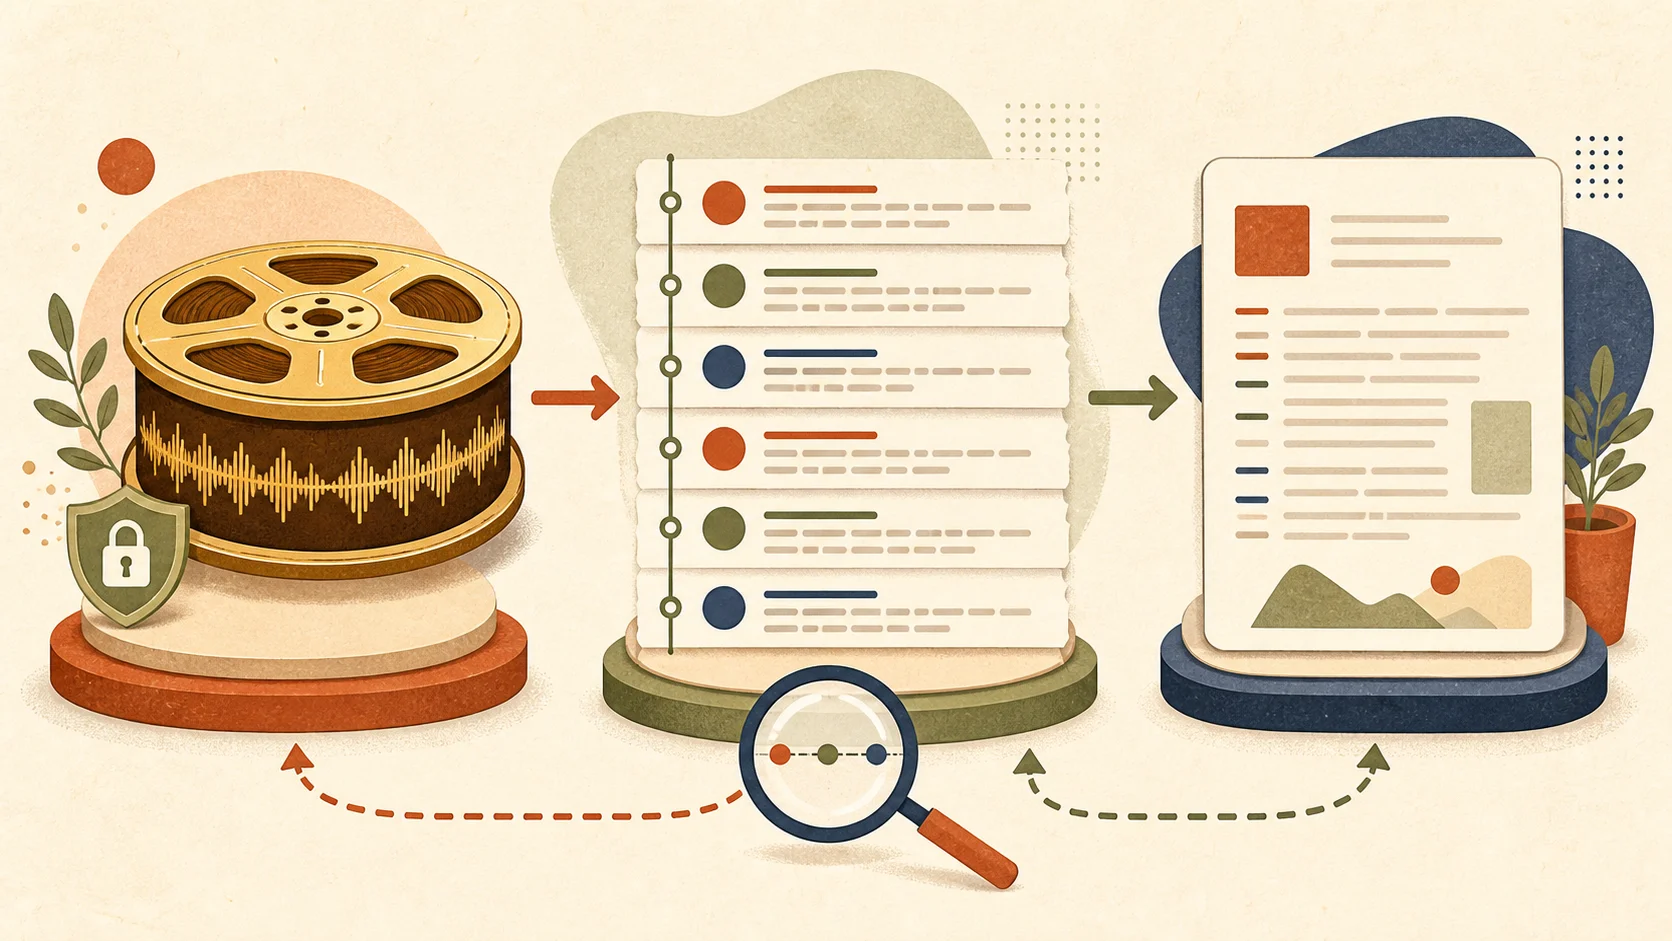
我自己的判断是,生产系统该把一段语音拆成三层资产。
第一层是原始音频。它是不可变底稿,放进对象存储,记录 SHA-256、采集时间、授权范围、保留期限和访问日志。需要争议复核时,系统能按时间戳跳回去听,而不是让运营同学在一小时录音里拖进度条拖到怀疑人生。
第二层是逐字稿。它尽量保留填充词、自我纠正、说话人、词级时间戳和模型返回的其他证据字段,只做字符编码与明显格式归一。模型名、接口版本、词表版本、语言配置也得一起存。三个月后换了模型重新跑,旧稿不能被新稿悄悄覆盖,得留出版本差异。
第三层才是清洁稿。它可以删掉口头语、合并重复句、补标点,甚至生成章节和行动项。用户日常读这一层,搜索和摘要也围绕它做。每个段落最好能反查逐字稿区间,再从逐字稿跳回原始音频。
有点子牛逼的不是多存了两个字段,而是从此把「记录」和「编辑」分开了。
一个简化后的记录结构可以长这样。下面只是工程示意,不是 Google API 的原始返回格式。
{
  "audio_uri": "object://meeting/abc.wav",
  "audio_sha256": "...",
  "verbatim_text": "...",
  "clean_text": "...",
  "speaker_segments": [],
  "model": "gemini-3.5-transcribe",
  "vocabulary_version": "support-v7",
  "transcript_version": 3
}
这套结构还有个朴素好处。清洁规则改了,只重算第三层。词表更新了,重算第二层和第三层。审计追问来了,第一层还在。数据链路不用每次都从头猜「当时究竟发生了什么」。
当然,原始音频也不是越多越好。语音里可能有姓名、账号、地址和公司资料,保存它就要同时接受加密、权限隔离、删除请求和保留周期的成本。该删的时候真删,该脱敏的时候别只在界面上打马赛克,底层对象还躺着原件。方便追溯不能变成无限期囤隐私的借口。
三种场景,三条不同的边界
会议纪要最适合把清洁稿放在前台。读者要的是结论、负责人和日期,不是每个「嗯」。但任何行动项旁边都该有原话定位,点一下能回到对应音频。谁对日期有异议,十秒内就能复核,别让会议纪要变成新一轮会议的起点。
客服质检更谨慎。检索、聚类和摘要可以吃清洁稿,判责、合规抽查和投诉复核必须能看逐字稿与音频。尤其是金额、日期、身份信息、验证码和购买诱导这类关键实体,最好单独算实体错误率,别被整体 WER 的漂亮平均数藏过去。
语音 Agent 的难点又换了一个。它面对的不是一篇完成稿,而是一串持续变化的 partial event 和 final event。中间结果可以拿来抢延迟,涉及转账、发送、删除、下单等外部动作时,至少等最终片段确认,并让动作请求带上 event_id 和幂等键。网络抖一下、WebSocket 重连一次,不能把同一句话执行两遍。棒棒的,语音听懂了,结果付款点了两次,这种智能不要也罢。
Google 当前的 官方定价页给出的估算综合价格,实时版约每分钟 0.009 美元,非实时版约每分钟 0.005 美元。这个单价确实很有攻击力。不过生产账单还得加上音频存储、跨区流量、失败重试、人工复核和回放工具。API 便宜,不等于整条证据链免费。
产品边界也别从宣传页脑补。官方公告写明三人以上的说话人识别仍是实验能力,85 种以上语言也不代表每种语言都能复现英文演示的效果。实时版与预录版是两个模型端点,延迟、准确率和输出字段都该分别验收。模型目录与具体接口文档如果更新,以你真正调用的端点合同为准。
上线前,先让它在影子流量里说一阵
坦率讲,新转写模型最不适合拿公开榜单直接拍板。你需要自己的脏数据。
从真实业务里抽一批已经取得授权的音频,覆盖口音、重叠说话、弱网、背景音乐、专业词、字母数字串和临时改口。别只算 WER,再加关键实体错误率、说话人绑定错误率、首个片段延迟、最终片段延迟、纠正回滚次数,以及错误动作触发率。每个指标都看 p50 和 p95,平均值很会照顾心情,尾延迟不照顾线上用户。
然后把新旧模型跑在同一份影子流量上,不立即影响用户。差异大的片段进入人工复核,复核结果反过来补自定义词表和回归集。模型版本、词表版本、清洁规则版本都进 trace。哪天数字突然变好,至少知道是模型升级了,还是评测集被你不小心洗干净了。
如果团队人手有限,先做最小版也行。原始音频不覆盖,逐字稿带时间戳,清洁稿能反查原文,危险动作只吃最终事件。四件事先守住,已经能躲开大半看不见的坑。
Gemini 3.5 Transcribe 当然是一次很强的发布。亚秒级流式、2.6% 非流式词错率、自定义词表和每分钟不到一美分的估算价格,放在一起看,语音入口正在从昂贵功能变成普通组件。
只是组件越聪明,系统越要记得谁在负责事实。
把 2.6% 放回它该在的位置。它衡量识别能力,不替你保存原话,更不替你承担一次错误动作。
罗盘可以越来越准,航海日志还是得留。