posts/gemini37-flash-unit-economics.md
Gemini 3.7 Flash 半价,Agent 账单未必更低
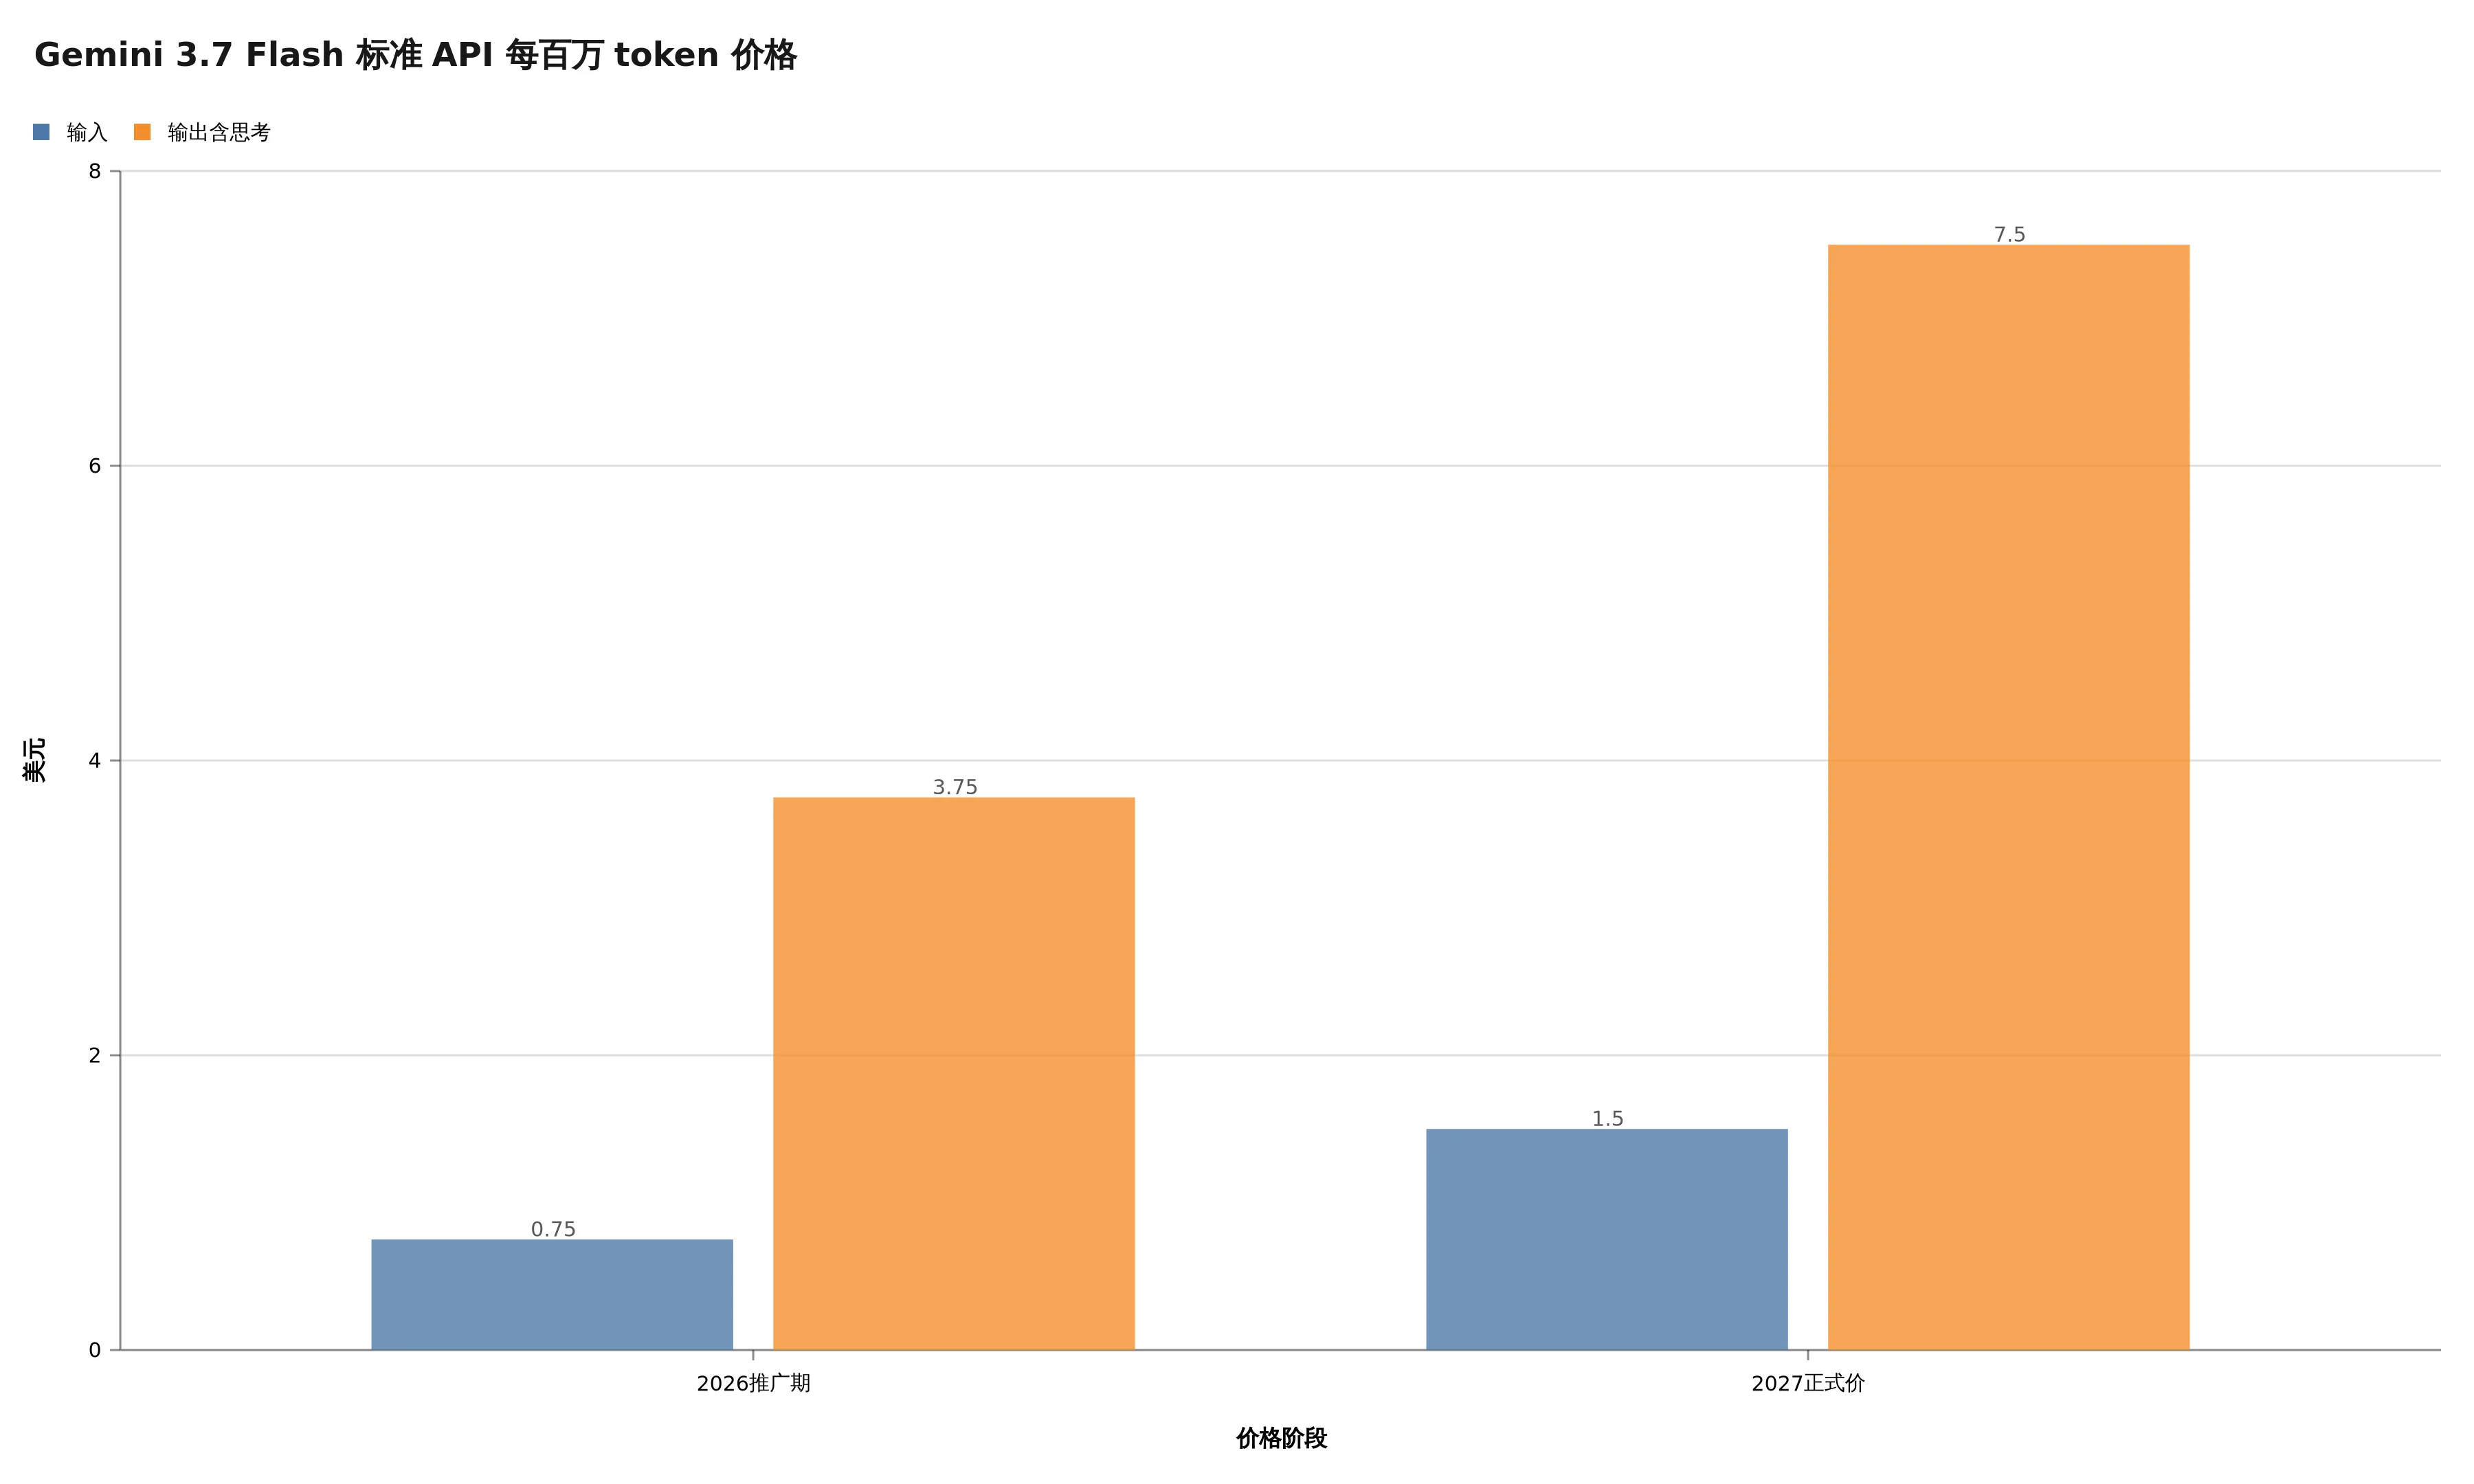
每百万输入 token 0.75 美元,输出 token 3.75 美元。
Google 昨天发布 Gemini 3.7 Flash,把这两个数字摆在了最显眼的位置。和三周前的 3.6 Flash 相比,推广价直接砍掉一半,编程、Web 开发和多步智能体任务的官方成绩还全线往上走。
好家伙,更强,还更便宜。
但页面脚注里藏着另一半账单。这个价格只持续到 2026 年 12 月 31 日。到了 2027 年元旦,标准 API 的输入价会变成 1.50 美元,输出价会变成 7.50 美元,缓存读价和缓存存储价也一起翻倍。Google 的 Gemini API 定价页 写得很清楚,只是字没有发布标题那么大。
如果你只是拿模型问几句话,年底之后多花几美元,问题不大。可要是你在跑一个会读仓库、查资料、调工具、失败后自动重试的 Agent,盯着每百万 token 的单价做决策,很容易算出一张看着漂亮、上线后完全不是那么回事的预算表。
我自己的判断很直接。
Gemini 3.7 Flash 值得测,但不能拿半价当迁移理由。生产 Agent 应该比较的不是 token 单价,而是每个成功任务到底花了多少钱。
半价先别急着乘用量
普通聊天的成本很好算,输入多少字,输出多少字,乘一下单价,完事。
Agent 不是这么工作的。
它接到一个修 bug 的任务,先读 issue,再搜代码,可能调用十几次文件工具,跑测试时撞上一条失败日志,又回头重写方案。中间任何一步走偏,都可能让整条轨迹重来。一次运行花了多少 token,只能回答「这趟船烧了多少油」,回答不了「货有没有送到」。
真正该算的是这个。
每个成功任务的成本
= 输入、输出、缓存与工具费用
× 平均运行次数
÷ 最终成功率
假设 3.6 Flash 跑一次要 0.10 美元,平均两次才能成功,成功率是 70%,那每个成功任务的成本大约是 0.29 美元。3.7 Flash 哪怕单次跑到 0.15 美元,只要首轮更稳,平均 1.2 次完成,成功率来到 90%,每个成功任务就降到 0.20 美元。
反过来也成立。模型单价便宜一半,但它为了一个工具错误多绕三轮,输出了更多 thinking token,结果还得人工接管,账单照样能抬头看你。
这里的例子是显式假设,不是 3.7 Flash 的实测数据。我还没把它接进自己的生产流水线,也不打算拿官方基准替代真实任务。但这个算式很重要,它把讨论从「一百万 token 多便宜」拉回「一个任务有没有交付」。
你想想看,团队真正买的从来不是 token。
买的是结果。
首轮通过率,才是这次升级最值钱的地方
Google 在发布页里反复强调一个词,first-pass,也就是首轮就做对。
这比榜单上又涨了几分更值得工程师盯住。
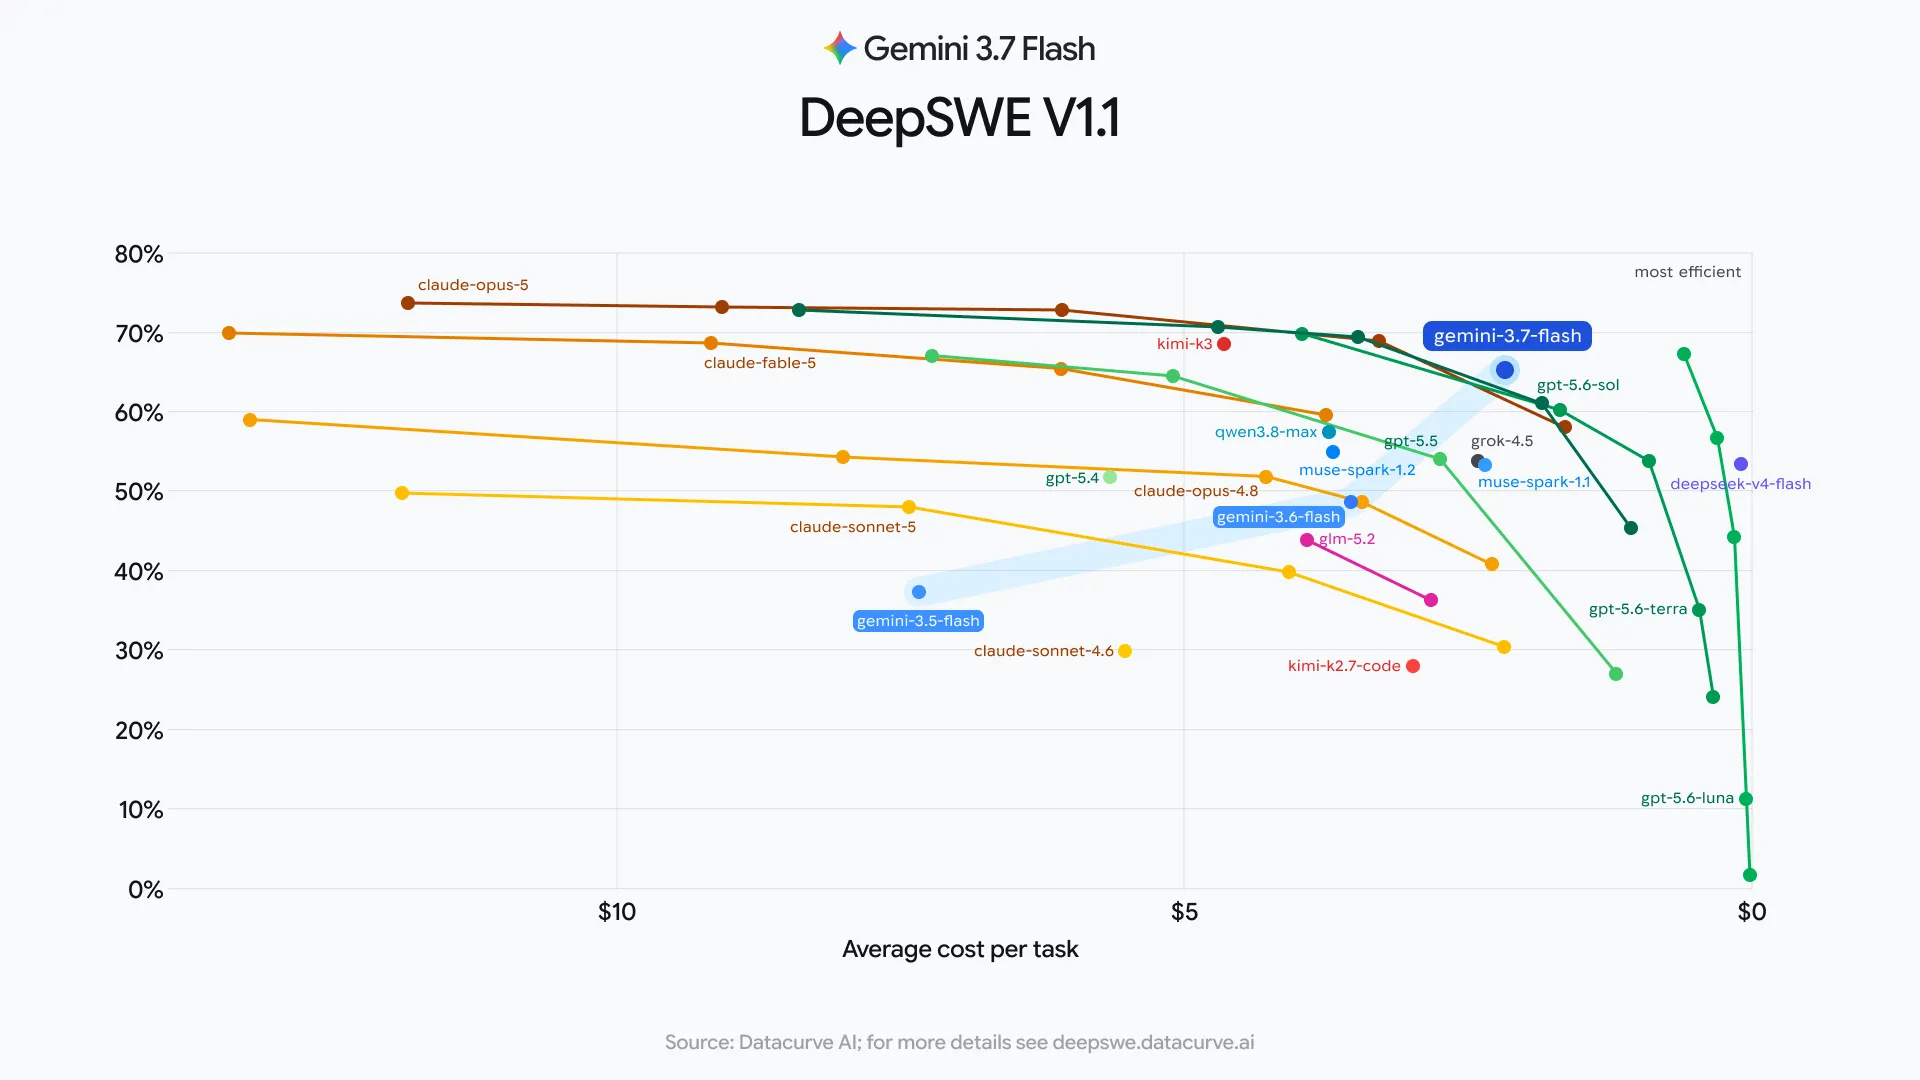
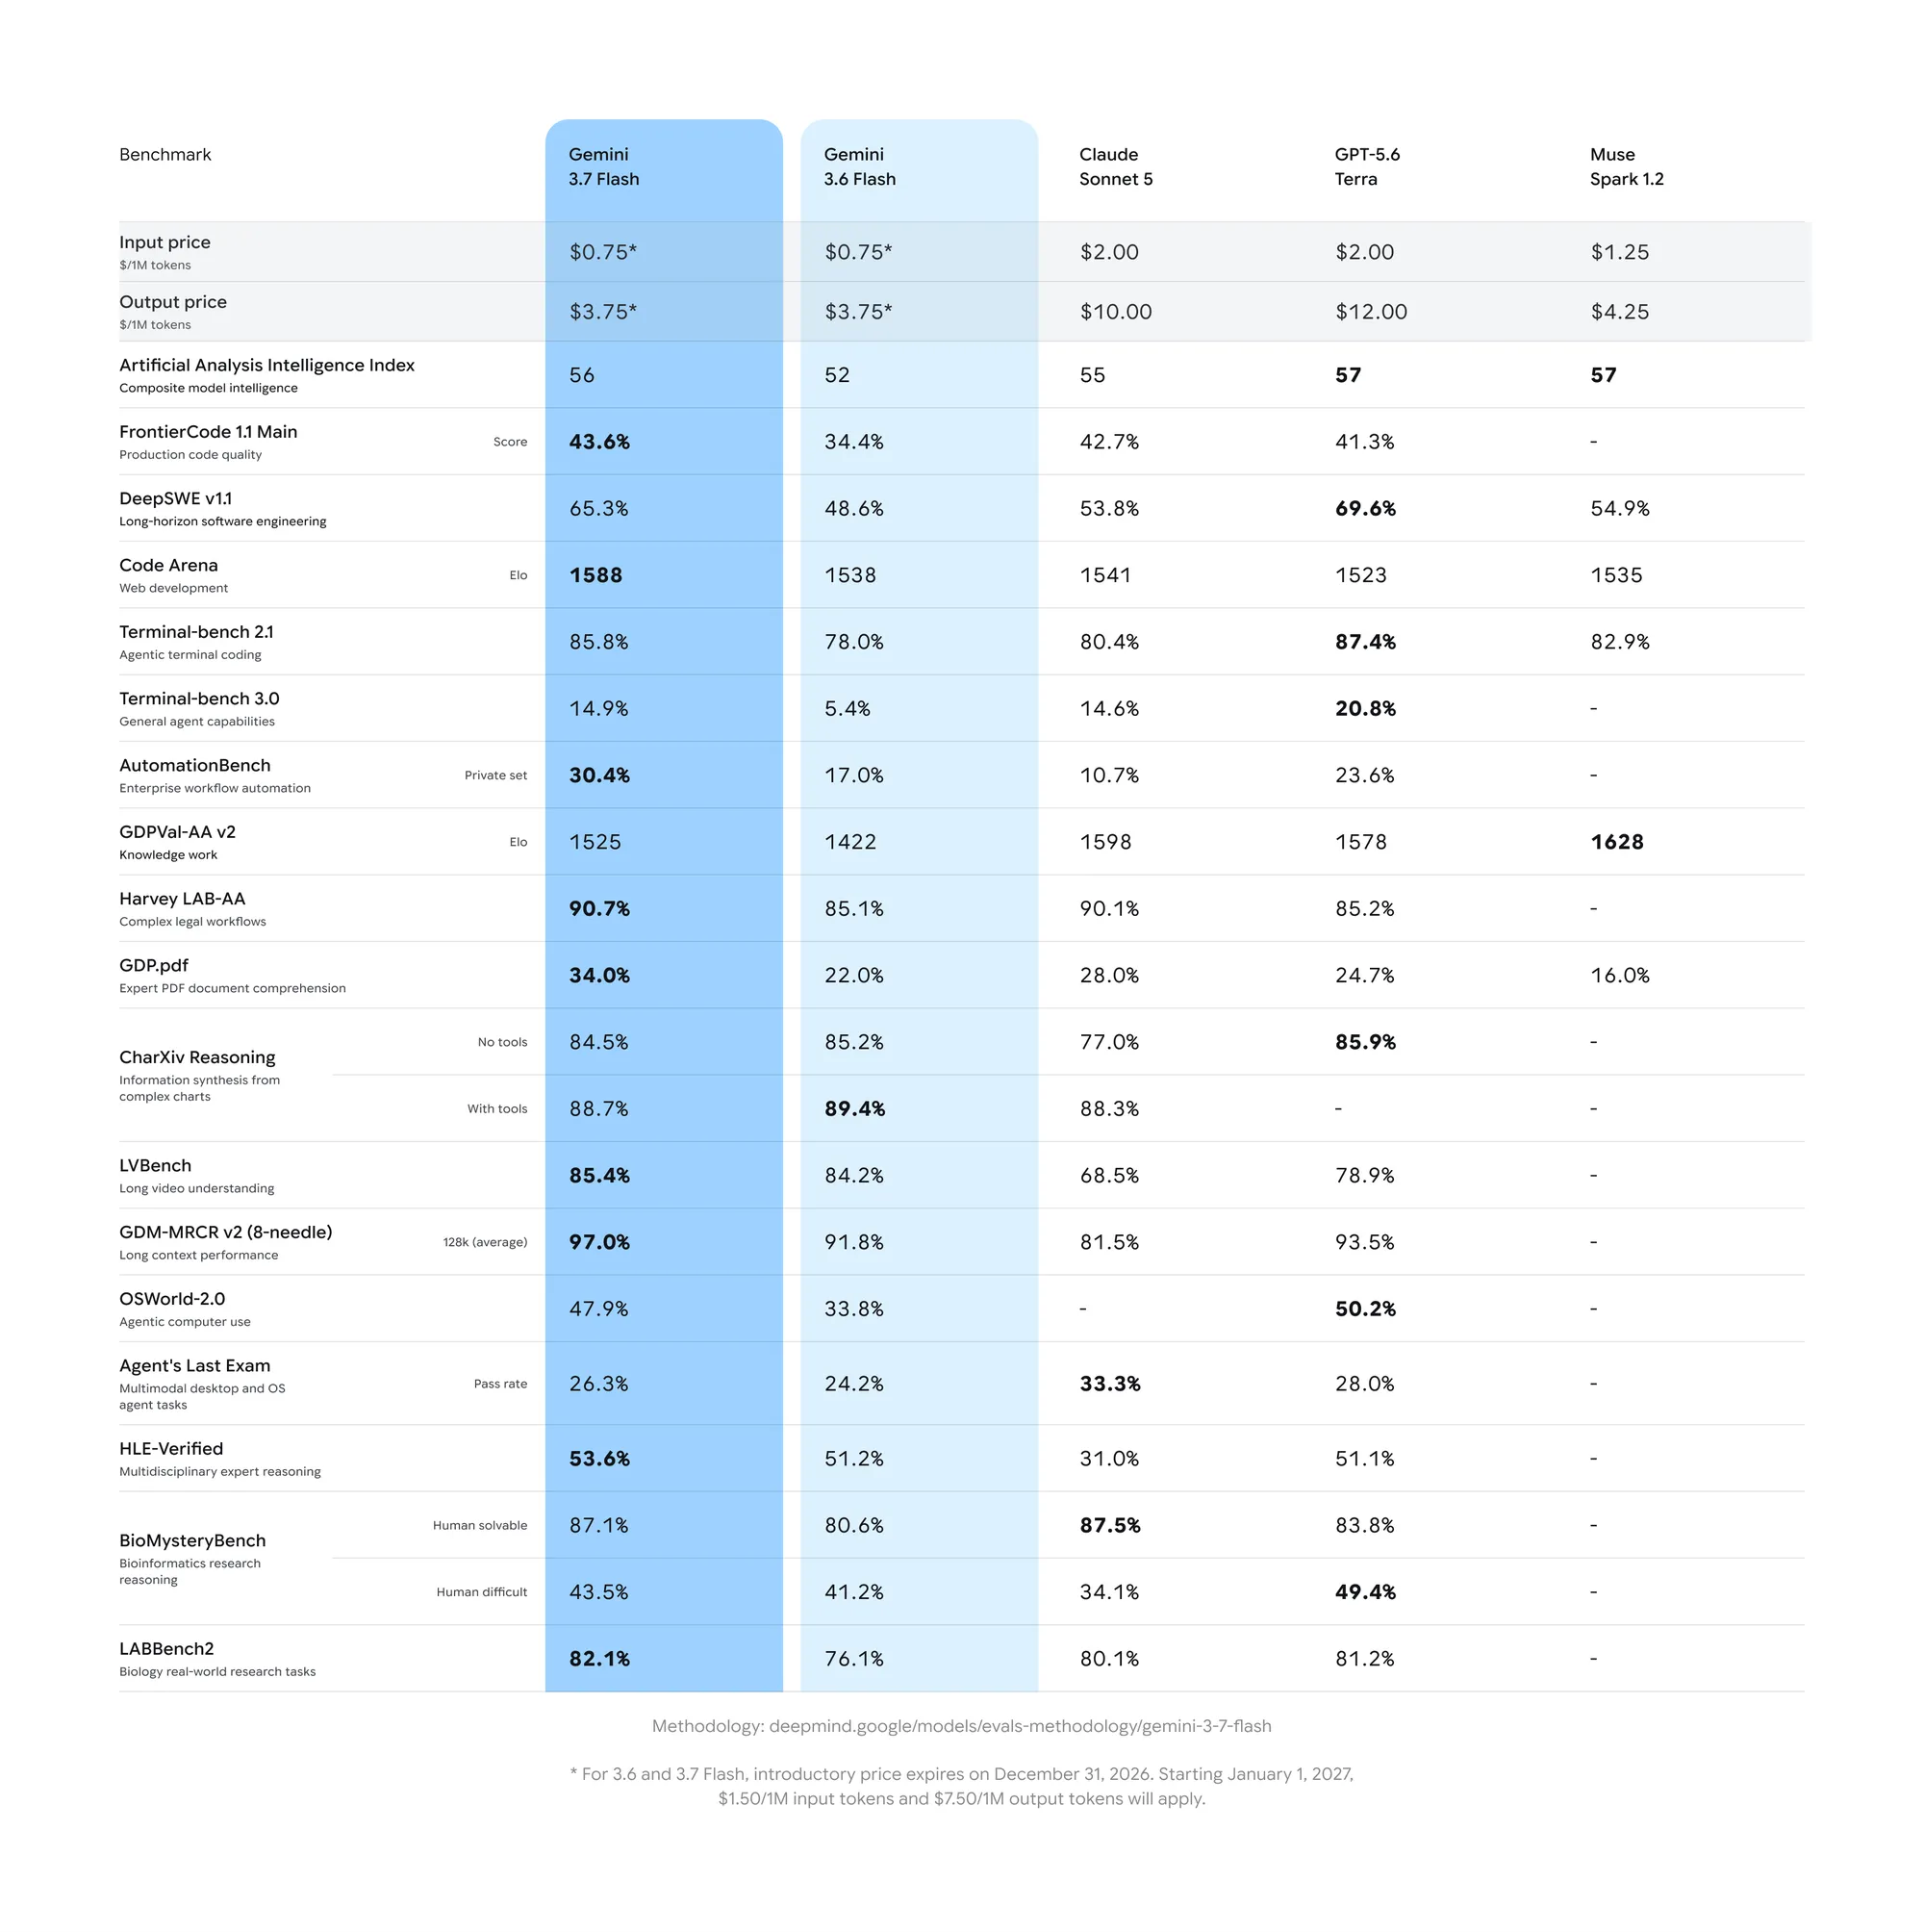
在 FrontierCode 1.1 Main 上,Gemini 3.7 Flash 从 3.6 Flash 的 34.4% 提升到 43.6%。在 DeepSWE v1.1 上,它从 49.0% 涨到 65.3%。如果按相对增幅算,分别约为 27% 和 33%。这不是小修小补,已经足以改变重试队列的长度。
业务自动化的差距更夸张。AutomationBench 从 17.0% 升到 30.4%,接近原来的 1.8 倍。Web 开发也有提升,WebDev Arena 的 Elo 从 1538 升到 1588。
有点子牛逼。
不过这里必须踩一下刹车。厂商基准证明的是「有一批标准任务做得更好了」,不是「你的 monorepo、内部 API 和祖传 CI 也会自动变好」。真实 Agent 最爱死在榜单不考的地方,工具返回了一段半截 JSON,测试容器启动慢了四十秒,仓库里两个同名配置文件互相打架,模型自信地改对了错误的那个。
所以基准的正确用法,不是替你宣布迁移成功,而是告诉你这次值得花时间跑验证。
我尤其在意 DeepSWE 和 AutomationBench 的涨幅。一个贴近软件工程,一个贴近跨应用业务流程,都触碰到了 Agent 最费钱的环节。模型如果真的能减少无效循环和人工接管,哪怕 thinking token 多用一些,系统总账仍可能下降。
关键在「如果」。
Thinking 更勤快,账单也会更勤快
Google 对 3.7 Flash 的描述里有一句很微妙。新模型会在多步规划和工具调用上投入更多思考,更勤快地处理障碍,也更愿意在意图不清时停下来确认。
对质量来说,这是好事。对成本来说,需要拿计算器。
Gemini API 的输出价格包含 thinking token。模型更认真,不等于免费认真。一个长任务如果把推理预算铺得很开,低输入价很快会被高输出量吃掉。再叠上上下文缓存存储、搜索 grounding 和多次工具调用,单看 0.75 美元的输入价,像拿一张地铁票估算整趟出差成本。
缓存也不是天然省钱。上下文稳定、相同前缀反复复用时,缓存很香。可要是每次任务都带一份不断变化的仓库快照,刚存进去就失效,缓存存储费只是给账单加了一个新栏目。Google Search grounding 每月有共享免费额度,超过后按每千次请求收费 14 美元。一个会自动深挖网页的研究 Agent,用起来可比聊天窗口豪放多了。
说真的,这不是 Google 特有的坑。所有按 token 和工具调用计费的 Agent 平台,都在逼工程团队从「模型价格表」升级到「任务单位经济学」。模型越会自主规划,调用链越长,这张账越不能省。
还有年底那条线。
现在是 8 月中旬,推广价还剩四个半月。足够做验证,也足够让团队把一条新流水线跑顺,然后在元旦发现成本模型换了底数。棒棒的,预算会自己长大。
迁移评估里最好同时放两套价格。一套按今天,一套按 2027 年 1 月 1 日。两套结果都能接受,才算真的便宜。只有推广价能接受,那不是架构优势,只是一张有到期日的优惠券。
迁不迁,先跑一张验收账
别急着把全公司默认模型改成 gemini-3.7-flash。先从已经有标准答案的真实任务里抽一批,数量不用夸张,五十到一百个就能看出方向。
代码 Agent 可以选修复过的 issue、依赖升级、测试补全和小范围重构。业务 Agent 可以选资料汇总、表格更新、邮件草拟和状态同步。任务要来自你自己的历史队列,别临时编一套让模型舒服的 demo。
然后把 3.6 Flash 和 3.7 Flash 放进同一条 Harness,也就是让模型真正干活的那层脚手架。系统提示词一样,工具描述一样,超时和重试策略一样,能缓存的上下文也一样。否则你改了模型又顺手改了工具协议,结果分数涨了,谁立的功根本说不清。
每个任务至少记下输入 token、缓存命中、输出与 thinking token、工具调用次数、搜索次数、墙钟时间、重试次数、人工接管次数和最终是否通过。平均值可以看,但别只看平均值。Agent 最折磨人的往往是尾部,P95 延迟和最贵的那 5% 任务,才决定告警会不会半夜把人叫醒。
还有一件容易漏掉的事,失败要分型。
模型理解错需求,工具参数拼错,外部 API 超时,拿到错误结果后没发现,这四种失败的修法完全不同。把它们全塞进「失败」一栏,只能得到一个百分比,得不到下一步怎么改。
跑完后,按今天的推广价算一次每个成功任务成本,再按元旦后的正式价重算一次。如果 3.7 Flash 在两套价格下都更划算,而且 P95 延迟、人工接管和失败类型没有恶化,就迁。如果只有跑分赢、系统账没赢,先把它放在路由器里做部分任务,别一键替换。
坦率讲,我更看好这种混合路由。让 Flash 处理高频、可验证、能快速回滚的任务,卡住时再升级到更强模型。便宜模型不是用来接住所有活的,它最适合把大多数普通活做得足够稳,让昂贵模型只处理真的难题。
Flash 模型在抢的不是低价位
Gemini 3.7 Flash 距离 3.6 Flash 只有三周。这个节奏本身就挺值得琢磨。
过去提到 Flash,大家默认它是快、便宜、能力差一档的副手。现在 Google 给它的定位是 coding and agents 的 workhorse,真正扛日常生产负载的主力。模型市场正在从「最强模型争第一」转向另一个战场,谁能用更低的单位任务成本,把海量普通工作稳定做完。
这也是为什么首轮通过率比单张榜单更关键。前沿模型负责展示上限,主力模型负责吞掉账单。后者每少一次重试,乘上每天几十万次任务,都是实打实的基础设施钱。
Google 这次给出的官方数据足够让人兴奋,模型卡 和安全说明也补得比较齐。但我始终觉得,生产环境不该被发布会情绪接管。先测自己的任务,算成功结果,不拿促销价当永久价,再决定把多少流量交出去。
那张 0.75 美元的价格牌当然好看。
只是船真正离港以后,油耗从来不写在船票正面。