posts/github-hydrafusion-routing.md
写代码选模型,GitHub 把 67% 成本差塞进路由器
你在终端里让 Copilot 修一个跨文件 Bug,最磨人的往往不是提示词,而是模型菜单。小任务想省一点,大任务又怕模型不够用,到头来还是凭感觉点了最贵的那个。账单出来再叹气,多少有点熟悉。
GitHub 在 9 月 4 日放出了 Project HydraFusion 研究预览。它不是新模型,而是把「这题该用谁、要不要复核、答得不够好要不要升级」放进一次运行时决策里。好家伙,模型选择终于开始像一条工程流程了。
官方给了三条路径。简单活走 Single,一个模型直接干。难一点的走 Cascade,先让效率高的模型写,质量闸门觉得不够再升级。需要第二双眼睛的走 Critique,换一个模型家族在只读环境里挑错,再让原模型改一轮。
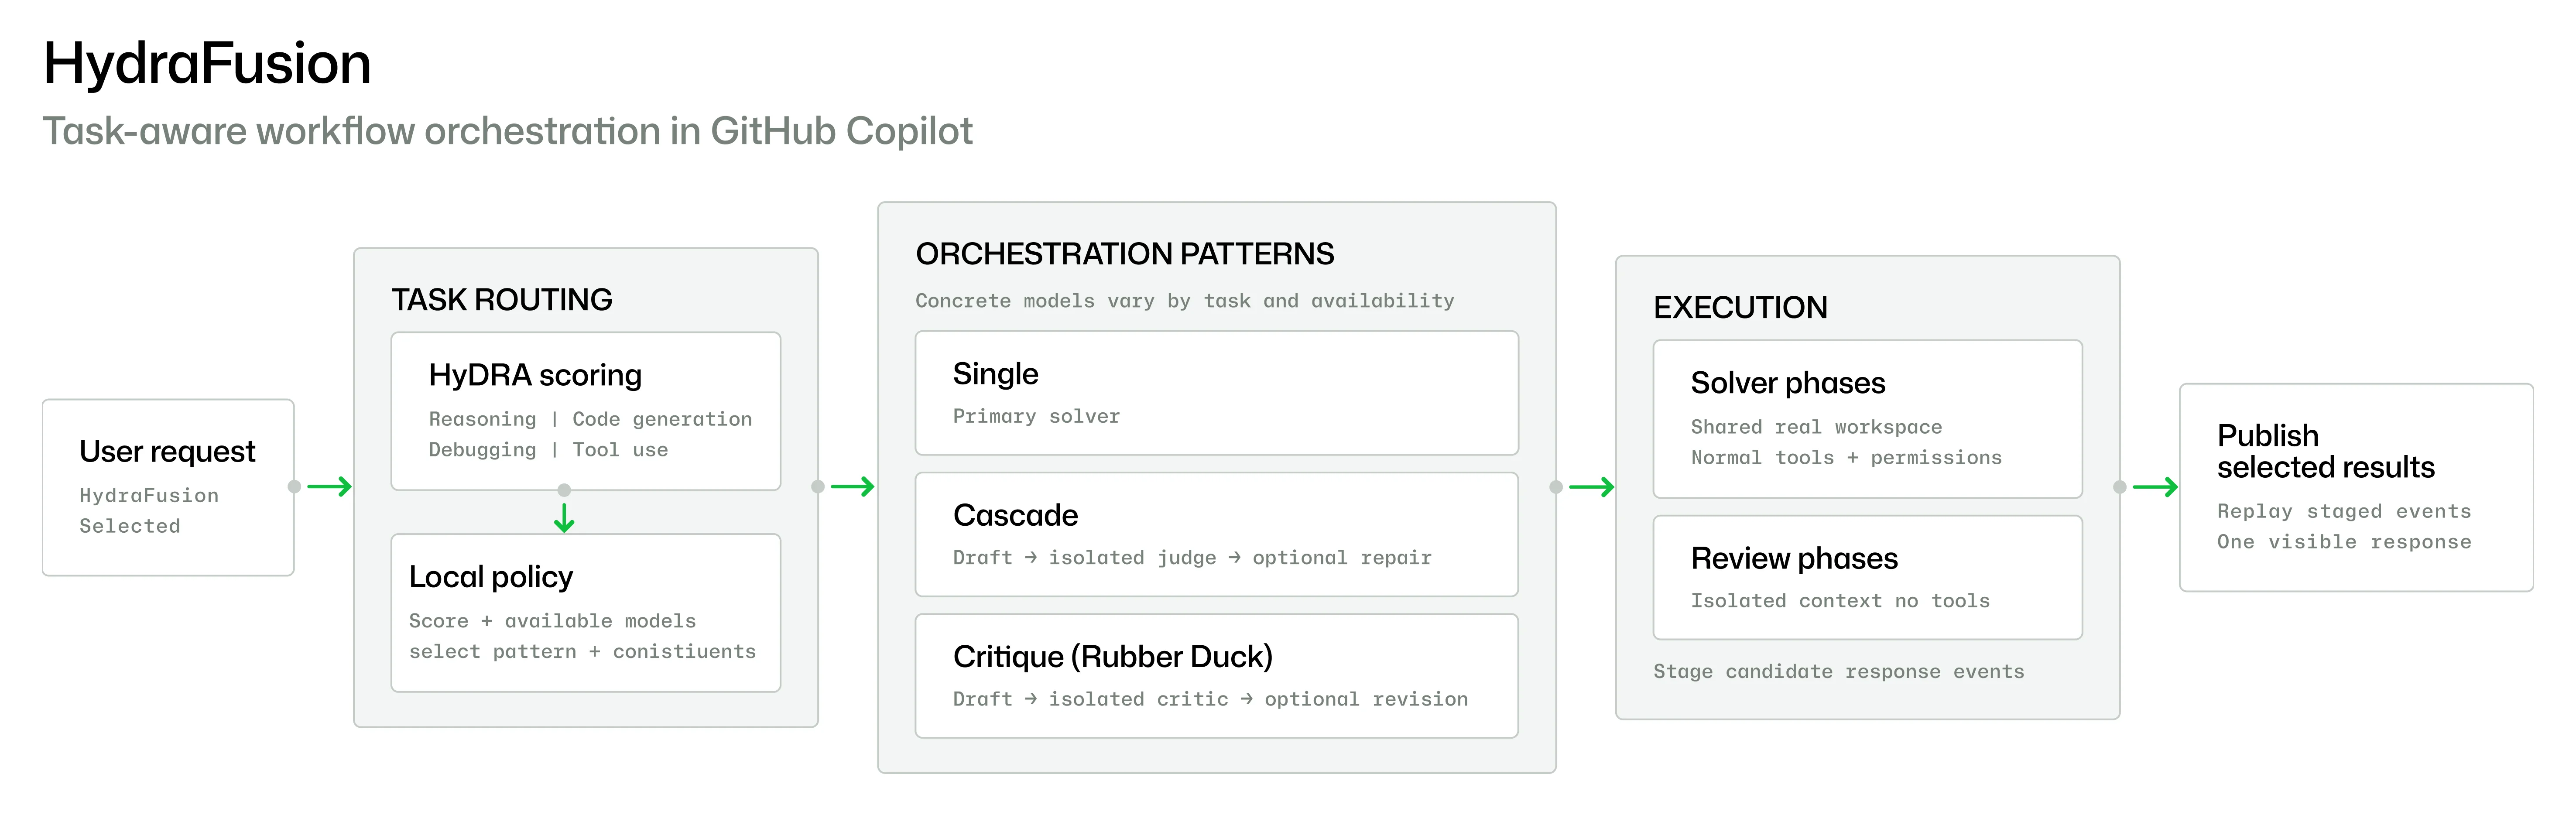
图,GitHub 官方架构图把单模型、级联与独立审查放进同一个任务入口。
这听上去像多 Agent 的老话题,可真正值得盯的不是它会叫几个模型,而是 GitHub 把账算到哪里。官方说,每一段起草、审查、修订、升级、重试和回退都要进成本统计。超时和取消要有边界,审查模型不能改仓库,工作流取消或校验失败就不应用补丁。
这几句很朴素,却比「自动路由」四个字值钱。模型路由一旦只看首轮 Token 单价,很容易搞出一个看起来便宜、实际把重试和返工都藏起来的省钱方案。成本不是模型单价,是一次任务从起草到能合并的全链路消耗。
GitHub 的离线数据也刚好说明了这点。在 TerminalBench 2.1 上,HydraFusion 相对 Opus 5 的已验证任务质量高出 4.9 个百分点,估算工作流成本低 67%。但到了更像大型仓库任务的 DeepSWE,成本低 36%,质量反而低 1.5 个百分点。CheckpointBench 里质量只低 0.1 个百分点,成本低 65%。
图,官方把质量与完整工作流估算成本并排展示,三项基准没有给出同一种答案。
所以别把 67% 当成「上了就省 67%」的优惠券。它是受控离线评测里的估算值,绑定了基准版本、模型池、价格假设和中等推理级别。GitHub 自己也写得很直白,研究预览阶段正是在验证它能不能迁移到真实开发工作负载。
我更愿意把这次预览看成一条试用方法,而不是新的默认开关。你如果正用 Copilot CLI,可以先更新到最新版,再依次输入下面三条命令。
/update
/experimental on
/model
然后别一上来把长期重构、线上配置或安全改动扔进去。官方推荐的是边界清楚、单轮单提示词、但又足够有分量的任务。比如一处能用测试验收的跨文件 Bug,或者范围明确的功能补齐。先让它跑完,再对着测试结果、实际耗时和账单看,不要只看它给你的那段解释。
给团队试用时,我会先守住三件小事。第一,任务必须有可验证的退出条件,测试、快照、构建结果都行。第二,把预览期的实际任务成本单独记出来,和原来的单模型流程并排看。第三,涉及权限、部署和安全的改动,仍然保留人类审查,别把 Critique 当成签字人。
厉害了,这三件事没什么新潮名词,却能拦住大部分「省了 Token,赔了返工」的幻觉。HydraFusion 真正有意思的地方,也不是替开发者把模型菜单藏起来,而是逼着工具开始交代,谁做了什么、花了多少、失败时有没有把半截补丁塞进仓库。
GitHub 现在只把它放在 Copilot CLI 的研究预览里,模型、工作流和行为都可能继续变化。可以试,尤其适合想少手挑模型的人。只是先把验收和核账摆在前面,才不会让路由器替你决定一切。
如果你要拿它做第一项试用任务,你更愿意给它一处可自动化测试的 Bug,还是一段需要第二个模型挑错的重构?