posts/glm53-flash-real-traffic.md
GLM-5.3 Flash 拿下 20% 流量,跑分只是第二战场
一个没有名字、没有公司标识、甚至没有正式价签的模型,先在 OpenRouter 跑了一周,拿到接近 20% 的周 token 份额,然后才公布自己是谁。
发布会的顺序,被倒了过来。
8 月 26 日,智谱揭晓匿名模型 ox-alpha,它就是新发布并开放权重的 GLM-5.3-Flash。总参数 320B,每个 token 只激活 18B,原生支持多模态,采用 MIT 协议。智谱首席科学家唐杰随后在公开声明里给出一组更扎眼的数据,Artificial Analysis 得分 57,价格约为前沿模型的百分之一,推理由国产芯片承载,OpenRouter 周 token 份额接近 20%,排名第一。
好家伙,身份还没亮,真实用户先替它投了票。
但我不太想把这篇写成又一篇「国产模型跑分追平 Opus」的喜报。跑分当然重要,低价也很香,可如果你真的在给 Agent 选模型,决定它能不能进生产的从来不是一张榜。
我更在意三道门。
陌生用户愿不愿意真用,完成一次任务到底花多少钱,服务栈能不能在大规模流量下稳住。
GLM-5.3-Flash 有意思的地方,是它同时把脚迈进了这三道门。至于有没有完全跨过去,还得把热闹拆开看。
匿名上线,测到的是选择,不是品牌
大模型发布通常有一套熟悉流程。先发博客,再贴基准图,然后让开发者带着品牌预期去试。
这次正好反着来。
智谱先把模型以 ox-alpha 的名字放到 OpenCode 和 OpenRouter,不说开发商,不讲架构,也不靠品牌把流量推过去。官方称,它很快成为当周最受欢迎的模型。唐杰公布的口径是接近 20% 周 token 份额,排在第一。
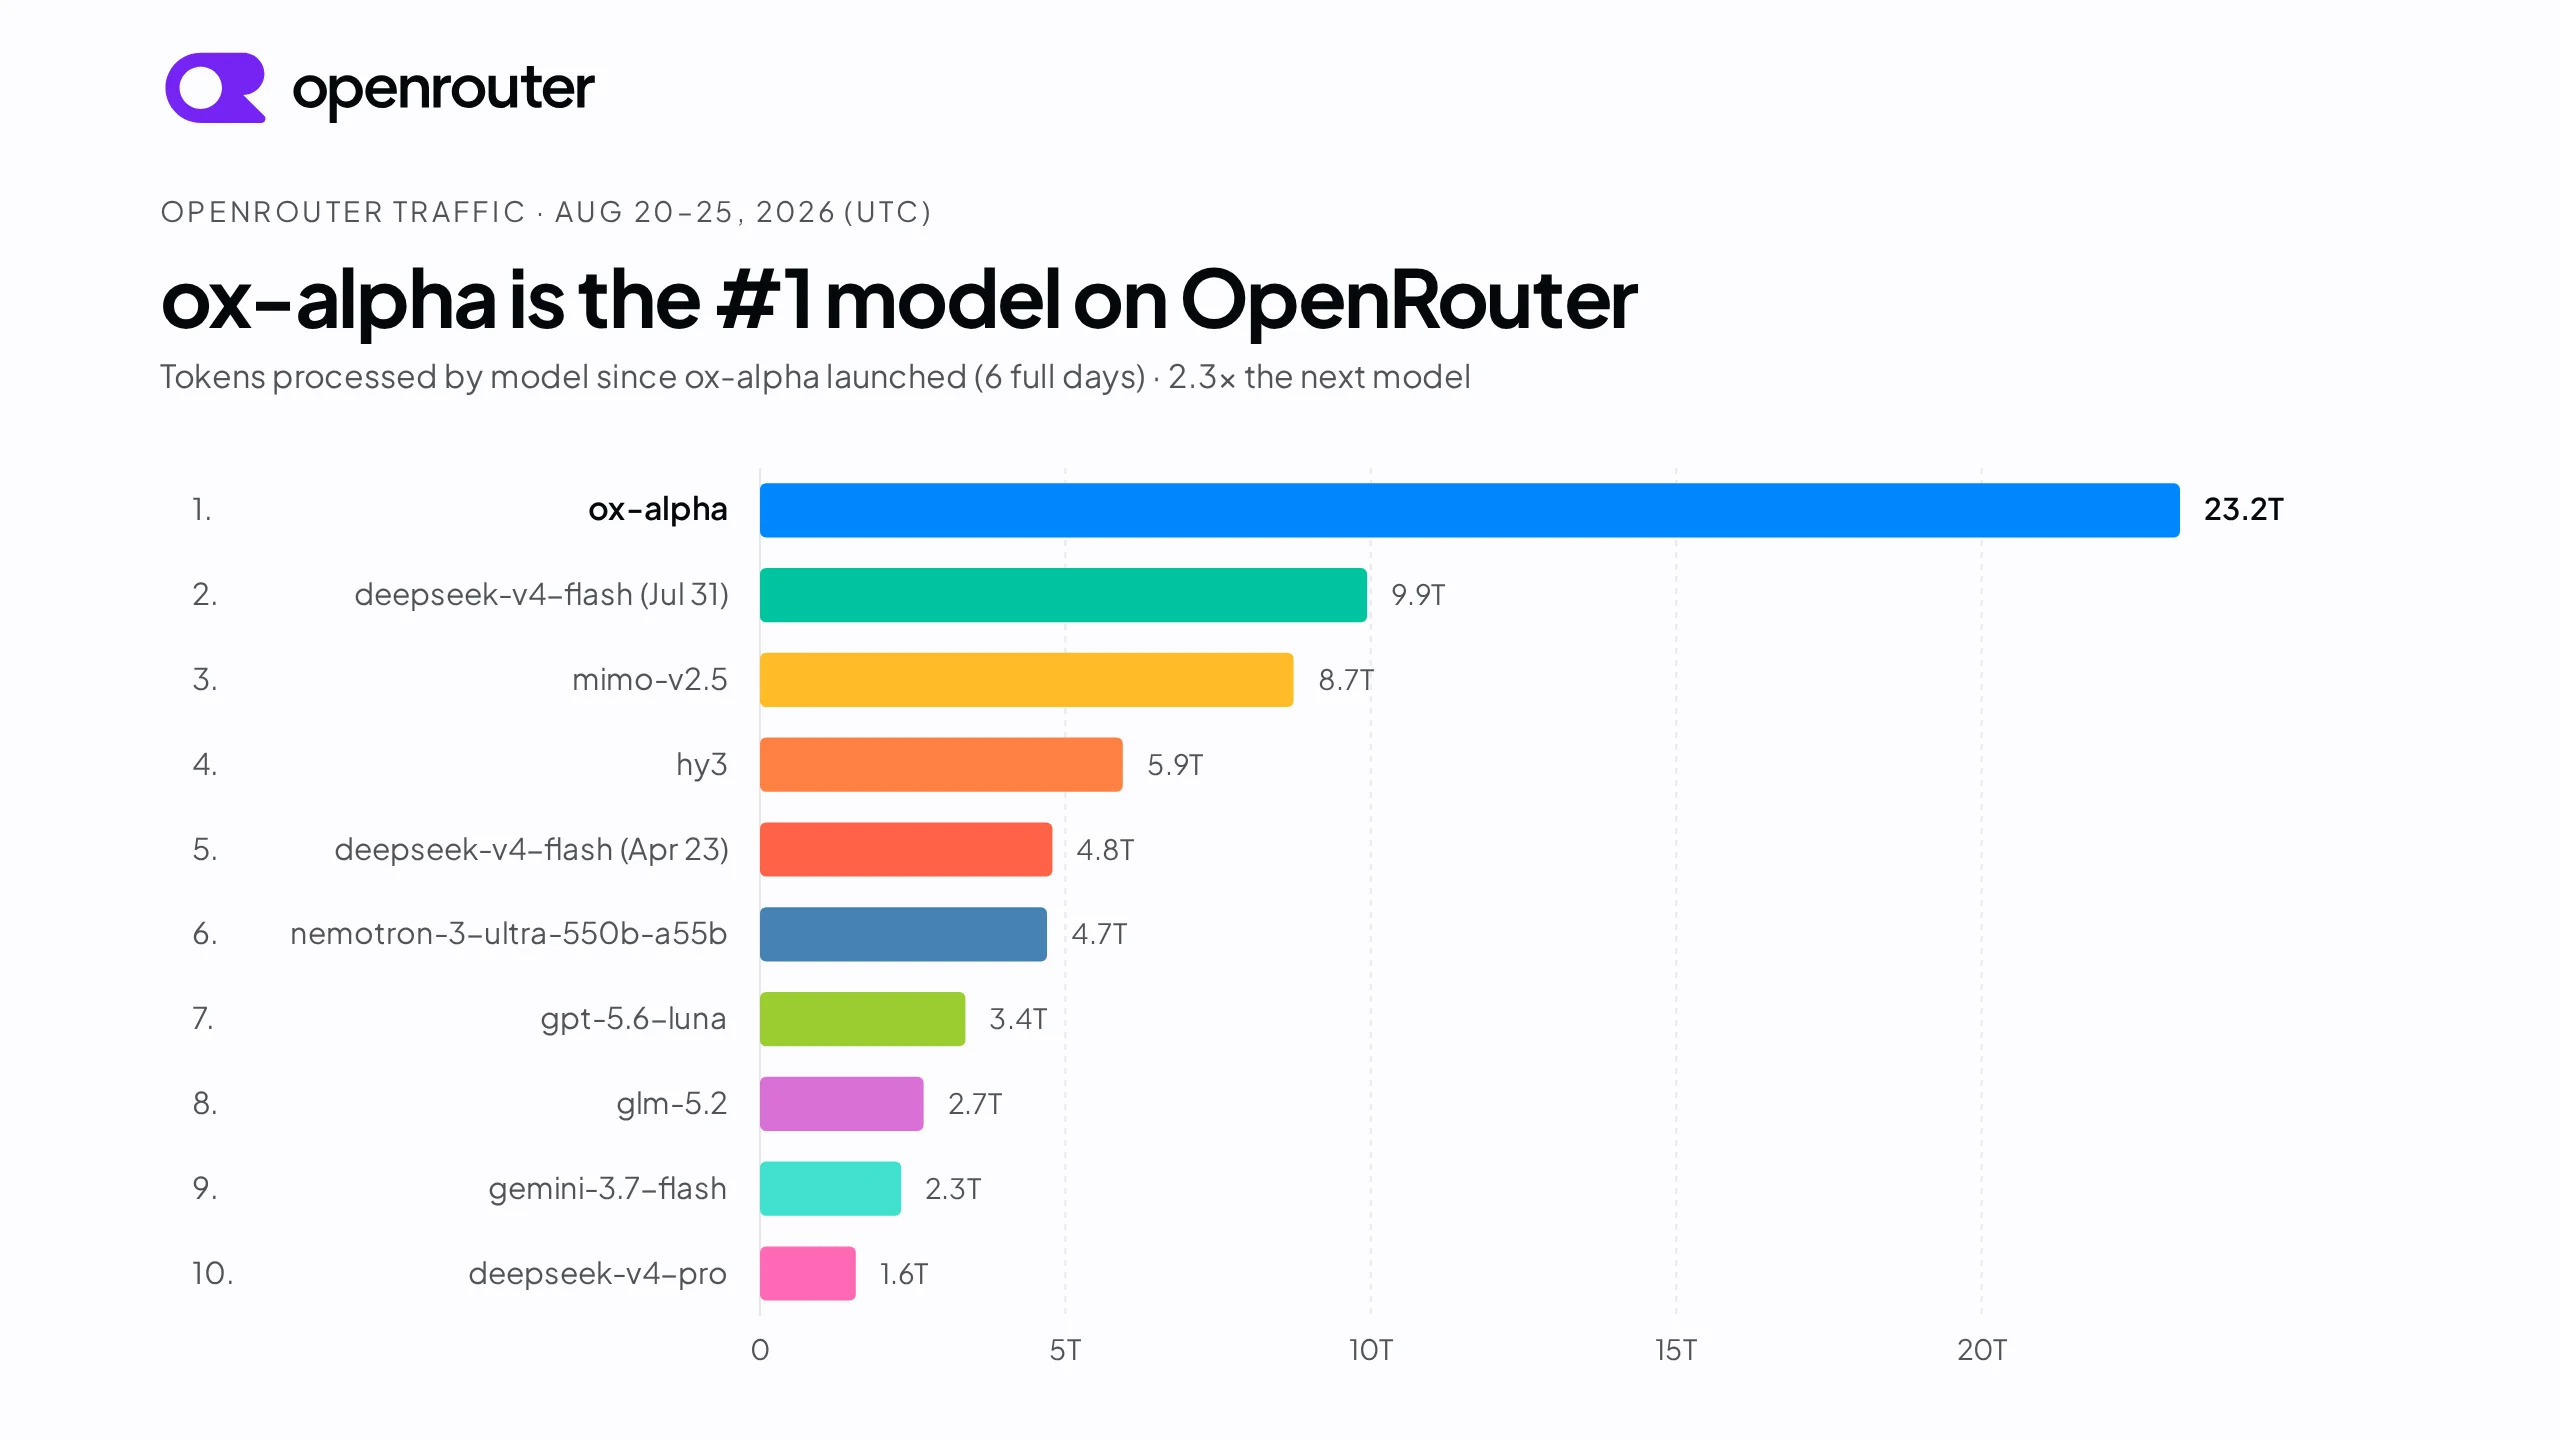
官方发布中的 OpenRouter 流量图。匿名模型拿到的是真实调用,不是固定题库里的选择题。
这个实验比普通盲测更接近真实选型。开发者不是在固定题库里点 A 或 B,而是把自己的代码、工具调用、长上下文和各种奇怪任务塞进去。模型如果老超时、工具参数写不对、改坏仓库,免费也很难让人持续调用。
所以,真实流量给了 GLM-5.3-Flash 一个挺硬的正面信号。它至少没有在陌生用户的杂乱任务里当场露馅。
可这份成绩也不能吹得太满。
匿名测试期间有免费流量和新模型猎奇加成,token 份额不等于付费留存,更不等于企业采购。一个模型被大量调用,可能是因为它效果好,也可能是因为它免费、上下文长、刚好被默认路由选中。很多朋友可能不知道,聚合平台上的 token 份额还会被输出长度放大,同样完成一个任务,话多的模型天然吃掉更多 token。
这一点刚好能在 Artificial Analysis 的独立页面上看到。GLM-5.3-Flash 的 Intelligence Index 是 57,但完成整套评测用了约 1.5 亿输出 token,高于同类模型约 1.1 亿的中位数。它很聪明,也确实偏能说。
因此我会把 20% 当成「真实需求验证通过」,不会把它当成「商业胜负已定」。下一轮更难,折扣结束后还有多少请求愿意留下,路由器会不会继续把高价值任务交给它。
这才是身份揭晓后的考试。
每 token 便宜,不等于每个任务便宜
模型价格最容易把人带沟里。
大家习惯盯输入、输出每百万 token 的单价,然后拿计算器一除,得出它比某个前沿模型便宜几十倍。这个数字很适合做海报,却不一定适合做预算。
Agent 账单真正该看的,是完成一个任务的总成本。
总成本里有输入 token、输出 token、缓存命中、工具调用次数、失败重试、推理时长,还有最贵的一项,人来收拾残局的时间。一个模型单价只有另一个的五分之一,但它每次要多写两倍 token,再多重试一次,省下来的钱很可能当场蒸发。
智谱官方给出的折扣口径是每项任务 0.045 美元,约为同等智能水平模型的十分之一。Artificial Analysis 当前页面给出的观测略保守,输入每百万 token 0.15 美元,输出 0.50 美元,综合每项任务约 0.09 美元。两套数字来自不同折扣和测试时点,不能硬凑成同一个结论。
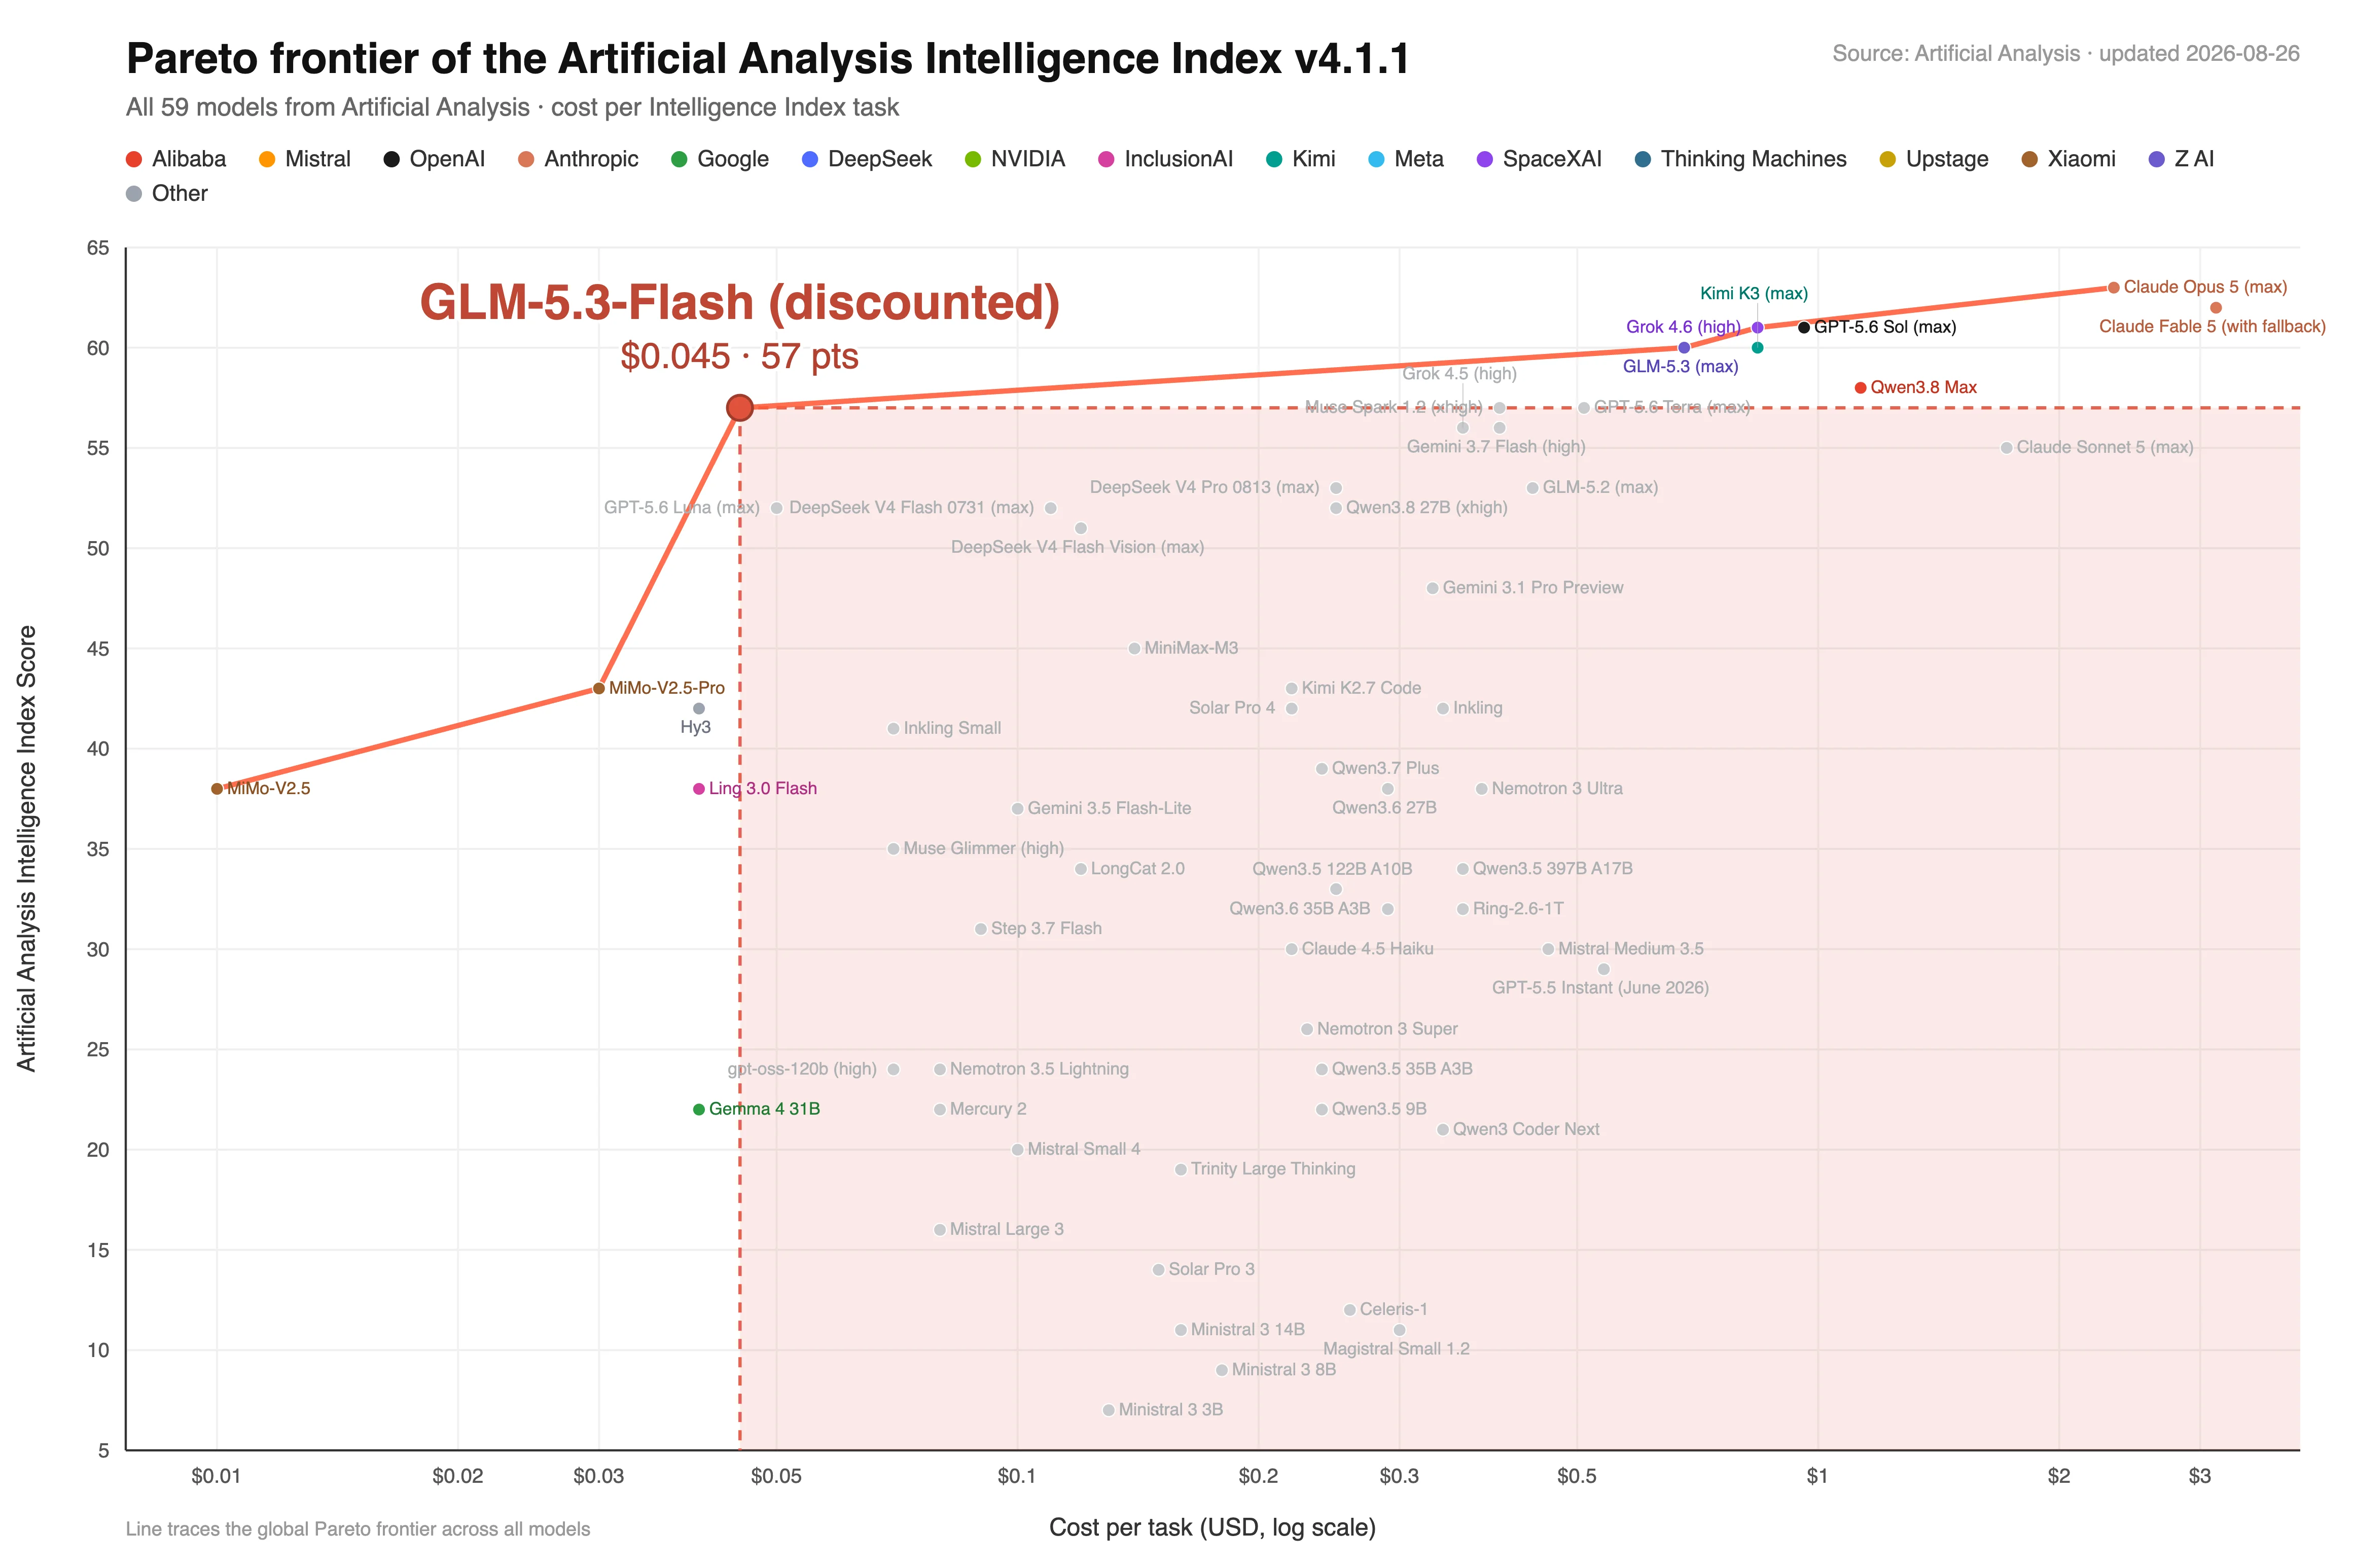
官方引用的 Artificial Analysis 帕累托图。横轴是每任务成本,不是单看 token 价。
不过方向很清楚,GLM-5.3-Flash 确实把能力成本曲线往下压了一截。
代价也写在同一页上。它当前输出速度大约 50 tok/s,低于相近开放权重模型约 67 tok/s 的中位数。首 token 延迟不错,长回答的尾部却可能拖。你做离线代码审查,慢一点也许无所谓。你做浏览器操作、客服协作或人机实时结对,模型每一步都多等几秒,整个 Agent 就会像网速不好的远程桌面。
厉害了,低价模型又把老问题送回来了。
成本、速度、输出长度,得一起看。
如果团队真想试,我建议别先跑一百道通用题,直接从生产流量里抽一小批可回放任务。记录每个任务的成功率、总 token、墙钟时间、重试次数和人工接管率。再用「成功任务总成本」排序,而不是用输入单价排序。
公式不复杂。
成功任务总成本 = 模型费用 + 重试费用 + 工具费用 + 人工接管时间这张表一跑,很多宣传里的百分之一价格会缩水,也可能反过来证明 GLM-5.3-Flash 真省。无论是哪种结果,都比盯着价签猜靠谱。
18B 激活参数背后,是一场内存战争
为什么它能便宜到这个位置?
官方给的答案不是一个魔法技巧,而是模型架构和推理系统一起改。
GLM-5.3-Flash 有 320B 总参数,单个 token 只激活 18B。跟 GLM-4.5 系列相比,总参数规模接近,激活参数从 32B 降到 18B,网络层数从 92 层降到 45 层。MoE(Mixture of Experts,混合专家)可以把它理解成一个很大的专家团队,每次任务只叫少数人进会议室,不让 320B 参数全部开工。
长上下文又用了线性注意力和稀疏注意力的混合结构。线性注意力负责压缩局部历史,稀疏注意力通过轻量索引器找回重要的全局信息。到了 1M token 上下文,IndexPool 再把四个索引器 key 向量压成一个。
官方对比显示,相对 GLM-5.3,注意力计算量降低 3 倍,KV cache 缩小 4.4 倍。KV cache 是模型生成时保存历史注意力状态的缓存,上下文越长,它越像一只不停膨胀的行李箱。能缩 4.4 倍,不只是省显存,也会改变并发量和每个请求的部署成本。
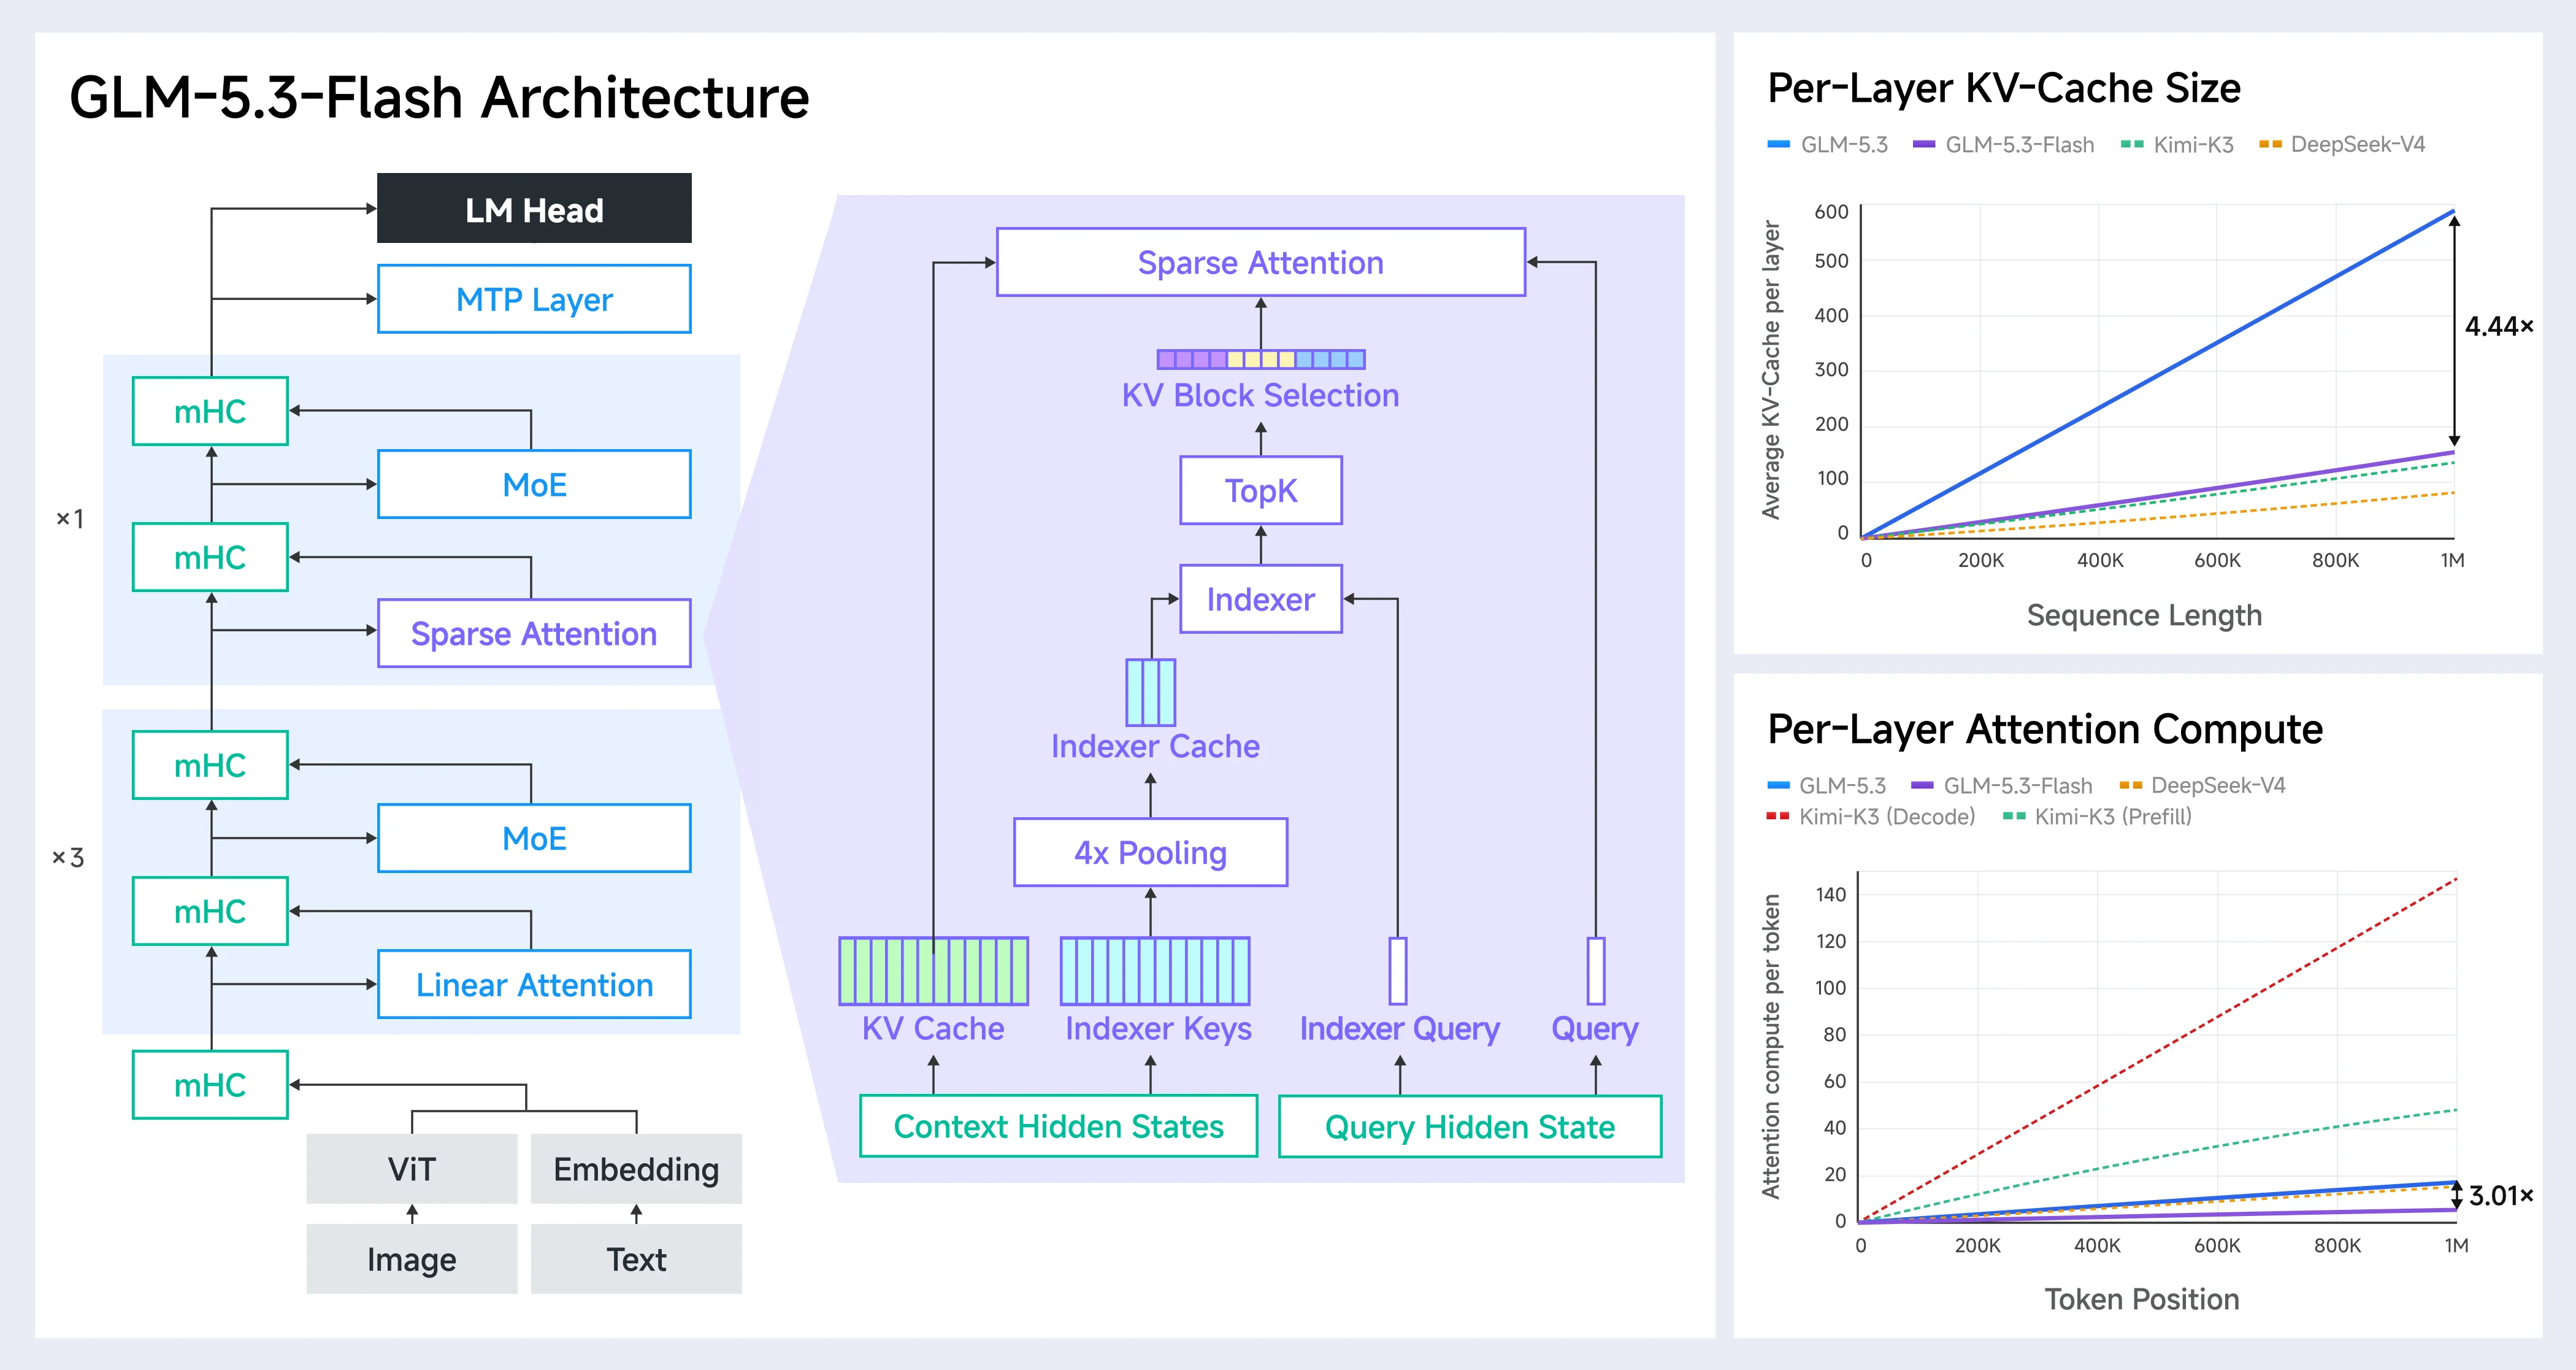
左侧是模型主干与稀疏索引流程,右侧两张曲线分别展示 KV cache 和注意力计算量。
不过这里有个很诚实的细节。GLM-5.3-Flash 的 KV cache 仍比 Kimi-K3 和 DeepSeek-V4-Flash 略大,官方原文直接写了「还有进一步改进空间」。我很喜欢这种句子。跑分图负责展示赢了什么,这一行小字告诉工程师还会在哪儿疼。
模型架构之外,GLM-5 技术报告和新的模型卡也把部署入口摆了出来。权重已经放到 Hugging Face,当前支持 SGLang、vLLM等推理框架。
但 320B 总参数不会因为只激活 18B 就凭空消失。本地部署仍要面对权重存储、跨卡通信、量化精度、预填充峰值和长上下文缓存。普通开发者看到「18B 激活」别直接脑补成一张消费级显卡轻松带走,参数要放得下,数据还得搬得动。
有点子牛逼,但不是桌面魔法。
国产卡真正过的,是持续服务这关
这次最容易被一句「国产芯片承载」带过去的部分,恰恰是整件事最难的部分。
模型能在某张卡上跑起来,和模型能在大规模集群上稳定对外服务,中间隔着一整片海。
智谱称,过去一周的匿名测试流量由国产 AI 芯片集群承载。单卡计算和内存容量有限,他们在 SGLang 上为这套架构做了专用推理引擎,用 W8A8 量化、混合精度 KV cache、张量并行、ReplaySSM 和 Layer Split 等办法抠内存与带宽。
到了集群层,系统把 Encode、Prefill、Decode 拆成独立工作池。Encode 负责多模态编码,Prefill 负责读入整段提示词,Decode 负责逐个生成 token。三种阶段吃资源的方式不同,绑在同一批机器上很容易互相堵。拆开后可以独立排队、独立扩容,像把仓库收货、分拣和配送从一个大屋子拆成三条流水线。
官方称,端到端服务性能相对同硬件初始基线提高 3 倍,每 token 成本已经能和主流 NVIDIA GPU 方案放在同一张表里比较。
这句比「模型能适配国产卡」重得多。
适配只证明能启动。真实流量证明故障恢复、批处理、尾延迟、内存碎片、跨机通信和监控告警至少被一起处理过。一个演示跑通十分钟不难,连续吃掉平台上的海量请求,还没被用户集体切走,才接近生产系统的标准。
当然,目前我们看到的大部分基础设施数据仍来自智谱自己,缺少公开的错误率、P95 延迟、集群利用率和故障统计。坦率讲,我希望下一步不是再多一张峰值吞吐海报,而是把这些难看的数据也放出来。平均值总是很漂亮,生产事故通常住在尾巴上。
真要接入,先给它一个可撤回的位置
模型发布当天,最危险的动作不是完全不试,而是把默认路由一把切过去。
更稳的办法,是给 GLM-5.3-Flash 一个可撤回的位置。
可以从低风险、可自动验收的任务开始,比如生成单元测试、整理代码搜索结果、给已有 PR 做第二意见、把长文档压成结构化字段。不要一上来让它改生产配置、碰支付流程或拿长期凭据。不是说模型一定会出事,而是任何刚上线的模型都不配跳过权限设计。
路由层至少要记五类指标,任务成功率、成功任务总成本、P50 与 P95 延迟、重试率、人工接管率。如果是长上下文任务,再单独看缓存命中和上下文长度分桶。一个平均分会把短请求的轻松和长请求的惨烈搅在一起,到头来谁都看不懂。
还要保留基线模型做影子对比。相同输入同时送两边,GLM-5.3-Flash 的结果先不影响用户,只在后台做验收。跑够一批真实任务,再逐步从 1% 放到 5%、20%。指标坏了能自动退回,不需要开会决定要不要认错。
反正我觉得,模型路由器最重要的能力不是总能选中冠军,而是冠军发挥失常时,业务还能继续走。
如果它在你的任务上真的做到接近前沿能力、显著更低的成功任务成本,并且国产卡服务稳定,那就把更多流量给它。要是长回答太慢、token 用量失控、工具调用频繁重试,也别因为排行榜好看硬撑。
真实生产不会给模型颁忠诚奖。
它只看任务有没有完成,账单有没有守住,凌晨告警有没有少一点。
GLM-5.3-Flash 这次最漂亮的一步,不是 57 分,也不是百分之一的宣传口径。它先摘掉名字,让真实流量把模型推到台前,再用架构和服务栈解释这份流量为什么可能成立。
名字是后来才贴上的。
下一张成绩单,也该由真实任务来写。