posts/glm53-open-source-gap.md
GLM-5.3 先拿开源第一,权重还在路上
一款权重还没放出来的模型,已经拿到了「开放权重编程第一」的头衔。
GLM-5.3 今天发布,官方给出的时间表很清楚,API 和 Coding Plan 现在能用,模型权重两周后开放。
好家伙,这个时间差很适合制造两种极端反应。
一种是看到 Terminal-Bench 3.0 从 4.6 涨到 28.3,立刻宣布开源模型改朝换代。另一种是盯住「两周后」,认定权重没出来就不配谈开源。
我觉得两边都着急了。
Z.ai 的官方博客里其实放了足够多的细节,让我们把今天已经交付的东西、厂商自己的评测,以及两周后才能验收的承诺分开看。拆开以后,这次发布比一张排行榜有意思得多。
一个有点尴尬的时间差
先把最容易吵起来的词放桌面上,什么叫开放权重模型。
在开发者手里,它至少有三层。
最外面一层是 API 能调用。今天把模型名换成 glm-5.3,请求能跑,真实任务能测,这一层已经交付。
中间一层是评测能不能复现。厂商给了 harness、上下文、采样参数、超时和运行次数,外部团队可以尽量搭出同样的环境。GLM-5.3 的博客把不少脚注写得很细,但有一部分数据来自私有的 Z.ai Code Bench,外面仍然没法独立复跑。
最里面一层才是大家平常说的开源交付,权重文件、许可证、模型卡、校验值、推理框架适配,以及别人下载以后真的能跑出接近的结果。这一层今天没有,官方承诺两周后给。
所以「权重还没开放」是事实,「这次只有一张 PPT」又不准确。API 已经在服务,公开基准给了方法,真正缺的是本地部署所需的核心产物。
怎么说呢,开源不是一盏啪地亮起的灯,更像一次分批上线。问题不在分批,问题在厂商如果提前用了「开源第一」的标签,读者就有理由把两周后的权重发布当成一次正式验收,而不是可有可无的赠品。
这不是抬杠,是工程习惯。
接口文档里写「稍后支持」,程序员默认会在 issue 里留一个勾。时间到了,代码、许可证和复现记录都得回来把这个勾划掉。
真正值得看的不是一句开源第一
GLM-5.3 与 GLM-5.2 使用同一个基座。官方那句英文写得很直接,所有提升都来自后训练。
这才是本次最有点子牛逼的地方。
没有换更大的底座,没有靠一轮新预训练制造代际叙事,而是继续扩训练环境、任务种类和计算量。官方沿用了 IndexShare、SAO 和开源的 slime 训练栈,把任务从短小的代码题推向完整的专业工作。
一个机器学习基础设施任务,不再是补一段函数。模型要拿到计算集群、存储系统、内部文档、代码库和实验结果,找到训练瓶颈,改代码,跑实验,还得证明速度上去了、正确性没丢。
这玩意已经不是「会不会写代码」了,更像「能不能对一段工作负责」。
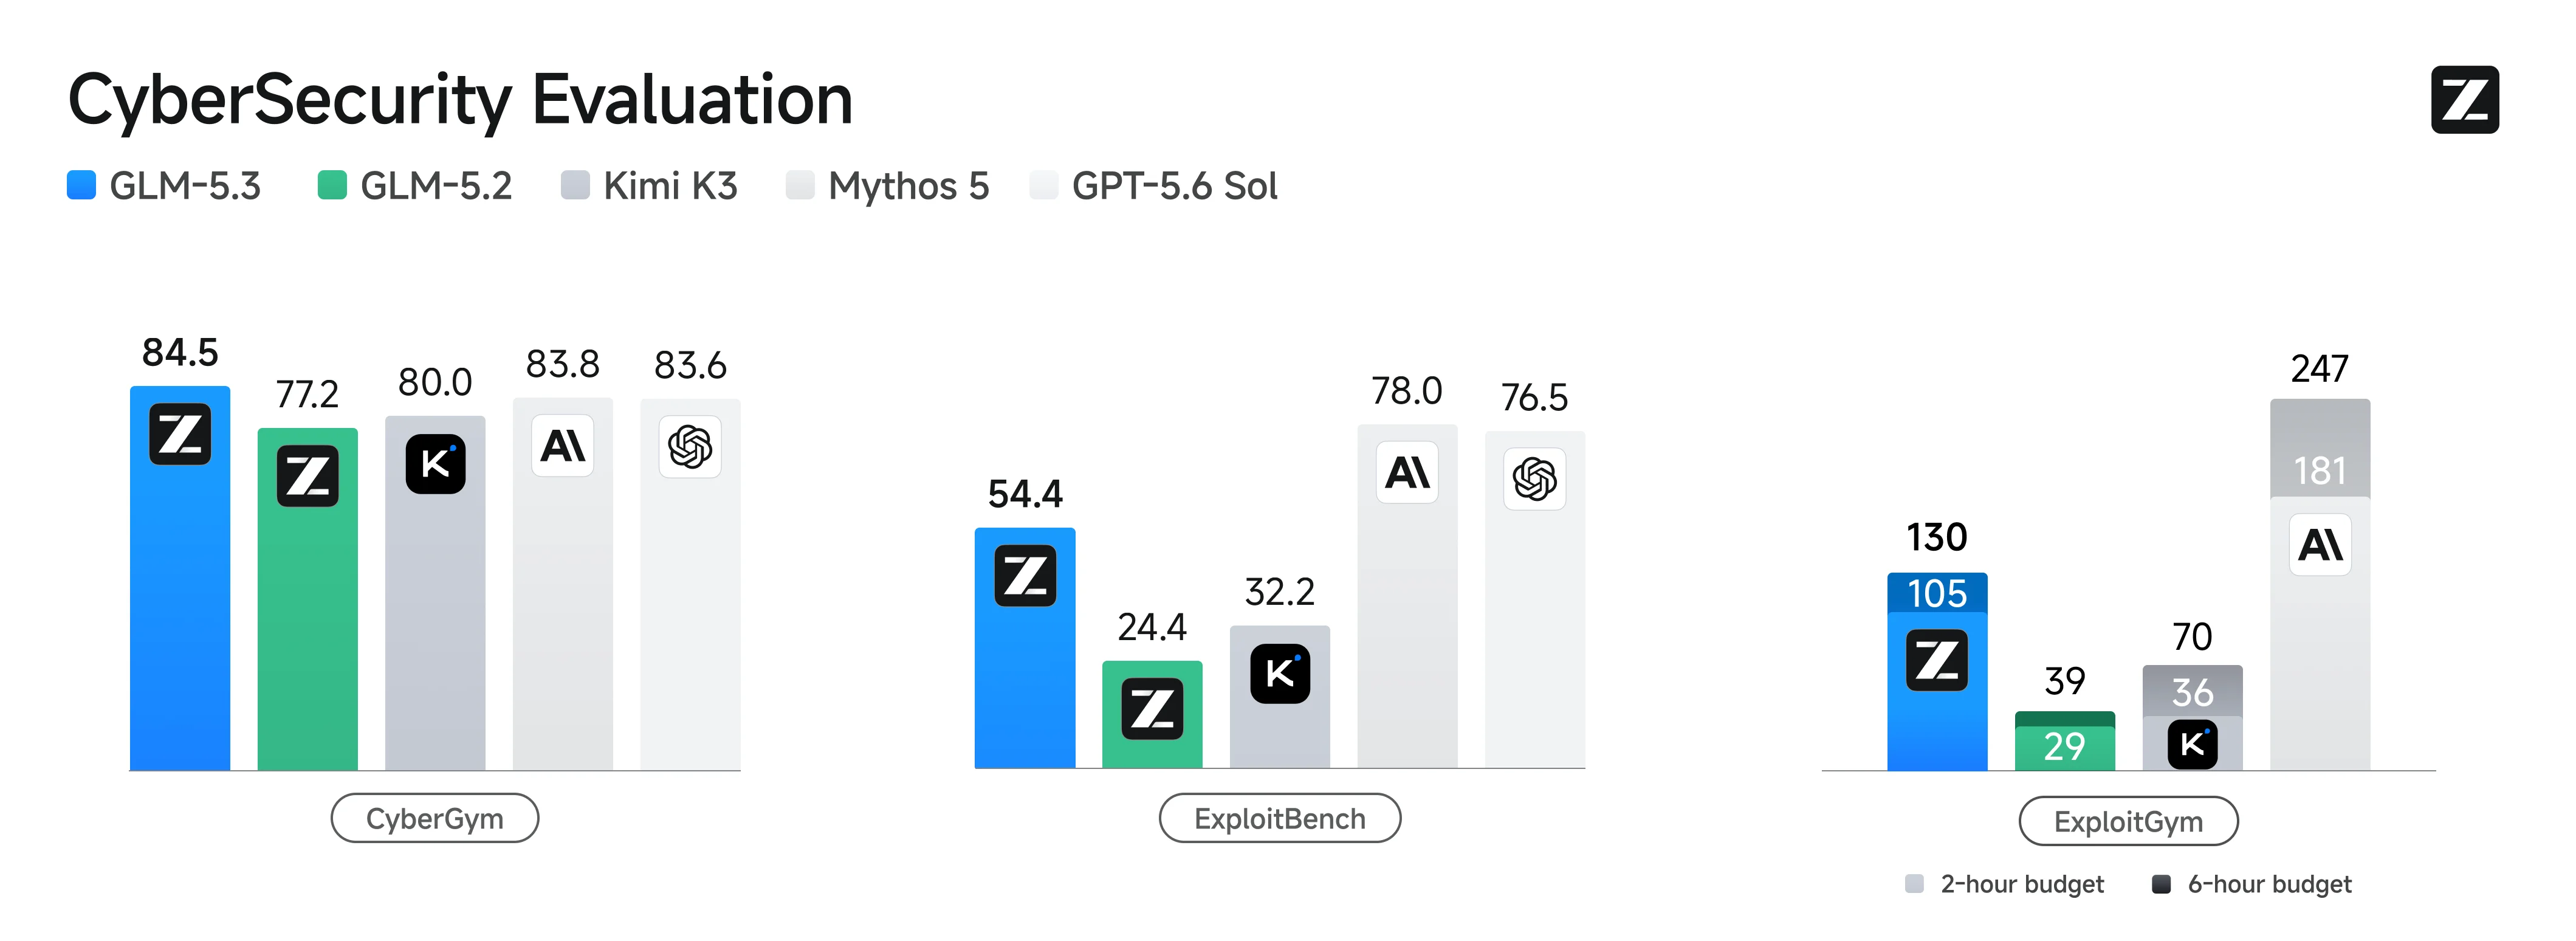
官方给出的公开数据确实猛。Terminal-Bench 3.0 从 4.6 升到 28.3,DeepSWE v1.1 从 46.2 升到 66.9,AutomationBench 从 26.2 升到 48.2。网络安全任务更抢眼,CyberGym 得到 84.5%,ExploitBench 从 24.4 升到 54.4。
但别急着把 84.5 写成全场碾压。
同一张官方表里,GLM-5.3 在 DeepSWE 上低于 GPT-5.6 Sol、Claude Fable 5 和 Kimi K3,在 NL2Repo 上低于 DeepSeek V4 Pro 与 Claude Opus 4.8,在更靠近完整漏洞利用链的 ExploitBench 上,也明显落后于两款闭源前沿模型。
官方自己没有藏这部分。厉害了,该赢的项目大字报喜,没赢的项目也留在表里。比起只截一列冠军,这种完整表更有阅读价值。
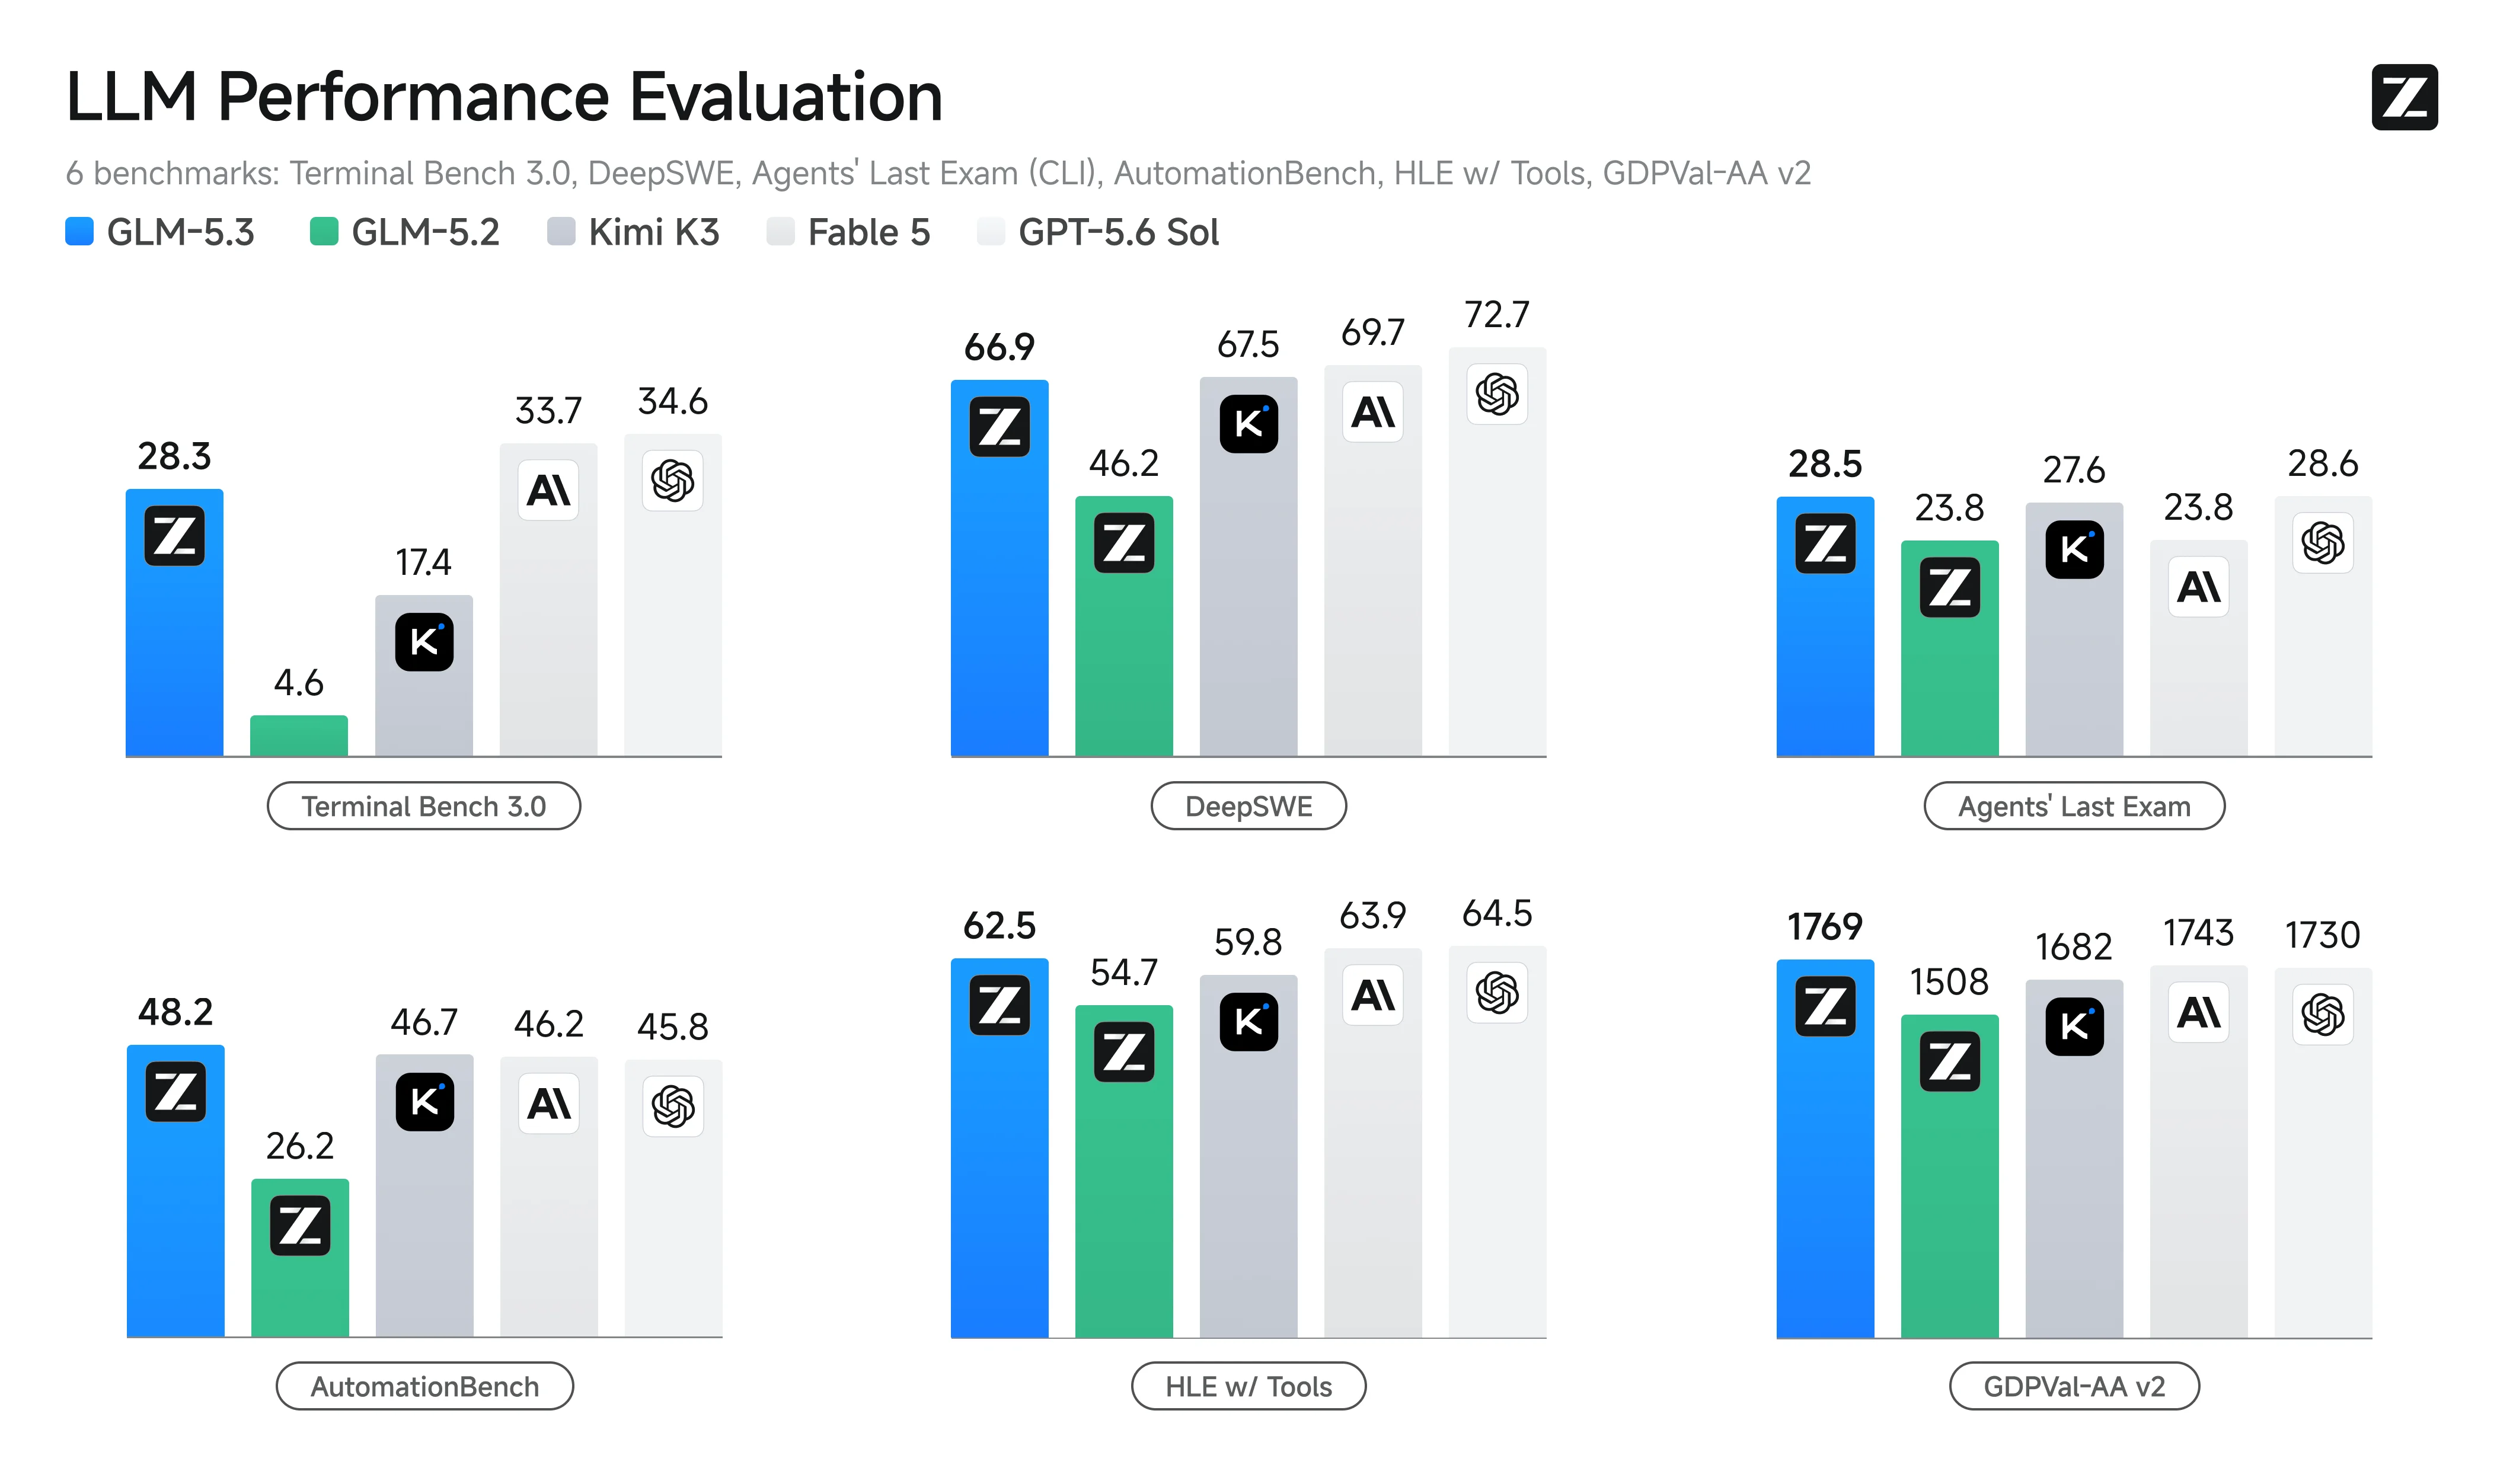
另一个容易被营销标题盖住的数字,是 token。
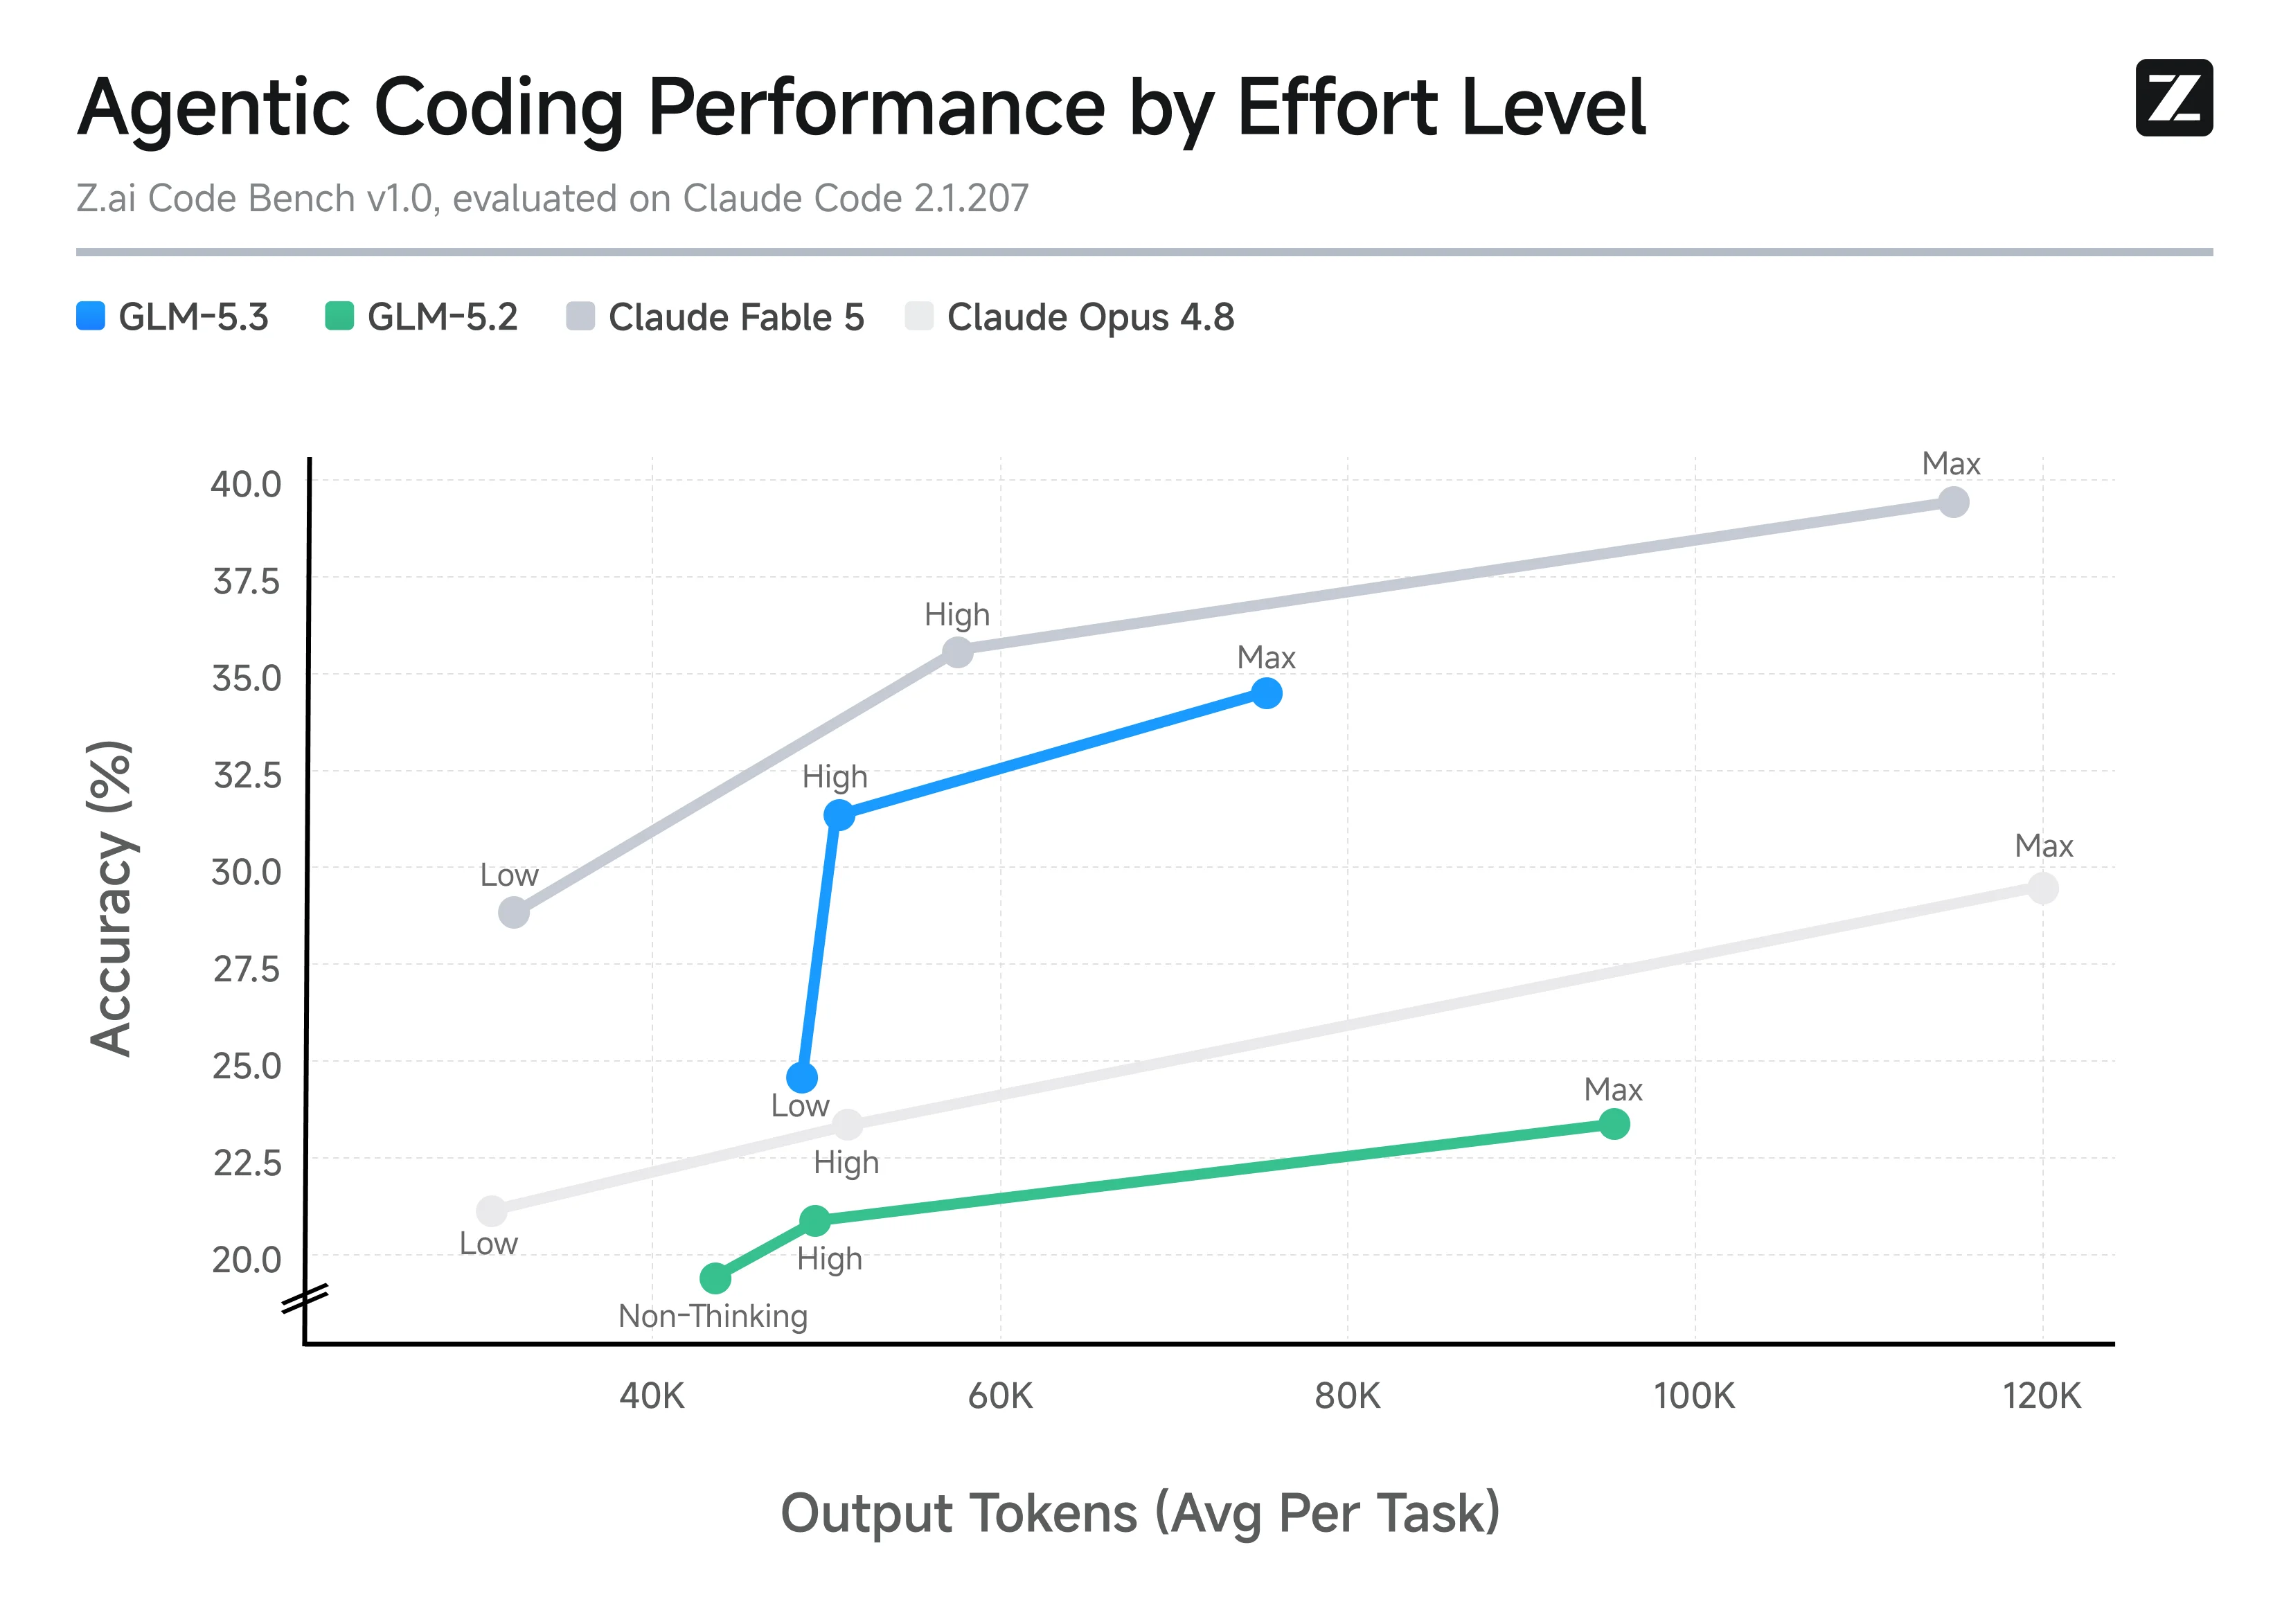
私有的 Z.ai Code Bench 里,GLM-5.3 在 Max 强度下用约 7.5 万输出 token 得到 34.5%,GLM-5.2 用约 9.6 万得到 23.4%。High 强度下,GLM-5.3 用约 5 万 token 得到 31.4%,Claude Opus 4.8 用约 12 万得到 29.5%。
这些数据来自厂商私有基准,不能当第三方审计。但它指出了一个很实用的方向,长任务竞争正在从「多吐一点也许能做对」,变成「更早找到有效路径,少走几万 token 的弯路」。做 Agent 的朋友应该很熟,模型多绕三轮,账单、延迟和失败面会一起长出来。
模型能力涨了,真正的瓶颈开始往环境和验证器移动。
官方用研究智能体收集真实任务模式,再生成含有多步依赖和隐藏状态的可执行环境。裁判智能体先试做,确认任务不是死题。验证器不能偷看参考答案,还要通过标准答案、空操作和未完成状态检查。求解轨迹则用来找奖励漏洞,免得模型学会骗分。
听起来有点绕,对吧。
用工程话讲,就是测试环境本身也得过测试。否则 RL 练得越猛,模型越可能把一条脆弱的评分规则钻成高速公路。模型没有学会修系统,只是学会让 CI 亮绿灯。棒棒的,线上一跑全是段错误。
跑分表背后藏着 Harness
很多模型发布都把分数摆在台前,把运行方式塞进脚注。GLM-5.3 这次的脚注值得反过来读。
Terminal-Bench 3.0 使用 Claude Code 2.1.207 作为 harness,推理强度设成 max,给 400K 上下文和 128K 最大输出。每个任务最多允许 600 个智能体回合,超时是 10 小时,三次运行取平均。Tool Search 关闭,每次运行放进独立容器,产物交给任务自带的验证器评分。
这已经不是把模型丢进一个题库,看它单轮答对多少道题。
同一个模型,换掉工具说明、上下文压缩、超时、最大输出、容器权限和重试策略,结果可能差得像两个产品。排行榜写的是模型名,交卷的却是模型和 Harness 的组合。
网络安全评测也一样。CyberGym 在 1507 个任务上做单次 Pass@1,运行时移除 Git 信息,关闭网页工具,只放行安装依赖所需的少数域名。ExploitGym 还按不同模型的生成速度折算时间预算,官方脚注采用 GLM-5.3 每秒 115 token、Kimi K3 每秒 40 token、Qwen3.8 Max 每秒 47 token 的口径。
你想想看,如果有人只截「105 对 36」,不告诉你预算按吞吐重新折算,这个比较就少了半张说明书。
这里不是说分数没用。恰好相反,分数很有用,但它回答的是一个更窄的问题。在指定版本的 Claude Code、指定工具权限、指定上下文和超时里,模型完成这套任务的概率有多高。
它不直接回答你公司的 monorepo 能不能修,也不替你决定一次任务愿意烧多少 token,更不保证私有依赖、内网权限和烂文档进来以后还保持同样的稳定性。
坦率讲,普通开发者今天最值得抄的不是冠军结论,而是评测纪律。
挑二十个真实任务,里面要有跨文件修改、测试失败、依赖缺失和模糊需求。固定同一套 Harness 与工具权限,让 GLM-5.2 和 GLM-5.3 各跑三次。别只记成功或失败,还要记输出 token、首个有效修改出现在哪一轮、测试跑了几次、有没有越权安装依赖,以及人工接管发生在什么位置。
二十题当然发不了论文,但足够决定下周要不要把团队默认模型切过去。厂商跑分解决认知问题,自己的回归集解决上线问题。两者不冲突,别拿一张表替另一张表干活。
今天能测什么,两周后要验什么
如果准备现在接入,先看一眼配置。
GLM-5.3 不再支持关闭思考,只提供 low、high、max 三档推理强度。已有请求若写着 thinking.type 为 disabled,直接换模型名会失败。官方开发文档建议先启用思考,把强度设为 low,再迁移到 glm-5.3。
{
  "model": "glm-5.3",
  "thinking": { "type": "enabled" },
  "reasoning_effort": "low"
}
别小看这一行。很多团队的模型切换做成配置开关,默认以为兼容 OpenAI 格式就能无痛换后端。模型名字能换,能力开关未必同构。没有在预发环境跑过错误响应和降级路径,周五下午切流量,告警会替你补一堂接口语义课。
GLM Coding Plan 同时改成积分额度制,输入、缓存输入和输出分别计点。工作日北京时间 14 点到 18 点属于高峰,其余时间和周末按一半积分消耗。ZCode 还给出重复上下文缓存命中率超过 98% 和约 30% 有效 token 增益的产品口径。
说真的,这部分对日常使用的影响,可能比一个基准多两分更直接。长任务是否划算,要看高峰规则、缓存命中、推理强度和失败重试一起算。最好拿真实账单核,不要把宣传页上的「最多」写进容量规划。
网络安全能力的跃迁,也解释了权重为什么要再等两周。
官方说 GLM-5.3 在真实代码库中协助发现了 2436 个漏洞,涉及 269 个项目,其中 1097 个被归为中高危。这个数字来自厂商及合作安全团队的复核口径,公开的 Z.ai Security Disclosure Ledger 目前区分了 53 项已披露问题和 2383 项仍在披露流程中的问题。
能力往漏洞利用链上长,开放权重前增加安全评估和加固,有合理性。与此同时,「安全原因」不能变成无限延期的万能解释。官方给了两周,屏幕前的你到时可以验四样东西,权重是否如期出现,许可证是否允许预期用途,主流推理框架能否跑通,第三方在公开任务上能否复现大致趋势。
少一样,都该记在那张工程验收单上。
我自己的判断是,GLM-5.3 今天已经是一款可测试的前沿 API 模型,但还不是一份完成交付的开放权重资产。这个判断并不矛盾,也没必要替厂商提前庆功或提前判刑。
模型没有迟到,权重还在安检。
两周后,等那只箱子真正上岸,再看里面装的是不是发布会上承诺的东西。