posts/google-cloud-model-router-contract.md
统一模型 API,最难的根本不是路由
一份 OpenAPI 配置,两个虚拟模型名,三个完全不同的模型后端。
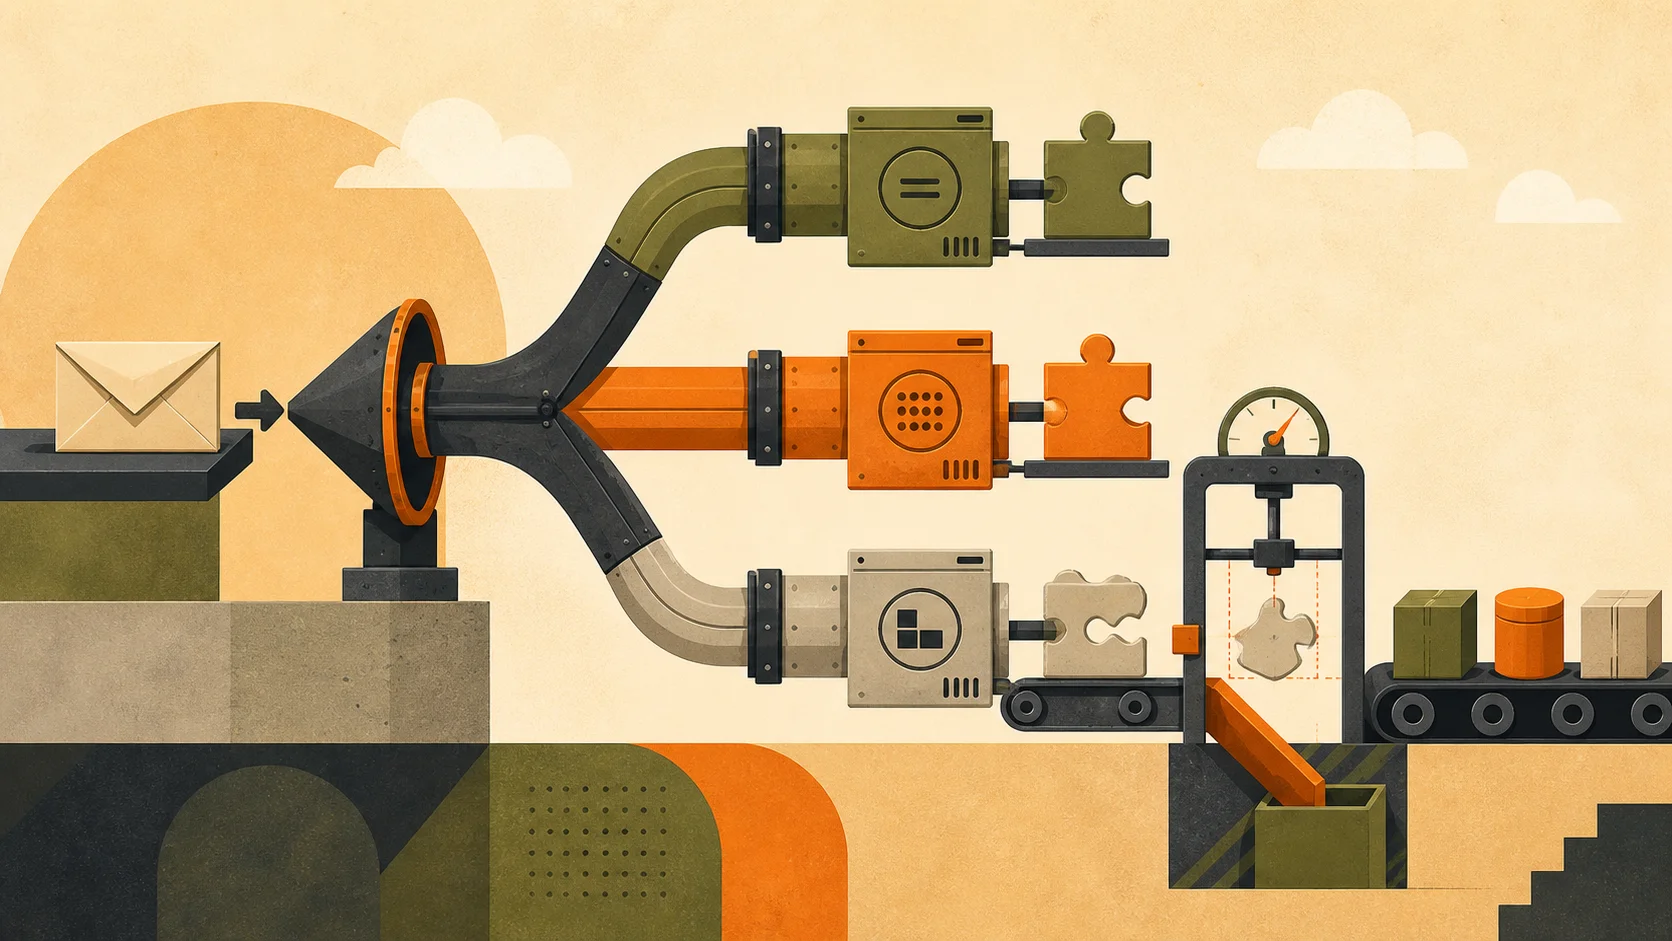
应用照常发 OpenAI 兼容请求,网关在中间把请求转成 Gemini、Claude 或 GPT-OSS 的原生格式,再送去正确的模型。
这是 Google Cloud 刚放进 Public Preview 的模型路由能力。它长得很像每个做过多模型应用的人都想要的东西。业务代码只认一个入口,不再塞满供应商判断,不用自己养 LiteLLM 一类代理,也不用每换一个模型就追着 SDK 改调用链。
好家伙,基础设施终于开始替开发者收拾多模型接入这摊线头了。
但我看完官方配置,脑子里冒出来的不是「以后路由简单了」,而是另一个更麻烦的问题。
入口统一以后,我们会不会更容易忘记,后面的模型从来没有真的统一过。
HTTP 状态是 200,JSON 也能反序列化,不代表这次切换是安全的。一个原本稳定返回工具参数的任务,换模型后可能改成自然语言。一个正在流式输出的会话,换后端后可能改变事件顺序。一次超时触发自动重试,前一个模型其实已经把订单写进系统,第二个模型又干了一遍。
路由规则写对了,只能证明请求去了该去的地方。
它证明不了结果还能被你的业务接住。
Google 真正统一了什么
先把这次更新讲清楚,因为它并不是「把全世界任意三个 API 地址塞进一个代理」。
Google 的方案在 API Gateway 上加了一层模型路由。开发者在 OpenAPI 3.x 文件里用 x-google-api-management 声明后端,再给虚拟模型配置默认目标和匹配规则。请求打到固定路径,网关读取 model 字段,完成协议转换与动态路由。
官方例子里,默认模型可以是 Gemini 3.5 Flash-Lite,也能按名字切到 Claude Opus 4.7。另一条路由默认走 GPT-OSS 120B,也允许切回 Gemini。应用侧仍然发送熟悉的 messages 结构,不需要知道 Vertex AI 后面的原生端点长什么样。
这一手确实有点子牛逼。
多模型系统里最脏的一层,往往不是 prompt,而是认证、限流、endpoint、请求格式、供应商 SDK 和观测字段。每个业务服务各写一份,半年后就会长出五种重试策略和七种环境变量。把入口收回网关,至少能让认证与配额回到一个位置。Google 的认证文档也把 API key、JWT 和服务账号分开处理,机器身份不必再跟个人密钥搅在一起。
不过,官方也写了一条很关键的边界。同一个路由器里的后端必须共享同一主机,例如都在 aiplatform.googleapis.com。网关是在这个共享主机上换模型和路径,不是拿它直接跨 Google、Anthropic、OpenAI 三个公网域名做多云漂移。
这个限制反而让产品定位更清楚。它解决的是 Vertex AI 里多模型入口的治理问题,不是替你抹平整个模型市场。
还有一层容易被发布稿的丝滑示例遮住。OpenAI 兼容描述的是请求外形,OpenAPI 规范负责让人和机器理解一套 HTTP 接口。它们都很重要,可OpenAPI 自己的定义也只是接口描述,不会替业务判断两台后端是否给出等价行为。
接口一样,能力未必一样。
这条缝,才是生产事故最爱钻的地方。
兼容接口最会藏问题
最简单的聊天请求几乎总能跑。发一段文字,拿回一段文字,模型之间的差别主要体现在质量、速度和价格。到了 agent,事情立刻变味。
函数调用就是第一道坎。Google 的函数调用文档里,光模式就有 AUTO、VALIDATED、ANY 和 NONE,支持的 OpenAPI Schema 属性也是一个明确子集。某个模型愿意严格按 schema 给参数,另一个模型可能更爱先解释两句。某个后端能并行提出多个调用,另一个后端只稳定地产出单个动作。
请求都叫 tools,返回也都能被转成类似的 tool_calls,可下游真正依赖的是更细的承诺。
参数能不能通过 JSON Schema 校验。
被要求必须调用工具时,会不会偷偷回答文本。
枚举值、可空字段和嵌套对象会不会漂。
工具结果送回去以后,模型能不能继续沿着同一条会话走。
这些都不是「接口通了」能回答的。
流式响应是第二道坎。前端只想逐字显示时,差一点问题不大。可很多 agent 会在流里同时拼文本、推理信息、工具参数和用量数据。事件顺序一变,状态机就可能提前结束。中途断线时,有的客户端会把已收到的半截参数扔掉,有的会拿半截 JSON 去执行。厉害了,路由层成功切了模型,执行层成功把半张订单送进仓库。
错误语义更隐蔽。429 可能是网关配额、项目配额,也可能是模型端限流。500 可能来自入口,也可能来自上游。Google 的排障文档甚至专门提醒,要结合响应详情区分网关与上游错误。对聊天框来说,等一秒再试通常没事。对会写数据库、发邮件、创建工单的 agent 来说,盲目重试就是把不确定性复制一份。
然后是拒答、上下文边界、最大输出、图片输入、结构化输出和 token 统计。每一项单拿出来都像边角料,凑在一起就是你的账单、告警和业务正确性。
很多团队第一次做模型路由,会从一个很自然的判断开始。
主模型挂了,就切备用模型。
听着合理对吧。
可「挂了」到底是什么。连接超时算挂,连续输出空文本算不算,工具参数连续三次校验失败算不算,拒绝了高风险动作算不算。后两个场景若直接切模型,很可能是在绕过能力边界或安全边界,而不是提高可用性。
所以我一直觉得,多模型路由不该先写一张供应商优先级表。它应该先写一份行为契约。
契约测试得比路由规则先写
所谓契约,不是给每个模型做一套跑分。它只回答一件更朴素的事,这个模型接到这条业务链以后,能不能遵守下游已经依赖的行为。
最小的一组测试,至少得覆盖普通文本、长上下文、结构化输出、单工具调用、多工具调用、流式中断、拒答边界、限流与超时。每个场景都用同一份输入跑过所有候选模型,再验证机器能判断的结果。
别只用肉眼看回答像不像。
结构化输出要过 schema。工具调用要检查名称、必填参数、枚举值和副作用等级。流式测试要故意在不同位置断开,确认状态机不会执行半截动作。长上下文要验证被裁掉的是哪一段。错误测试要确认哪些状态允许重试,哪些只能进入人工处理。
可以把一条契约写成很普通的数据,而不是藏在某位工程师脑子里。
case: create_ticket
input: fixtures/create-ticket.json
assertions:
  response_kind: tool_call
  tool_name: create_ticket
  args_schema: schemas/create-ticket.json
  max_tool_calls: 1
  side_effect: write
  retry_policy: manual_after_unknown
这份测试有个很实用的副产品。你终于能把「默认模型」从一个品牌选择,变成一条可以验收的部署决定。
模型 A 可能在普通问答上便宜又快,却过不了严格工具参数。模型 B 适合写代码,但在你的中文客服场景里容易丢字段。模型 C 很贵,只有高风险工单值得走。路由不再是 if model == xxx,而是任务风险、能力契约、延迟预算与成本上限共同做出的选择。
怎么落地比较稳,我会从影子流量开始。
真实请求仍由当前模型回答,同时把脱敏后的输入复制给候选模型,只记录输出,不触发任何工具。两边跑完以后做离线比较,先看 schema 通过率、工具选择、延迟、拒答和 token,再看人工抽样质量。候选模型通过契约后,才让少量只读任务进入灰度。写操作再晚一点,而且必须有幂等键或人工确认。
这里不需要追求一个漂亮的总分。总分最容易把风险平均掉。创建工单的参数错一次,不能拿十次文案写得更顺来抵消。每条业务链都要有自己的硬门槛。
坦率讲,这部分不花哨。没有模型竞技场那种一眼能转发的排行榜,只有一排失败用例和红色断言。
但生产系统真正的家底,往往就是这些不太上镜的东西。
故障切换别把一次请求做成两次事故
路由进入生产后,观测也要跟着变。Google API Gateway 会自动记录请求与响应,并提供延迟、流量和错误等指标,监控文档已经把入口层的基础信号准备好了。但对多模型应用来说,只看网关状态还不够。
每次请求至少要能回答这些问题。
用户请求的是哪个虚拟模型,最终落到了哪个真实模型。使用了哪一版路由配置。上游耗时多少,首 token 等了多久。结束原因是什么,工具参数有没有过校验。发生过几次重试,为什么切换,切换前的尝试有没有产生外部动作。
这些字段不一定都塞进一条日志,但必须能靠同一个 attempt_id 串起来。否则半夜看到错误率上涨,你只知道统一入口出了问题,却不知道是 Gemini 慢了、Claude 的工具参数漂了,还是某次配置把默认模型指错了。
更麻烦的是自动故障切换。
只读任务比较简单。摘要、分类、检索改写失败后,换模型再跑一次,最多多花点 token。写操作完全不是一个物种。创建订单、发消息、改权限、删资源,只要前一次执行状态未知,就不能当成从未发生。
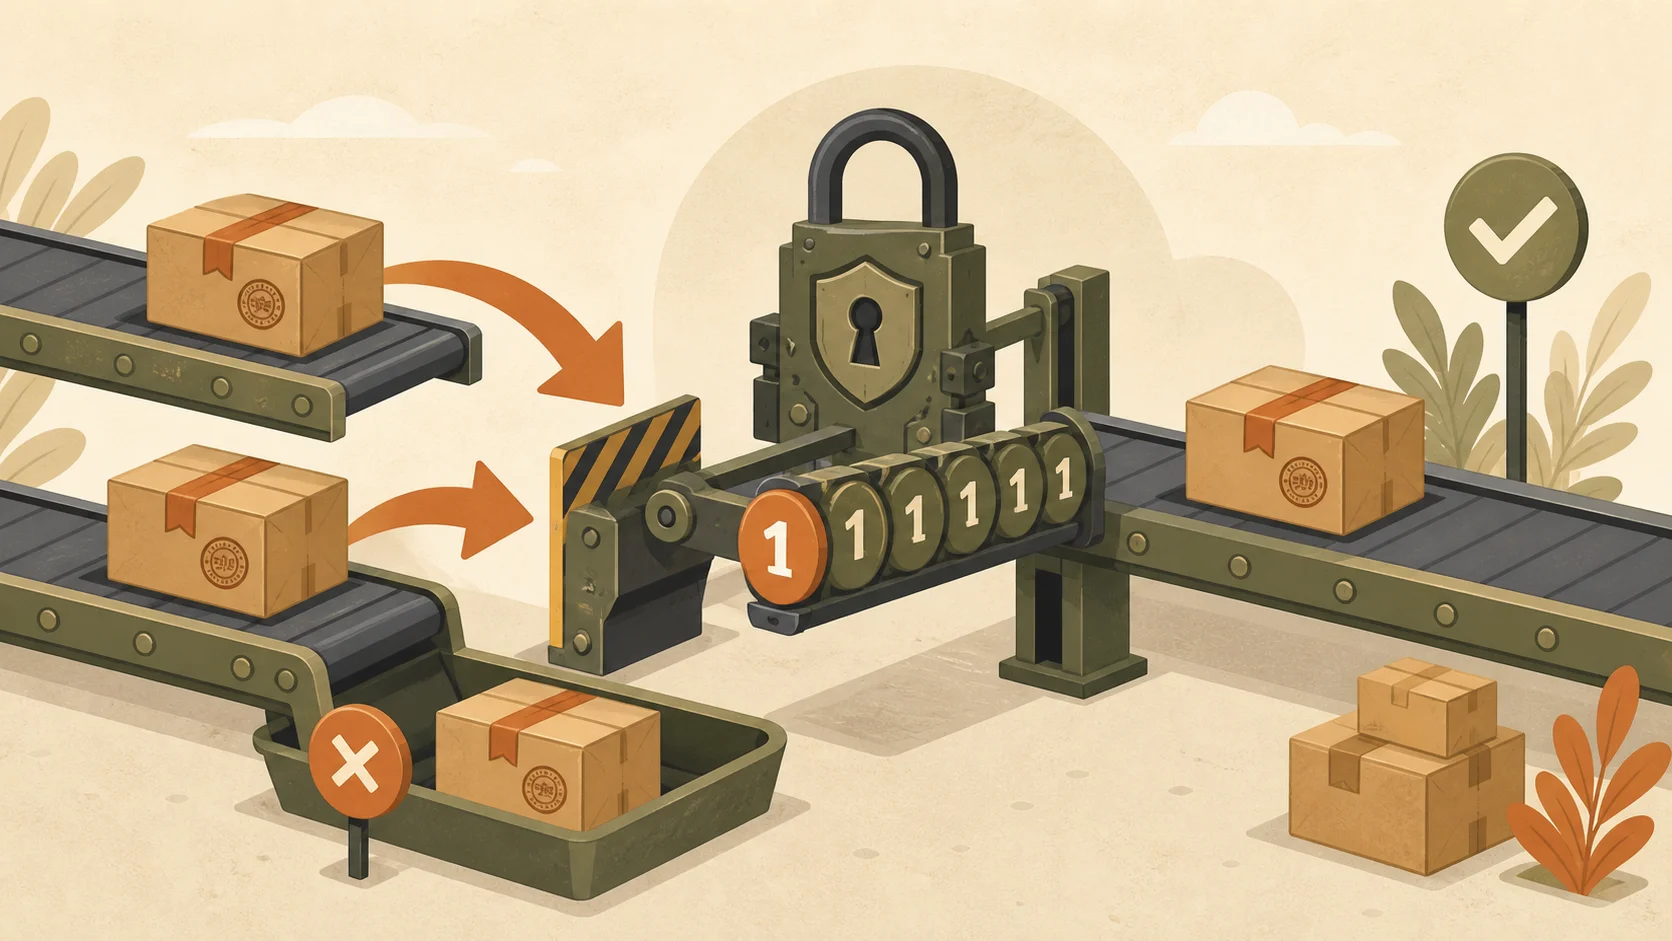
这事儿可以借数据库的老规矩来处理。所有有副作用的工具都带幂等键。模型只提出动作,执行器负责去重。超时后先查动作状态,不要立刻让备用模型再发一次。无法确认时,把任务放进待处理队列,让人决定继续还是回滚。
注意,这里真正保护系统的不是更聪明的模型,是模型外面的执行协议。
很多朋友可能会觉得,既然要补这么多测试、日志和幂等控制,统一 API 好像也没省下多少事。
其实吧,它省掉的是重复接线,不是业务判断。
认证、端点、协议转换、限流与基础观测被网关收走,团队终于能把时间花在行为契约上。这是好事。只是别把少写几段 SDK 适配代码,误认成模型已经可以无差别替换。
我自己的判断可能有点刺耳。未来的模型网关不会靠「接了多少家」拉开差距,真正值钱的是它能不能告诉你,某个模型在某条业务链上为什么可用,什么时候不该切,切坏了怎么停下来。
Google 这次把门修得很漂亮。
门后面那几条路,还是得我们自己验。