posts/gpt-live-voice-agent-handoff.md
语音 Agent 不该全塞进一个模型,GPT‑Live‑1 的新分工
用户还没把话说完,电话里的 Agent 就开始抢答。用户停两秒想一下,它又把沉默当成结束。更烦的是,用户忽然改口,后台那个查订单的任务已经带着旧条件一路冲出去了。
做过语音产品的人,大概都见过这种场面。界面看着挺聪明,真正接起电话就像一个过于热情的实习生,既怕冷场,又分不清一句「嗯」是在确认、在犹豫,还是在和旁边的人说话。
OpenAI 在 9 月 10 日把 GPT‑Live‑1 开放到了 API。它可以一边听一边说,能处理打断、停顿和简短回应,还能把比较费脑子的推理、搜索和工具调用交给开发者选定的后端模型。官方给语音前端层的价格是每分钟 0.05 美元,后端模型和工具另算。
很多人的第一反应会是,语音 Agent 终于不用自己拼 STT、LLM、TTS 了,棒棒的,少几段胶水代码。
但我盯着它的架构说明看了一会儿,觉得更值得聊的不是「声音终于自然了」,而是它把一件常被混在一起的事拆开了。
会聊天的那一层,和替你办事的那一层,不该是同一团东西。
这不是洁癖。把它们揉成一个模型、一个会话、一个权限域,Demo 的确很顺。可一进真实业务,体验、成本、权限和故障恢复会一起缠成耳机线。你听见的是一句自然的回应,后台可能已经排队跑着检索、查库、调用订单系统,甚至准备改一条真实记录。
全双工解决的是前台的节奏。它没有替你做业务边界。
语音前台只管把对话接住
传统语音 Agent 很像接力赛。用户说完一段话,语音转文字,文字送到语言模型,语言模型再吐出文本,文本送去合成语音。每次交接都要等一下,也要赌一下上下文有没有丢。更麻烦的是,系统还得单独猜「这人现在说完了吗」。猜早了会抢话,猜晚了又像网络卡住。
OpenAI 的 工程说明 讲得很直白,GPT‑Live 把音频持续送进、送出语音模型,深度推理和工具使用走独立的异步路径。媒体循环优先保持通畅,搜索、推理、持久化这些可能拖慢节奏的工作,不挤在实时关键路径里。
好家伙,这个分法比「模型更会说话」重要得多。
在前台,GPT‑Live‑1 的工作应该是听清、判断对话还在不在继续、在合适的时候接话、把用户真正的意图整理成可交给后端的上下文。它原生提供转录文本、回复文本、关键词偏置和显式轮次检测,也能对背景噪声和静默更稳一点。浏览器可以接 WebRTC,服务端音频可以接 WebSockets,电话 Agent 可以走 Telephony 或 SIP。
这些能力听上去很碎,但它们都服务于同一件事,别让用户感觉自己在和一台按回车键才肯思考的机器对话。
官方公布的客户早期评估里,语言学习产品 Speak 说,GPT‑Live‑1 在学习者思考停顿时的打断,比此前轮次制系统少了接近 80%。这是一家客户的早期结果,不是所有业务都能照抄的指标。可它至少说明,很多语音体验的问题不是答案不够聪明,而是系统根本没给人留出犹豫、改口和插话的空间。
这层的验收口径也该跟着变。
别只盯识别准确率,应该把「用户打断时有没有立刻停住」「用户说到一半改条件,系统有没有带着旧问题继续答」「嘈杂场景是不是频繁误开口」「长通话后有没有越来越慢」放进测试。语音前台像一个很敏感的接待员,任务是把对话接住,不是替整家公司做完决定。
后端才是那台真正会办事的机器
语音层接住一句「帮我看看明天的订单能不能改地址」之后,后面才刚刚开始。
它要判断用户说的是哪一笔订单,要查身份与权限,要确认订单状态,要处理库存和配送限制,可能还得让用户再确认一次。这个链路里有检索、有规则、有外部系统、有可逆和不可逆的动作。让一个实时语音模型把整段事情一口吞掉,听着很爽,出了问题也会很刺激。不是哥们,那个刺激多数时候不是好词。
GPT‑Live‑1 的官方公告明确写了,深度推理和工具调用可以委派给后端模型、工具或 Agent 框架。应用自己仍掌握权限和持久任务状态,用户打断语音,不会自动取消后台工作。开发者公告 把这句说得更明白,打断语音和取消后台任务是两件独立的事。
这正是架构里最容易被忽略的缝。
语音层说「好的,我先帮你看一下」,可能只是为了让等待没有那么尴尬。后端却已经收到一条带 delegation ID 的任务,开始查企业系统。用户这时改口,说「等等,不是明天那单,是周五那单」。前台应该自然地承接改口,后端则不能靠「用户声音断了」这种模糊信号判断旧任务该不该继续。
真正需要的是显式状态机。每个委派任务要有自己的 ID、版本、权限快照和取消语义。新条件来了,旧任务是继续、撤销、标记过期,还是先把结果回来再要求二次确认,都得由业务规则决定。
可以先把职责写得像下面这样,名字随你改,边界别省。
语音层 GPT-Live-1
  负责,连续听说、打断处理、转录、对话状态、委派请求

后端编排层
  负责,意图校验、任务 ID、版本控制、超时、重试、取消与审计

推理与工具层
  负责,检索、规则判断、模型路由、工具调用、结构化结果

业务执行层
  负责,身份校验、最小权限、二次确认、真实写入、人工转交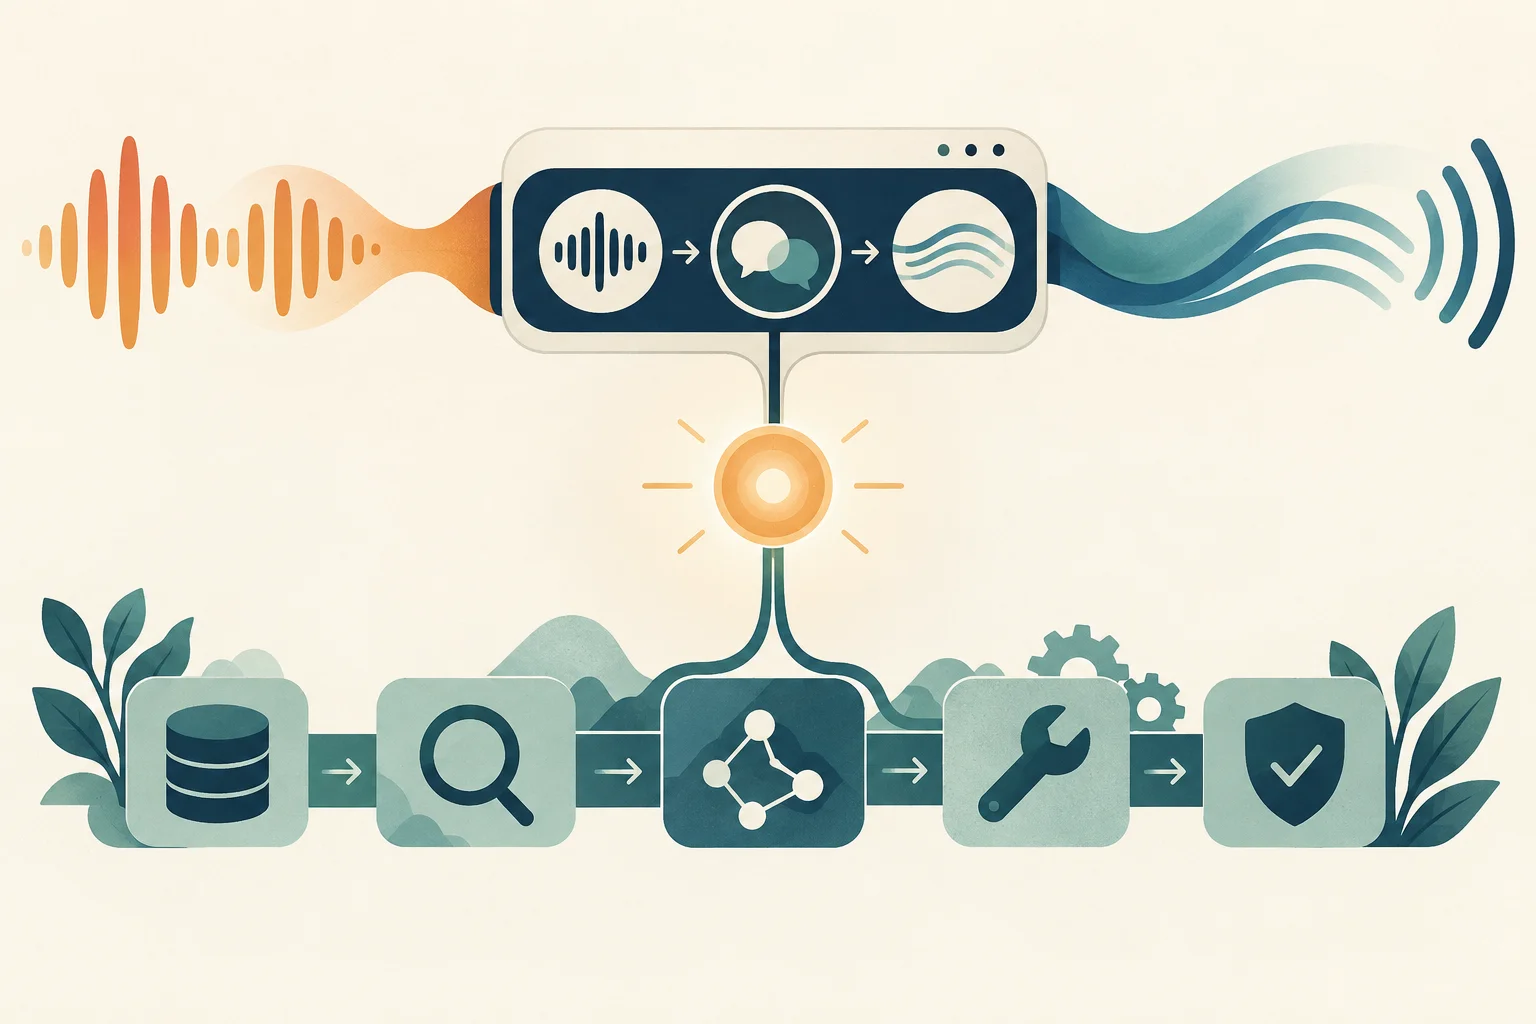
语音层把连续对话交给后台,后台再把可审计的结果交回业务路径。
这张表看着朴素,实际能挡住不少「声音很顺,事情办错」的事故。
假设用户要求改配送地址。语音层可以立刻回应「我在核对这笔订单」,让对话继续流动。后端拿到的是一个只读查询任务,先回传订单候选和可修改条件。只有用户在听到完整地址、费用变化和时限后再次确认,业务执行层才拿到一次有时效的写权限。中间哪怕用户沉默、网络抖一下、重新连进来,也不应该默默把地址改了。
有点子牛逼的语音体验,靠的是前台足够自然。能让人放心交代事情的体验,靠的是后台足够克制。
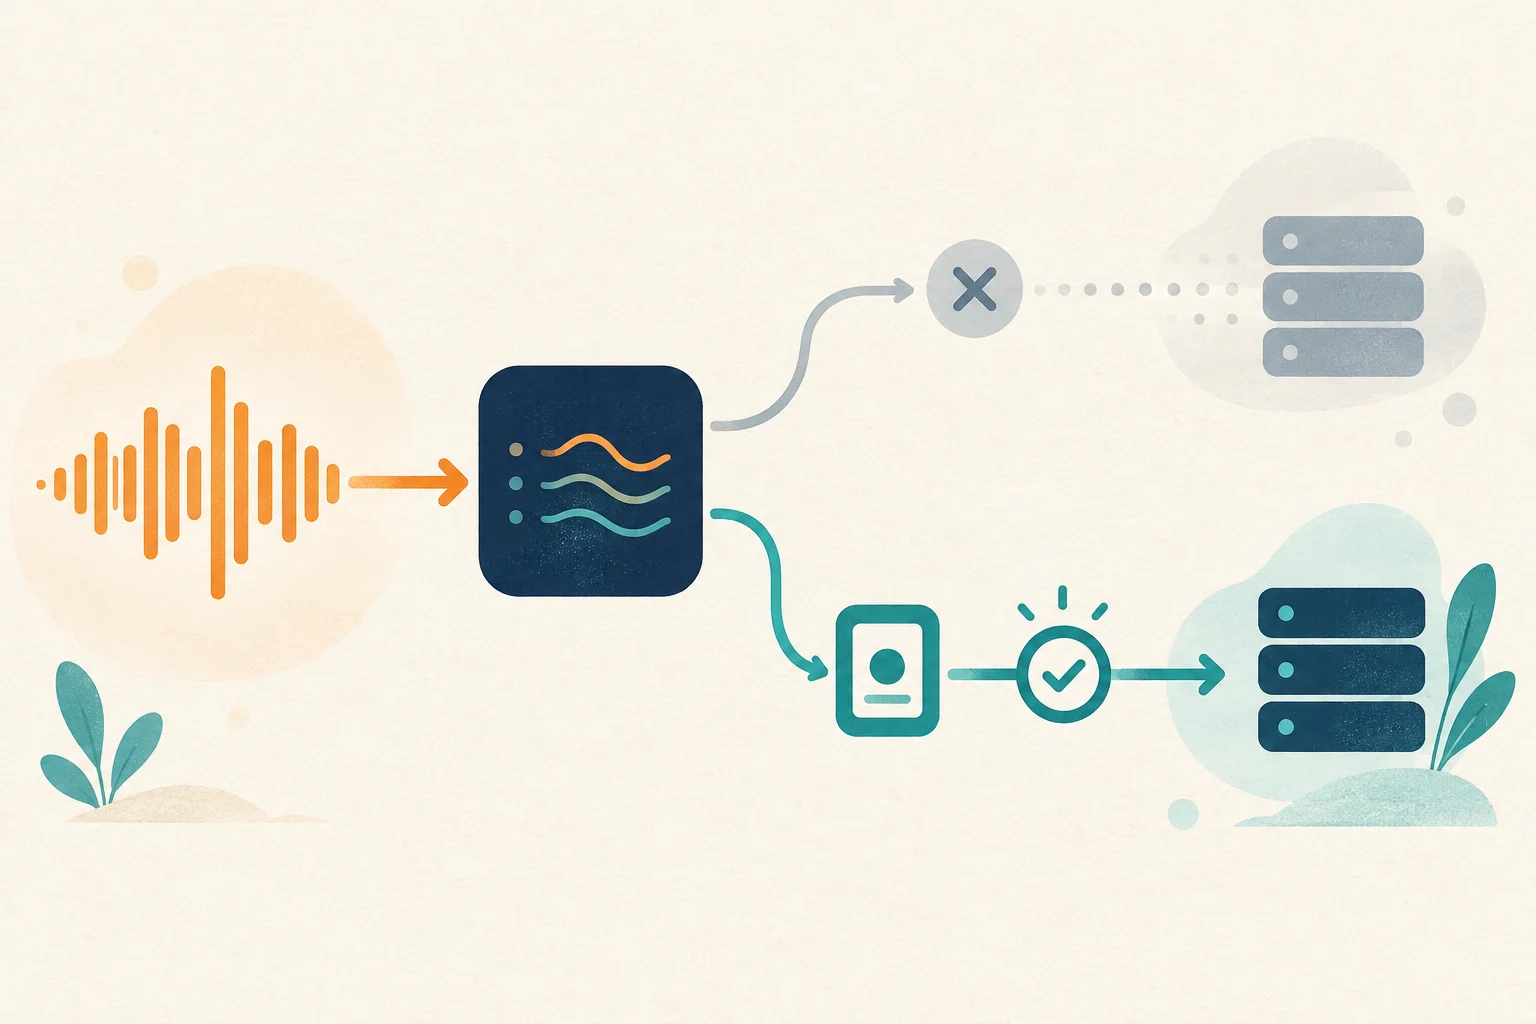
改口可以是自然语言,取消、版本与确认必须是明确的系统状态。
成本别只按每分钟算
0.05 美元每分钟很容易让人产生一个错觉,语音成本终于有了一个简单的单价。
它只是前台的单价。
一个八分钟的客服会话,语音层大约是 0.40 美元。可用户如果触发了知识库检索、复杂推理、外部工具、订单查询和后续摘要,真正的单次任务成本还要把后端模型、工具调用、存储、监控和人工转交算进去。官方也明确说明,后端模型与工具是单独计费的。
这里有个很现实的取舍。对排期、查物流、更新会员信息这类高频而确定的任务,后端可以配更快、更便宜的模型和受限工具。对故障排查、复杂售后、跨系统的问题,才路由给更强的推理模型,或者直接转人工。OpenAI 的发布页也举了类似思路,用较轻的后端处理高量级日程和订单更新,再把需要推理的复杂客服问题交给更强的模型。
这不是为了抠每一分钱。语音场景里,慢和贵经常是一回事。一个模型想把所有问题想透,用户就要听更长的停顿,系统也会积累更多上下文和工具调用。把简单任务留在简单路径,复杂任务才上深度推理,既能压住预算,也更容易让用户知道此刻系统究竟在做什么。
官方在 Tau3 上给出的数字很亮眼,GPT‑Live‑1 搭配 GPT‑6 Astra 中等推理强度的首次任务完成率为 83.6%,GPT‑Realtime‑2.1 为 45.7%。Tau3 覆盖航空、零售和电信客服任务。这个对比可以证明全双工前台配后端推理有潜力,不能直接替你证明自家订单系统也会有 83.6%。数据集、工具质量、权限边界和失败兜底都不一样,别把评测分数当上线批准单。
真正该追的是任务级账本。
每种意图的会话分钟数、后端模型消耗、工具成功率、人工接管率、取消后仍在跑的后台任务数,都得看。只有把它们放在一起,你才知道一个「更自然」的语音体验,是帮客服少走了一步,还是把一堆昂贵的异步任务藏到了用户听不见的地方。
上线前,拿四个问题拦住它
如果你正准备接 GPT‑Live‑1,先别急着把它塞进电话入口。模型 API 很新,业务边界却一点都不新。
第一个问题,用户打断一句话,究竟打断的是播报、当前委派、还是未来的真实写入。三个答案都可能合理,关键是别让系统自己猜。
第二个问题,后台任务回来的时候,对话已经换题了怎么办。结果需要带着任务 ID 和上下文版本回来,前台再决定是继续说、压成通知、丢弃,还是请用户重新确认。
第三个问题,语音层能看到多少信息。实时对话需要上下文,可不代表每一轮都该把完整客户档案、内部备注和所有工具凭据塞进提示词。把用户身份、可见字段和可执行动作拆开,才有机会在出错时知道哪里漏了。
第四个问题,连接断掉以后谁负责收尾。长会话、重连和异步任务本来就是两套生命周期。官方工程团队在真实流量的静默测试里也提到,短压测很难暴露内存、持久化、状态恢复和关闭握手的问题。语音 Agent 不该只测一段漂亮的三十秒 Demo,还要测用户挂机、网络切换、工具超时和人工接手。
这四个问题没有一个靠换模型就能解决。它们会一直留在系统里,只是以前被 STT、TTS 和轮次检测的复杂度盖住了。现在语音层更干净,反而更该把后端那条线拉直。
GPT‑Live‑1 真正值得高兴的地方,是它让实时语音前台终于不像一串勉强黏住的组件。可它也把责任分得更清楚了。前台负责让用户感觉被听见,后端负责让每一次查询、写入和转交经得起追问。
声音可以流畅,权限不能含糊。
如果你要在语音 Agent 里只多加一项验收,你会先测打断后的任务取消,还是先测二次确认前的写权限?