posts/gpt-live-voice-evaluation.md
做语音 Agent,81.5 分第一的模型要不要换
如果你正在做电话客服、预约助手,或者那个总在产品会上被说成“以后能像人一样聊天”的语音 Agent,这两天可能会看到一个很容易让人手痒的数字。
Artificial Analysis 最新的 Speech to Speech Index 里,GPT-Live-1 拿了 81.5 分,排在第一。Grok Voice Think Fast 2.0 High 是 81.3,差 0.2 分。数字一摆出来,群里通常很快会冒出一句,咱们是不是该换模型了?
先别急着开迁移分支。
语音 Agent 最会骗人的吗?不是模型,是那张总榜。它把很多能力压成一个分数,适合让人快速看方向,却不适合替你决定一次线上迁移。电话这一头有人会停顿,会插话,会把订单号念成一串断断续续的数字,后台那头还要查库存、写工单、转人工。中间任何一环掉链子,81.5 分也救不了那句“我刚才已经说过了”。
这不是要给榜单泼冷水。能在语音到语音的综合评测里跑到前面,本身就值得认真看。问题是,团队真正要买的不是一段更顺滑的 Demo,而是一套在嘈杂、反复和高峰时段仍能把事办完的系统。
那 0.2 分究竟在比什么
先把公开信息放在桌上。Artificial Analysis 给出的配置里,GPT-Live-1 搭配 Astra 后端、medium 推理强度得 81.5,Grok Voice Think Fast 2.0 High 是 81.3,使用 Sol 后端的配置为 80.1。这个名次说明,在它定义的任务和配置下,GPT-Live-1 的整体语音交互表现很强。
但“配置下”这三个字很重要。
GPT-Live-1 不是一个把声音丢进去、答案就凭空长出来的黑盒。OpenAI 的 API 发布说明写得很直白,它是全双工模型,能同时听和说,复杂推理和工具调用可以交给后端模型。也就是说,你听到的那句自然回应,背后常常是一条语音层、编排层、工具层和文本模型共同跑出来的链路。
所以 81.5 不是一句“换它就能拿到 81.5”的承诺。它更像一道体检报告,告诉你这个身体在某种测试里跑得不错。至于穿上你家的业务衣服以后还能不能跑,得另外验。
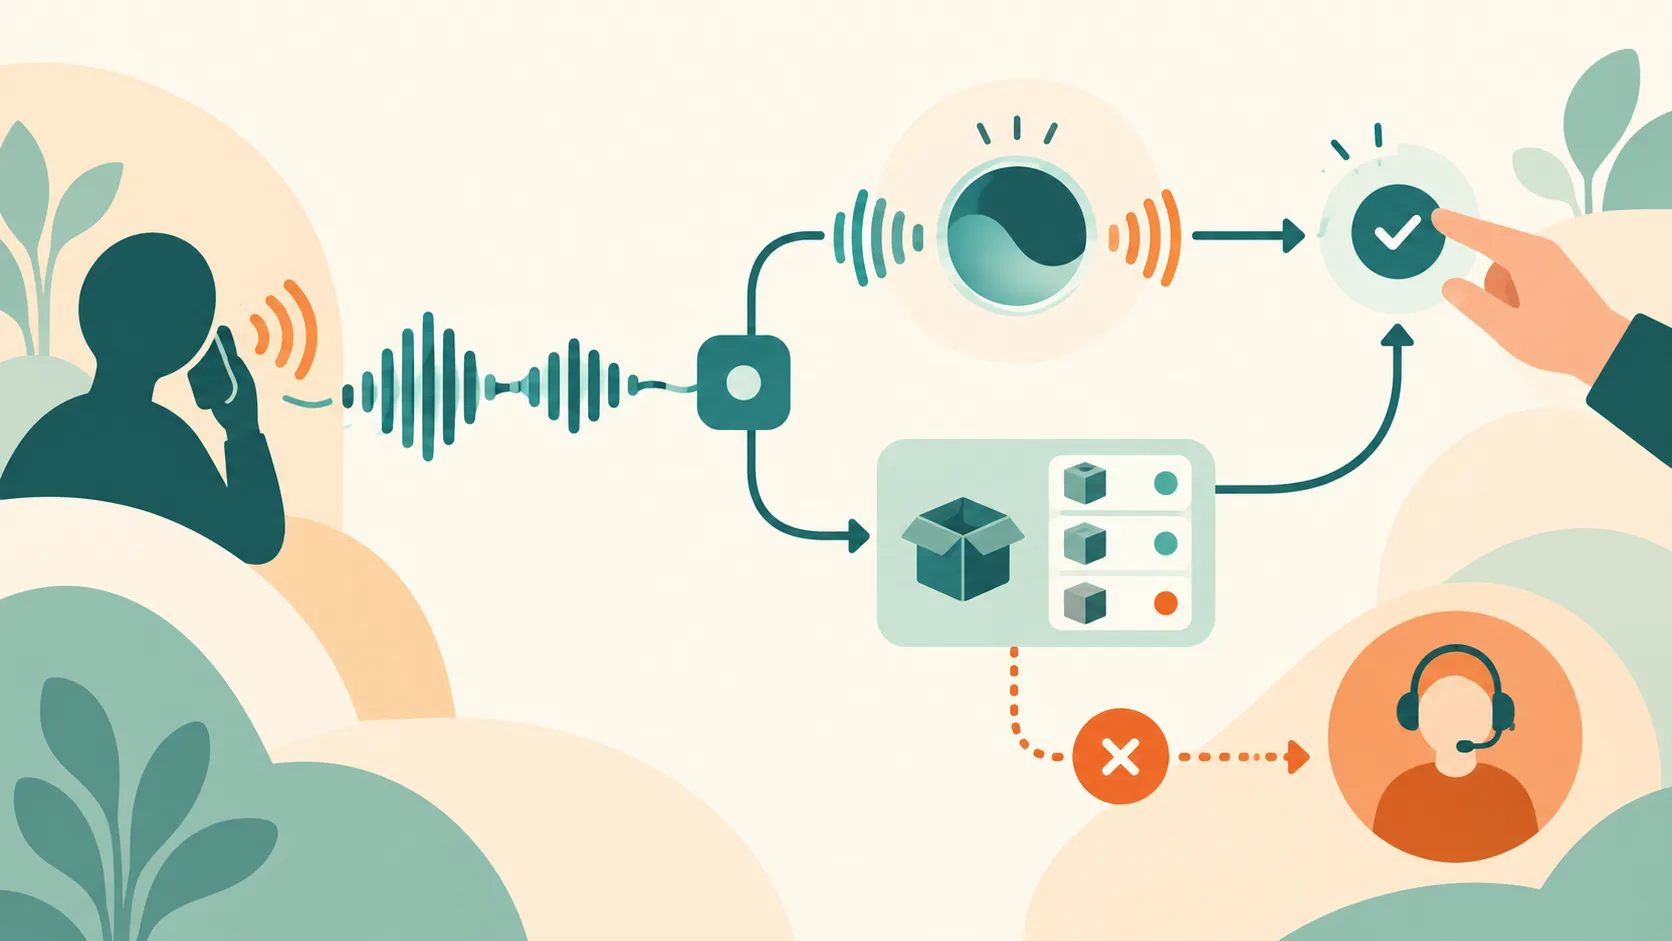
语音体验不是单个模型的独角戏,打断、工具和兜底都在同一条链路上。
我会把“要不要换”先拆成一个非常朴素的问题,你现在最痛的是哪一段?
如果用户总说还没讲完就被抢话,重点该看打断和静音判断。如果模型会听错订单号、姓名或地址,重点是数字与实体识别。如果它回答得像人但不会查真实库存,问题在后端工具。如果它既会聊天也会下错单,问题就在权限和确认。把这些问题全塞进一个总分里,确实很省眼睛,也确实很容易把工程活藏起来。
换模型前,先跑完十通不体面的电话
没做过本地实测的模型,不该被写成已经救了谁。这篇也一样,下面这张表不是实测结果,是一份可以直接拿去跑的小型验收单。
第一通,让用户在模型开口两秒后换需求。不要只记它有没有停下来,要记它多久停止旧回答,能不能把新的约束接住。全双工的价值就在这里,少一次僵硬的轮次切换,用户少一次“你先别说”。
第二通,把环境噪音拉上来。键盘声、地铁报站、旁边的人插一句话,这些都比录音棚里的普通话更接近线上。OpenAI 把背景噪音和静默处理列为 GPT-Live-1 的重点能力,但你的麦克风、电话线路和用户语言,仍然得自己验。模型若把背景一句话当成操作指令,后果就不只是体验差。
第三通,专门念一串不讨喜的信息。订单号、银行卡后四位、车牌、日期、产品规格都行。验收时不要只看转写文本漂亮不漂亮,要看工具参数到底有没有被传对。语音模型最容易在这里给人一种“差不多听懂了”的错觉,可系统要的不是差不多。
第四到第六通,放进真正的业务工具。查一次库存,改一次预约,再把一个不该自动执行的动作挡在确认页前。工具调用做得快不等于做得对,尤其是在语音里,用户很难像看网页那样回头核对每一个字段。需要扣费、发送、取消的动作,最好让模型复述关键参数,再由用户明确确认。
第七到第八通,故意让工具超时、返回空数据或权限被拒。看它会不会胡编一个结果,也看它能不能说清正在等待还是已经失败。一个靠谱的语音 Agent 不一定每次都很机灵,至少不能把失败包装成成功。
剩下两通留给长对话。让用户在几分钟后回到前面说过的偏好,再临时改变话题。OpenAI 把长会话可靠性列为这次 API 发布的改进项,正好可以拿来做你自己的基线。语音里最尴尬的瞬间,往往不是答不上,而是它非常笃定地忘了你三分钟前刚说的话。
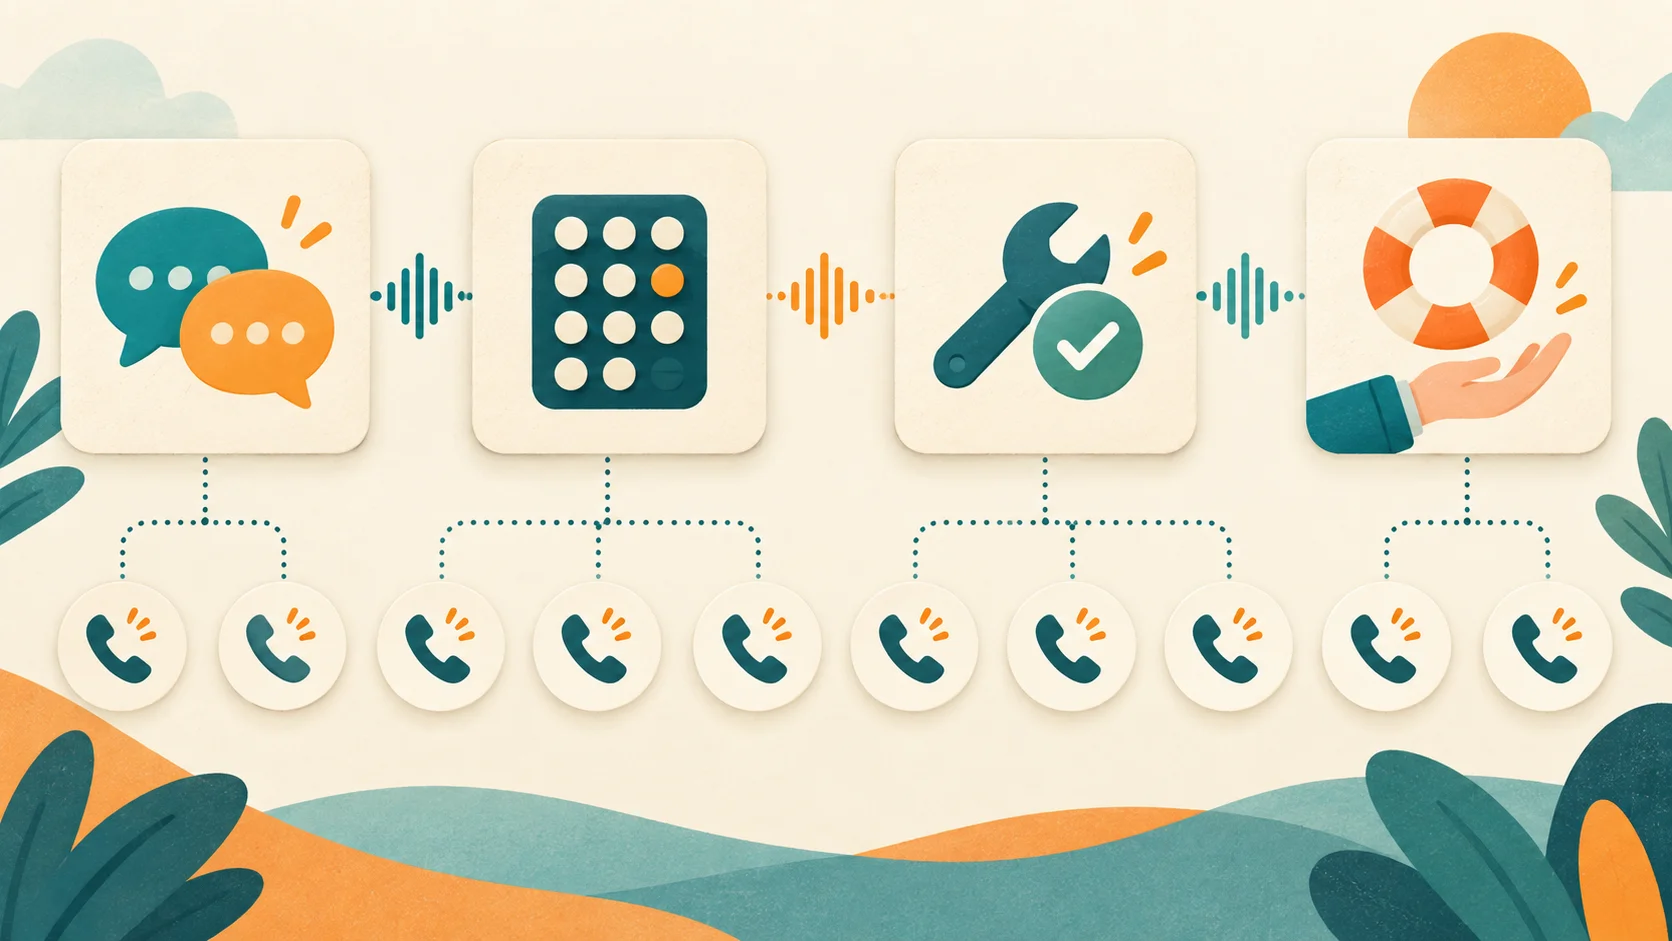
拿同一套十通电话比较候选模型,才知道分数高出来的是哪里。
十通当然不够代表全部用户,它却足够让一次会议从“这个模型分数真高”往前走一点,走到“它在哪两通翻车了”。这一步有点子笨,但比在生产环境里收集用户的叹气声便宜多了。
账单也不能只看每分钟
GPT-Live-1 的官方定价是前端语音层每分钟 0.05 美元,后端模型和工具调用另算。这个拆分很诚实,也提醒了一个常被忽略的点,语音成本不是只按通话时长结算。
同样一分钟的电话,有人只是问营业时间,有人会连续查三次订单、调一次知识库、让模型总结对话再转人工。前者主要消耗语音层,后者的账单会被后端推理、检索和工具重试一起抬起来。要是你把所有复杂问题都委托给最贵的后端,前端换得再便宜,月末还是会被账单拍一下肩膀。
比较候选模型时,我更建议把每十通电话记成四列。任务成功率、被打断后恢复成功率、人工接管率、单个成功任务成本。成本那一列故意写成“成功任务”,不是“每分钟”。一段 20 秒却把用户带进死循环的对话,价格再低也没有意义。
这里还有一个很现实的边界。GPT-Live-1 目前的 API 能力里不支持视频和屏幕共享,ChatGPT 里的 Live 与 Advanced 体验也不是同一个东西。产品如果依赖用户把屏幕指给助手看,或者需要用视觉确认设备状态,不能因为名字相近就把两条产品线当成可互换。好家伙,语音上分以后,需求边界反而更值得翻出来看一遍。
我的结论很简单
榜单第一,值得进候选池。0.2 分领先,不值得替你做迁移决定。
对已经有稳定语音链路的团队,最稳的动作不是一夜之间替换生产模型,而是拿同一批十通电话做小流量对照。先让它在打断、号码、工具和失败回退四件事上赢过现有方案,再谈扩大流量。对还没做语音产品的团队,也不必把每个环节都拆成旧式的语音转写、文本推理、语音合成三段式再硬粘回去,先理解全双工能替你省掉哪些时序问题,再决定它是否适合你的业务。
模型榜单像海图上的水深数字,有用,但它不替你开船。真正让用户留在电话里的,是那条从一句含糊的口语,到一次正确的工具调用,再到一次能体面转人工的完整航线。
你们的语音 Agent 现在最常翻车的是打断、信息识别,还是工具调用?
文中事实依据为 Artificial Analysis 的榜单条目、OpenAI 的 API 发布说明 与 GPT-Live-1 模型文档。