posts/gpt56-agent-economics.md
GPT-5.6 再强,也救不了一条笨流水线
13.3%,变成 38.3%。
模型没换。
OpenAI 在刚发布的 GPT-5.6 构建者指南里,放了一组很扎眼的数据。GPT-5.6 Sol 跑 ARC-AGI-3,使用标准 Agent 架构时得分 13.3%。开启保留推理和长会话压缩后,得分升到 38.3%,输出 token 还少了大约 6 倍。
同一颗脑子,只改外面的脚手架,效果接近三倍,话还说得更少。
好家伙。
我们聊模型升级时,习惯盯着参数、跑分和价格。线上 Agent 一变笨,第一反应也是把模型往上换。Luna 不行换 Terra,Terra 不行上 Sol,推理强度从 low 拧到 high,再不行就多重试几次。账单涨得很诚实,效果却未必跟着涨。
这篇官方指南最有价值的地方,不是又证明 GPT-5.6 很强。厂商夸自家模型,正常操作。真正值得做 Agent 的人停下来看的,是 OpenAI 把模型选择、推理状态、上下文压缩、程序化工具调用、多智能体和提示词缓存摆在了同一张工程图上。
它指向一个有点刺耳的判断。
Agent 的性能瓶颈,可能已经不在模型里,而在你怎么把活送到模型面前。
最贵的错,是把每一步都当成难题
先看一笔最直观的账。
OpenAI 给出的 BrowseComp 数据里,GPT-5.5 Extra High 得分 84.36%,一次评测成本 33.27 美元。GPT-5.6 Luna Extra High 得分 84.04%,成本 1.33 美元。
差 0.32 分,差不多 25 倍成本。
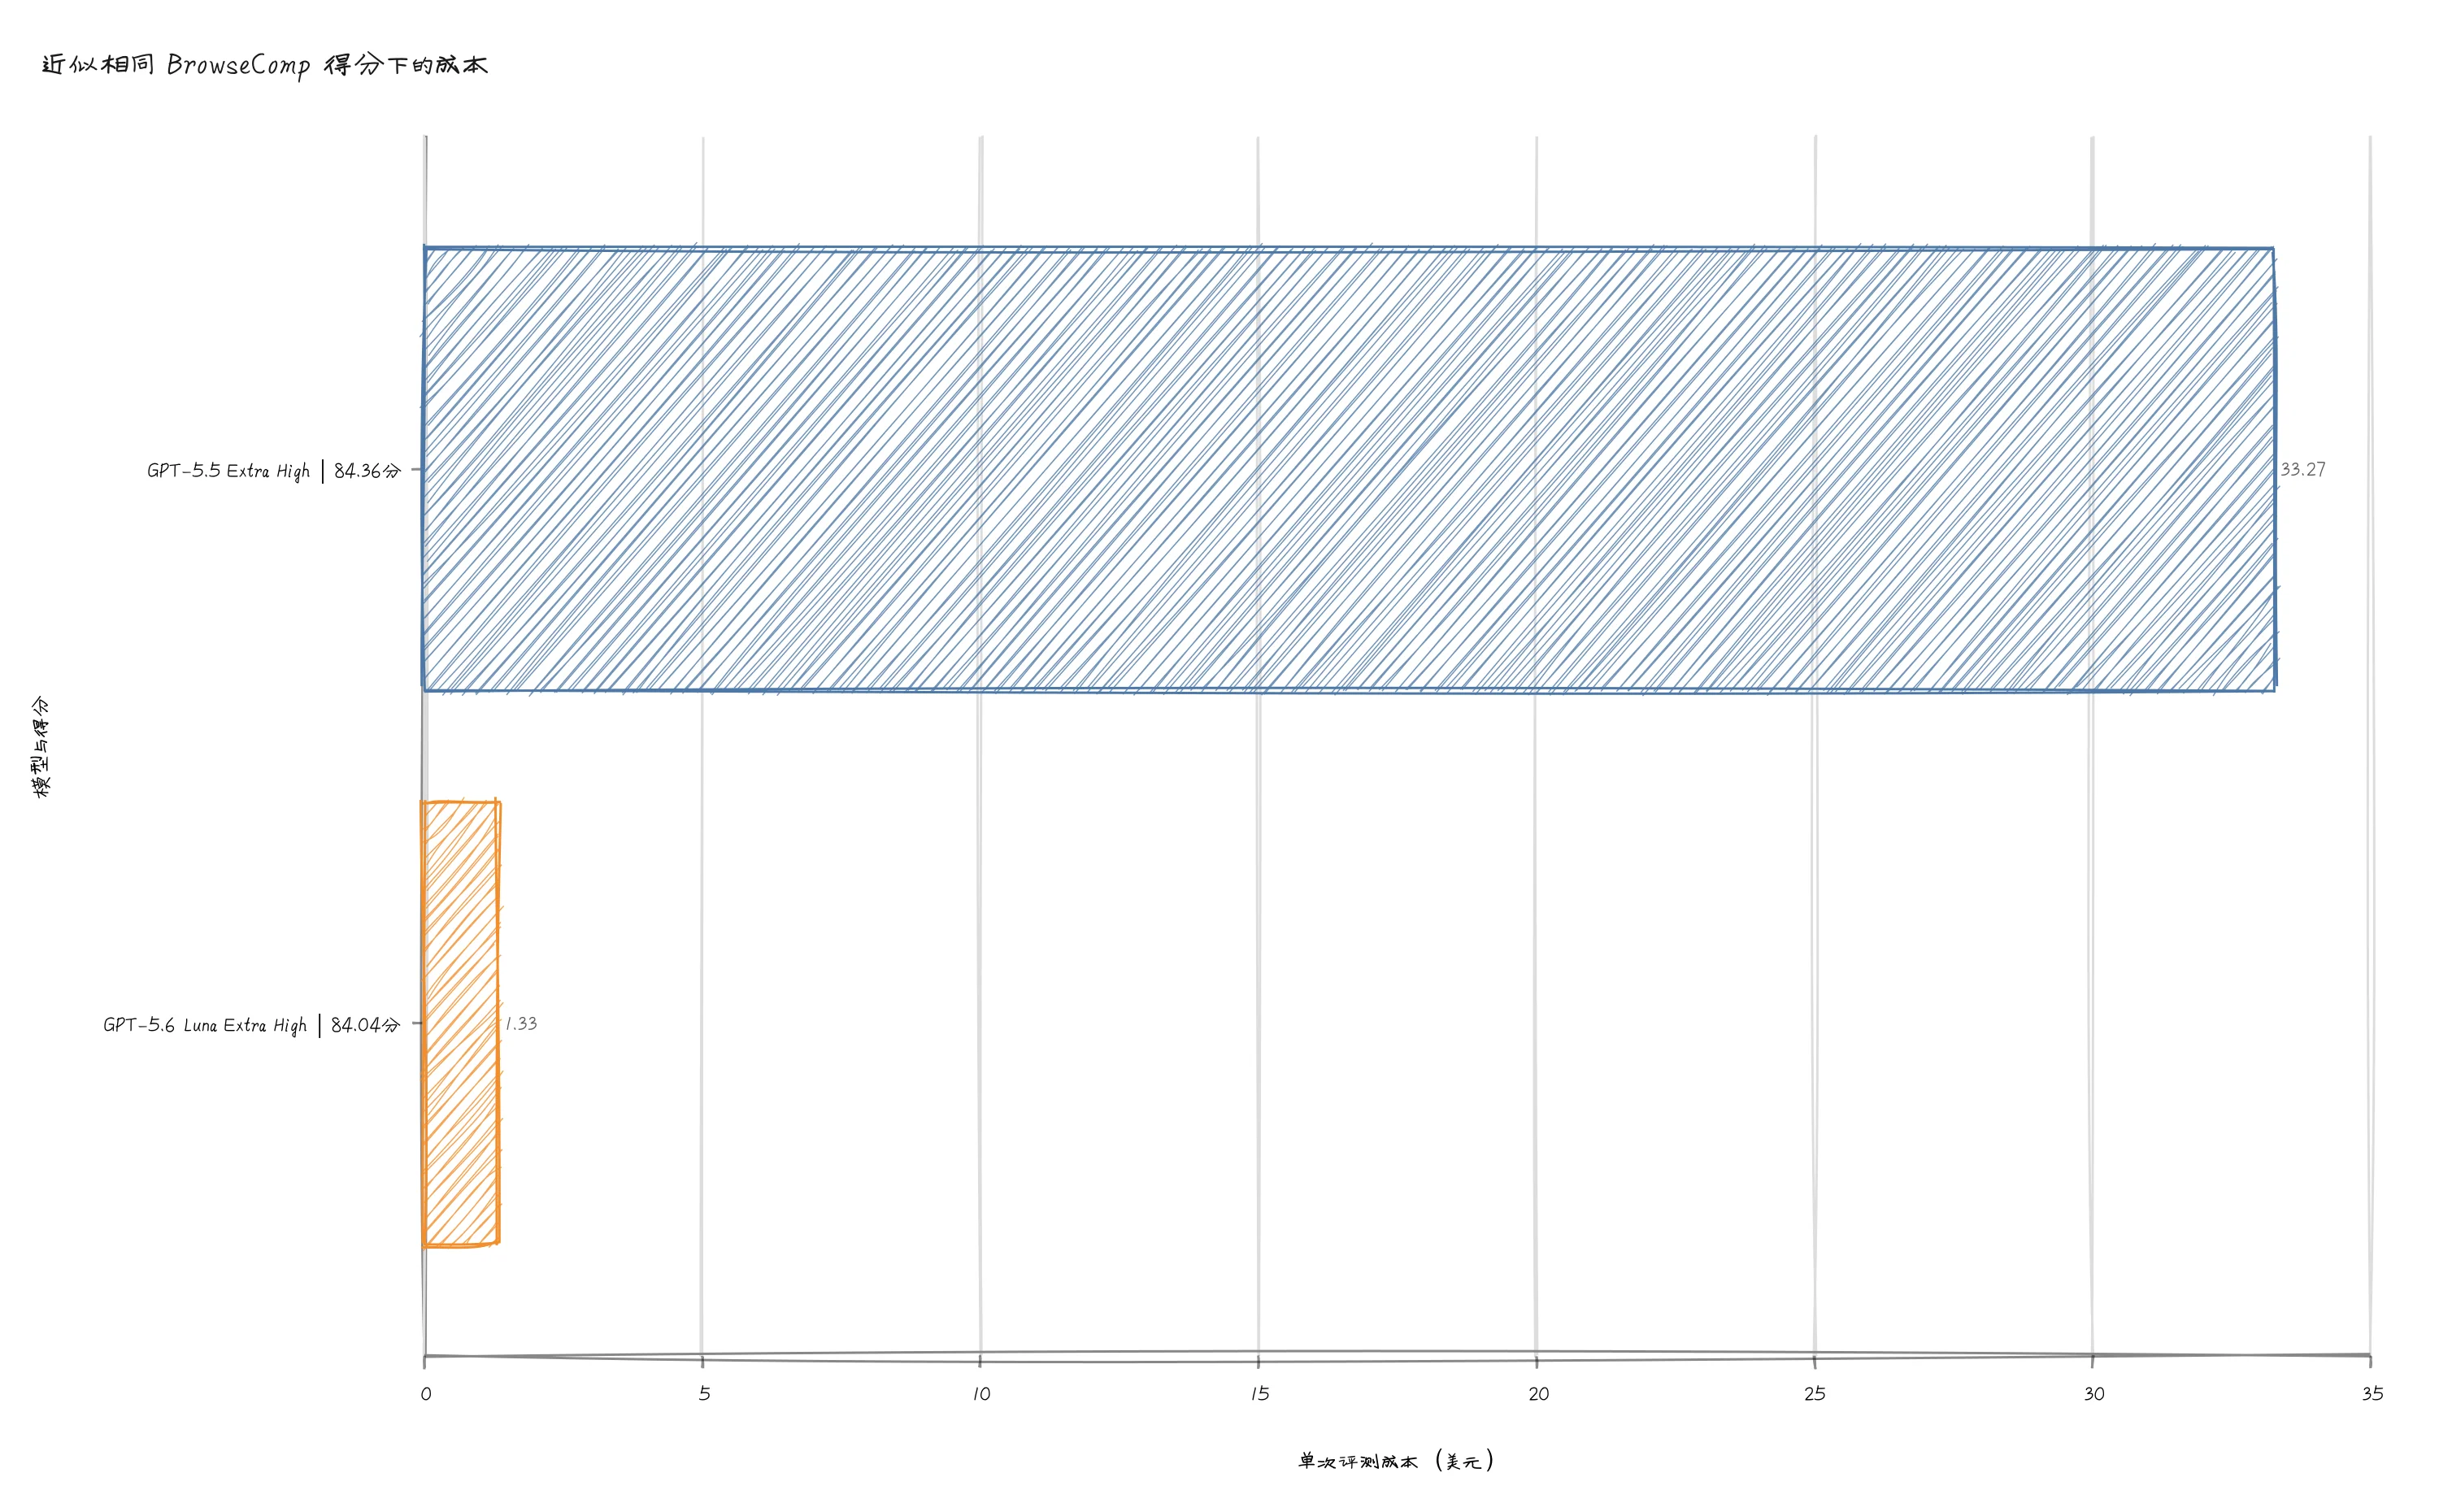
图|得分近似打平,成本从 33.27 美元降到 1.33 美元
Browser Use 还测了 106 个困难浏览器任务。Luna 完成 78%,花了约 14 美元。当时的前沿模型完成 80%,花了约 235 美元。多拿两个百分点,账单多出 221 美元。
这些数字来自 OpenAI 汇总的合作方案例,不是跨厂商统一审计,不能拿来宣布谁永久碾压谁。工作流、提示词、工具和评分器一换,结果都可能变。可它们足够说明一件事,默认把最贵模型塞进每个步骤,通常不是稳,是懒。
一条生产 Agent 流水线里,任务难度并不平均。
从十份文档里抽字段,难点是格式脏,不是推理深。给三百条搜索结果去重,难点是数据搬运,不是世界观。根据已经写清楚的规格补测试,难点是执行稳定,不是重新发明需求。真正需要高推理强度的,往往只有少数节点,比如需求含糊时定计划、多个证据冲突时做判断、变更可能删库时决定要不要继续。
如果这些步骤全走 Sol,相当于请架构师逐行复制 Excel。架构师当然能干,财务看完血压也当然会上来。
OpenAI 的性价比更新给了一个很具体的组合。复杂模型负责消除不确定性和制定计划,Luna 负责执行清晰的改动、写测试、跑测试和检查结果。这里不是大模型带小模型的营销口号,而是把同一条任务按错误代价重新切开。
我更愿意把路由条件写成一条朴素的式子。
风险分 = 错误代价 × 不确定性 × 回滚难度
这不是 OpenAI 的官方公式,只是一条工程启发。风险分低,优先让 Luna 做,配上明确输出格式和便宜重试。风险分中等,交给 Terra,要求它给证据和置信度。风险分高,才让 Sol 接手,同时保留人工审批或独立评测。
注意,模型路由不是先猜哪款模型聪明,而是先问哪一步出错最贵。
一个分类标签错了可以重跑,一封已经发给客户的法律承诺可没那么好回滚。模型名字一样,风险等级完全不是一回事。
厉害了,真正省钱的开关,不在模型下拉框,在任务图里。
同一个模型,为什么能抬高近三倍
再回到开头那组 13.3% 和 38.3%。
OpenAI 说,分数变化来自两个设置,保留推理和压缩。细节可以看官方的 ARC-AGI-3 Harness 调查,但背后的问题很常见。
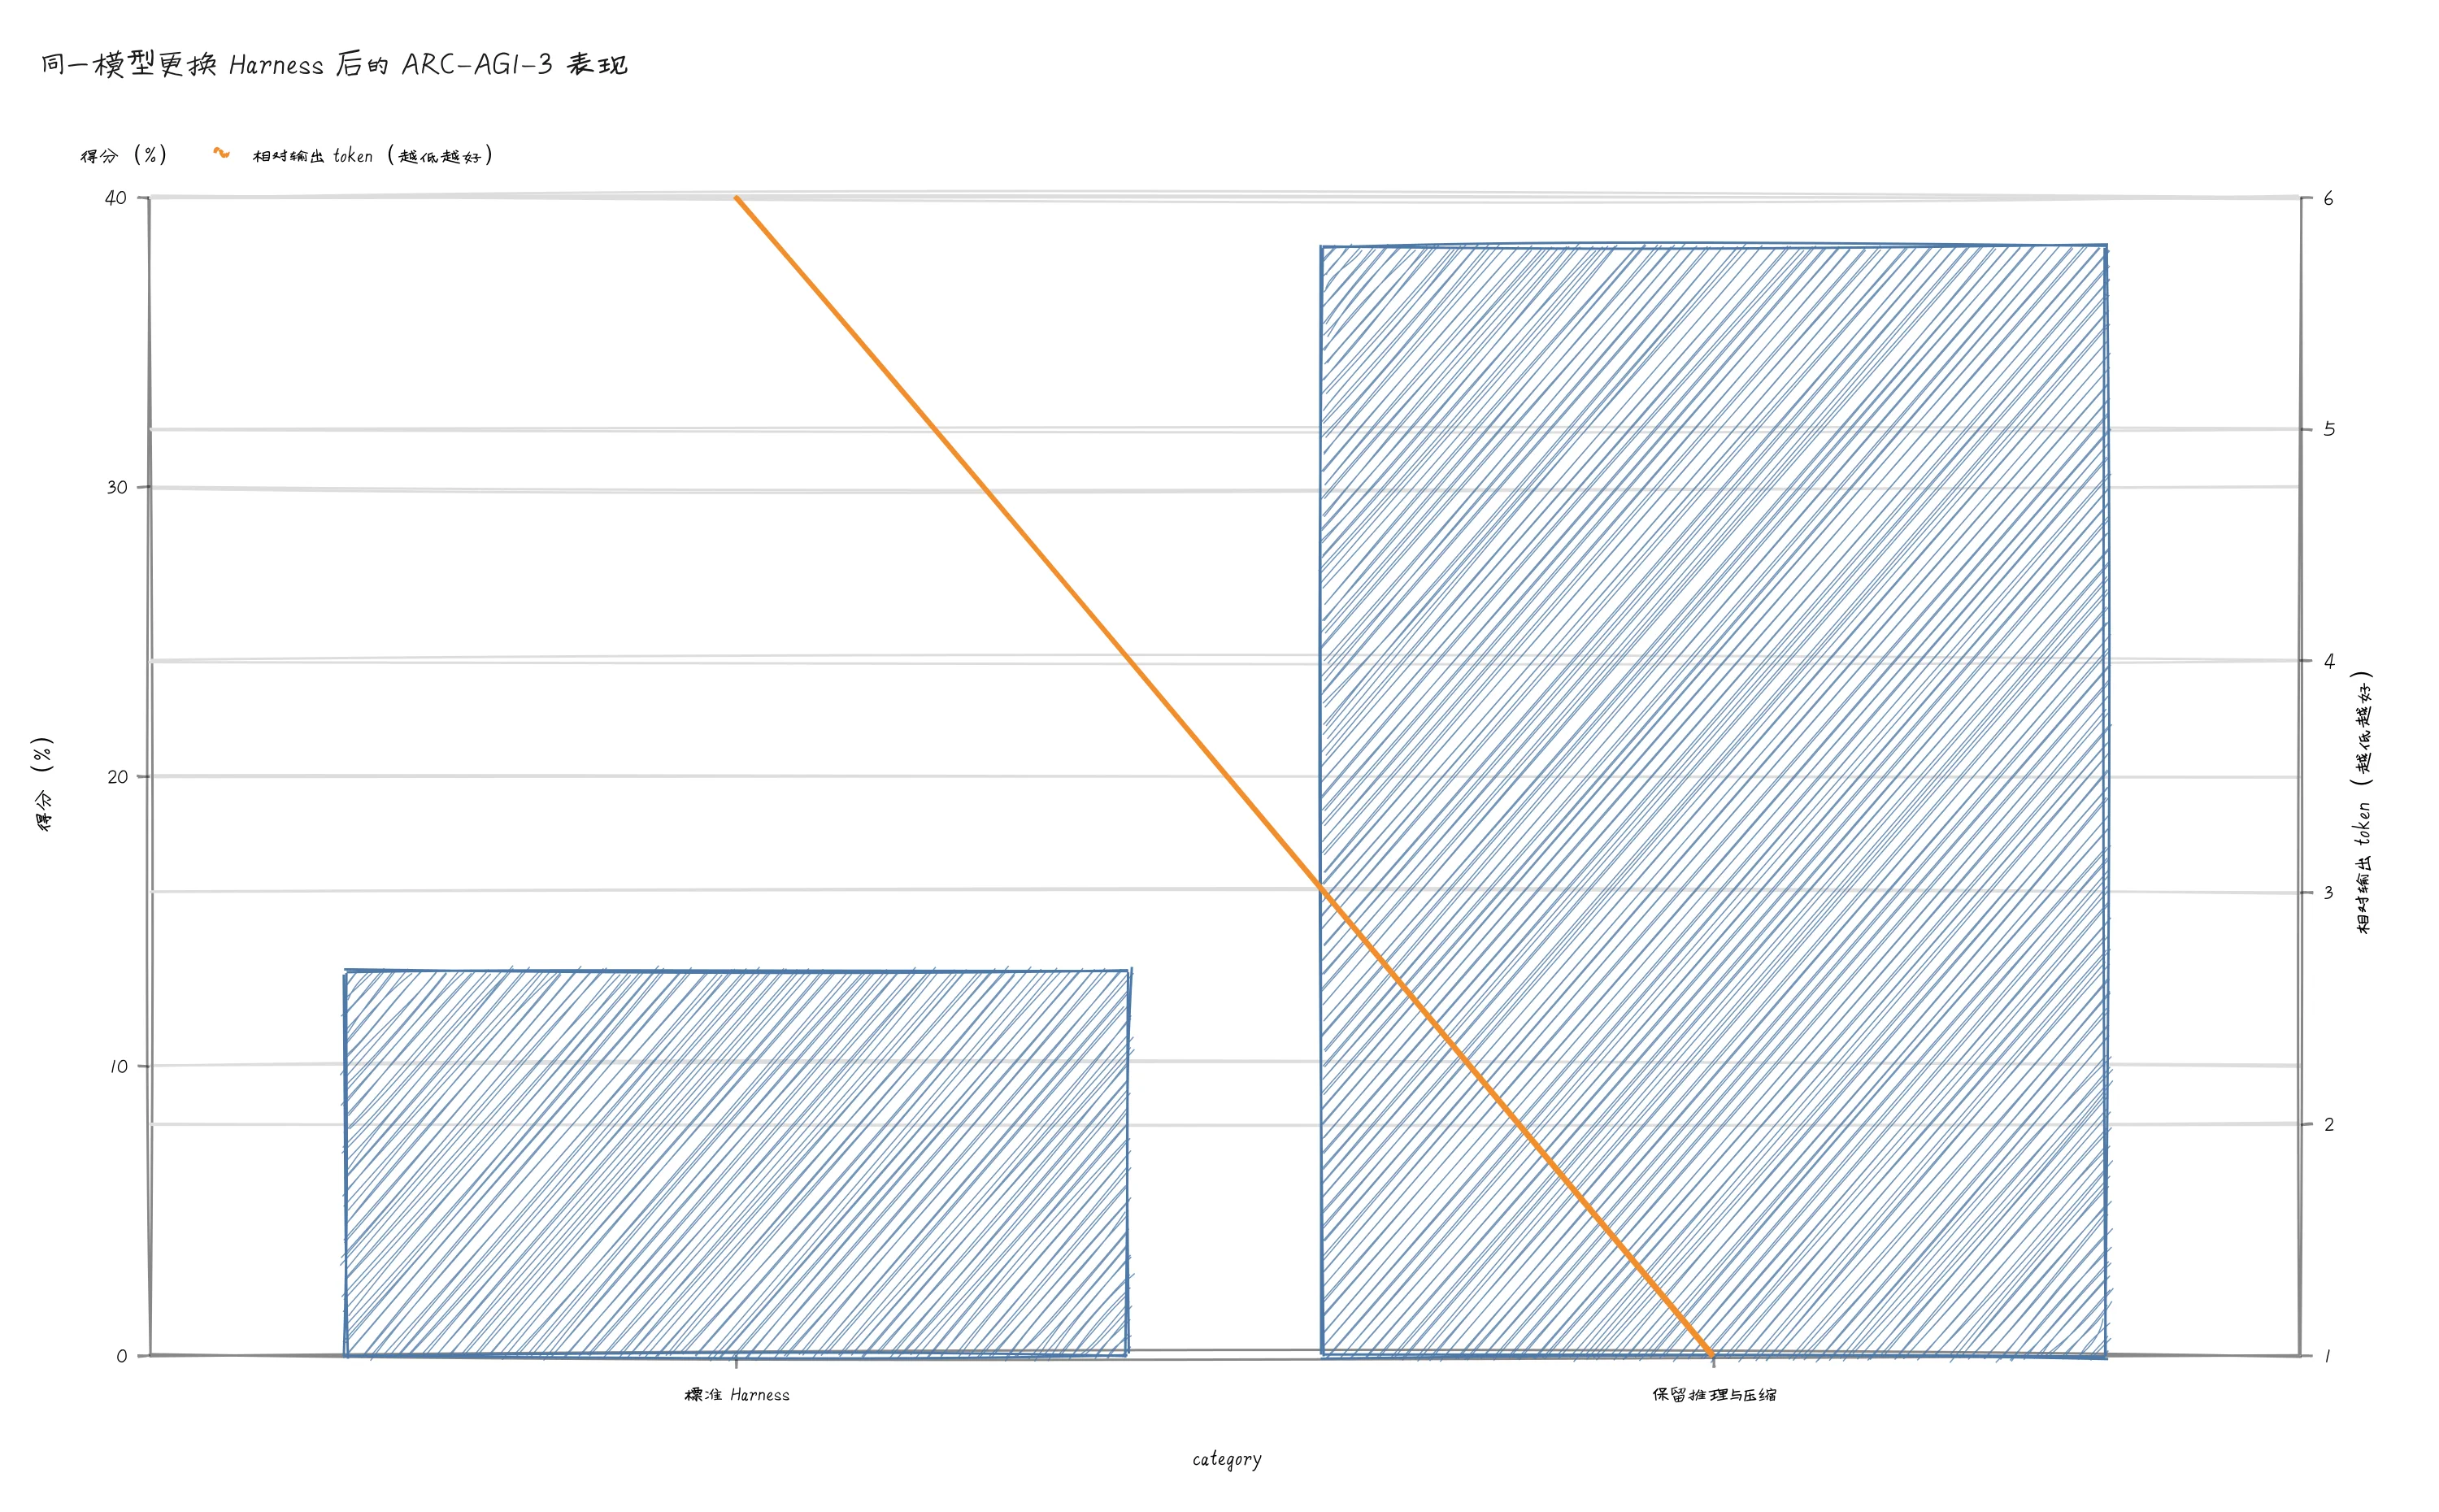
图|柱形是 ARC-AGI-3 得分,折线是相对输出 token,越低越省
长任务跑到后半程,模型会开始丢东西。
它忘了前面为什么排除某条路径,忘了某个工具已经报过同样的错,忘了用户对边界条件的要求。上下文越塞越长,重复日志、过期计划、工具原始输出一起挤进窗口。模型看似拥有完整历史,真正能用的信号却越来越稀。
很多系统的处理办法很粗暴,窗口快满了就总结一下。麻烦在于,总结常把结论留下,把判断过程擦掉。前面已经验证过 A 路径失败,压缩后只剩一句尝试过 A。下一轮模型看不到失败条件,又兴致勃勃走回去。
哦豁,昂贵的轮回。
推理状态持久化解决的是已经想明白的东西不要每轮重建。长会话压缩解决的是上下文变长后,保留后续行动需要的状态,同时缩小继续请求的输入。两个能力放在一起,模型既不用反复交思考税,也不用背着整袋终端日志继续跑。
但别把它理解成打开两个参数,所有 Agent 自动涨三倍。ARC-AGI-3 是特定基准,13.3% 到 38.3% 不能平移到客服、代码审查或网页研究。真正能抄走的是状态设计。
一条长任务至少要分清四样东西,用户目标、已经确认的事实、仍待验证的假设、下一步动作。工具原始输出可以归档,关键证据要带来源进入状态,失败尝试要留下可判定的原因,计划变化要记录是谁因为什么改的。
很多 Agent 只有聊天记录,没有任务状态。聊天记录是一条河,什么都流过去。任务状态更像航海日志,当前位置、已知暗礁、剩余燃料和下一段航线都写得清楚。窗口要压缩时,河水可以少装一点,航海日志不能丢。
这块如果你正在搭系统,可以先做一个很小的改动。别把所有工具返回原封不动拼回 prompt,给每次调用生成结构化事件,至少留 tool、input_hash、result_ref、decision 和 retryable。下一轮真正需要原文时再按引用取,不需要就只读事件摘要。
说真的,这种改动看起来没换模型刺激,甚至不太适合发发布会。可线上 Agent 能不能跑半小时不迷路,常常就卡在这些不起眼的字段上。
工具越多,越该把笨活赶出上下文
GPT-5.6 这次还有一个挺有意思的能力,叫 Programmatic Tool Calling,可以让模型写 JavaScript,在隔离运行时里编排工具调用、并行执行、循环、过滤和聚合中间结果。
官方举了一个金融研究场景。Agent 拉回一百份文件,再按日期筛选,找出相关交易。传统做法是把一百份文件和所有工具结果塞进上下文,让模型一边读一边筛。Programmatic Tool Calling 则让程序先完成确定性的搬运与过滤,模型只处理仍需判断的部分。Rogo 的案例里,评分质量保持不变,输入 token 减少 21%。
这手设计有点子牛逼。
不是因为模型突然会写 JavaScript。模型早就会。关键是工具编排有了一个受控的中间层。官方文档写得很明确,这个 V8 运行时没有 Node.js、包安装、直接网络、通用文件系统或子进程。它只能通过本次请求里获准的工具访问外部系统。
能力边界比代码能力更重要。
做 Agent 的朋友大概都见过一种上下文污染。搜索工具返回二十页,数据库工具返回五百行,日志工具顺手带上三千行堆栈,模型认真读完,token 先没了一半。更糟的是,九成内容只参与一次筛选,后面再也用不到,却一路跟着会话吃缓存、拖延迟。
能确定完成的活,就别让语言模型反复读。
排序、去重、字段映射、日期过滤、数值汇总、分页追取,这些任务优先放进代码。模型负责决定筛什么、哪些异常值得留下、证据够不够支撑结论。代码负责把动作稳定地做完。
这不是让 Agent 少用工具,而是让工具结果少污染思考。
缓存也是同一回事。OpenAI 的提示词缓存文档强调,缓存命中依赖前缀完全一致。稳定的系统指令、工具定义和示例放在前面,用户输入和运行时变量放在后面,才更容易复用。官方指南里,Ploy 给一段 2.9 万 token 的共享提示词加缓存断点和工作区 key,未缓存输入减少 28%。缓存窗口也延长到至少 30 分钟。
很多团队一边抱怨缓存命中率低,一边把时间戳、随机 ID 和动态工具描述塞在最前面。不是缓存不给力,是每次请求都主动换了锁芯。
把静态前缀固定,把动态状态引用化,把大结果留在上下文外面。三件事做完,模型还没升级,账单通常已经先瘦一圈。
多 Agent 不是多开几个标签页
GPT-5.6 的原生多智能体能力允许根 Agent 在一次 Responses API 请求里启动并协调多个子 Agent。代码库探索、文档整理和实现任务,确实很适合并行。
可多 Agent 最容易制造另一种幻觉。
屏幕上同时跑着六个进度条,看起来像一个繁忙的小团队。等结果回来,三个子 Agent 查了同一份文档,两个用了互相冲突的假设,根 Agent 光合并它们就花掉更多 token。热热闹闹,产出一份分布式内耗。
原生能力是 Beta,官方也提醒,多 Agent 的行为可以被明确指令控制。重点不在能不能开,而在什么时候值得开。
一个任务适合并行,至少要满足三个条件。子任务之间依赖少,可以独立推进。每个子任务有清楚的交付契约,结果能压缩成短证据。并行节省的时间或提高的覆盖率,足以抵掉额外 token 和合并成本。
这三个条件里,最容易漏的是第二个。
如果根 Agent 只说去研究一下,子 Agent 会把研究理解成不同的东西。有人写背景,有人找数据,有人开始做方案,回来后自然难合。换成找出三条支持结论的官方证据,每条包含 URL、日期、原文位置和一句判断,合并成本立刻下降。
我自己的判断是,多 Agent 最该优化的不是并发数,是接口。
根 Agent 用 Sol 做任务拆解和冲突裁决,子任务如果边界清楚,交给 Luna 并行执行。返回时不交作文,交结构化证据。发现子任务仍然高度耦合,就别硬拆,单 Agent 带着完整状态继续跑,反而更稳。
可能有小伙伴会问,模型现在已经这么强,为什么还要费劲设计这些路由、状态和接口?
因为模型越强,浪费也越隐蔽。
弱模型做错,你一眼能看出来。强模型在错误结构里工作,常常能给出一份语气笃定、格式漂亮、成本很高的次优答案。它把流水线的问题遮住了,直到任务变长、并发变大或账单翻上去,暗礁才露出来。
真正该升级的,是这张系统账
把 OpenAI 这篇指南压成一条可执行的路线,大概是这样。
入口先做风险与不确定性判断,别按用户身份粗暴分模型。低风险、高吞吐的步骤默认交给 Luna,中间态交给 Terra,只有规划、冲突裁决和高代价动作才升级到 Sol。
任务一旦变长,就把聊天记录和任务状态拆开。保留已经完成的推理与关键证据,压缩会话噪声,工具原始输出用引用回取,不要每轮重复塞。
遇到排序、过滤、聚合和批量工具调用,把确定性部分赶进代码。多 Agent 只用于真能并行的工作,子 Agent 必须带着交付契约回来。稳定前缀放前面,动态内容放后面,让缓存真的有机会命中。
然后再做一件很不性感但最重要的事,评测。
别只记成功率。每条路由至少同时看任务通过率、单位任务成本、P95 延迟、人工接管率和重试次数。小模型便宜却重试五次,不一定真便宜。大模型一次过但把所有任务都当博士论文,也不一定真稳。
OpenAI 的案例给了一个很好的提醒,模型选择和 Agent 架构不能分开测。只换模型不换 Harness,你测到的是模型适应旧系统的能力。只改 Harness 不做分层评测,你也不知道优化到底来自哪一层。
我可能看走眼,但 GPT-5.6 这波真正会拉开团队差距的,不是大家都能点到的 Sol,而是谁先把 Luna、Terra、Sol 变成一条有状态、有边界、会算账的流水线。
13.3% 到 38.3%,差的不是一颗更大的脑子。
差的是脑子外面,那本一直没人认真写的航海日志。