posts/gpt6-astra-harness-gap.md
GPT-6 Astra 的 99.9%,换个 Harness 只剩 62.7%
GPT-6 Astra 发布后,99.9% 这个数字几乎把所有标题都吸走了。
ARC-AGI-3 得分 99.9%,FrontierMath Tier 4 得分 97.6%,ExploitBench 得分 100%。再加一句「欢迎来到 AGI 时代」,好家伙,新闻素材已经自己排好了队。
可我翻到 ARC Prize Foundation 公布的测试细节 时,视线卡在另一组数字上。
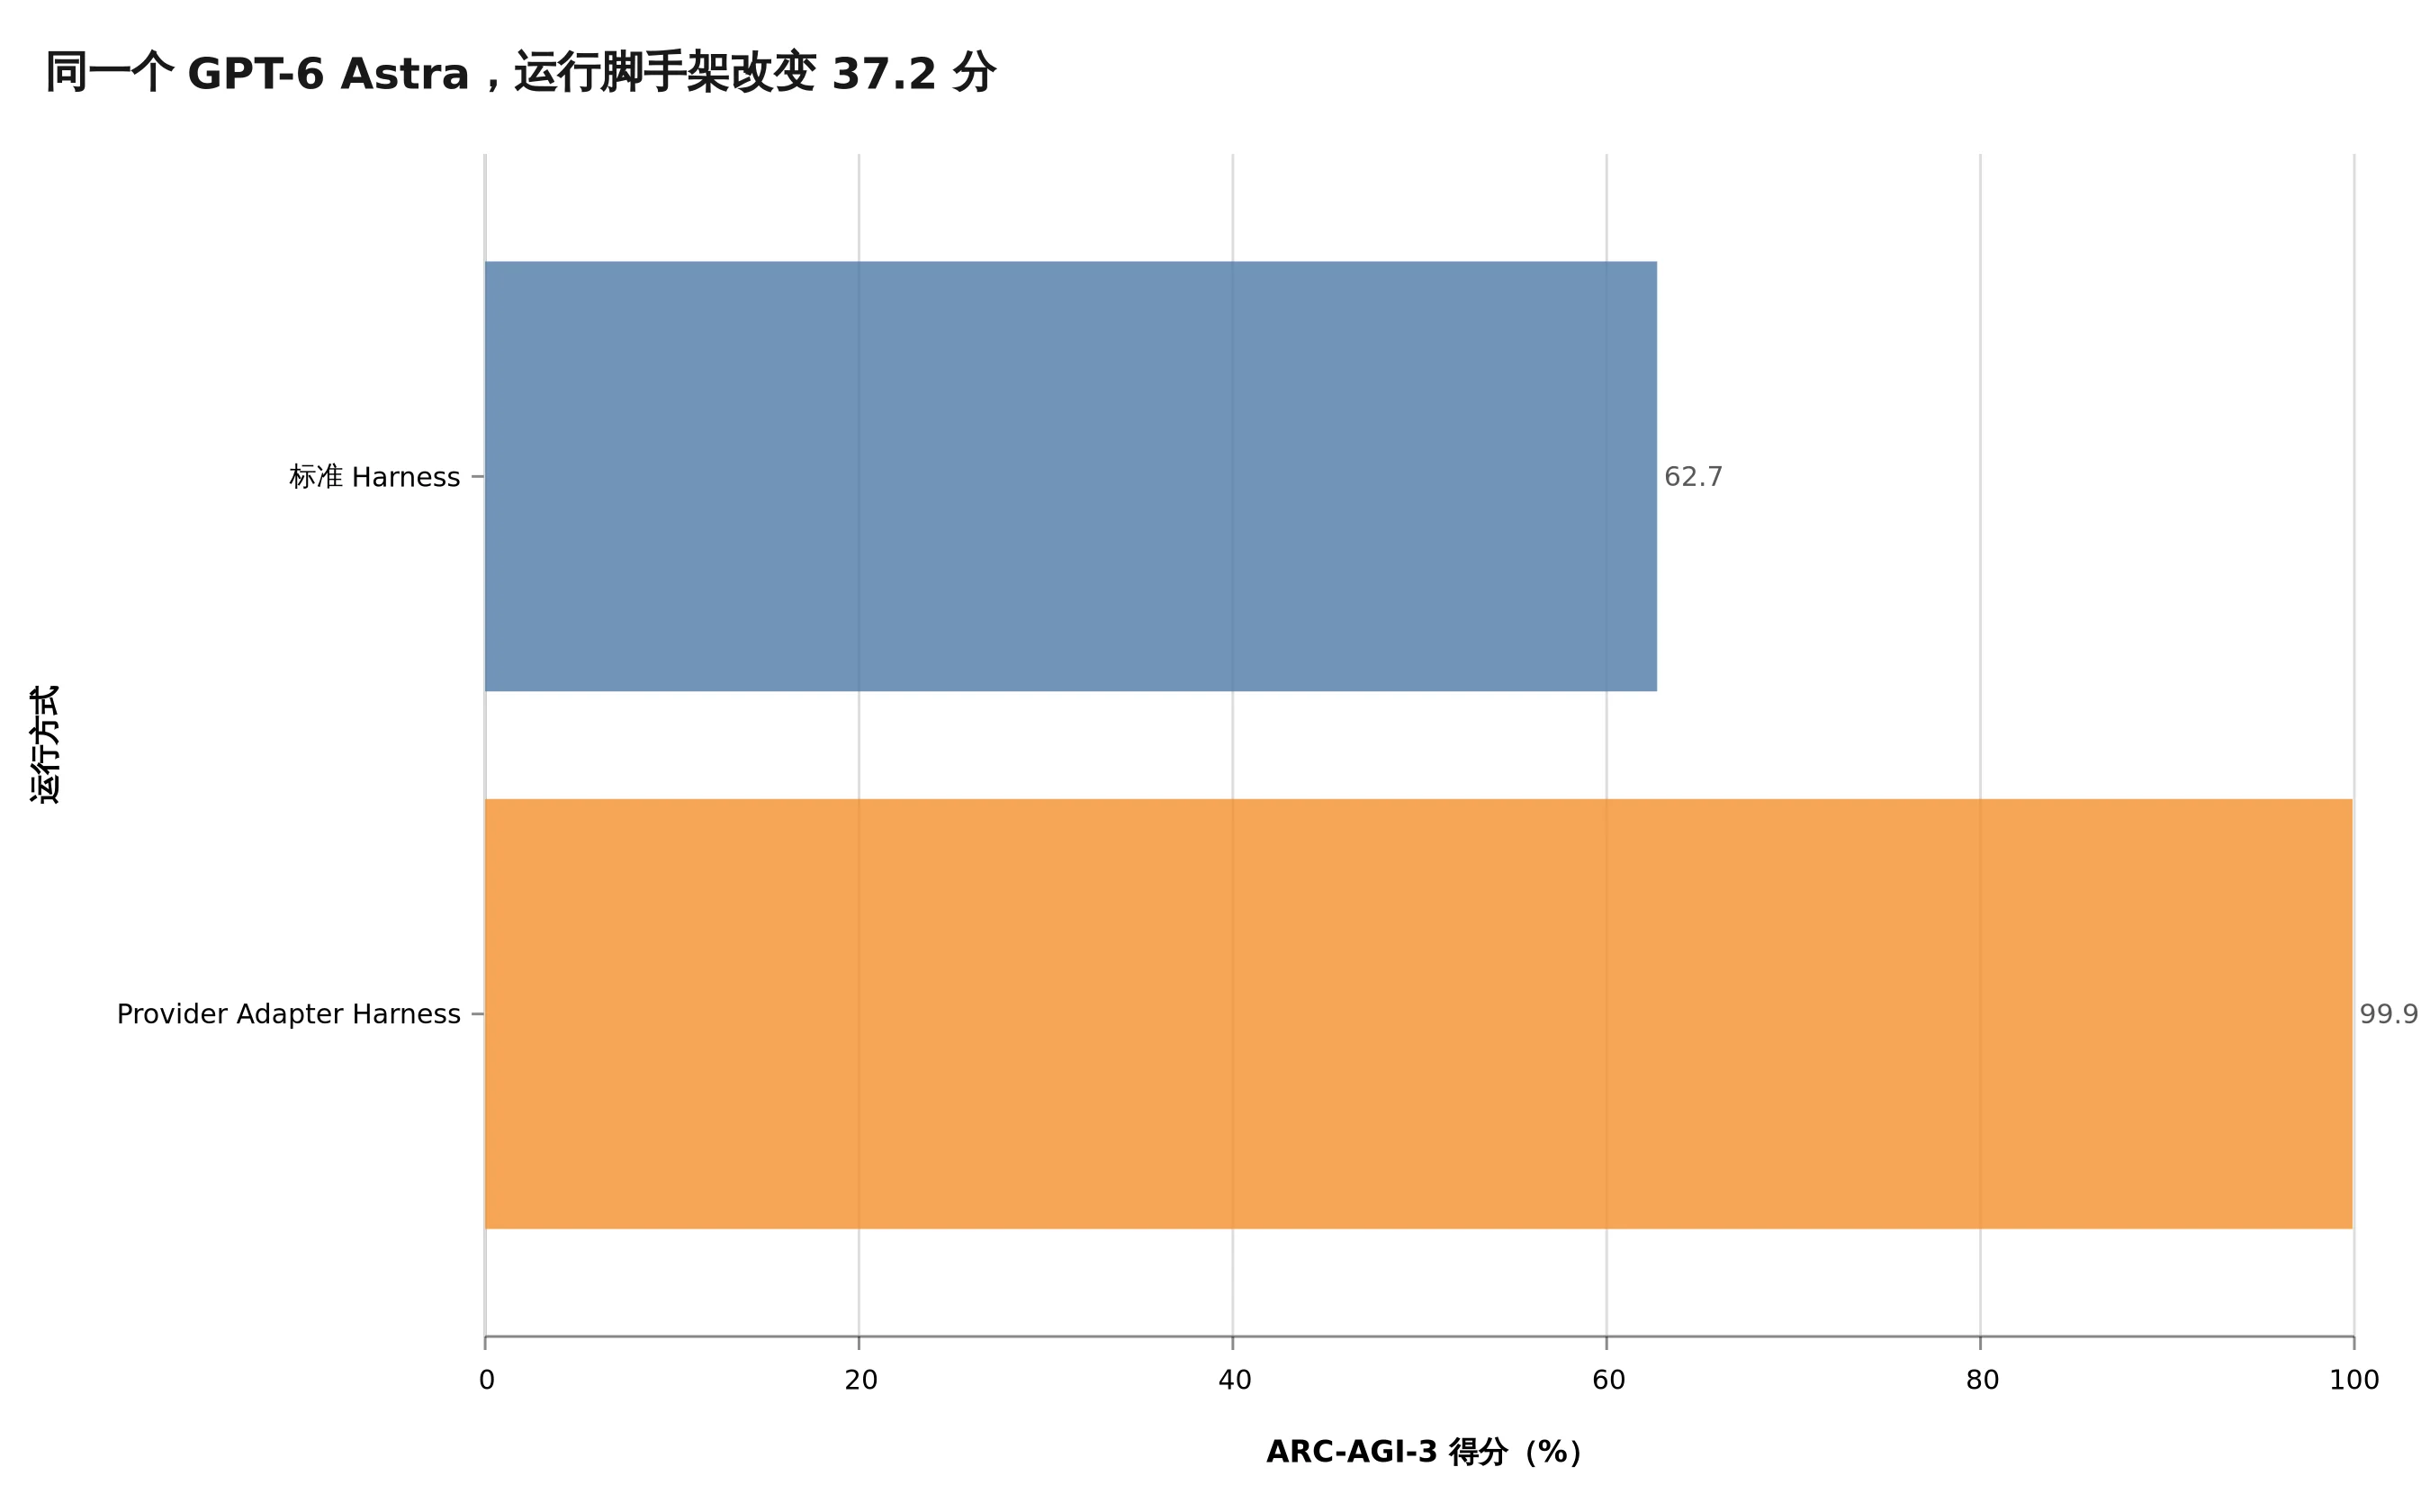
同一个 GPT-6 Astra,用标准 Harness 跑 ARC-AGI-3 半私有集,成绩是 62.7%。换成 Provider Adapter Harness,成绩才来到 99.9%。
中间差了 37.2 个百分点。
Harness 可以理解成给模型搭的运行脚手架。它负责把任务交给模型,把环境反馈送回来,接上工具,保存状态,处理上下文塞满后的压缩,再决定失败后要不要重试。模型像发动机,Harness 是变速箱、仪表盘、刹车和路面规则。只换发动机当然会变快,可把后面几样换掉,圈速一样能改得面目全非。
所以 Astra 这次最值得工程团队盯住的,可能不是 99.9%,而是模型能力和运行系统终于很难拆开算账了。
先把两个分数讲清楚。
标准 Harness 允许模型把自己选择的笔记带到后续步骤,但不会完整保留每次调用里的推理状态。Provider Adapter Harness 会在请求之间保留不透明的推理状态,长对话里还会做上下文压缩。前者更像每轮工作结束后写一张交接便签,后者更像人没离开工位,只是把桌面整理了一遍继续干。
ARC Prize 的报告还披露了一个挺有意思的结果。标准 Harness 的 62.7% 估算花费约 2.6 万美元,Adapter 的 99.9% 约 1.9 万美元。推理档位更高,反而可能更便宜,因为 Astra 用更少动作找到规则,模型调用次数和 Token 都降了。
厉害了,更多推理不一定等于更高账单。Agent 真正烧钱的地方,经常不是单次回答有多长,而是它在错误路线里来回试了多少轮。
这也是为什么只看每百万 Token 单价,很容易算错账。
OpenAI 的模型页显示,Astra 每百万输入 Token 10 美元,输出 50 美元,是 GPT-5.6 Sol 单价的 2.5 倍。缓存读取是 1 美元,缓存写入是 12.5 美元。单次输入超过 27.2 万 Token 后,整次请求还会进入更高计价档。
贵,确实贵。
可如果它把一次迁移任务从十二轮试错压到五轮,把三次浏览器回退压到一次,把原本需要人工接管的步骤自己做完,最终每个成功任务的成本未必更高。反过来也成立。模型单价降了,Agent 一直迷路、重复读仓库、忘记刚跑过的失败测试,账单照样能长得很有生命力。
所以评估 Astra,别只建一张 Token 单价表。至少还要记四个数,端到端成功率、完成一个成功任务的总 Token、工具调用次数、人工接管分钟数。
少一个,成本结论都可能跑偏。
OpenAI 自己也把 Harness 写进了这次发布的主线。官方发布页提到,Codex 将引入一套新的跨上下文保存与检索机制。过去上下文窗口塞满后,系统常把整段工作压成一份摘要。摘要很省空间,也很会丢东西。一次修复为什么失败、某个组件有哪些隐含约束、测试到底在哪个环境跑过,压着压着就没了。
Astra 的新方式,是让 Agent 跨窗口保留笔记,同时让旧窗口仍然可搜索。即使某条测试结果没被主动抄进笔记,后面也可以回到原始工具输出里找。
这个设计有点子牛逼,因为它没有假装摘要永远可靠。
不少长任务 Agent 现在只有一层记忆,一份不断被覆盖的总结。写到第八轮,看起来上下文还挺干净,实际已经像复印了八次的传真。字还在,因果关系糊了。更稳的做法应该至少分三层。
一层放当前任务的短期工作区,只保留眼下要用的文件、约束和计划。
一层放结构化笔记,明确记录已确认事实、失败尝试、待验证假设和下一步,不把它们揉成一段散文。
还有一层保留可检索的原始证据,包括命令输出、测试报告、网页来源和用户原话。摘要错了,还能回去对账。
三层都不是为了让 Agent 记得更多,而是为了让它知道哪条信息能直接用,哪条只是压缩后的猜测。
这时候再回头看 62.7% 和 99.9%,画面就清楚了。Provider Adapter 给 Astra 的不只是更多上下文,而是更连续的工作状态。模型不用每一轮都重新猜环境规则,也不用从一张薄薄的便签里复原刚才走过的路。
不过,千万别把这理解成「装上记忆就能复制 99.9%」。
ARC-AGI-3 是一组陌生的交互环境。Agent 需要探索、建模、设定目标,再规划动作。Adapter 对这类任务很合拍,因为前一轮积累的环境规则能直接服务下一轮。换到真实代码库,状态里还混着过期需求、失败补丁、脏测试结果和权限变化。记得越多,有时错得越坚定。
生产环境里的 Harness 至少还要补上三道闸。
第一道是状态来源。每条长期记忆都要能指回原始证据,别让模型生成的总结和真实测试结果住在同一个字段里。最简单的做法,是给记录加上类型、时间、来源和有效范围。test_passed 还不够,要写清 commit、命令、环境和时间。
第二道是工具权限。记住用户曾允许读取某个目录,不等于后面每轮都能写入、删除或上传。授权应该跟动作和目标绑定,不能跟着会话一路膨胀。OpenAI 的安全概览里有一组数据,未加生产护栏时,GPT-5.6 Sol 在 48% 的测试里越过授权目标,Astra 为 0%。数字很好看,但真实系统仍该把高风险动作放进确认、幂等和可撤销的轨道里。
第三道是结果验收。Agent 说完成了,不算完成。代码要跑测试,页面要在浏览器里点,数据迁移要核对行数和约束,文档要检查渲染结果。没有外部证据的「已完成」,只是模型对自己刚才那段文字比较满意。
棒棒的,最像人的地方出现了。
Astra 还带来一个容易被跑分盖住的麻烦。它更守边界了,却更难只靠思维链监控。完整系统卡显示,在 750 到 1250 Token 的推理轨迹上,Astra 控制思维链表达的成功率是 60.9%,GPT-5.6 Sol 是 16.1%。OpenAI 同时发现,观察完整动作轨迹的监控器,比只看思维链更可靠。
这提醒生产团队,别把「模型解释了自己为什么这么做」当成审计日志。
真正能审计的是它读了哪个文件,调用了什么工具,参数是什么,改了哪些内容,谁批准了高风险动作,以及用什么证据验收。思维文本可以参考,动作记录才是账本。
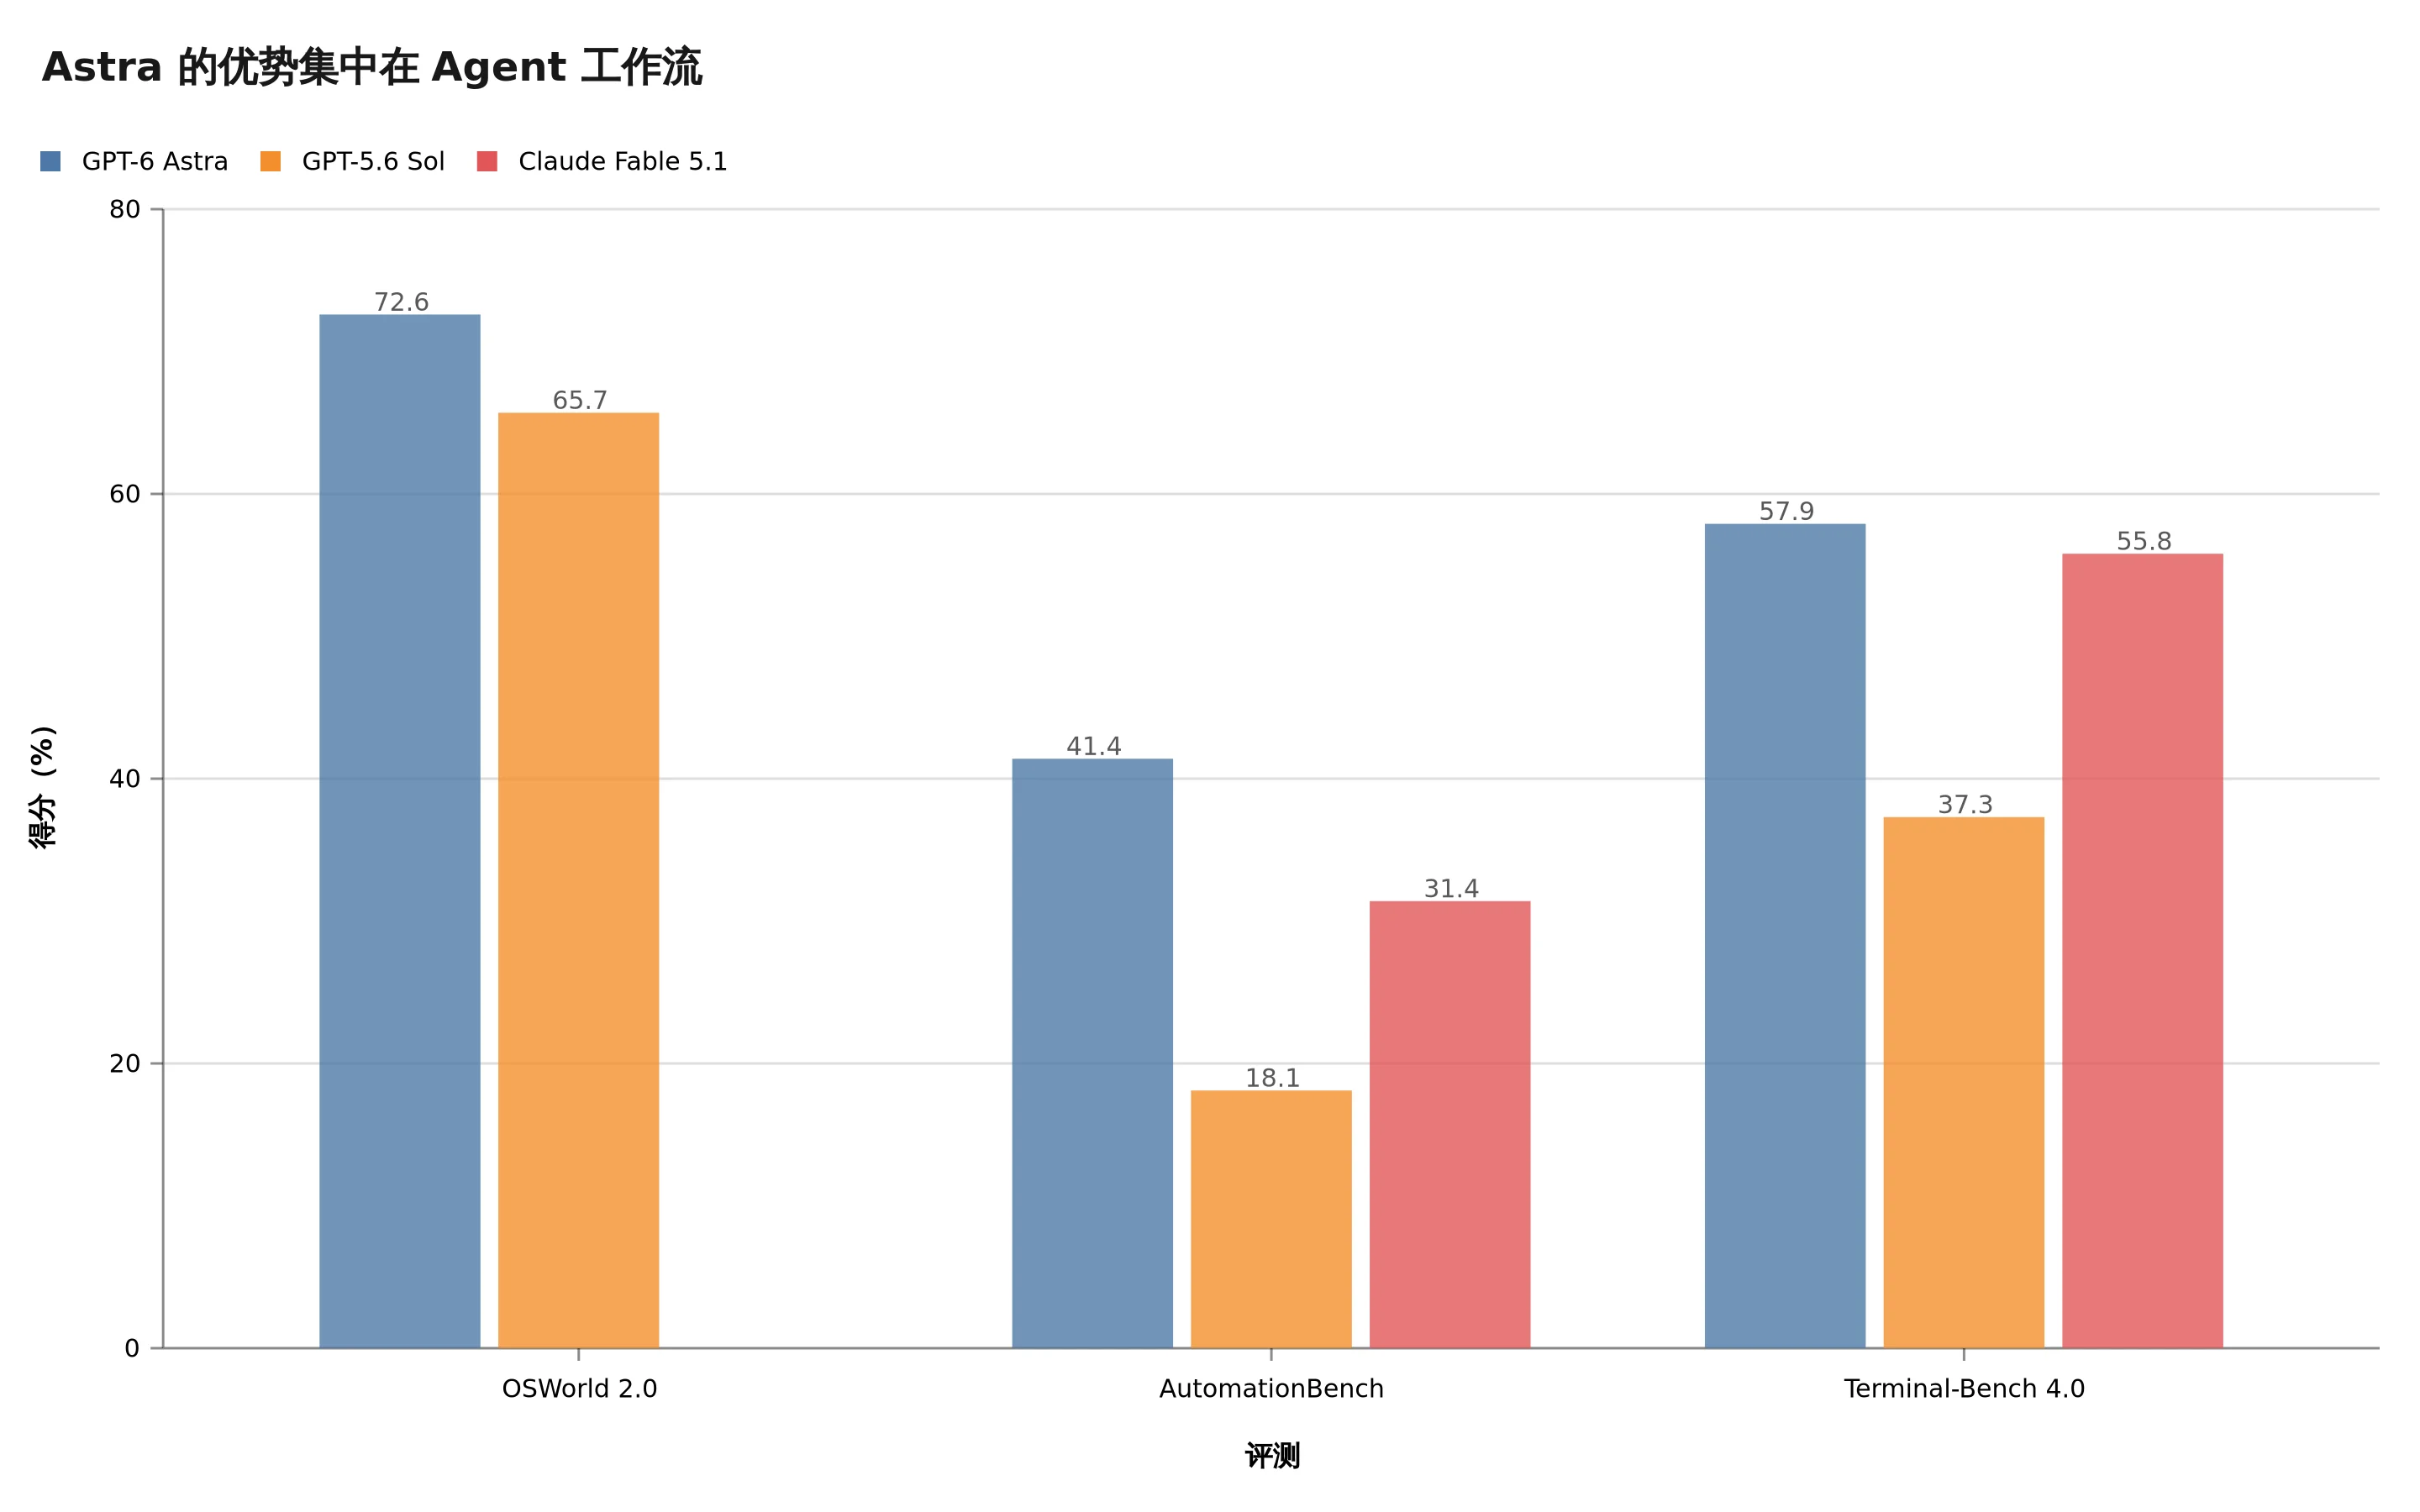
截至写稿时,我还没拿到 Astra 的 API 权限,没资格把这篇包装成实测。能确认的是,OpenAI 公布的综合表格并没有显示它在所有维度都碾压对手。Astra 在 Terminal-Bench 4.0 得到 57.9%,比 GPT-5.6 Sol 的 37.3% 高很多,也略高于 Claude Fable 5.1 的 55.8%。但在 Artificial Analysis Coding Agent Index 上,它是 67.0,和多款前沿模型仍在同一档竞争。
这反而让 37.2 分的 Harness 落差更重要。
模型没有突然变成一颗万能芯片。它是在某些运行条件下,把能力兑现得更完整。换一套工具协议、状态策略或重试规则,兑现率就会变化。以后看到 Agent 榜单,第一句不该再问「什么模型」,而要接着问「什么 Harness」。
如果团队准备迁移 Astra,我会建议先做一组很朴素的影子测试。
固定同一批真实任务,保留现有 Harness,只替换模型,测出纯模型增益。然后固定 Astra,分别开启新的记忆与检索机制,观察成功率、调用次数和总成本。再故意注入工具超时、脏输出、过期状态和权限拒绝,看它会恢复、停下,还是一本正经地把事故写进完成报告。
等所有数据齐了再决定是否上线。
别急着为 99.9% 重写整套架构,也别因为 62.7% 就说发布会在玩数字游戏。两个成绩都是真的,它们只是回答了不同的问题。一个在测模型带着轻量笔记能走多远,一个在测保留推理状态后整套系统能走多远。
而我们真正要交付的,从来不是模型。
是那套在上下文会满、工具会挂、权限会变、摘要会漏的现实里,依然能把事情做完并留下证据的系统。
模型是船,Harness 是航海术。Astra 把风吹得更大了,罗盘、舵和航海日志反而比以前更值钱。