posts/grok-46-long-horizon-agents.md
Grok 4.6 跑分追平了,长任务还是不能放心交
61 分。
Grok 4.6 在 Artificial Analysis Intelligence Index 上拿到 61 分,追平 GPT-5.6 Sol,只比 Fable 5 Max 少 1 分。这个数字很适合做海报,四根柱子往那儿一摆,橙色那根已经挤进第一排。
好家伙,又一位前沿选手坐上桌了。
但我顺着官方表格往下看,味道马上变得复杂。Grok 4.6 在 GDPVal-AA v2 和 Harvey LAB 上拿到了表中最高分,CursorBench v3.2 也很强,可到了更贴近终端操作的 Terminal-Bench v3.0,它是 26%,GPT-5.6 Sol 是 34.6%,Fable 5 Max 是 34.1%。DeepSWE v1.1 里,Grok 4.6 的 65.9% 也落后于 GPT-5.6 Sol 的 73%。
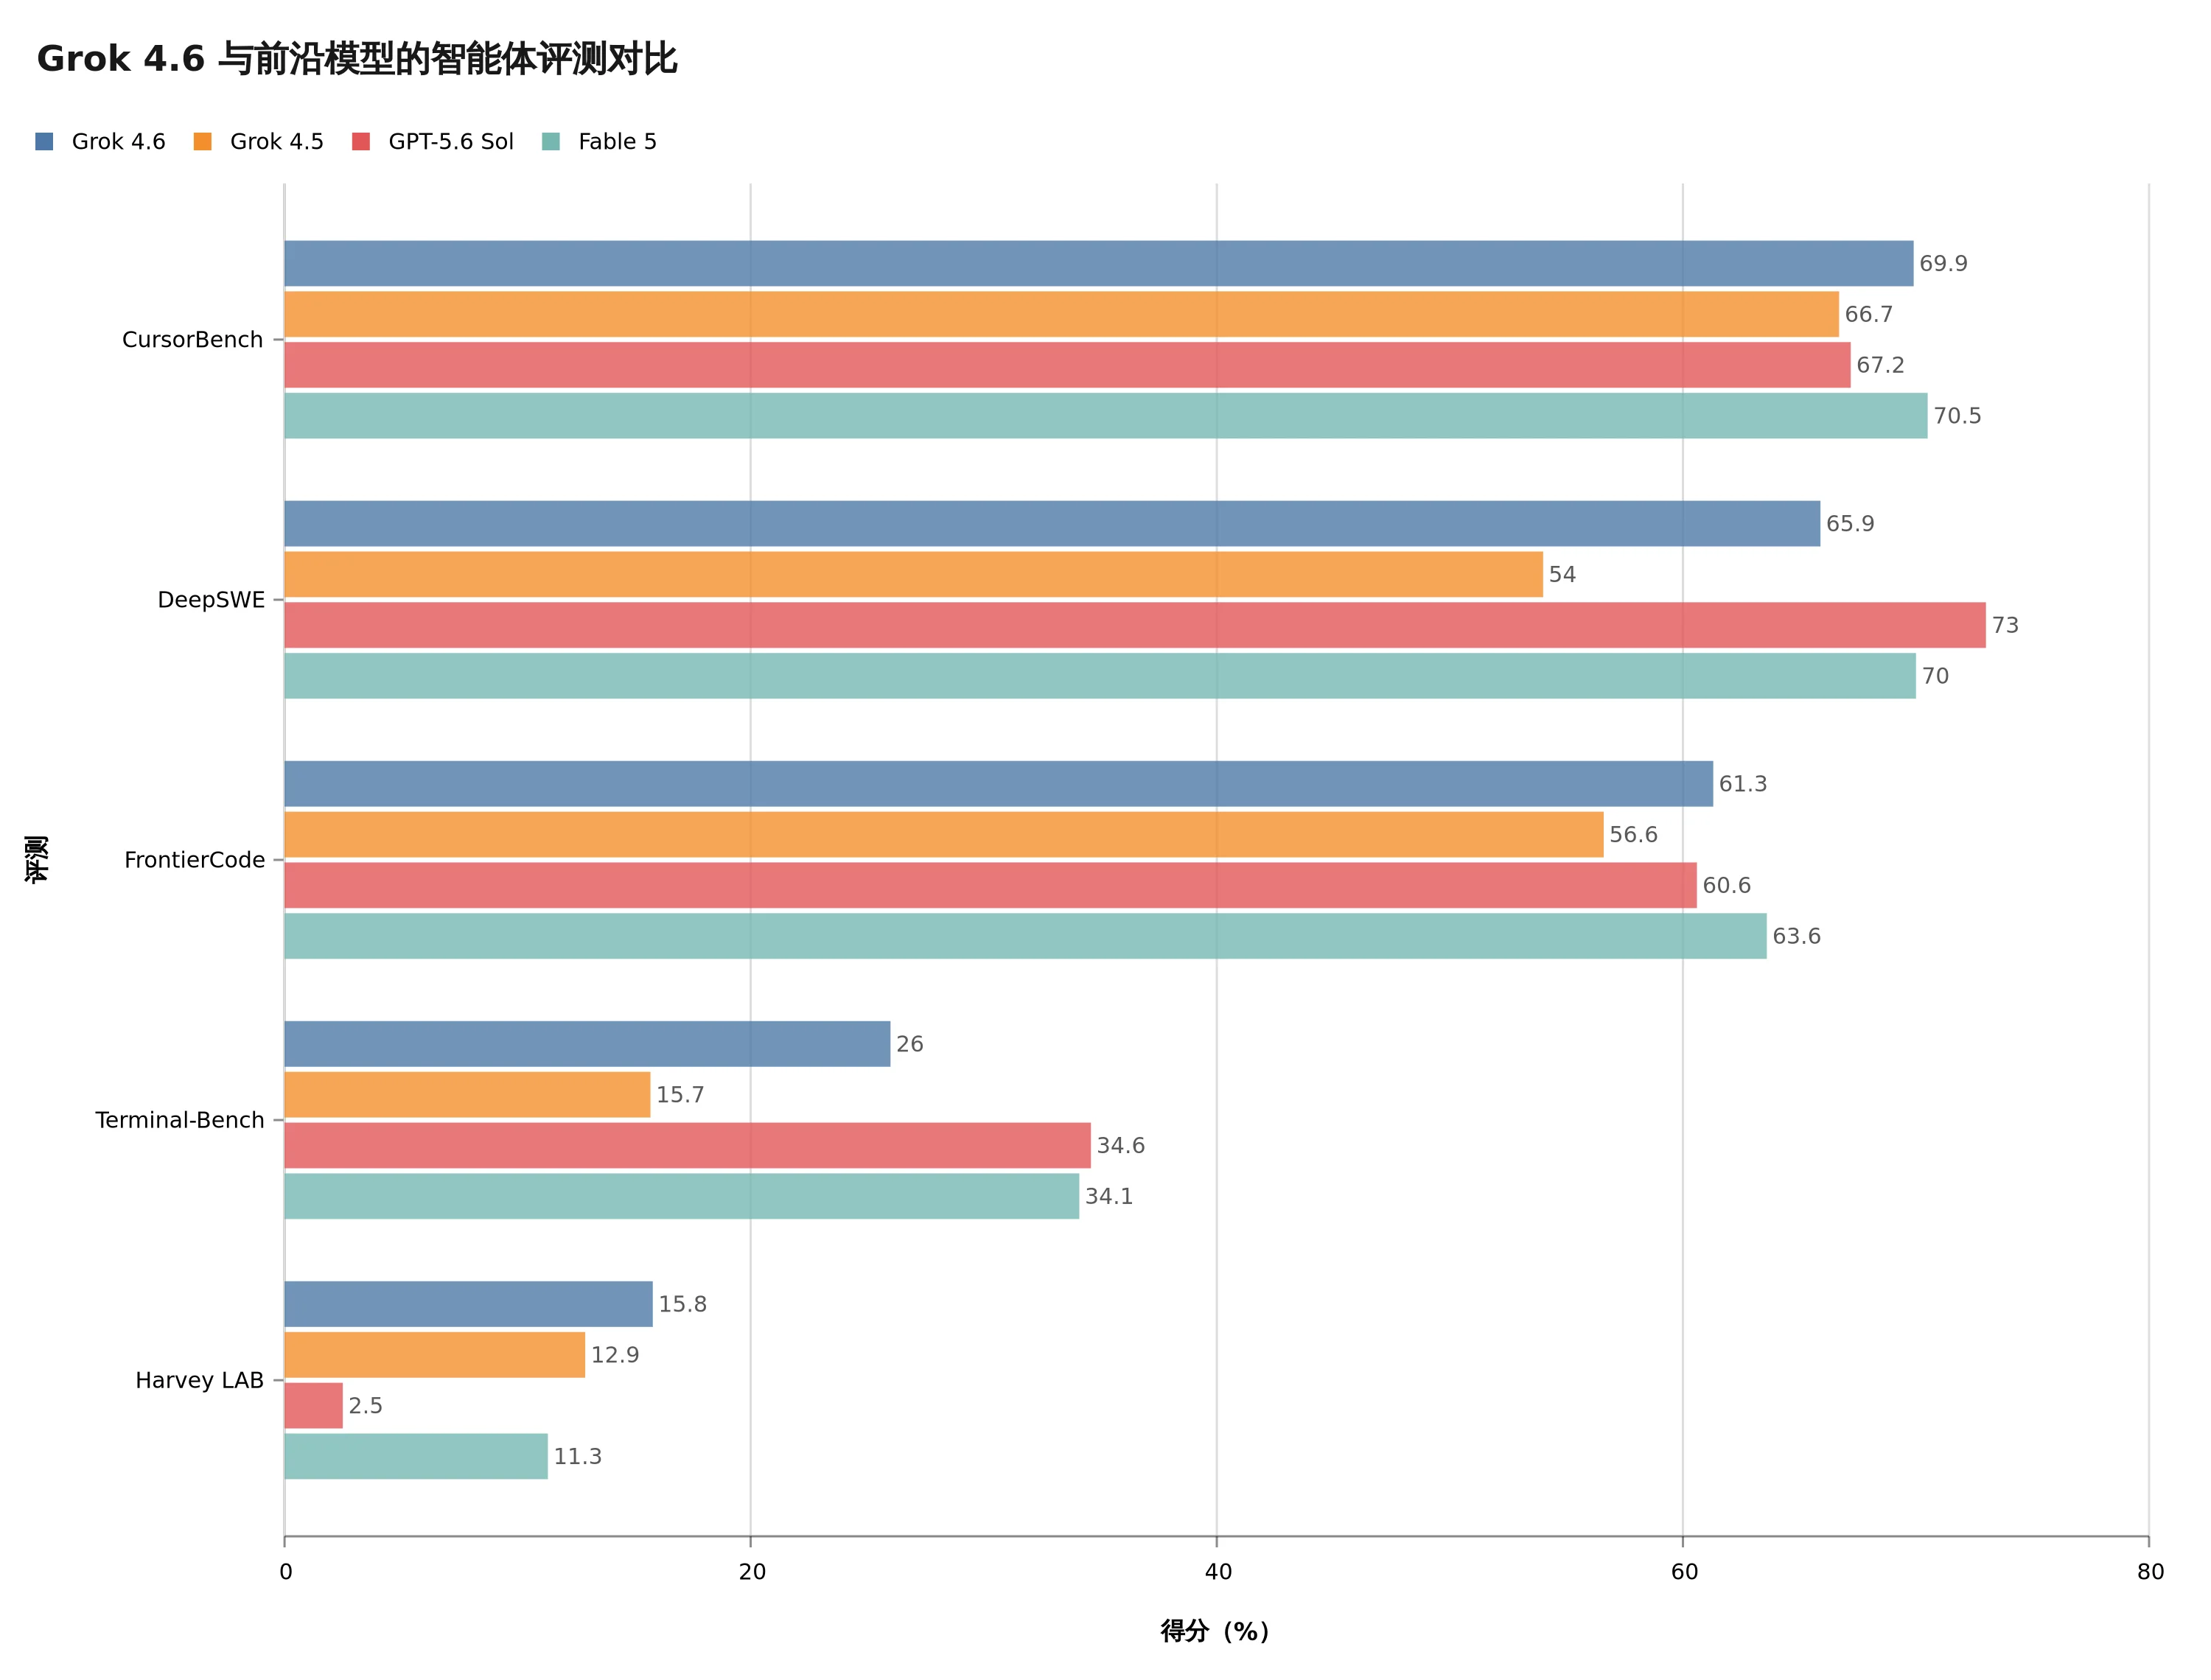
同一张总榜下面,Grok 4.6 在不同任务上的位置并不相同,数据来自 xAI 官方评测。
这不是在挑一张对自己不利的表格唱衰新模型。模型当然进步了,从 Grok 4.5 的综合 56 分涨到 61 分,几项智能体评测都有明显提升。真正值得聊的是另一件事。
综合分追平,不等于长任务已经可以放心托管。
模型回答一道题,和 Agent 在一个真实环境里连续工作几个小时,是两种完全不同的工程问题。前者看聪明程度,后者还要看状态会不会漂、预算会不会炸、环境会不会被改坏、失败之后能不能从断点接着来,以及最后交上来的东西有没有证据证明它真的完成了。
跑分描述模型。
交付描述系统。
这次真正有意思的,是模型和脚手架一起训练
Cursor 的发布页 开头写得很直接,他们与 SpaceXAI 共同发布 Grok 4.6。xAI 也把长时间运行的智能体、跨代码库工作、研究和复杂视觉项目放在发布页最靠前的位置。
如果只是又发一个更大的聊天模型,这段话没什么稀奇。可训练细节里藏着一个很关键的信号。
xAI 先做了比 Grok 4.5 更长的补充训练,再用 Grok 4.5 重新生成 SFT 轨迹。SFT 是监督微调,你可以把它理解成给模型看大量高质量示范,让它学会任务应该怎么走。这里的示范不是单一问答,而是覆盖不同推理强度、不同 Agent Harness 和不同领域的完整轨迹。
Agent Harness,就是让模型真正干活的那层脚手架。工具怎么调用,上下文怎么塞,失败怎么重试,任务怎么分步,结果怎么交回去,都在这一层。
接下来,Grok 4.6 又在知识工作、通用编码、内核优化、Web 开发、计算机辅助设计等环境里做智能体强化学习。官方还特别提到,长轨迹里开始出现更多自测和验证行为,模型会先检查自己的工作,再继续往下走。
这一手有点子牛逼。
以前我们常把模型和运行框架想成两件东西。模型厂商负责把大脑练聪明,Cursor、Claude Code、Codex 这类产品负责给它接手脚。现在边界正在往里缩。训练数据里已经有不同的 Agent Harness,模型学到的不只是怎么回答,还在学怎么身处一套工具、状态和反馈规则里持续行动。
也难怪这次会和 Cursor 一起发。模型能力不再只从参数里长出来,它也从自己将在什么运行环境里工作这件事里长出来。
不过,别急着把终端权限全开。
发布页告诉了我们模型更会持续工作,却没有给出另一组对生产环境更要命的数据。不同任务长度下的成功率怎么衰减,跑到第几个小时最容易偏航,需要人工接管多少次,同一个任务重跑五次的方差有多大,自测到底能抓住多少自身错误。这些不是发布稿必须回答的问题,但它们恰好是团队准备接入长任务 Agent 时必须补的验收题。
长时间运行,最怕的不是笨,是悄悄跑偏
短任务失败往往很诚实。命令报错,测试红了,API 返回 401,大家一眼就知道没成。
长任务的失败更像慢性漂移。Agent 前二十步都做对了,第二十一步误解了一条约束,后面五十步仍然执行得特别勤快。日志看起来热火朝天,token 也烧得很有事业心,最后交回来一个结构完整、方向错误的产物。
厉害了,错误还有自己的项目管理能力。
做代码任务时,这种漂移很常见。最初要求只是修一个解析器,Agent 顺手升级依赖,再顺手改配置,测试为了适配新行为也被一起改掉。最终 pytest -q 全绿,并不能自动证明需求完成了,有时只能证明它成功改写了考卷。
视觉项目也一样。Grok 4.6 官方强调它能从宽泛想法出发,一次搭起应用结构和视觉语言,这很适合快速拿到第一版。但一个页面能打开,和它满足无障碍、移动端、真实数据、异常状态、加载性能,是几层不同的验收。截图漂亮只是证据之一,不是全部证据。
自测同样不能被神化。一个模型写代码,再由同一个模型决定自己写得好不好,多少有点让同一个人出题、答题、判卷。它当然比完全不检查强,可如果验收标准本身就含糊,自测只会更自信地执行含糊。
坦率讲,长任务 Agent 最需要的不是一句「请仔细检查」,而是一份模型无法靠嘴糊弄过去的交付合同。
下面是一份可以直接改的最小版本。
goal: 修复 CSV 解析器在空字段上的崩溃
allowed_paths:
  - src/parser/
  - tests/parser/
acceptance:
  - pytest -q tests/parser
  - 旧测试数量不得减少
  - 新增空字段与连续分隔符用例
budget:
  max_minutes: 45
  max_cost_usd: 8
checkpoint:
  every_steps: 12
rollback:
  keep_git_worktree: true
evidence:
  - git diff --stat
  - 完整测试输出
  - 最终 commit hash
这里最重要的不是 YAML 写得多漂亮,而是把五件事钉死。任务目标是什么,允许改哪里,用什么命令验收,最多烧多少时间和钱,失败后从哪里恢复。再加一份不可省略的证据清单,Agent 才不能只用一段流畅总结宣布胜利。
很多朋友可能会觉得,这不就是把项目管理写进 prompt 吗。
还真不完全是。
Prompt 只是模型看到的文字,合同还要由外部程序执行。allowed_paths 需要在提交前检查真实 diff,预算需要看门狗硬停,checkpoint 需要真的落到独立 worktree 或 commit,验收命令要由模型之外的进程运行。模型说自己执行过,不算。日志里出现退出码、测试数量和产物路径,才算。
这也是 Cursor 介绍云端智能体环境 时反复强调隔离环境的原因。长任务不是把一次对话拉长,而是给模型一个可恢复、可限制、可审计的运行空间。
价格便宜,不代表长任务便宜
Grok 4.6 的 API 起价是每百万输入 token 2 美元、每百万输出 token 6 美元,快速版本价格翻倍。放在前沿模型里,这个价很有竞争力。
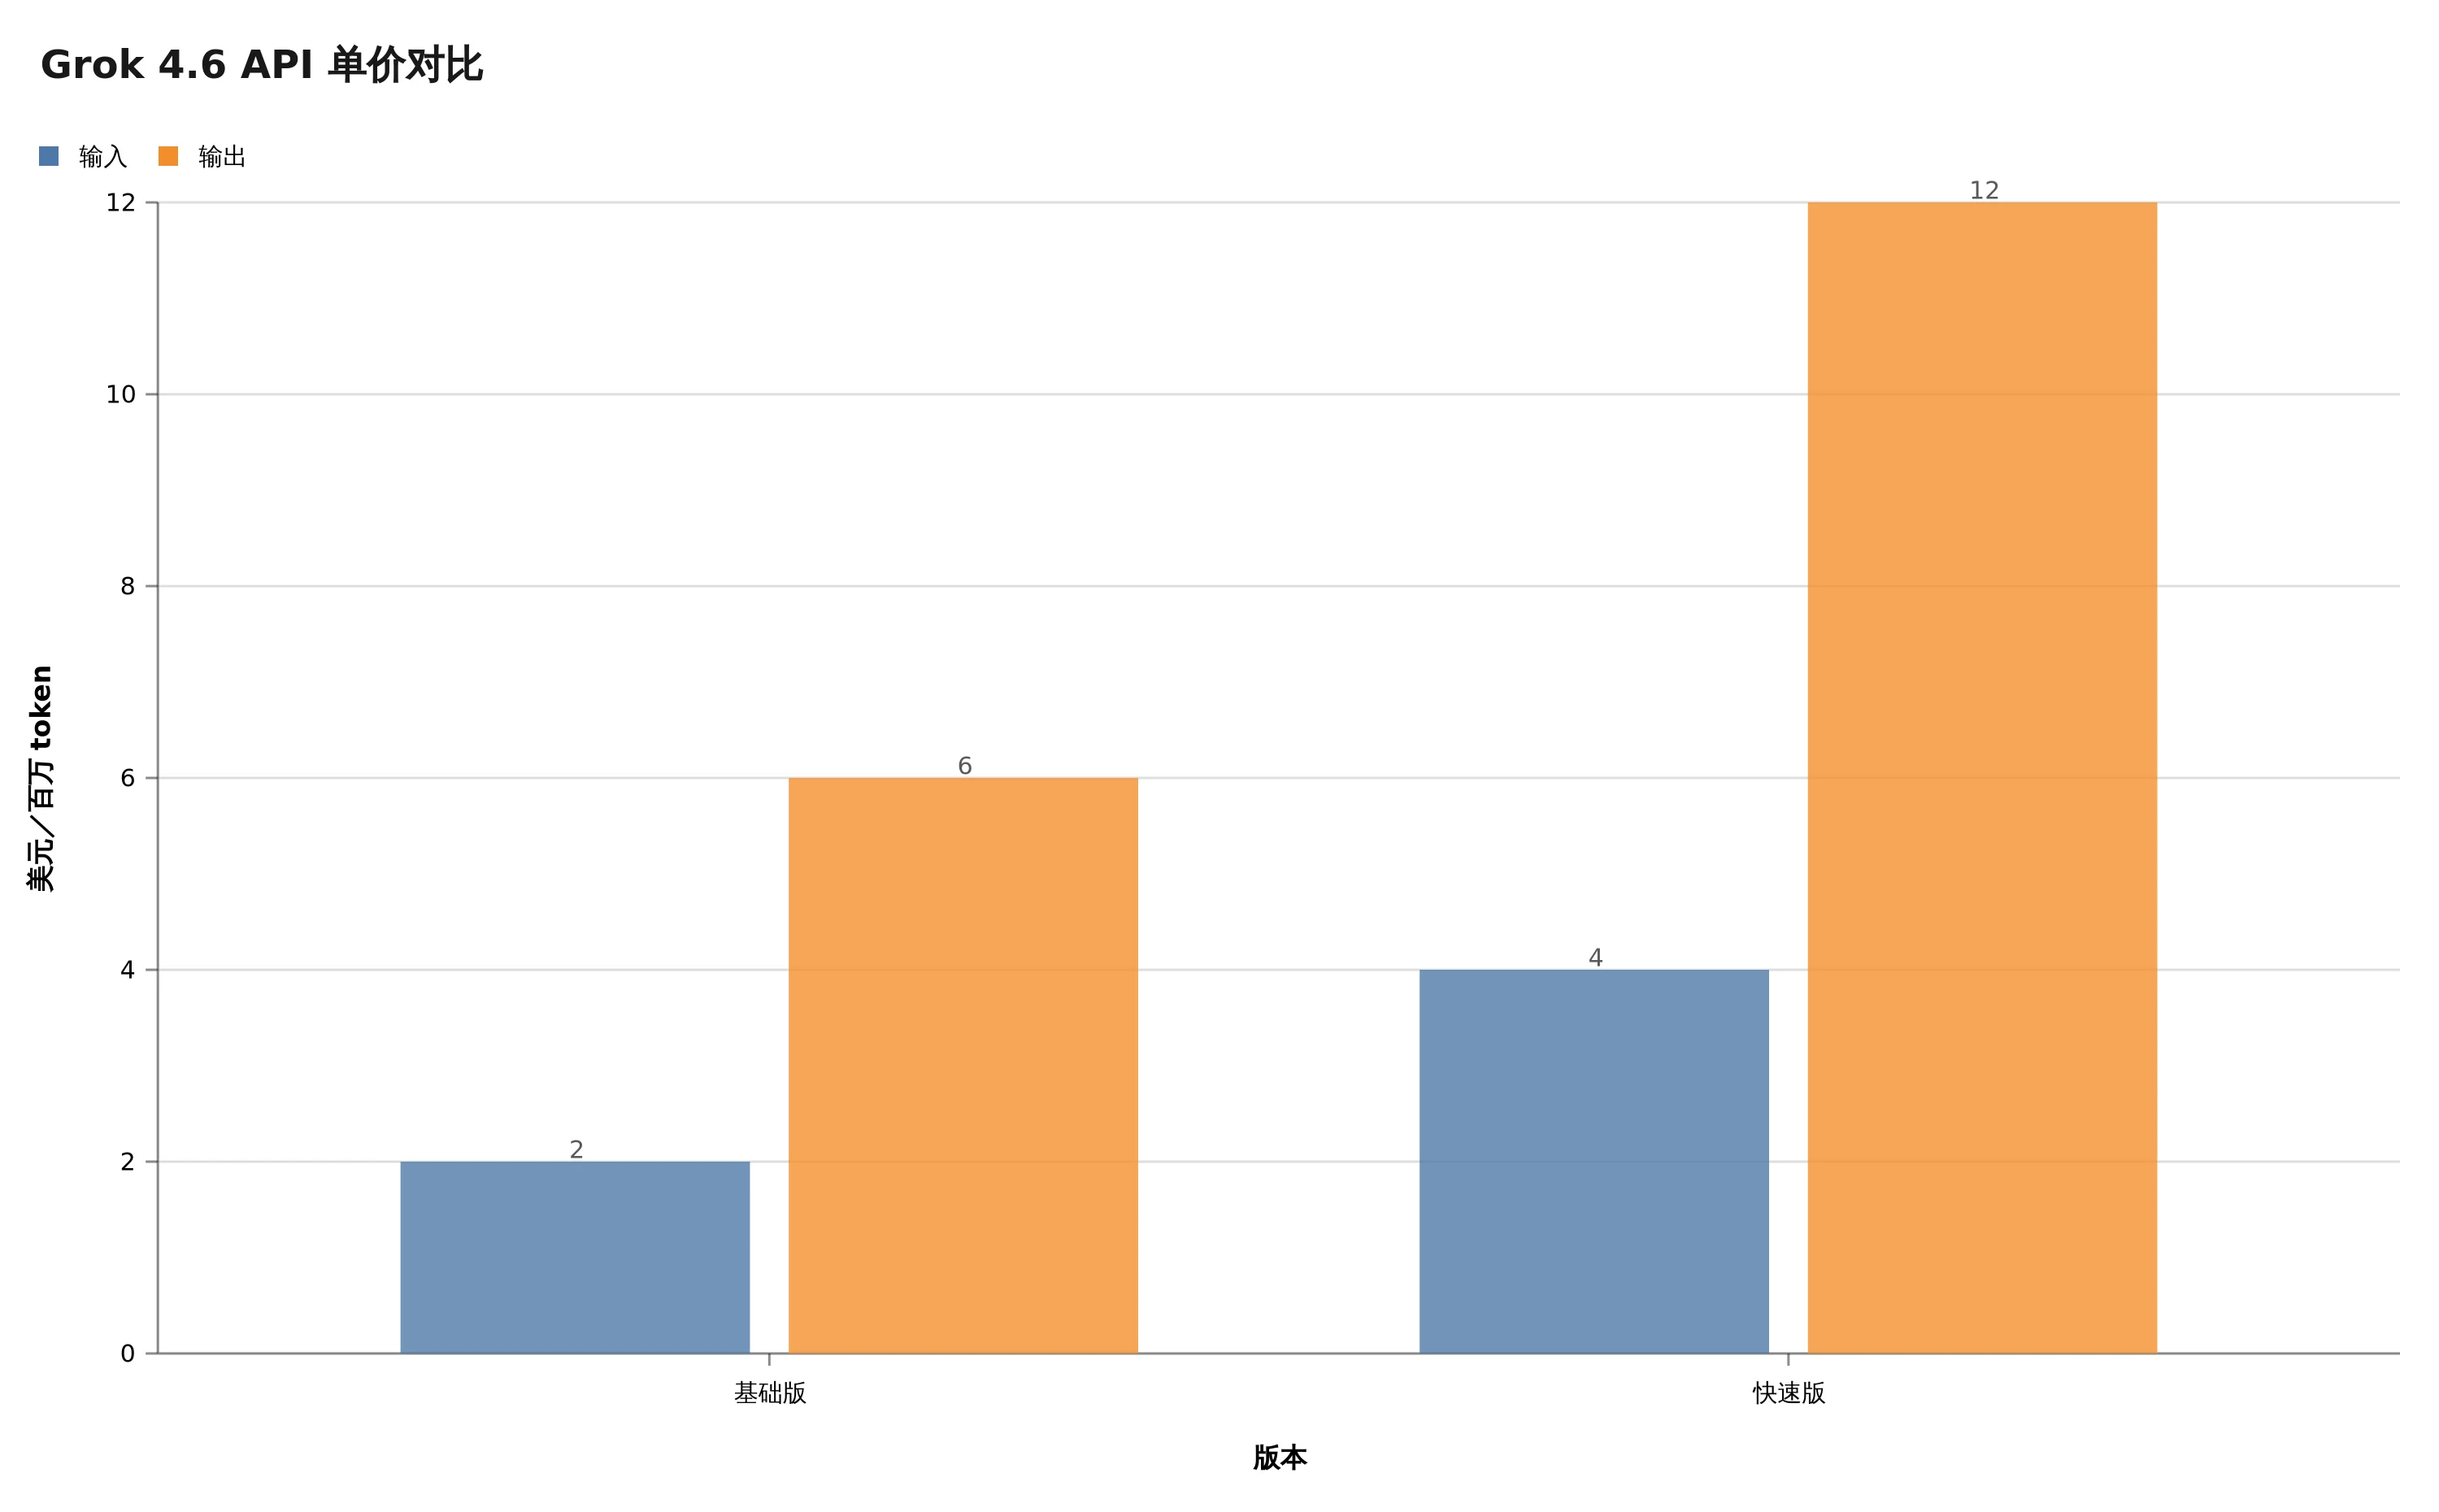
快速版把输入与输出单价同时翻倍,数据来自 xAI 官方发布页。
可长任务的账不能只看单价。
假设一条任务轨迹累计消耗 1000 万输入 token 和 100 万输出 token,不算工具、搜索与环境成本,基础版本就是 26 美元,快速版本是 52 美元。这只是一个明确标注的假设,不代表每次任务都会烧这么多。它想说明的是,Agent 一旦在错误方向上多跑几十步,低单价也能被长轨迹迅速吃掉。
所以预算上限不是财务同事来扫兴,它是任务逻辑的一部分。达到 50% 预算时做一次中期验收,发现连续两次测试没有新增通过项就停,三次重复读取同一批文件就触发反思,修改范围越过白名单就立即回滚。规则越确定,越应该交给外部看门狗,不要指望模型每次都自觉。
OpenAI 的 Evals 指南 一直强调用可重复的评测去比较系统行为,Anthropic 的智能体工程文章 也把环境反馈、检查点和停止条件放在重要位置。不同厂商的模型会轮流坐榜首,但这些工程动作不会因为换了模型就失效。
我自己的感受是,Grok 4.6 最值得高兴的地方,不是 61 分本身,而是模型厂商开始正面训练「持续工作」这件事。以前 Agent 跑得久,多少像产品层拿 prompt 和重试硬拽出来的能力。现在,长轨迹、运行框架、自测和专门环境已经进入训练配方,模型和脚手架终于在同一张图上了。
这一步很大。
但「会持续工作」到「能可靠交付」之间,仍然隔着一整套工程。检查点、预算、权限、回滚、外部验收、证据留存,一个都不会因为总榜多了 5 分自动消失。
模型是船的发动机,Grok 4.6 把马力又往上拧了一截。真正决定它能不能夜航的,还是海图、舱壁、仪表和那根出了问题就能把电切掉的开关。
回到开头那 61 分。
它证明 Grok 4.6 已经坐上前沿模型的牌桌。至于长任务能不能放心交,答案不在下一张跑分图里,在你有没有先把那份交付合同写好。