posts/grok-video-analysis-verification.md
Grok 看懂了视频,却在关键一问开始猜
一段 63 秒的视频里,科比坐在夜景前,穿着黑色西装,像拍球鞋广告一样推介 Grok 4.5。
他讲训练规模,讲工程能力,讲 token 价格,收尾时用了那句熟悉的 Mamba 口号。
问题是,科比已经在 2020 年去世。这段视频显然不是真人拍的。
8 月 2 日,Elon Musk 在 X 上只写了一句话,Grok 可以分析任意视频,下面挂的就是这段演示。那份公开的 Grok 对话很有意思,甚至比一句功能官宣更值得看。
用户先让 Grok 分析视频。它交出了一份很像样的结果,识别出办公室夜景、皮质扶手椅、篮球、人物动作和广告风格,也提炼了大部分台词与产品卖点。单看这一轮,挺能打。
用户接着问,这段视频是哪一个 AI 做的。
Grok 先准确判断它是合成视频,然后开始推测。它把 Grok Imagine 列为最可能的工具,理由主要是发布时间、宣传对象和 xAI 自家产品的能力,又把 Sora 与 Veo 放进备选名单。它还判断,63 秒成片大概由多个短片段拼接而成。
这段回答没有装作百分之百确定,已经比很多拍脑袋答案克制。但它仍然没有拿出能够识别生成工具的元数据、内容凭证或模型指纹。
前半段是在看视频。
后半段是在猜来源。
好家伙,「能分析任意视频」最麻烦的地方,就藏在这个切换里。模型从画面里读到的事实、从常识推出的判断、根据上下文做的猜测,会被同一种流畅语气揉在一起。读者如果不追问证据,很容易把三层东西全部当成视频里真的存在。
所以我对这次更新的判断有点不合群。
视频 AI 的下一道门槛不是看得更多,而是把每个结论钉回原片。
它看到的不是视频,而是一串被压缩过的线索
人看视频时,眼睛、耳朵和时间感一起工作。我们知道一个动作先发生还是后发生,知道一句旁白来自画外还是人物口型,看到镜头一闪也可能记住那个细节。
模型拿到的通常不是完整连续体验。
一条常见的视频理解链路,会先把文件解码,再按一定频率抽帧,单独处理音轨,做语音转写和画面文字识别,再把这些信息塞进多模态上下文,让语言模型组织答案。视频越长,抽样、压缩和检索越激进。
每一层都可能漏东西。
Google 的视频理解文档把这笔账写得很坦白。默认视觉采样是每秒一帧,快速动作和快速切镜可能丢失细节。默认分辨率下,一秒视频大约消耗 300 个 token,其中画面、音频和元数据各占一部分。文档也明确建议,回答关键事件时带上时间码。
每秒一帧听着不少,可一段 30 帧每秒的视频里,模型默认只拿到大约三十分之一的画面。篮球出手、屏幕报错、路口一闪而过的标牌,偏偏可能落在另外二十九帧里。
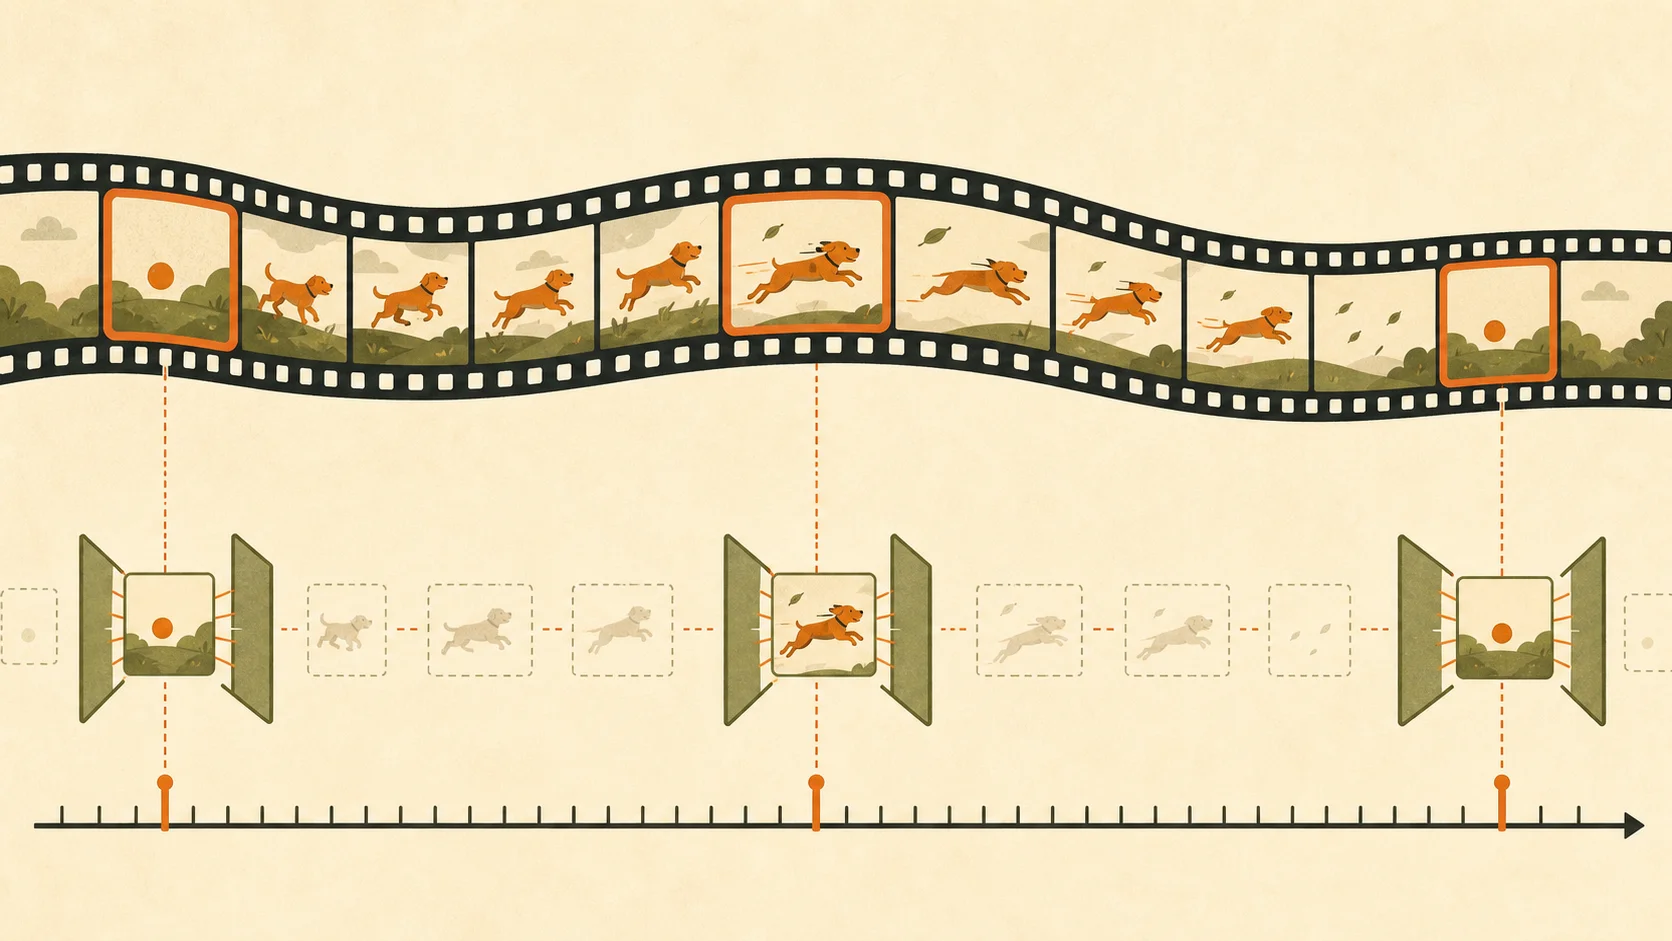
模型并不是连续观看原片,采样门之间的快速动作可能直接滑过去。
厉害了,模型输出可以逐字生成,输入却可能是隔着一秒才看一眼。
这不是 Grok 独有的问题,而是视频理解的工程现实。长视频尤其凶。上下文窗口再大,也不等于可以把几个小时的原始帧无损搬进去。系统必须决定哪些帧值得留,音频要压到什么程度,字幕和画面冲突时相信谁。
Apple 在 2026 年 7 月公开了 LVSum 长视频摘要基准。数据集有 72 段视频,平均长度 16 分钟,人工摘要带细粒度时间对齐。实验里有三个结果很扎眼,转写文本对摘要质量的贡献明显高于视觉帧,模型与人工摘要仍有显著差距,现有模型在时间定位、指令遵循和跨模态一致性上持续掉链子。
翻译成人话,很多所谓视频总结,主力其实是听字幕和看转写。画面负责补一些对象与场景,时间顺序一复杂,模型就容易把发生过、没发生过、先发生和后发生搅在一起。
另一项 2026 年的 HAVEN 视频理解研究说得更直接,流畅的文字摘要与真正落在视频证据上的理解之间,仍然隔着一道稳定存在的缝。
Grok 那份演示恰好把这道缝摊开了。
它能复述人物说了什么,也能识别广告气质。可到了「哪一个模型生成」这个问题,视频画面本身未必包含答案。模型只好调用外部常识,把宣传对象、发布时间和产品能力拼成一个概率判断。
推理没有错。
把推理误当取证,才会出事。
总结很便宜,时间码才是证据入口
想判断一个视频 AI 能不能进工作流,我现在只看一个动作。
让它给每条重要结论附上开始时间与结束时间。
不是在答案末尾丢一个视频链接,也不是写「根据视频内容」。要具体到 00:18 至 00:24,人物说了什么,画面出现了什么,这条结论来自音频、画面、字幕还是外部资料。
原因很简单。视频摘要是一种高压缩输出,一小时内容可能被压成十句话。只要其中一句有问题,人就得拖着进度条从头找。模型替你省下十分钟总结时间,又让你花四十分钟找证据,这个自动化属实有点行为艺术。
时间码会把复核成本从「重看整段」缩到「回看六秒」。
更重要的是,它逼模型暴露自己的信息来源。一个结论若只能给出「综合判断」,却找不到对应片段,就应该自动降级为推测。一个动作若只在 12.4 秒附近闪过,系统就可以针对那一小段提高采样率,而不是假装默认一帧每秒已经看清。
给视频 AI 的提示词,也该从「帮我总结」升级成一份证据合同。
把输出拆成三类

一,视频直接支持的事实
每条给出开始时间、结束时间、证据模态和一句原始证据

二,基于事实做出的推断
写明推断链,并给出置信度

三,视频无法回答的问题
直接写不知道,不要根据品牌、人物或发布时间猜测

如果音频、画面与字幕冲突,分别列出,不替我选一个顺耳的版本
这段提示词不能把模型变成法证工具,但能先把回答里的事实、推断和未知拆开。很多幻觉并不是模型完全没看见,而是输出格式允许它把不确定性悄悄抹平。
真正做产品,还要再多一层。
第一遍只做粗粒度检索,找出候选片段。第二遍把候选片段按更高帧率重新送进模型,要求逐项核对。对重要结论再做一次反向检查,给出这条结论不成立的可能证据。
这样设计会多花 token,也会慢一点。
但会议复盘、素材检索、质检和培训审核要的从来不是一篇顺滑观后感。它们要的是某句话到底在第几分钟说过,某个动作是否真的出现,某项违规能不能让另一个人沿着证据复现。
没有复现,就没有验收。
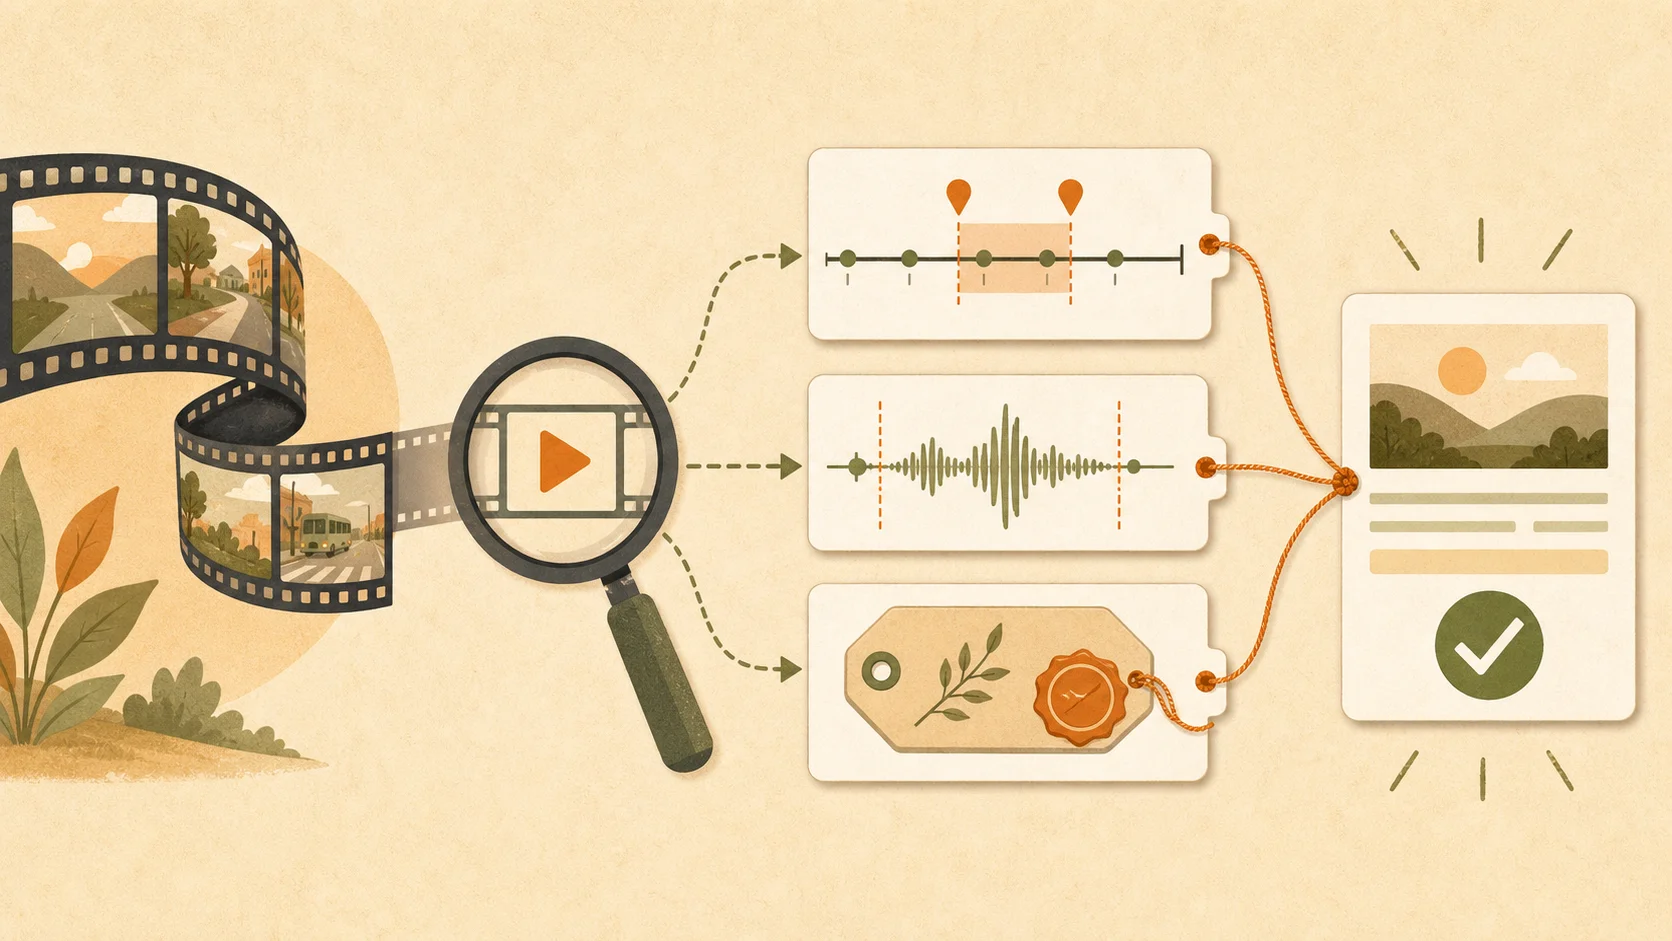
时间码、原始音画与来源链连在一起,一条结论才有可复核的入口。
识别内容和识别来源,是两种完全不同的任务
再回到那段科比视频。
Grok 判断它是合成内容,有一个非常强的外部线索,视频中的人物不可能在 2026 年真人出镜推介新模型。这个结论不需要从皮肤纹理、眨眼频率或编码噪声里识别生成痕迹,常识就足够完成大部分工作。
可判断「它由哪一个生成模型制作」,难度一下变了。
视频可能经过剪辑、补帧、降噪、转码、配音、口型同步和平台二次压缩。不同模型的画面风格越来越接近,同一条成片也可能由三四个工具接力完成。哪怕 xAI 的 Grok Imagine Video 1.5确实支持原生音频、视频生成和编辑,也不能仅凭内容正在宣传 Grok,就倒推出它一定来自 Grok Imagine。
这跟看到一段写得像 Claude 的文字,就认定它由 Claude 生成差不多。可以当线索,不能当证据。
更靠谱的来源识别,应该优先读内容凭证和制作链元数据。C2PA 的内容凭证说明提供了一套给数字资产记录来源、编辑动作与签名的框架。如果创作工具写入了可验证凭证,平台又在转码时保留下来,系统才有机会回答「谁用什么工具做了哪些修改」。
注意,它证明的是一条签名过的来源链,不是画面里的每句话都真实。凭证缺失也不等于内容一定造假,可能只是平台剥掉了元数据,或者制作工具压根没写。
所以来源判断最好只给三种状态。
有可验证凭证,可以确认。没有凭证但存在风格与上下文线索,只能推测。证据冲突或链路断裂,直接未知。
我很喜欢 Grok 演示里保留「最可能」这种措辞,它至少没有把猜测伪装成鉴定结果。可如果这项能力要进入 API、审核后台或媒体工作流,界面还得更狠一点。
把「最可能」做成机器可读字段,把证据来源展开,把未知状态放在显眼的位置。不要只靠一段温柔的自然语言提醒用户保持谨慎。人在赶时间时,只会记住模型说的那个名字。
真正能上线的视频 AI,要学会交底
我不知道 Grok 的视频能力目前具体怎么抽帧,支持多长文件,是否能稳定输出片段级时间码。xAI 在今年 4 月的 Grok 4.20 系统卡里已经写过,部署在 grok.com 和 x.com 的 Grok 可以使用工具分析 X 上的视频。这次「任意视频」把入口往前推了一大截,公开演示却还没有回答采样率、文件限制、时间定位误差和 API 形态这些工程问题。
这很正常,功能刚出来,文档总要追一阵。
但如果我是做接入的人,上线前会先准备一组很不友好的测试视频。
画面与旁白故意矛盾,关键动作只出现两三帧,同一人物在不同时间重复相似动作,字幕写错一个数字,画外音描述没有发生的事,再塞一段经过多次转码、没有任何内容凭证的合成片。
评测不只看摘要像不像人写。我会记录事件召回率、时间边界误差、无证据断言数量、跨模态冲突识别率,还有模型在不知道时是否真的愿意停下来。
那项「愿不愿意停下来」的指标,经常被低估。
能说不知道,不是能力弱,是工作流终于有了刹车。
「任意视频」是一个很诱人的入口。会议录像、课程、播客、监控片段、产品演示、素材库,全都可以变成能提问的对象。过去得拖进度条找半天的内容,现在一句话就能捞出来,当然爽。
可真正值钱的不是模型替你看完。
是它说完之后,你能沿着时间码回去,看到同一帧,听到同一句话,分清哪部分来自原片,哪部分来自推理,哪部分只是猜测。
任何视频,它大概都能看。
任何结论,还是得交证据。