posts/h3-max-live-video-system.md
H3 Max 跑得比播放快,离直播产品还很远
五秒的视频,三秒左右生成。
播放条还没走完,下一段画面已经在路上了。
这两天,fal 发布了 H3 Max,紧接着,MiniMax 官方公众号提到,海外开发者已经拿它搭出了 Twitch 直播和 24 小时 AI 电视台。观众发一句评论,系统接着生成下一段几秒钟的视频,频道就这么一路播下去。
好家伙,视频模型终于跑过播放速度了。
但我看到这件事的第一反应,不是以后每个人都能开电视台,而是另一句有点扫兴的话。
跑得比播放快,只是让 AI 视频拿到了直播产品的入场券。
以前生成视频像跑一个离线任务。丢进去提示词,等它算完,下载文件,满意就发,不满意再来一次。失败了顶多浪费几分钟和一些额度。直播不是这套脾气。它是一条不能随便停的长任务,上一段和下一段要接得住,观众输入会突然挤进来,危险内容得在播出前拦住,模型抽风时还得有人把场子兜回来。
速度跨过实时线之后,这些原来躲在等待时间后面的工程问题,一下全露出来了。
跑过实时,只是删掉了等待
H3 Max 是 fal Research 基于开放权重的 MiniMax H3做后训练的版本。fal 重点补了提示词遵循和视觉质量,同时让模型研究团队与推理团队一起改训练栈、推理栈和底层内核。
它不是单纯少跑几步采样,也不是把精度砍下去换一个好看的速度数字。fal 的说法是,每项提速优化都要重新过人类偏好评测,守不住质量排名就不要。
公开结果确实很猛。H3 Max 在 fal 的对比里同时拿到综合偏好、提示词理解和美学表现第一,参与比较的有 MiniMax H3 官方端点、Gemini Omni Flash、Wan 3.0、Seedance 2.5、Kling 3 和 Veo 3.1 等 12 个模型。五秒视频约三秒生成,吞吐量大约是 H3 官方端点的 35 倍。fal 引用的 Design Arena 独立测试给出的速度差距更大,在接近 H3 质量的位置超过 50 倍。
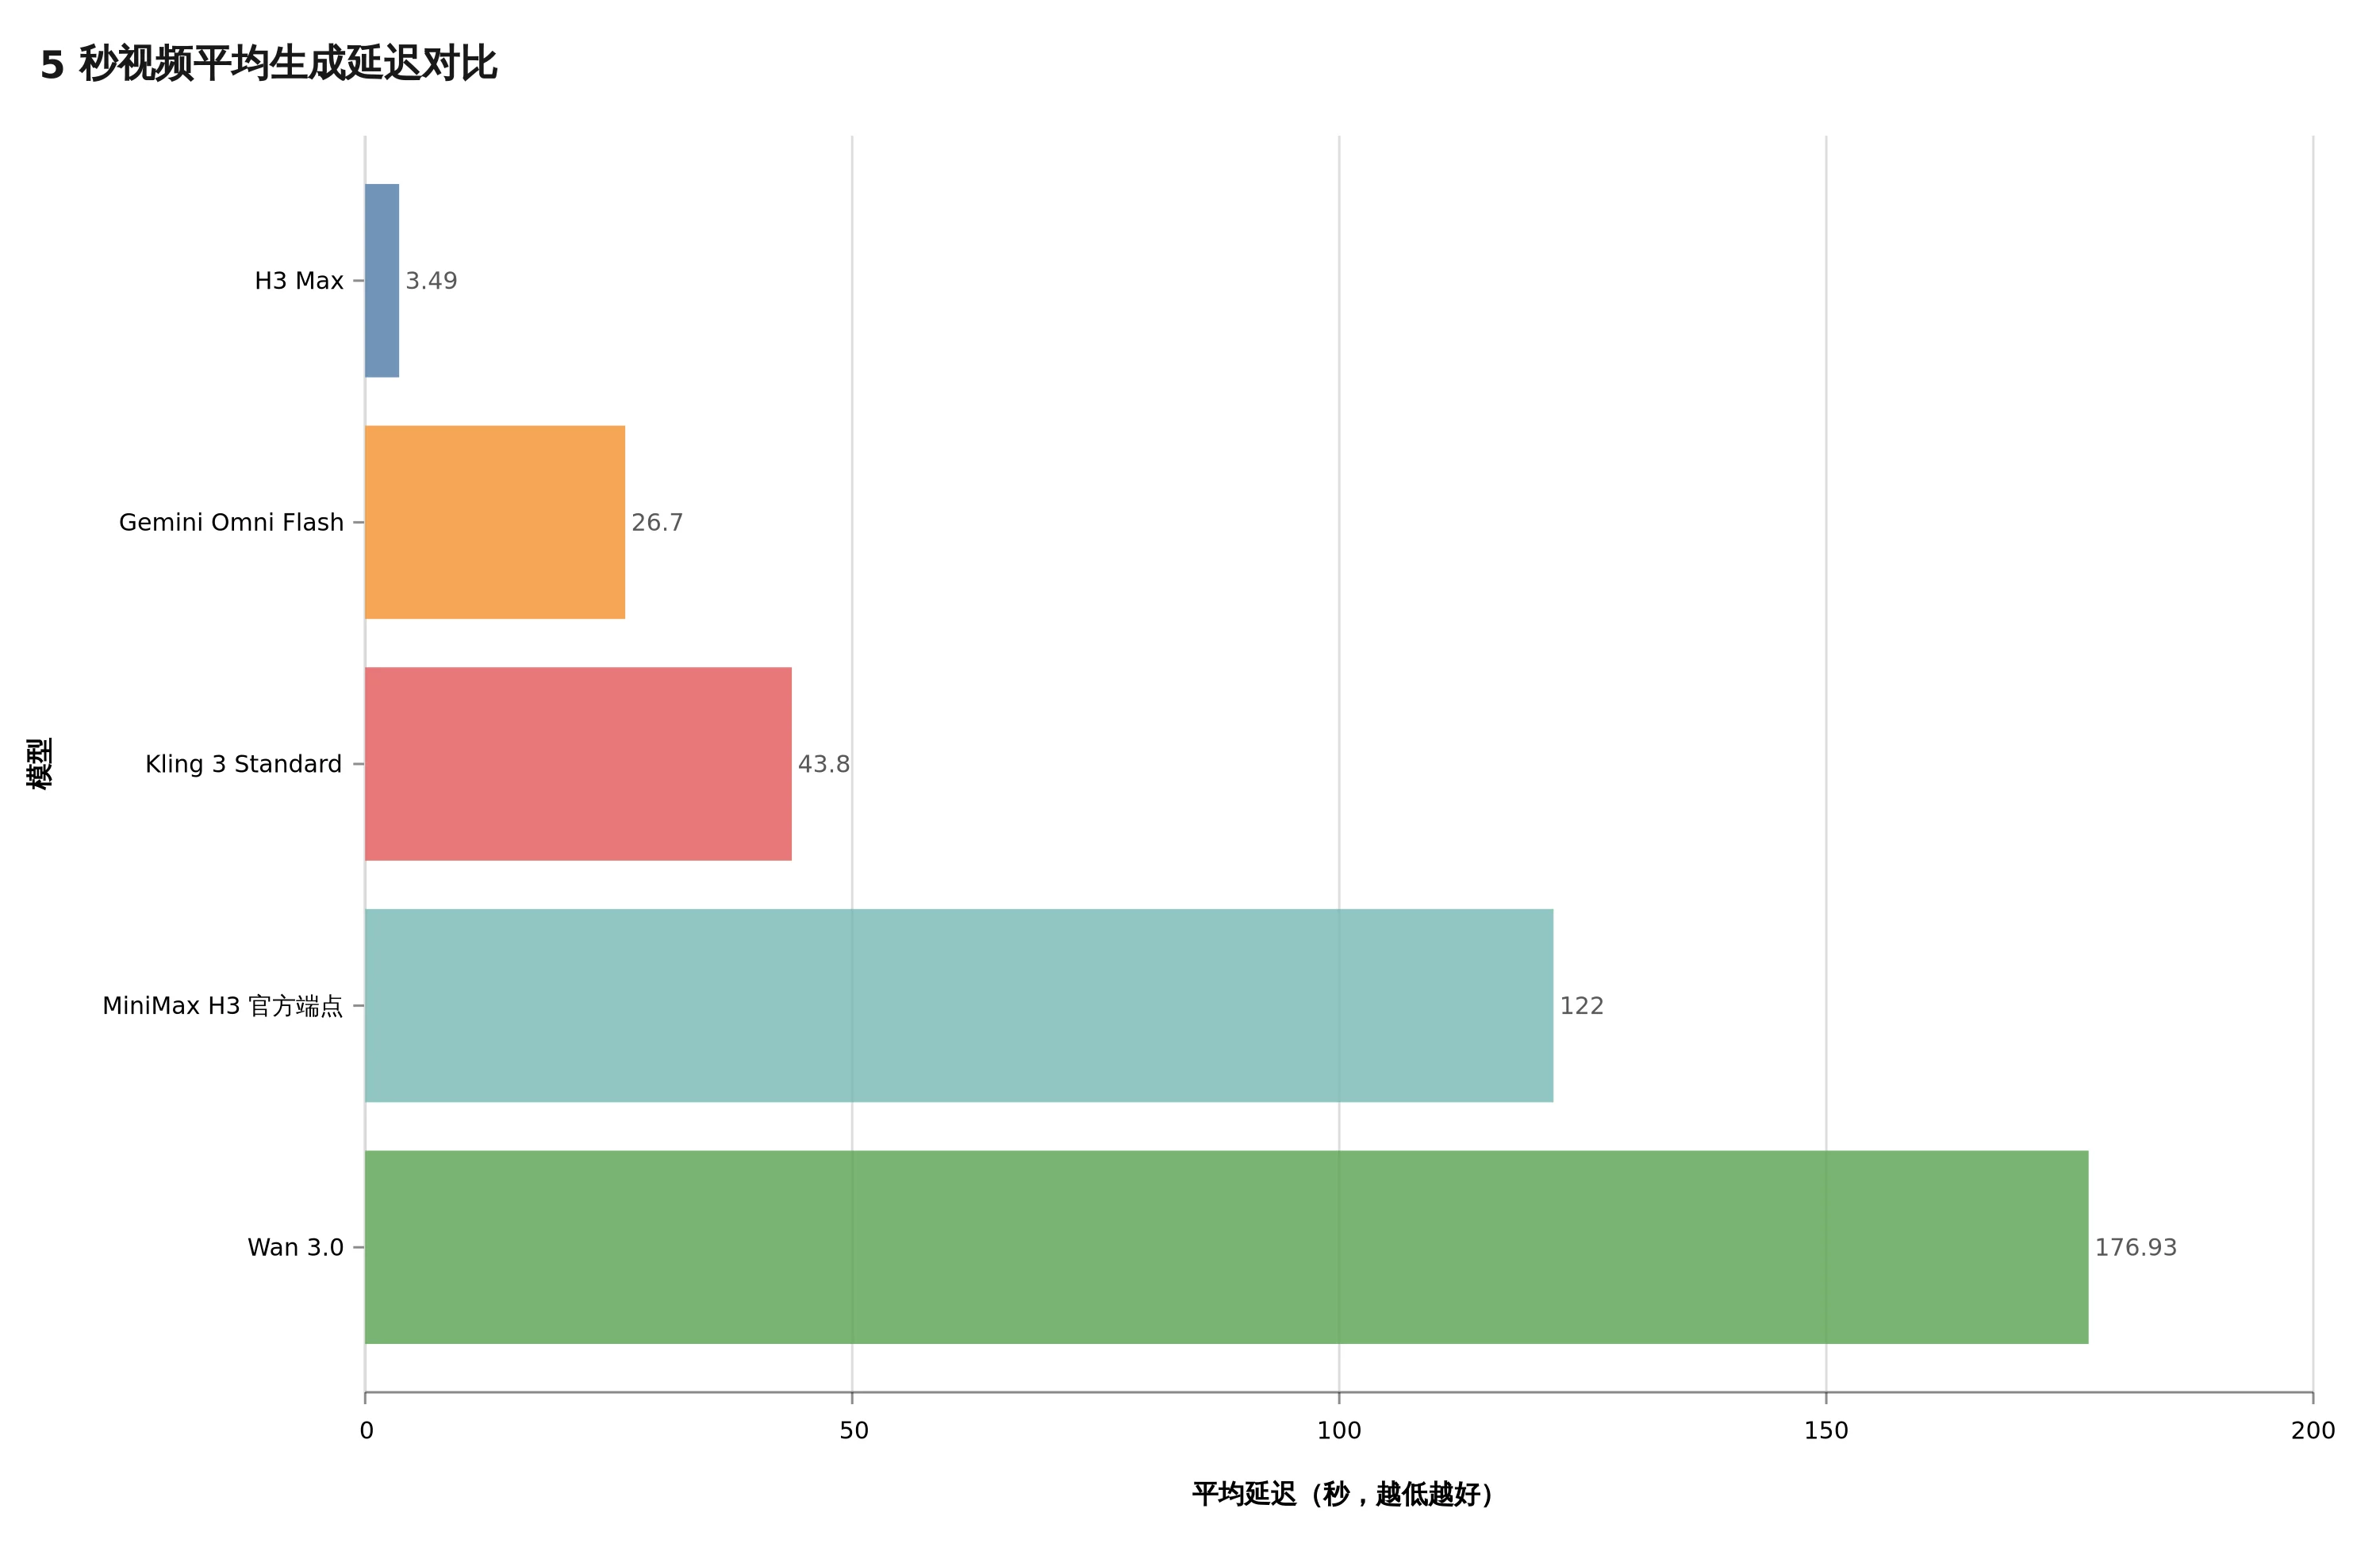
基于 fal 发布材料数据重绘,平均延迟越低越好。
这些数字来自发布方和公开榜单,我没有替大家补一段并不存在的本地实测。端到端等待时间还会受排队、上传素材、内容审核、视频编码和网络传输影响,不能把三秒推理直接写成用户三秒拿到成片。
这块要分清,营销页爱把秒表按在最漂亮的位置,生产系统可没有这个礼貌。
H3 Max 完全在 NVIDIA GB200 NVL72 系统上训练和服务。fal 还把它放进了 在线 Playground 与 API,让开发者能直接调。厉害了,原来视频生成要围着一个异步任务慢慢轮询,现在它已经有机会进入互动环节。
为什么我只说有机会?
因为一条五秒视频比播放快,证明的是单个片段来得及。直播产品要证明的是,第一千个片段还能来得及,而且它记得前面九百九十九个片段发生过什么。
这是两道完全不同的题。
真正难的是让系统记得自己在播什么
短视频生成最常见的体验是,每次点击生成,世界就重启一次。
人物衣服可能换色,镜头方向可能翻转,背景里的门突然消失,上一段还在下雨,下一段太阳直接挂到了正午。单条看都挺漂亮,连起来像一群剪辑师在同一个时间线上抢鼠标。
AI 直播不能每五秒失忆一次。
要把这种模型接成频道,系统至少得留住几类状态。人物是谁,穿什么,镜头在哪,场景里有哪些不能移动的物体,上一段结束在什么动作,当前剧情走到了哪,观众刚才的输入有没有被采用。状态不一定全塞回提示词,但必须有一个地方负责保存、压缩和校验。
这其实很像我平时给 AI 接工具链时处理长任务。模型可以很聪明,可一旦任务跨过几十分钟,真正决定它能不能继续干活的,往往是模型外面那层不起眼的脚手架。状态存储、超时看门狗、失败重试、权限边界,这些词没发布会那么亮,但少一个都可能半夜响铃。
视频这边可以把上一段最后一帧当作下一段的视觉锚点,再配一份很短的场景账本。账本里不要写长篇小说,只留必须稳定的事实。角色服装、摄像机位置、光线、当前目标、禁止改变的元素。每生成一段,就检查关键锚点有没有漂。如果漂得太远,宁可回退到上一段安全画面,也别把错误继续传下去。
这里最怕一个很程序员的坏习惯,失败后无脑重试。
普通接口偶尔超时,重试一次挺合理。视频模型如果已经开始角色漂移,你再拿同一份坏状态连跑三遍,很可能只是更快地产出三段错片。正确做法不是把重试次数从三改成五,而是先判断失败类型。超时可以重试,内容漂移要回滚状态,输入不合规则直接丢弃,模型服务不可用就切安全垫片。
安全垫片不需要多聪明。一个与频道主题一致的循环片段,一张稍后继续的品牌画面,一段预先审核过的过场,都比把半成品送上直播强。
有点子牛逼的产品,通常不是从不失败,而是失败时观众看不见它摔得有多重。
连续性之外,第二个坑是输入队列。
演示里一个观众发评论,模型接住,生成下一段,节奏很顺。真开播后,十个人同时发,下一秒又来五十条,系统听谁的?如果每条都排队,半小时前的评论可能在剧情已经换场后才被执行。如果只拿最新一条,观众又会发现自己的参与像往海里扔纸条。
所以互动直播不能只有一个提示词输入框。它要有输入缓冲、过期时间、优先级和丢弃策略。可以把多条相近意见聚合成一个动作,也可以让观众先投出几个受控选项。自由文本当然更有魔法感,可魔法背后还是得有人维护队列。
我会盯三个时间点。评论被系统接受的时间,首帧准备好的时间,画面真正推到观众端的时间。三段分别记下来,才知道延迟到底卡在模型、审核、编码还是网络。只看平均值也不够,直播最怕长尾,平时三秒,偶尔三十秒,观众看到的就是黑屏。
再算一笔很朴素的账。如果频道完全由五秒片段拼起来,一小时要 720 段,一天是 17280 段。单段成本看着再小,乘到二十四小时也会长出牙齿。这里还没算失败重试、预生成缓冲、审核和传输。
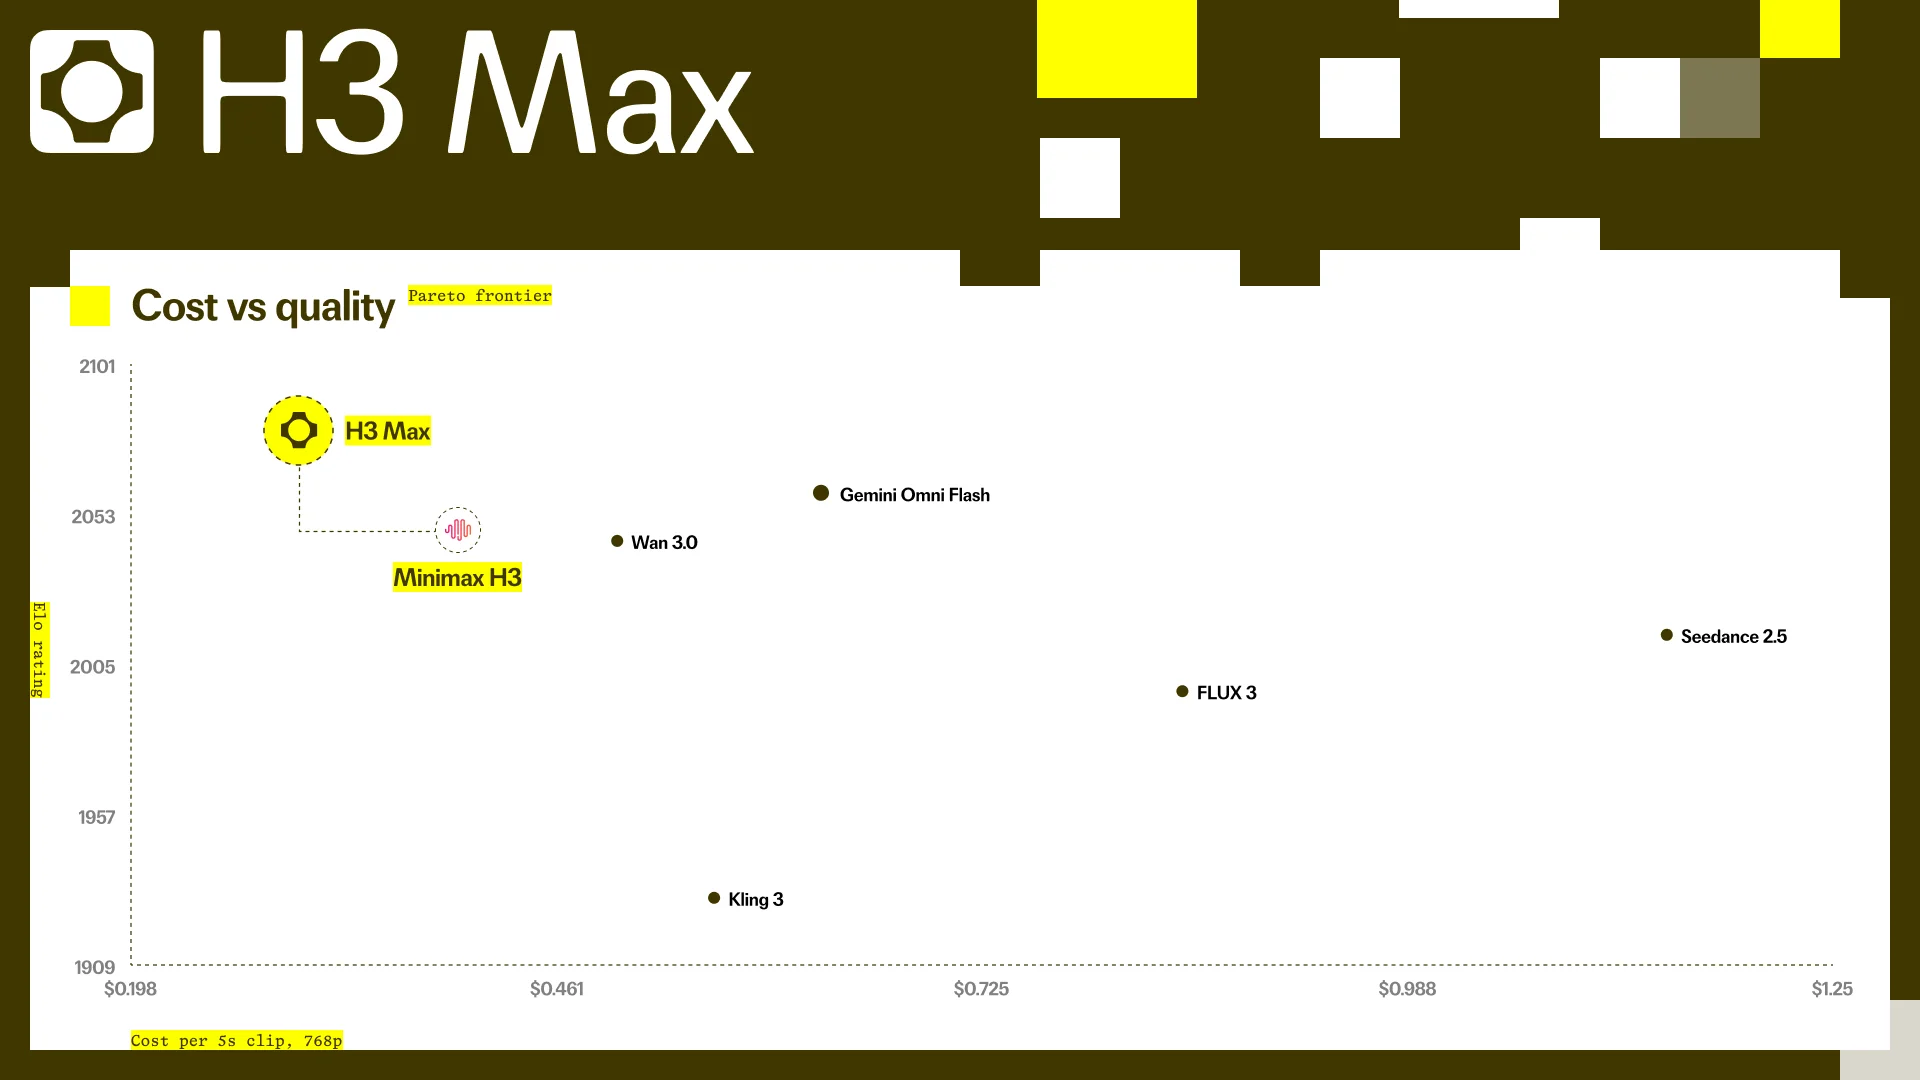
fal 发布材料中的成本与质量前沿图,价格与优惠以调用当天为准。
发布首周五折很好看,长期节目不能靠首周五折活着。
播错一帧,比生成失败麻烦得多
离线生成有一个很宝贵的东西,删除键。
画面不对,可以不发。音频奇怪,可以重做。品牌名拼错,可以在客户看到前撤回来。
直播没有这层缓冲。模型生成的下一帧一旦进了推流,观众已经看见。截图比撤回快,这件事大家都懂。
观众自由输入又把风险往上抬了一层。有人会认真参与,也一定有人想看看系统能被带到多离谱。提示词注入、冒充品牌指令、诱导泄露内部设定、让模型生成未经授权的形象,都不是边角问题。直播越火,测试边界的人越多。
比较稳的做法,是把输入和输出分成两道门。
输入端先把自由文本压进受控的动作语法。谁在做什么,场景允许怎么变,哪些对象不能出现,能用的镜头指令有哪些。无法映射的输入不进入生成队列。输出端先过低分辨率预览与内容检查,确认画面、文字和音频没有越界,再推给观众。
有人会说,多一道审核不就把三秒优势吃掉了吗?
对,确实会吃掉一部分。
但直播系统追求的从来不是模型推理数字最小,而是安全画面按时到达。三秒生成加两秒审核,比三秒生成后花两天处理事故便宜多了。
这话听着不性感,但生产环境经常就这么扫兴。
故障恢复也得在开播前写进设计。模型接口超时怎么办,连续三段画面重复怎么办,角色彻底跑偏怎么办,音频开始爆音怎么办,审核服务不可用怎么办。每种故障都要有停止条件和退路,不能等事故发生再让另一个模型现场想办法。
最简单的一套配置,大概会像这样。
session:
  max_minutes: 30
  human_on_call: true
queue:
  max_pending: 3
  late_action: drop
continuity:
  anchor_last_frame: true
  rollback_on_drift: true
moderation:
  input: before_generation
  output: before_publish
fallback:
  clip: safe-loop.mp4
  manual_stop: required
别急着嫌它保守。先让三十分钟稳定工作,再谈二十四小时。先限定一个角色、一个场景和五种可选动作,再放开自由剧情。先记录每一次丢帧、回滚和人工接管,再决定自动化比例。
无人值守不是无人负责。
这句话放在 Agent 上成立,放在 AI 直播上更成立。系统可以自动跑,责任、权限和停止按钮不能自动消失。
回到 H3 Max。
我很喜欢这次发布,因为它真的越过了一条物理门槛。视频生成第一次不必天然慢于视频播放,互动内容、实时预演、虚拟场景和个性化频道因此多了很多想象空间。别的模型还在让创作者等结果,它已经开始逼工程师考虑队列、状态和直播事故了。
这当然是进步,而且很大。
只是我不想把 Twitch 演示提前写成电视台革命。公开材料还没有完整说明长会话怎么计费、状态能保存多久、并发与服务等级如何、审核接口能做到什么程度。产品团队现在最该做的,不是把 24 小时写进首页,而是拿一个三十分钟试播,把那四道工程门一扇扇撞过去。
连续性别漂,延迟别堆,坏内容别播,服务挂了能退。
等这四件事都稳了,播放条后面那段提前生成好的画面,才不只是一场很酷的演示。
它才算节目。