posts/hpc-ops-sglang-tpot.md
HPC-Ops 把 TPOT 降 48.8%,用户未必快一半
48.8%。
腾讯混元 AI Infra 和 SGLang 团队刚公开的 HPC-Ops 接入结果里,最抢眼的就是这个数字。
8 张 H20 跑 Hy3-FP8,输入 8K token、输出 4K token,batch 32 时,TPOT 从 35.33 毫秒降到 18.09 毫秒,降幅 48.8%。看着几乎就是快了一倍。
然后把同一张表往上看一行。batch 1,TPOT 从 7.56 毫秒降到 7.31 毫秒,只少了 3.3%。
好家伙,一张表,两种世界。
这不是谁在玩数字游戏。官方给的是实打实的 8×H20 服务测试,不只是拿一个 CUDA kernel 单独跑几万次取最好成绩。HPC-Ops 的 Attention、Router GEMM 和 MoE 路径也已经通过 多个上游 PR 合入 SGLang 主分支,代码、测试和讨论都能翻。
但要把「TPOT 降 48.8%」直接翻译成「用户少等一半」,中间还隔着一整条推理服务链。这个区别很重要,因为性能优化最容易在这里串台。芯片团队在谈 kernel,推理框架在谈 token,产品经理在谈首屏,用户只关心那个转圈什么时候停。
大家说的都是快,量的却不是同一件事。
TPOT 快的是哪一段
TPOT 是 Time Per Output Token,也就是模型进入生成阶段后,平均吐出一个新 token 要花多久。它主要描述 decode 的节奏。流式输出时,TPOT 越低,屏幕上的字出现得越密,长回答完成得越早。
可用户按下发送以后,模型并不会立刻开始逐字往外吐。请求先过鉴权、网关和限流,繁忙时还要排队;随后模型处理整段输入,算出第一个 token,这一段通常看 TTFT,也就是 Time To First Token;接着才进入 TPOT 主导的 decode;如果是 Agent,还会暂停去搜网页、查数据库、跑代码,再把工具结果塞回来继续生成;末尾还有网络传输和前端渲染。
粗略写成一行,大概是这样。
用户总等待 ≈ 网关与排队 + TTFT + TPOT × 输出 token 数 + 工具调用 + 网络与渲染HPC-Ops 这次把 Attention 和 MoE 两个热路径一起换掉,48.8% 已经是 SGLang 服务循环里的 TPOT 结果,比「某个算子快 2.95 倍」更接近真实线上。但它依然只覆盖上面公式中的一项。
官方同一组测试里的 TTFT 很能说明问题。8K 输入时,batch 1 到 16 的 TTFT 降幅是 9.0%、4.9%、6.0% 和 3.3%。也就是说,如果用户最在意的是点下发送后多久看见第一个字,提升不是 48.8%,而是个位数。
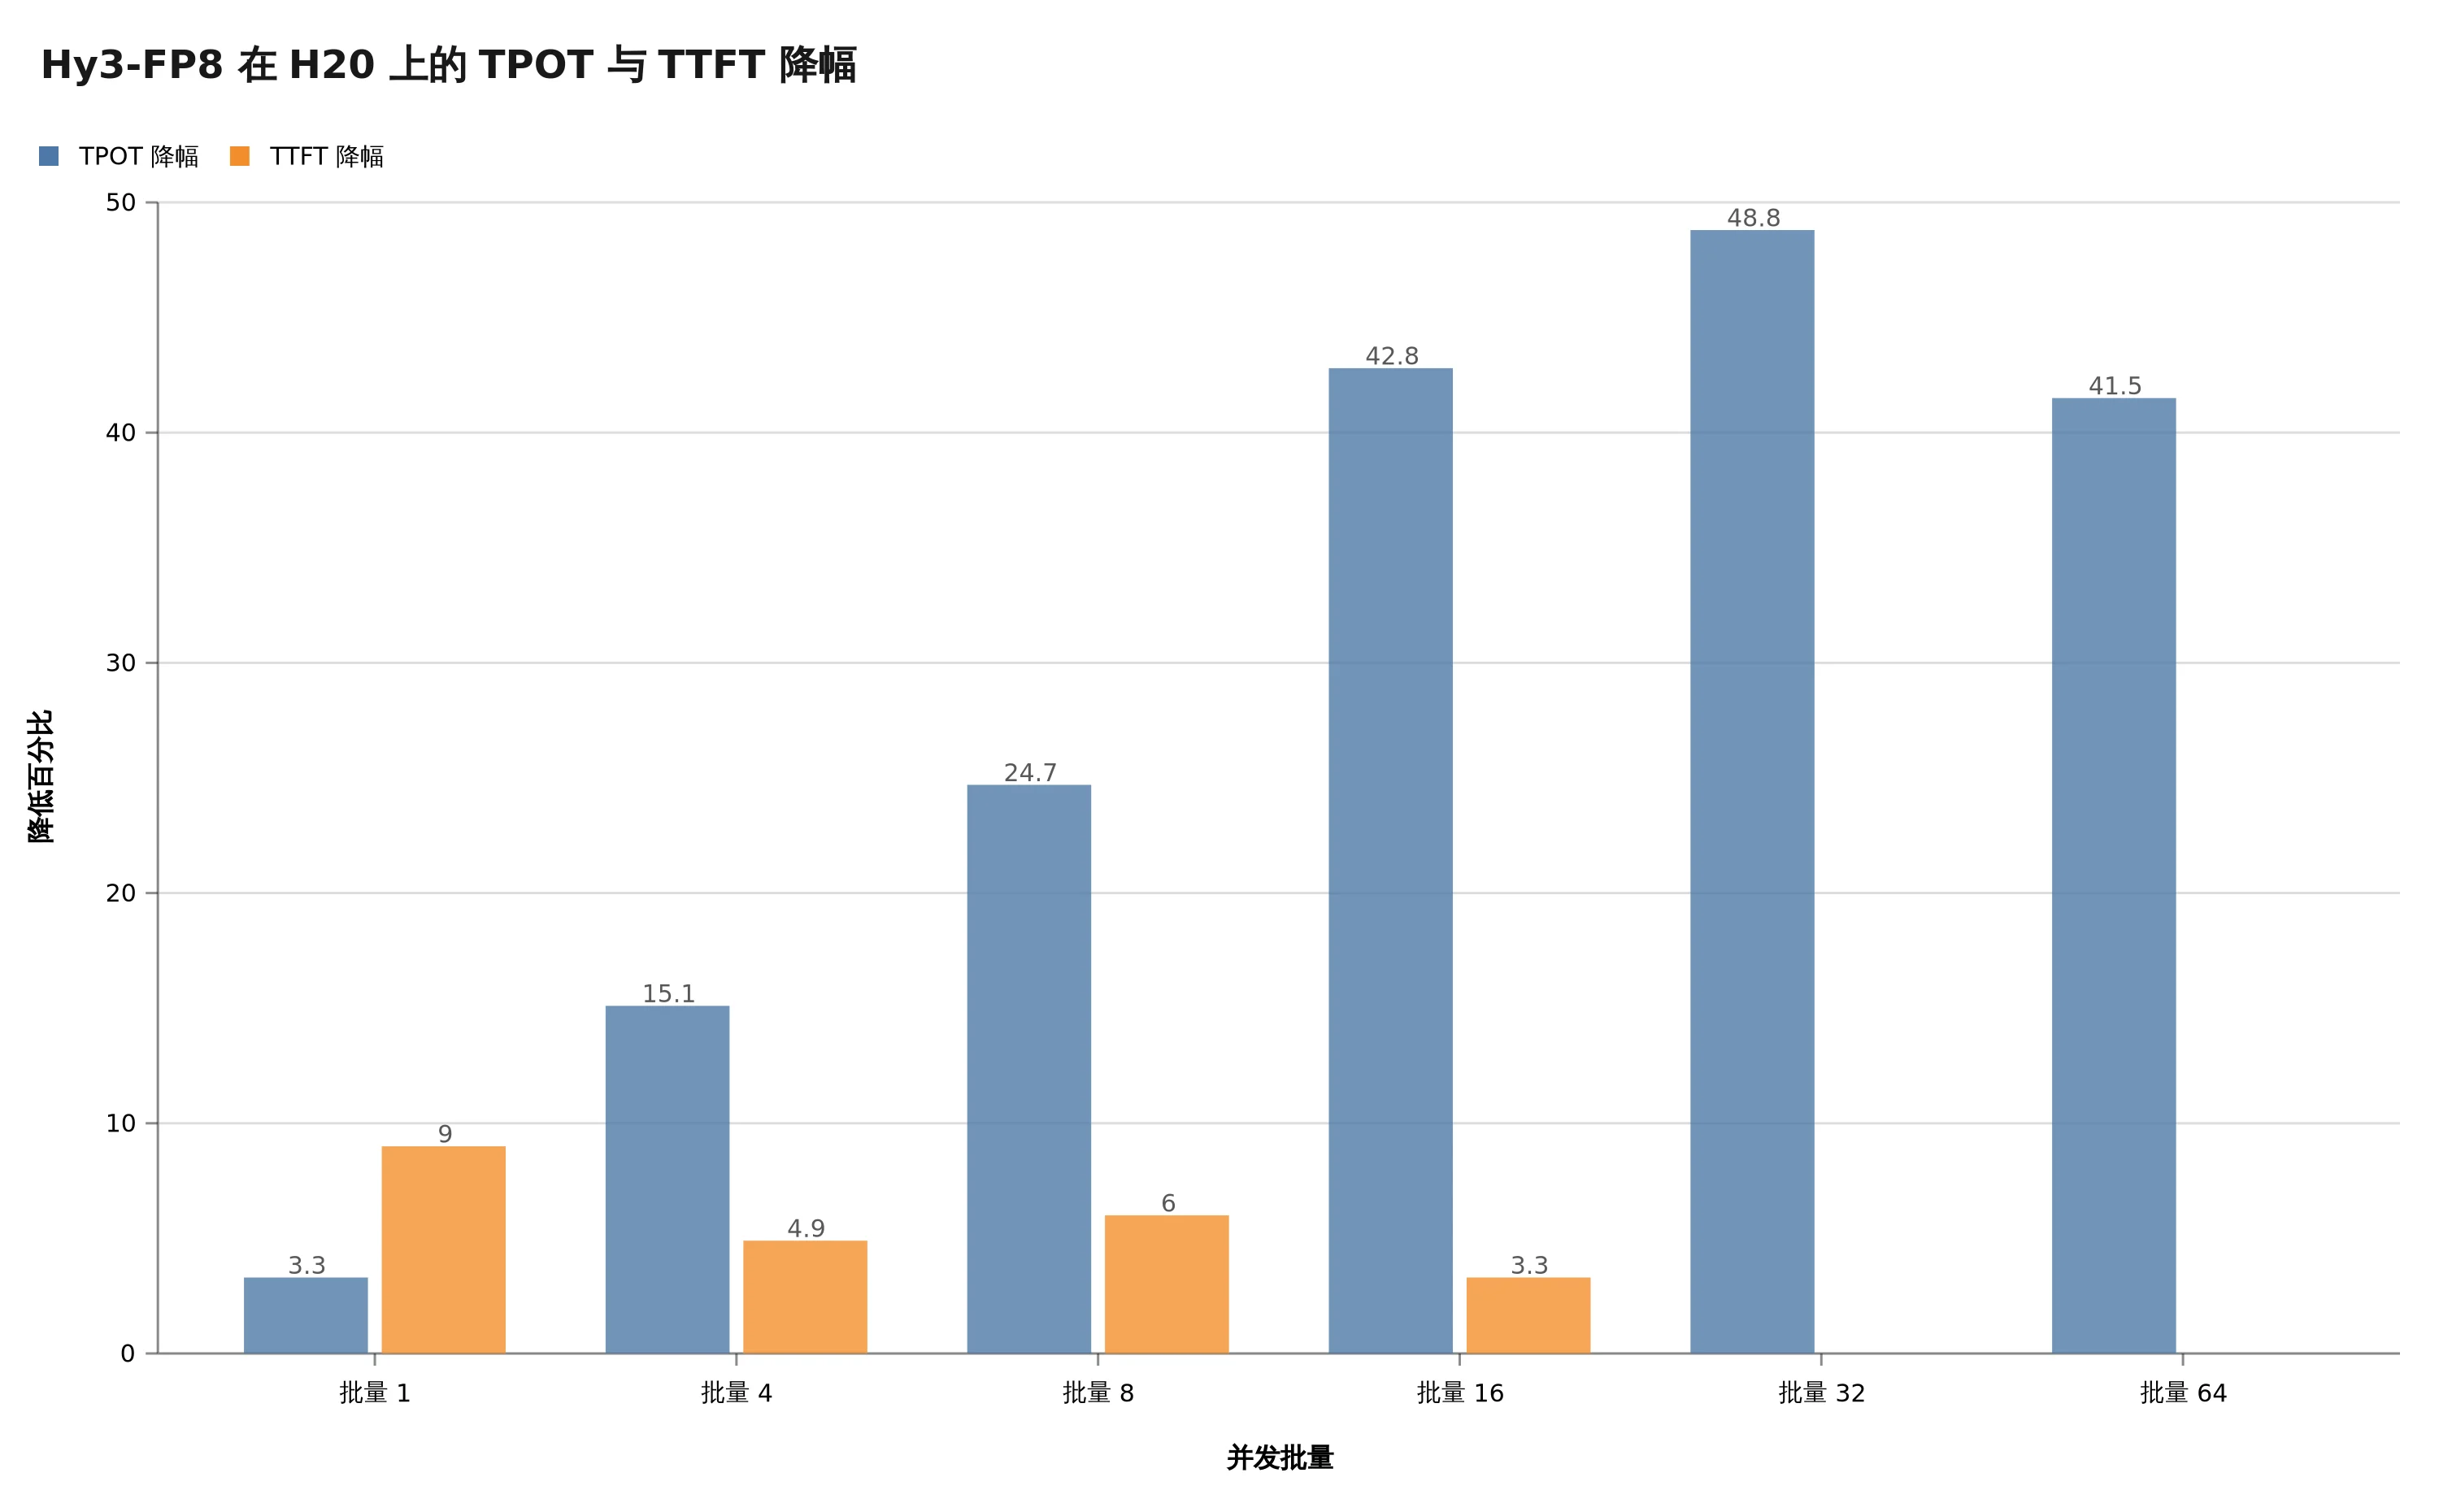
同一条服务链里,decode 改善与首 token 改善不是一个量级。
这也是流式界面很会「骗人」的地方。首字出来得快,后面慢一点,人会觉得系统挺灵;首字等很久,后面哪怕像机关枪一样喷 token,人还是会先皱眉。产品体感不是把所有毫秒平铺相加,它有明显的阶段权重。
说真的,这里不能反过来贬低 TPOT。对 4K 输出的长代码、报告生成、推理轨迹和多轮 Agent 任务,decode 可能占掉绝大多数时间。batch 32 时,每个 token 少 17.24 毫秒,4096 个输出 token 累计能省大约 70 秒,这当然不是小修小补。
问题只在于,屏幕前的普通用户并不会手动把 batch 调到 32,也不会每次都要 4K 输出。
为什么 batch 越大,数字越漂亮
这里的 batch 不是聊天框里的某个开关,而是同一时刻被服务循环一起处理的请求或 token 规模。单个用户访问低负载实例,常常更接近 batch 1。流量上来以后,continuous batching 才会把不同请求拼在一起,让 GPU 一轮多干活。
HPC-Ops 的设计恰好在这种场景更占便宜。
先看 Attention。连续批处理里的请求长短不一,有的 KV cache 只有 1K,有的已经拖到 64K。静态 split-KV 要么固定切片数,让长请求变成拖尾的那一块;要么固定切片大小,再按最长请求预留网格,短请求就带着一堆空任务占位置。一个像超市里有人推着三车年货堵住收银台,一个像给只买一瓶水的人也开一条空货车通道,都不太聪明。
HPC-Ops 会按实时 KV 长度把工作切成 64-token 的 tile,再把全局任务尽量均匀地分给持久化 CTA。长序列多拿任务,短序列只算自己真有的部分。长度越倾斜,动态调度越有价值。官方的 H20 单算子测试里,均匀的 64×0.5K 场景完全没变快;换成 1 条 128K 加 31 条 4K,才拉出 2.95 倍。
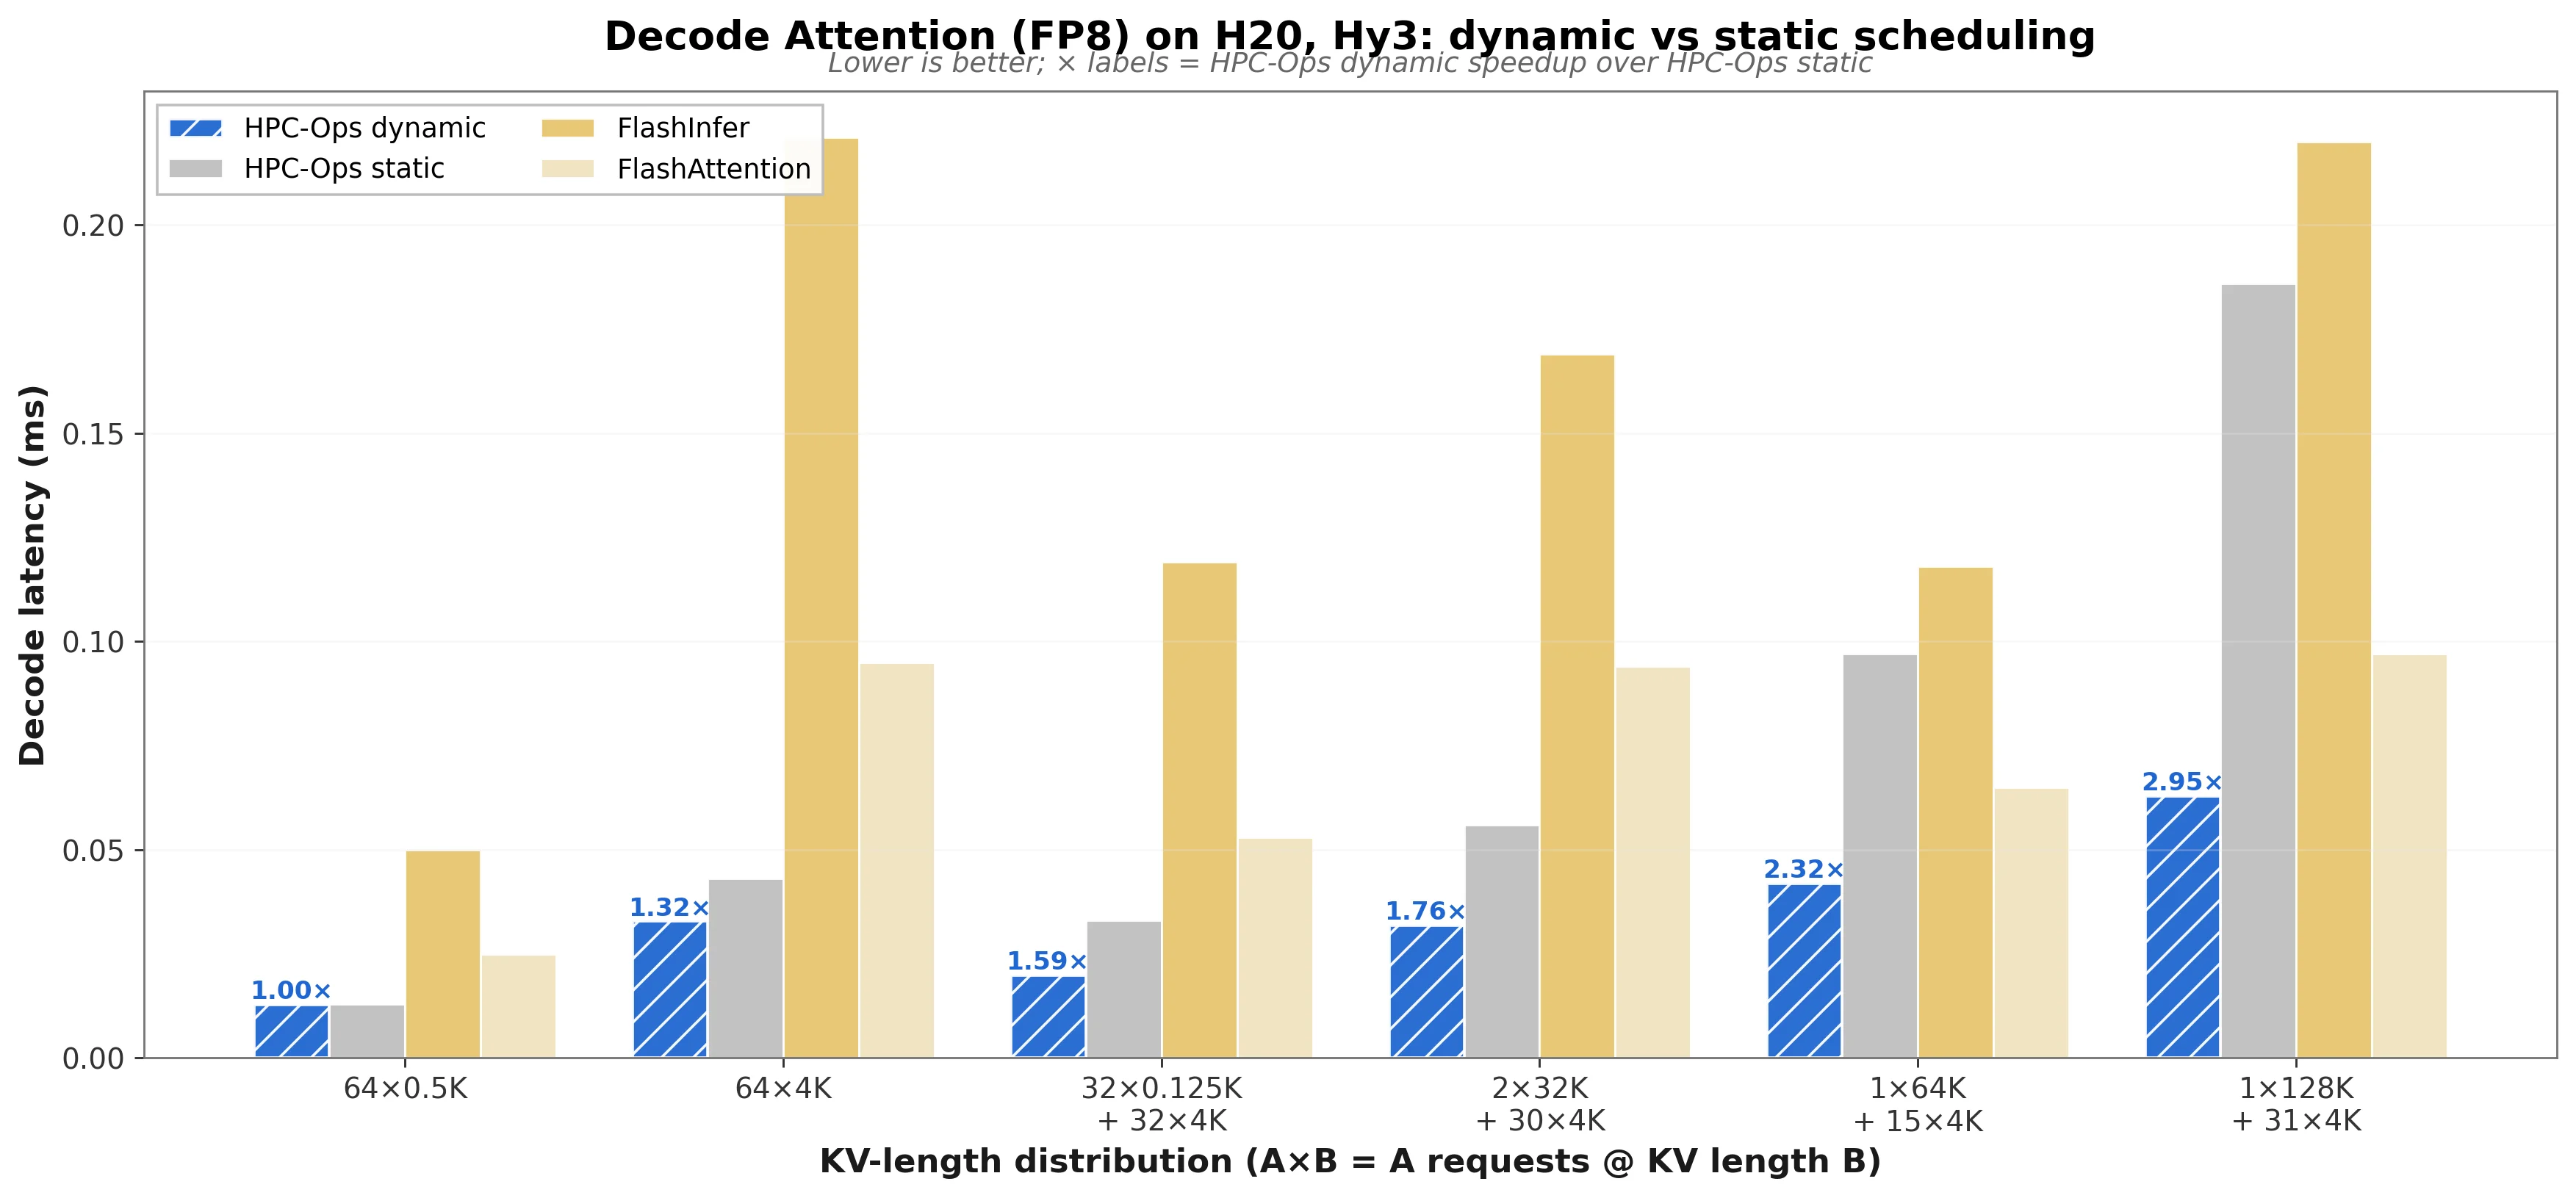
左边接近均匀负载,右边是少数超长请求拖住整个 batch。
再看 MoE。小 batch decode 时,每个专家分到的 token 很少,真正的矩阵乘法没有多大,反而是路由、搬运 token、写中间张量、一次次启动 kernel 更扎眼。HPC-Ops 把路由索引、Gate-Up、激活与再量化、Down GEMM、top-k 归并串成一条融合管线,跳过独立 gather,也少做几次 HBM 往返。
这种优化听着不性感,甚至有点像收拾机房地上的线。但线上性能往往就是被这些小缝隙吃掉的。厉害了,不是发明了新的数学,而是让 GPU 少等、少搬、少起跑。
当 batch 增大,默认路径里的负载不均、内存流量与 launch 空洞一起膨胀,HPC-Ops 消掉的浪费自然更多。所以 TPOT 降幅从 batch 4 的 15.1% 走到 batch 32 的 48.8%,不是一条神秘曲线,它和算子的设计目标正好对上了。
反过来,batch 1 没那么多可均衡的请求,也没有足够大的重复开销可摊,3.3% 才是合理结果。
局部快两倍,整条链只快一点
做性能优化的人绕不开一个老朋友,阿姆达尔定律。整条链路能快多少,取决于被优化的部分原来占多少时间。
假设某个算子原来只占请求耗时的 30%,即便它自己快一倍,剩下 70% 一毫秒没动,整条请求也只是从 100 缩到 85,提升约 17.6%。如果它只占 10%,那更直接,局部快一倍,整体只快约 5.3%。
HPC-Ops 官方结果里有个很漂亮的现实样本。Router GEMM 在 LongCat-Flash 的部分 shape 上,kernel 级最高能做到 2.83 倍;到了 LongCat-Flash-Lite-FP8 的完整 prefill,batch 4 到 64 的输入吞吐只提升 5.5% 到 6.1%,batch 1 更是只有 0.5%。
不是优化失效了。Router GEMM 本来就只是 prefill 里的一小段,模型还有 Attention、其他 GEMM、归一化、通信和调度。一个齿轮转得再快,也不能替整台机器省掉所有摩擦。
同样的道理放到用户请求上,还要再稀释一次。短回答如果只有 300 个输出 token,batch 1 下每个 token 省 0.25 毫秒,整个 decode 大约少 75 毫秒;再加 TTFT 省下的约 41 毫秒,理想状态也就一百多毫秒。网关排队或一次外部搜索慢半秒,这点收益就被盖住了。
换成 4K token 的长输出、高并发、混合长度请求,结论立刻翻面。此时 Attention 与 MoE 在总耗时里的占比更大,批处理带来的拖尾也更重,算子优化能连续吃到几千次,节省几十秒完全可能。
所以「用户有没有体感」不是一个统一答案。在线客服的短回复、代码 Agent 的长 patch、批量摘要服务、离线报告生成,它们看见的是四条不同的收益曲线。把最高值复制到所有场景里,才是真正的问题。
从实验表走到 SLA,还差一轮负载测试
这次结果还有两个容易被标题吃掉的边界。
一个是硬件。HPC-Ops 目前支持 NVIDIA Hopper,重点针对 H20 调优。Attention 接入 PR 明说,在 H100、H200、B200 等其他 GPU 上,收益可能有限或不存在,所以 backend 保持 opt-in。
H200 验证也很诚实。Hy3-FP8 的 Attention 输出吞吐提升 3.7% 到 5.9%;Router GEMM 的输入吞吐提升 2.8% 到 5.4%;MoE 在 Hy3 上从下降 4.2% 到提升 6.3% 都有。同一份代码从 H20 挪到 H200,曲线就不是原来那条了。硬件代际、显存带宽、Tensor Core 形态和 kernel 调度,少一个条件都可能换答案。
另一个是负载模型。固定 batch 的 bench_one_batch_server 能干净比较实现差异,却不会完整模拟线上到达率、排队、缓存命中、请求取消和长短输出混跑。高并发时,TPOT 降下来可能进一步释放容量,缩短排队,这部分用户收益甚至可能比表里更大;也可能因为流量被推到更高饱和区,P99 仍然难看。
我自己的判断是,准备接 HPC-Ops 的团队,别只复跑官方那张表。至少把线上请求分布切成短输入短输出、长输入短输出、短输入长输出、长输入长输出四类,再分别看 p50 和 p99 的 TTFT、TPOT、端到端耗时、每卡吞吐与失败率。然后固定一条 SLA,看同样 GPU 数能多扛多少 QPS;再固定 QPS,看能不能少用卡。
这才是算子库真正能兑现的钱。
数值正确性也别靠一句「FP8 没问题」带过。HPC-Ops 的 Router GEMM 为了保住 top-k 专家选择,把 FP32 权重拆成 BF16 高位与残差,两次 Tensor Core 计算后再合起来。官方给了误差、greedy 输出和 cosine similarity 验证,这是好事。但生产模型、量化配置、LoRA、在线权重更新都可能引入新组合。尤其 Router 的微小误差会改变专家选择,性能回归测试最好和任务质量评测绑在一起跑。
有点子牛逼的工程,通常也有一张很长的适用条件表。
48.8% 应该怎么读
我不觉得这次发布是在堆跑分。恰恰相反,腾讯开源 HPC-Ops,又把 Attention、Router GEMM 和 MoE 真正接进 SGLang,价值比一张漂亮的 PPT 大得多。H20 在国内部署里数量不小,一套针对它的生产算子库进入主流开源框架,能省的是持续发生的 GPU 时间。
只是读这类性能新闻,最好养成一个小习惯。看见「快 48.8%」,先问它量的是 kernel、TPOT、TTFT、吞吐还是完整请求;再看 batch、输入输出长度、硬件、模型和精度;落回自己的线上流量究竟在哪一格。
回到开头那张表。batch 1 的 3.3% 和 batch 32 的 48.8% 都是真的,它们分别写给低负载单请求和高并发长输出。
算子负责把浪费的毫秒一颗颗捡回来。至于用户能不能少等一半,得看整条链路愿不愿意把这些毫秒交到他手上。