posts/huggingface-webgpu-kernels.md
207 个 WebGPU 内核快 2.57 倍,整模型还没跑
你在网页里点一下「本地运行」,底下真正忙的并不是模型名字。
矩阵乘法、归一化、卷积、Attention、量化、数据布局转换,一层接一层地往显卡里塞。只要其中一个算子踩进慢路径,页面上那个漂亮的「纯本地 AI」按钮,就可能变成风扇声和进度圈的联名周边。
9 月 1 日,Hugging Face WebAI 团队把这层脏活摆到了台面上。他们发布了 @huggingface/kernels,首批 207 个 WebGPU 内核,全部放在 Hugging Face Hub上,Apache-2.0 开源。
官方在 Apple M4 GPU 上和 ONNX Runtime Web 做了 809 组有效对比,几何平均快 2.57 倍,中位数快 1.90 倍,629 胜、176 负、4 平。最夸张的一组 Einsum,0.136 毫秒对 1396 毫秒,超过 10000 倍。
好家伙,10000 倍。
但我看完整篇公告,最想提醒的一句反而是,整模型还没跑。
官方测的是 GPU 内部单个算子的执行时间,没有计入加载内核、创建会话、上传输入、编译 shader 和读回输出。它自己也写得很直白,这不是完整模型的端到端结果,不同 GPU、浏览器和驱动会继续改写答案。
所以这次发布值得看,却不能只看最快的那个数字。真正有点子牛逼的地方,是 Hugging Face 把一段 shader 变成了一个能被工程团队长期维护的软件制品。
207 个内核不是 207 段代码
WebGPU 是浏览器调用 GPU 的通用接口,WGSL是它使用的着色器语言。你可以把内核理解成模型落到显卡上时真正执行的一小块数学程序。
问题在于,可移植不等于性能稳定。
同一个加法,同样算对,在 Apple GPU、NVIDIA GPU 和集成显卡上可能走出完全不同的速度。工作组大小、内存访问、向量化方式、数据类型、输入形状和算子融合,任何一项都可能让结果翻脸。再叠一层 Chrome、Edge、Safari 的实现差异,浏览器本地推理很容易从「我的机器能跑」滑向「用户的机器谁知道」。
Hugging Face 这次没有只扔出 207 份 *.wgsl 文件。
每个内核都有自己的仓库和 kernel card。以最简单的 ai.onnx.Add 为例,仓库里至少有五类东西。
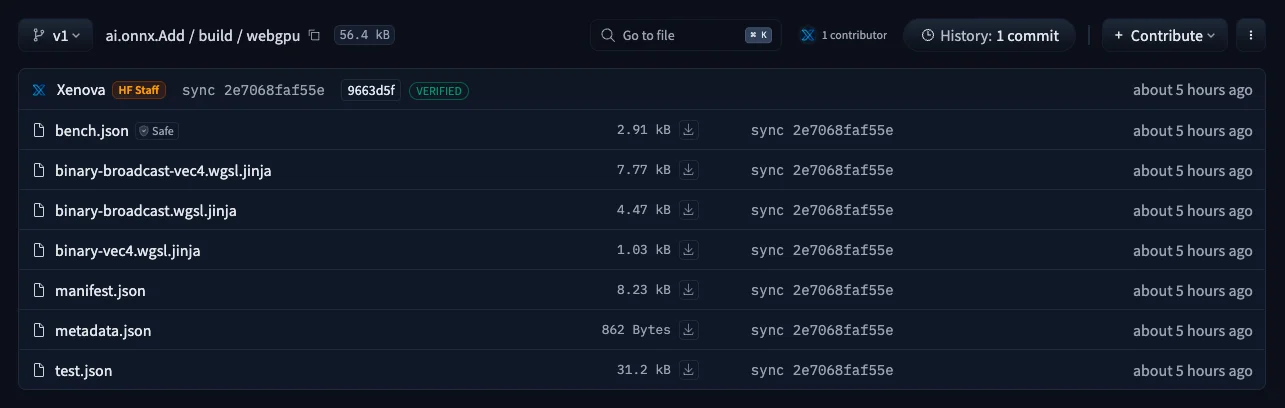
图,ai.onnx.Add 不是孤立 shader,正确性用例和性能基准都跟着实现一起版本化
manifest.json 写输入、输出、属性、类型限制和形状推导规则,metadata.json 记标识、摘要和来源,test.json 放正确性用例,bench.json 放性能与调优用例,*.wgsl.jinja 才是参数化的 WGSL 实现。
这套安排看起来不如万倍加速刺激,却更接近生产环境真正缺的东西。
shader 写出来,只解决「有实现」。契约让上层知道怎么调用,测试证明它没有算错,基准暴露它在哪些形状上变慢,版本号则让今天能跑的应用,不会因为明天有人悄悄改了一段代码就原地爆炸。
尤其是 version: 1 这个设计。它锁定的是 JavaScript 面向的内核契约,不是 ONNX opset,也不是模型 revision。内核底下可以继续换实现,上层调用方式不用跟着抖。
很多 AI 工程的坑,就埋在这种看起来没什么内容的边界里。
模型可以换,运行时可以升级,底层优化也可以一轮轮重做。但契约、测试和可复现基准不能一起漂。否则某次提速到底来自新 shader、浏览器缓存、驱动更新还是计时误差,最终只能靠群聊里一句「我这边挺快的」结案。
厉害了,性能工程被做成玄学,通常就差这一条证据链。
2.57 倍该怎么读
这组数字经得住第一轮检查。
官方先跑了 1756 个用例,只保留两边输出一致、计时可靠的 809 个,再计算几何平均、中位数和胜负数。Add 快 3.52 倍,MatMul 快 1.14 倍,Softmax 快 2.11 倍,LayerNormalization 快 2.22 倍。
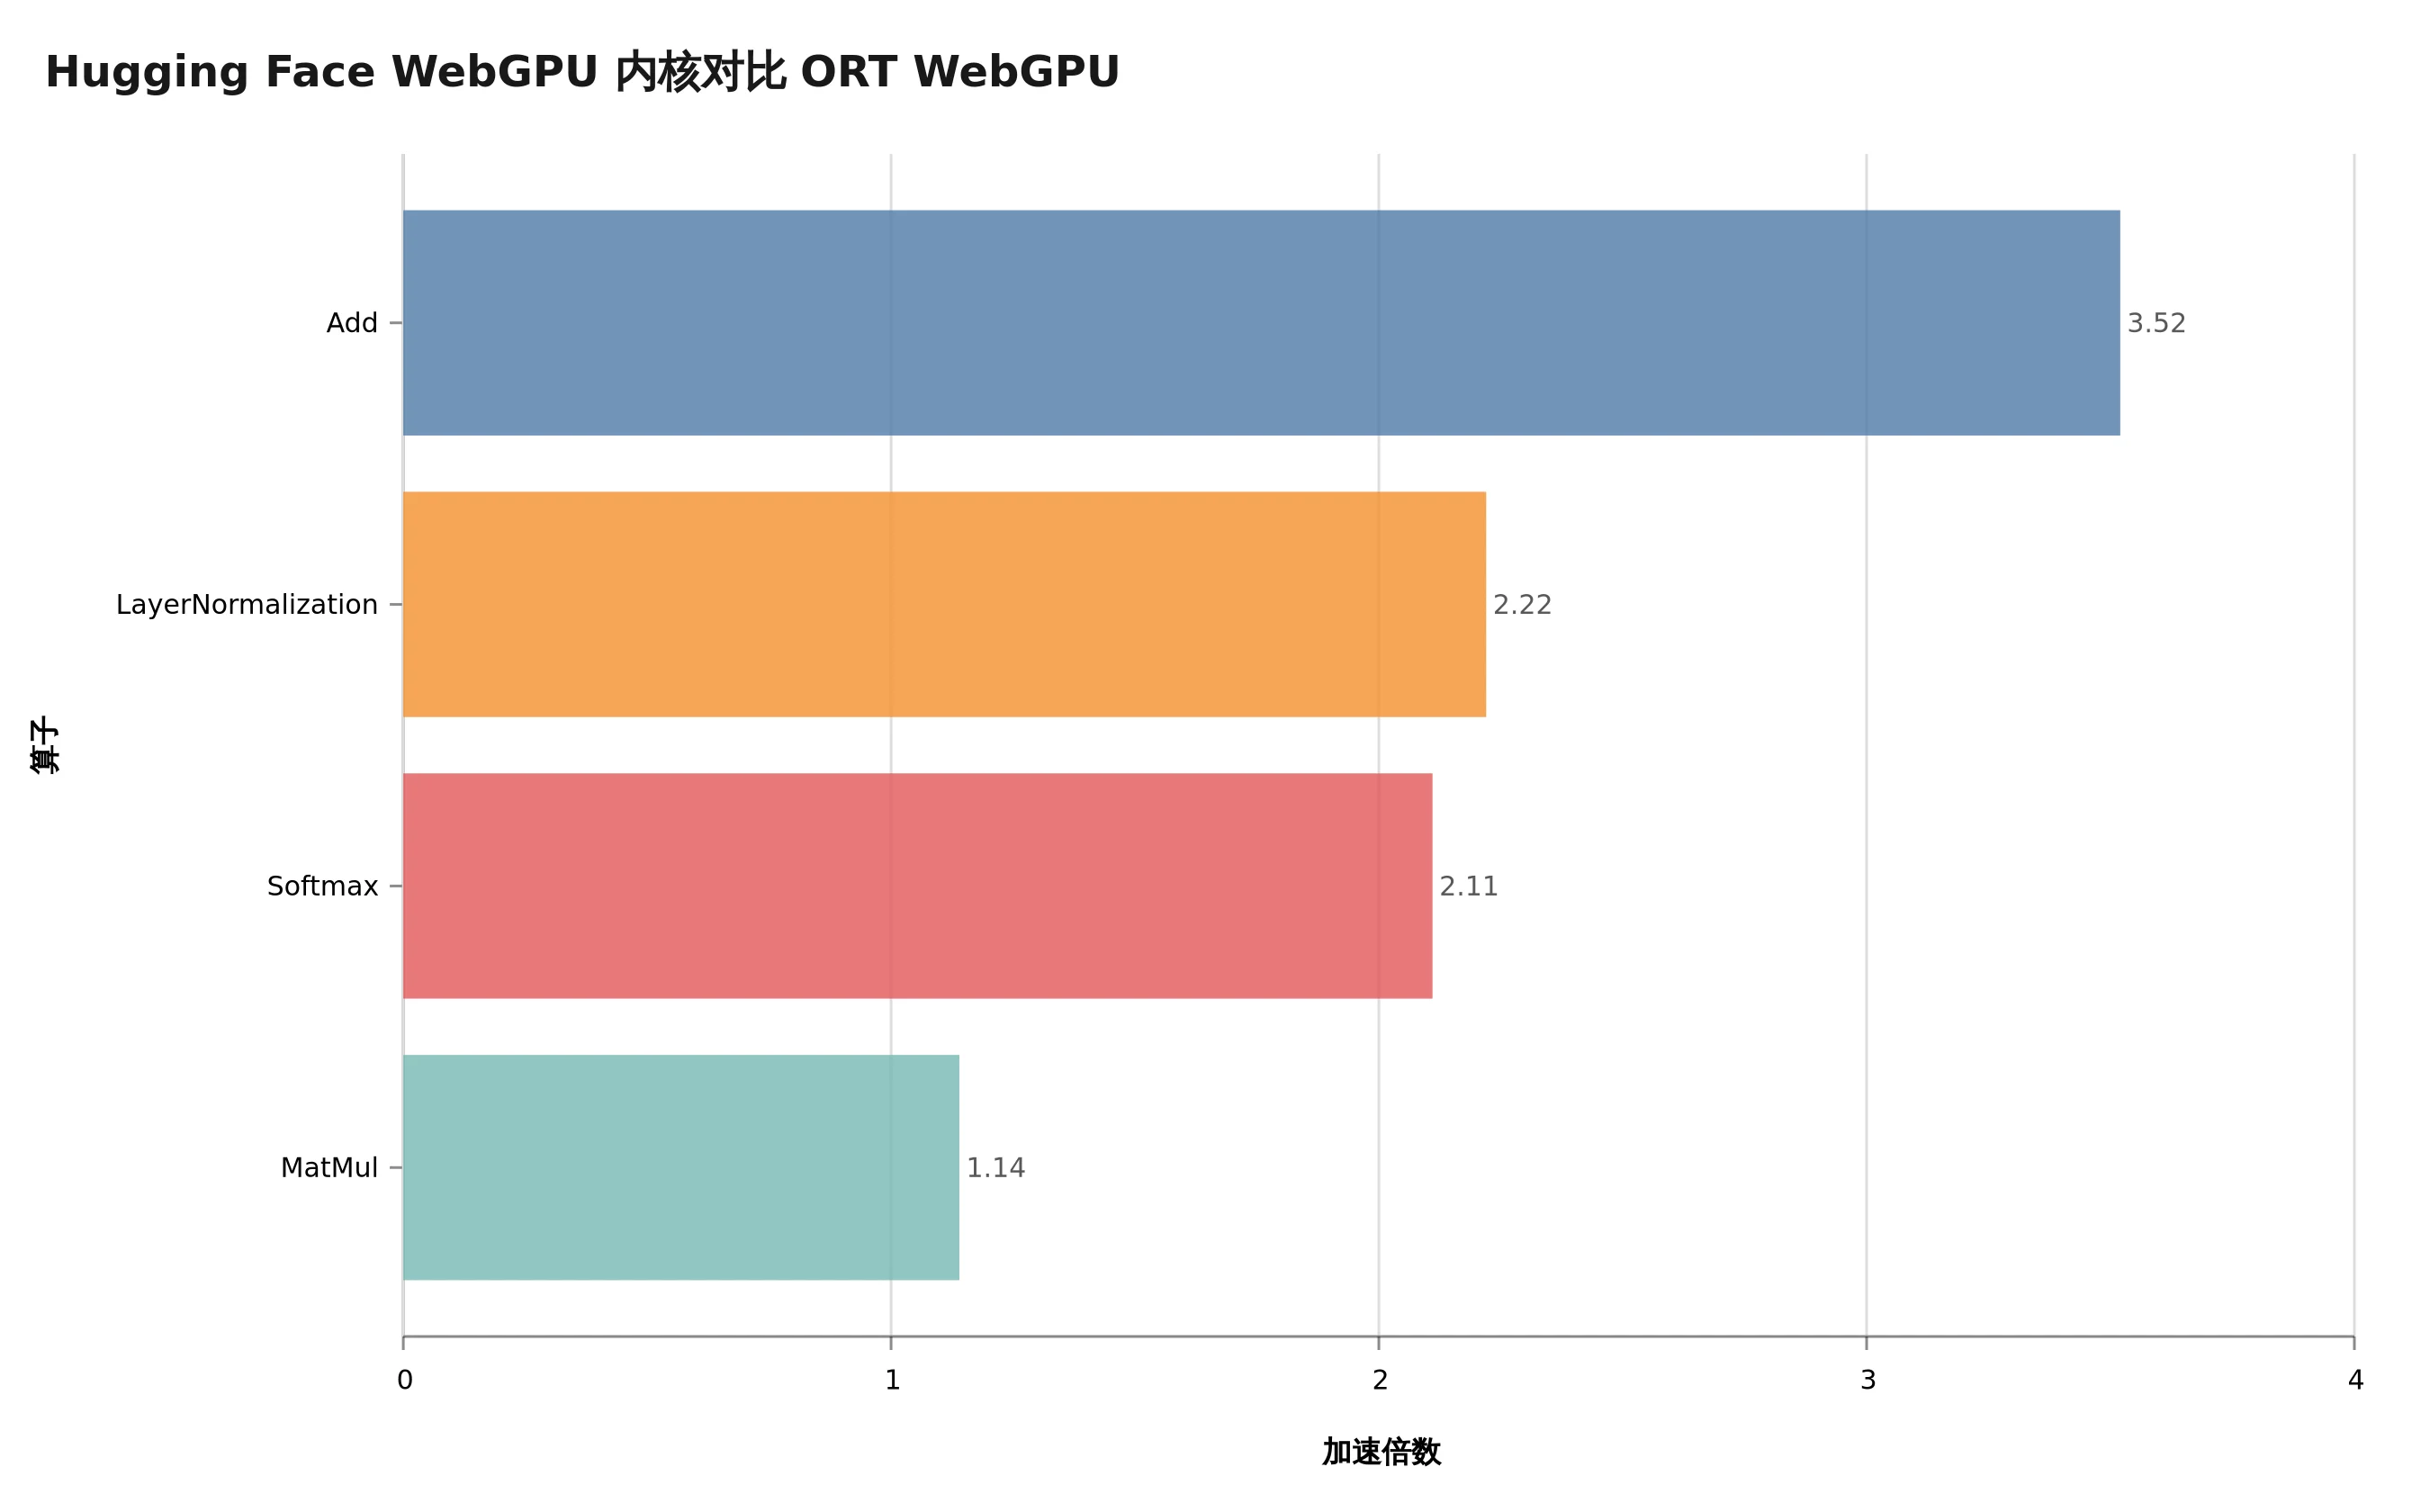
图,四个常见算子都更快,但 MatMul 的 1.14 倍和 Add 的 3.52 倍差得很远
这比只挑四张漂亮截图靠谱得多。629 胜旁边还老老实实摆着 176 负,至少没有假装所有算子都被一夜优化完了。
可边界同样清楚。
第一,测试机器只有 Apple M4 GPU。WebGPU 最大的难点,恰恰是设备、浏览器和驱动组合太多。一台机器上的冠军,不会自动复制到办公室那台核显 Windows、三年前的 MacBook 或用户刚更新过驱动的 Linux。
第二,官方只测 GPU 内部工作。对一个完整网页应用来说,模型下载、权重解码、shader 编译、数据上传、CPU 与 GPU 同步、结果读回都在账单里。某个算子从 0.2 毫秒缩到 0.1 毫秒,如果前后准备花了 80 毫秒,用户可能完全感觉不到。
第三,10000 倍和 301 倍来自非常特殊的慢路径。它们的价值,是证明专用变体能救回灾难级实现,不是承诺所有浏览器模型明天都能快两个数量级。
换到工程语境里,正确的验证顺序应该是从单算子往上爬。
先确认相同输入能得到相同输出,再看代表性 shape 的内核时间,然后跑完整模型的预热后延迟和首轮延迟,再回到产品页面,测从用户点击到结果可用的总时间。中间任何一层没有记录,最上面的「快了多少」都可能是错觉。
我自己的判断是,2.57 倍是一张很好的入场券,不是一张生产证明。
这话听着有点扫兴,但对要把本地 AI 真塞进产品的人,它比 10000 倍有用。跑分负责把你吸引进来,端到端验收才负责让你别在发布日被工单叫醒。
Fleet 才是这套东西的长线价值
Hugging Face 同时放出了 Fleet,一个直接在浏览器里跑正确性和性能测试的工具。
它不是再做一张固定榜单。用户在自己的设备上运行测试,明确同意后,结果会以私密证据的方式回传。团队就能看到哪种 GPU 加浏览器加驱动组合算错了,哪条路径慢得离谱,哪个变体不该在某类设备上被选中。
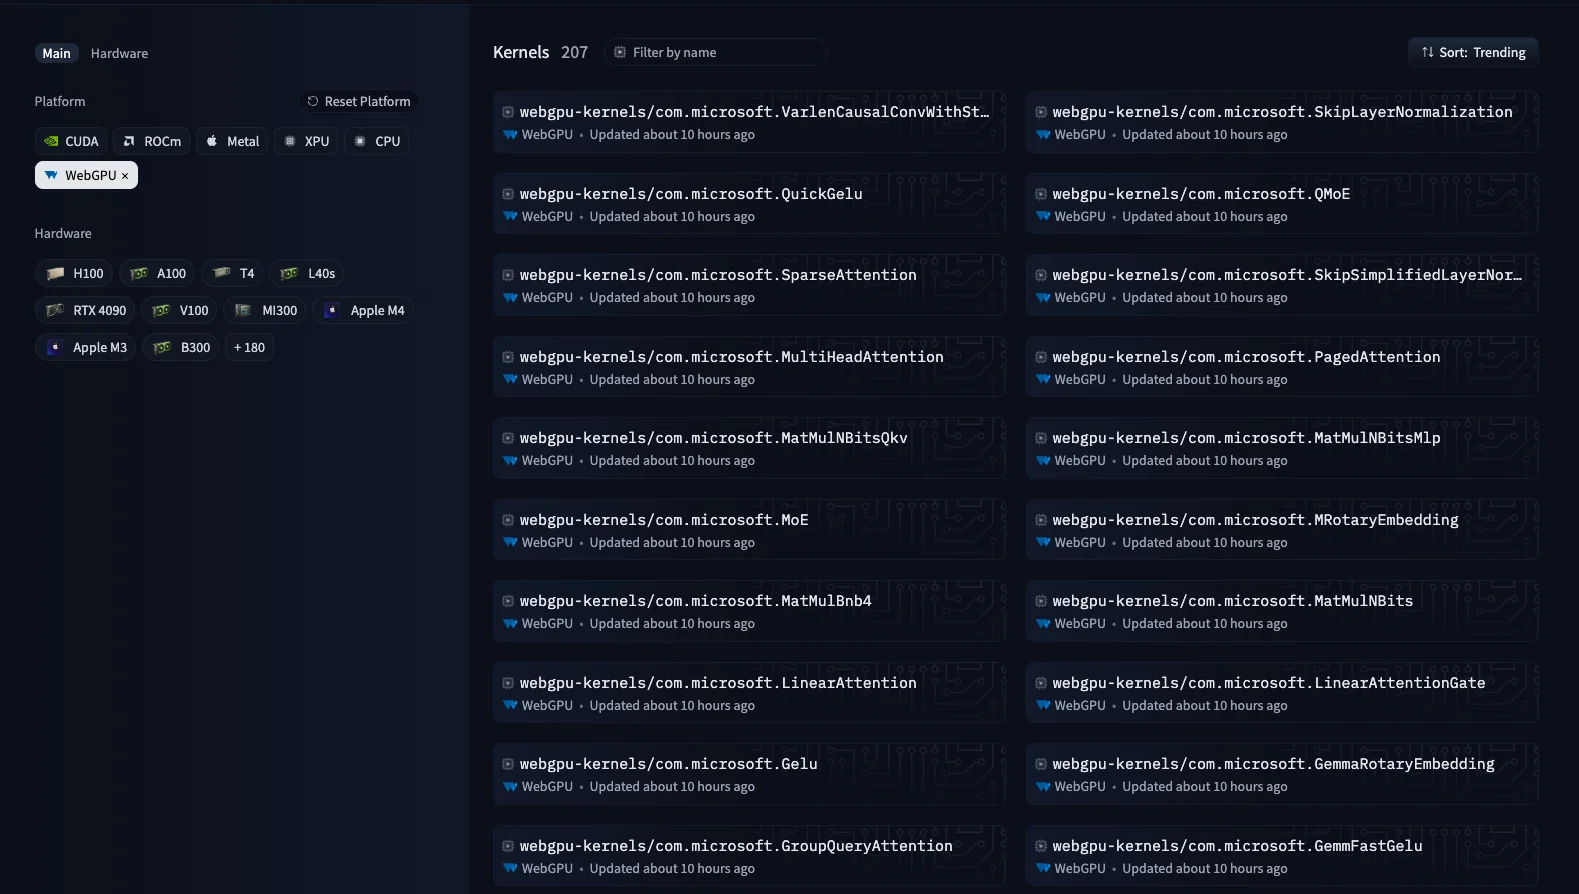
图,207 个 WebGPU 内核以独立仓库进入 Hub,可以按平台和硬件继续筛选
这块需要注意一下,WebGPU 的难题从来不只是写出一份快代码,而是你不可能买齐用户手里的所有机器。
传统测试实验室可以覆盖几台主流显卡,覆盖不了长尾驱动、企业锁死的浏览器版本、奇怪的集成 GPU 和移动设备。Fleet 把这片盲区改造成一张持续长出来的证据网。
内核仓库负责给出稳定契约和可复现用例,JavaScript loader 负责把它送进应用,Fleet 负责从真实硬件捞回正确性与性能信号。这三件事连起来,才像一套完整系统。
没有 Fleet,207 个内核更像一份规模很大的代码捐赠。有了真实设备反馈,运行时才有机会知道,同一个 Add 请求在当前 shape 和当前设备上,应该选等形向量化、广播向量化、标量还是通用广播变体。
浏览器 AI 的竞争也会跟着变。
以前大家比谁能把模型塞进网页,demo 能出字就算赢。下一阶段要比的,是同一个模型在多少设备上算得对、跑得稳、升级后不回退。模型文件依然重要,但底下这套内核、契约和证据网络,会越来越像真正的护城河。
今天怎么试,别把预览版当成魔法
安装入口很短。
npm install @huggingface/kernels@preview运行前先按 MDN 的 WebGPU 兼容说明检查浏览器支持,代码里也可以用下面这一句做能力探测。
const hasWebGPU = "gpu" in navigator;然后通过 getKernel 指定 Hub 仓库和契约版本。官方最小示例加载的是 webgpu-kernels/ai.onnx.Add,输入两组 Float32Array 和 shape,运行时根据 manifest 推导输出并分配结果。
import { getKernel } from "@huggingface/kernels";

const add = await getKernel("webgpu-kernels/ai.onnx.Add", { version: 1 });

const { c } = await add({
  a: { data: new Float32Array([1, 2, 3, 4, 5, 6]), shape: [2, 3] },
  b: { data: new Float32Array([10, 20, 30]), shape: [3] },
});
六个浮点数的加法当然不会因为上 GPU 就更划算,往返成本比数学本身还大。这个例子要证明的是调用契约,换成 MatMul 之类的重运算,调用姿势不需要重写。
如果你准备把它接进真实产品,我建议先留四条护栏。
别删现有回退路径。WebGPU 不可用或初始化失败时,WebAssembly、CPU 或原来的 ONNX Runtime Web仍要能接住请求。
别只记热身后的最好成绩。首轮 shader 编译和权重准备,往往更接近用户第一次点击时看到的等待。
别把官方 M4 数据当成自己用户的数据。挑几台真实目标设备跑完整页面,再决定是否默认启用。
也别忘了这是 preview 包。固定内核契约版本,锁依赖范围,把正确性用例和端到端基准塞进 CI,升级前后各跑一遍。
这些动作没一个像 10000 倍那么适合做海报。
但软件从 demo 走到产品,靠的本来就不是海报。
Hugging Face 这次真正放出来的,不只是 207 个更快的 GPU 零件。他们把每个零件的说明书、验收单、秒表和真实道路测试绑在了一起。
模型是船,浏览器是海。内核快不快当然重要,但能不能在不同风浪里持续知道它算对了、没变慢,才决定这条船能不能离开码头。
2.57 倍先记下。
然后把整模型跑完。