posts/hy4-million-context-budget.md
Hy4 的百万上下文,不该成为 Agent 默认配置
100 万 token,差不多能塞进一个中型代码仓库、几十份长文档,再顺手捎上几个月的 Agent 运行记录。
屏幕前的你如果做过长任务,大概会立刻冒出一个很诱人的想法。既然窗口这么大,检索、摘要、压缩是不是都可以先放一边,把资料全扔进去就完事了。
先别急。
腾讯混元刚开源的 Hy4 preview确实很猛。770B 总参数,每个 token 激活 49B,78 层主干,1M 上下文,还原生带了一层 MTP 做投机解码。官方给出的生产力方向也很对工程师胃口,长程软件开发、跨文件办公分析、游戏项目和科研任务,都是吃上下文的大户。
但我盯着模型卡看了一圈,最想提醒的不是它能装多少,而是另一件事。
百万上下文是一块地址空间,不是一份免费容量。
好家伙,窗口从 256K 往 1M 一拉,模型能看见的东西多了四倍,Agent 的架构债也跟着一起显影。以前被窗口上限强迫做的检索、分层记忆、状态压缩和任务切分,一旦不再被迫做,很容易全被偷懒删掉。到头来得到的不是更聪明的 Agent,而是一条更贵、更慢、更难复盘的长请求。
别人会把 770B、49B 和 1M 做成三张大字海报。我更想把这三个数字放回一张工程账单里。
49B 激活,不等于 49B 模型
Hy4 preview 是混合专家模型,也就是 MoE。它一共有 256 个路由专家和 1 个共享专家,每个 token 只会激活其中 8 个路由专家,再加上共享专家。于是,模型拥有 770B 的总容量,单次前向计算只动用 49B 激活参数。
这套设计有点子牛逼。模型可以把不同知识和能力分散进大量专家,又不用每生成一个 token 都把 770B 参数全部算一遍。
可部署时,770B 权重并不会因为没被激活就消失。
官方同时放出了原始权重和 FP8 量化权重。如果用 FP8 粗略估算,一字节一个参数,770B 主干权重已经接近 770GB,额外那层 MTP 还有 10B 总参数。真实显存占用还会受到元数据、量化格式、运行时缓冲区和并行策略影响。这也是为什么官方的 vLLM 部署方案直接从 8 路张量并行起步,并要求专门的稀疏注意力后端。
这里很容易把两个概念混在一起。
49B 决定的是每个 token 主要要算多少专家,770B 决定的是整套模型权重得放在哪里。前者更接近计算量,后者更接近容量与加载成本。你不能拿激活参数去估显存,也不能拿总参数直接估每 token 的计算量。
这就像一个有 7700 本书的图书馆,每次回答只抽 490 本出来翻。读书速度确实不用按 7700 本算,但图书馆的房租一平方米都不会少。
厉害了,MoE 把计算账和容量账拆开了。工程团队也得分开算。

图,Hy4 preview 官方基准总览,蓝色柱为 Hy4 preview,浅蓝部分为上一代 Hy3。来源,腾讯混元。
百万上下文,贵的不只是一百万次分词
权重是模型启动前的固定账,上下文则是每个请求都可能重新长出来的活账。
Hy4 的模型卡给了几个很关键的规格。Key-Value 压缩维度是 512,主干 78 层,上下文上限 1M。KV cache 可以理解成模型为已经读过的 token 留下的中间笔记,后面生成新 token 时不用从头重算。窗口越长,这摞笔记就越厚。
做一个刻意保守的纸面估算。假设每层为每个 token 保存 512 个半精度数,每个数 2 字节,78 层乘 100 万 token,单条序列的压缩 KV 数据就接近 80GB。这个数字不是官方显存承诺,实际结果会随精度、分页、稀疏实现和框架变化,它只是告诉我们数量级。
一条百万上下文,会开始和一张大显存卡抢空间。
Hy4 用了 Gated DeepSeek Sparse Attention,并通过 IndexCache跨层复用稀疏索引,Indexer 每次选 top-k 2048。它们能削掉长序列注意力里的大量重复计算,也让百万窗口不至于按最朴素的全量注意力爆炸。
但稀疏注意力没有把上下文变成空气。
模型仍得接收文本、建立索引、保存必要状态,还要在 Agent 每次工具调用之后继续维护这条长序列。上下文上限回答的是「最多能放多少」,不是「放满之后每一步都一样快」。这是两个完全不同的问题。
API 账单也有同样的错觉。OpenRouter 当前的 Hy4 preview 页面标着 1M 上下文,并公开了按百万 token 计费的输入输出价格。单看一次请求,百万 token 似乎没有想象中夸张。
可 Agent 不是问一次就结束。
假设一个任务会调用 20 次工具,每次都把接近 1M 的历史重新带回去,缓存又没有命中,那就是约 2000 万输入 token。再乘上并发任务、失败重试、验证回合和每天的调用量,原本一条看起来能接受的长请求,会迅速变成稳定烧钱的背景进程。
更麻烦的是延迟。一个工具返回只花 300 毫秒,模型为了重新读懂庞大历史等了十几秒,Agent 的瓶颈就不再是工具,而是它每一步都背着整个仓库过河。
不是哥们,窗口大了,怎么还开始负重训练了。
真正危险的是,模型会认真地浪费预算
腾讯在模型卡里很坦诚地写了两个已知局限。Hy4 preview 在复杂任务上可能思考过久,也有过度验证自己工作的倾向。
这两条放在普通聊天里,最多让回答慢一点。放进长程 Agent,它们会互相放大。
长窗口给模型更多历史,更多历史给它更多可复查的细节,过度验证又会制造新的日志、工具结果和推理痕迹。上下文继续变长,下一轮可复查的东西更多。嘶,这就不是一个模型习惯了,而是一条会自我加料的运行时回路。
很多朋友可能不知道,长任务里最难处理的并不是模型突然胡说,而是它一直显得很认真。
它会重复检查已经通过的测试,重新打开刚读过的文件,为一个低风险改动再跑一次全量验证。每个动作单独看都合理,串起来却在消耗时间、token 和外部系统额度。日志里没有明显报错,监控甚至会显示任务仍在健康推进。
等 deadline 到了,Agent 留下一份非常勤奋的过程记录,真正的交付物还差一步。
段错误都比这诚实,至少它会停。
所以,百万上下文最需要搭配的能力不是更激进的「全部塞进去」,而是清晰的停止条件。任务要有最大回合数、最大输入预算、最大工具成本和明确的完成判据。验证动作也要分级,改一行文案不该触发全仓集成测试,关键数据库迁移才值得把检查开满。
模型越能坚持,运行时越要知道什么时候让它收手。
窗口大了,更该把状态搬出去
我始终觉得,1M 上下文对 Agent 最好的用法,不是取消架构,而是给架构留出更大的安全余量。
原始代码、文档、表格和日志继续放在文件系统、对象存储或检索服务里。上下文里只保留当前目标、约束、已确认事实、证据索引、最近动作和下一步计划。需要原文时,让工具按路径或片段取回来,不要把整个仓库永久焊在 prompt 上。
长任务可以分成三层状态。
第一层是稳定前缀,放系统规则、工具合同和任务目标,尽量保持字节级稳定,给服务端缓存留下命中机会。
第二层是压缩后的工作记忆,记录已经做出的决定、失败原因、关键文件位置和待办,不复制大段原文。每条结论都带来源路径,之后能追溯。
第三层是短期现场,只保留最近几轮工具输入输出。现场变长就做一次有证据索引的压缩,而不是把旧消息粗暴删掉,也不是任由它无限堆积。
这里最重要的词不是摘要,而是可恢复。
Agent 崩掉重启后,能不能从检查点知道任务做到哪一步,哪些测试真的通过,哪个判断只是模型猜的。换一个模型接手后,能不能沿着证据索引重建关键上下文。人工介入时,能不能在几分钟内看懂它为什么走到这里。
这些问题如果答不上来,1M 窗口只是把故障现场推迟了。
官方已经给出了 SGLang 部署方案,也提供 OpenAI 兼容接口、工具调用解析器和推理解析器。接下来真正值得社区测的,不只是把标准跑分再跑一遍,而是几类长任务的运行曲线。上下文从 64K、256K 拉到 1M 后,首 token 延迟怎么变,单任务 KV 占用怎么变,缓存命中率怎么变,20 回合工具调用的完成率和总成本怎么变。
还有一条必须钉在测试报告上。
官方那组 163 名内部专家、203 个工程任务的盲测很有参考价值,Hy4 preview 的均分略高于 GLM 5.3 和 Kimi K3。但它仍是腾讯内部任务与内部评分,公开、可复现的长程 Agent 基准还得继续补。preview 三个字不是装饰,模型团队自己也承认预训练、后训练和复杂任务行为仍有提升空间。
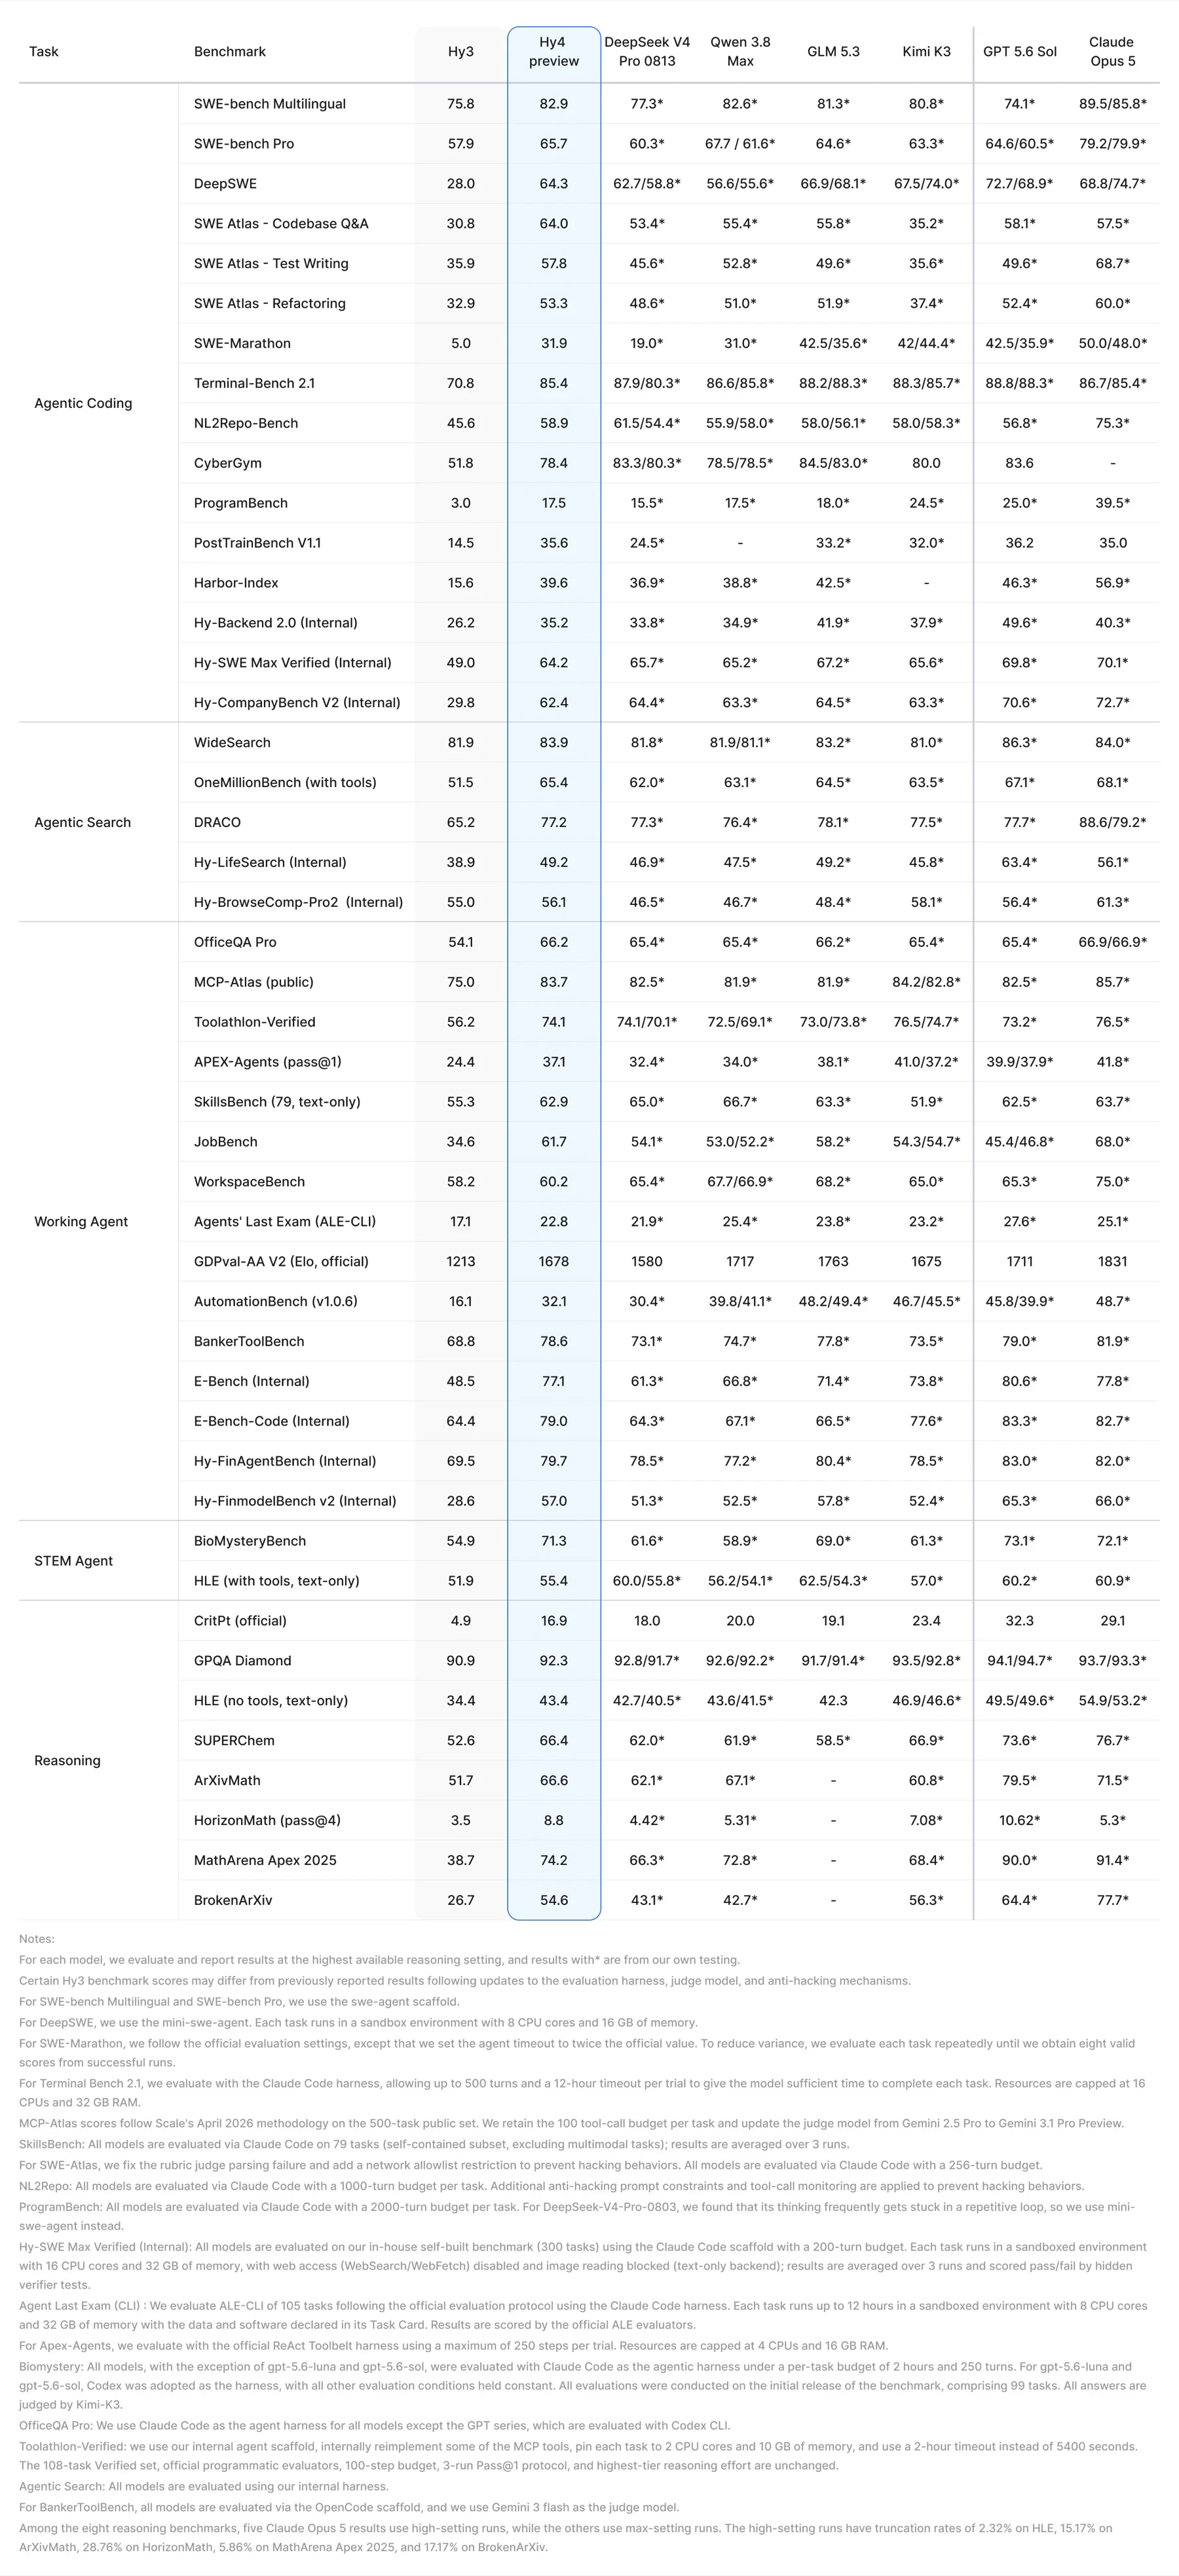
图,官方附录同时列出公开与内部基准,带星号成绩由腾讯复测,内部任务并非第三方可复现。来源,腾讯混元。
坦率讲,这种坦白反而让我更愿意认真看它。
Hy4 preview 把开源模型的窗口推到 1M,也把一个老问题摆到了台面上。过去我们总担心上下文装不下,现在更该担心装得下以后,团队失去了整理信息的动力。
仓库可以很大,工位上不该堆满全部档案。
让模型随时能找到它需要的那一份,比让它永远背着所有东西,更接近一个真正能长期工作的 Agent。