posts/imdb-sentiment-evaluation-chain.md
LoRA 不是小数据项目的第一步,TF-IDF 才是
一份情感分析教程,塞进了 TF-IDF、逻辑回归、DistilBERT、LoRA、概率校准、遮挡解释和半监督学习。
好家伙,像是把机器学习工具箱整盒倒在了桌上。
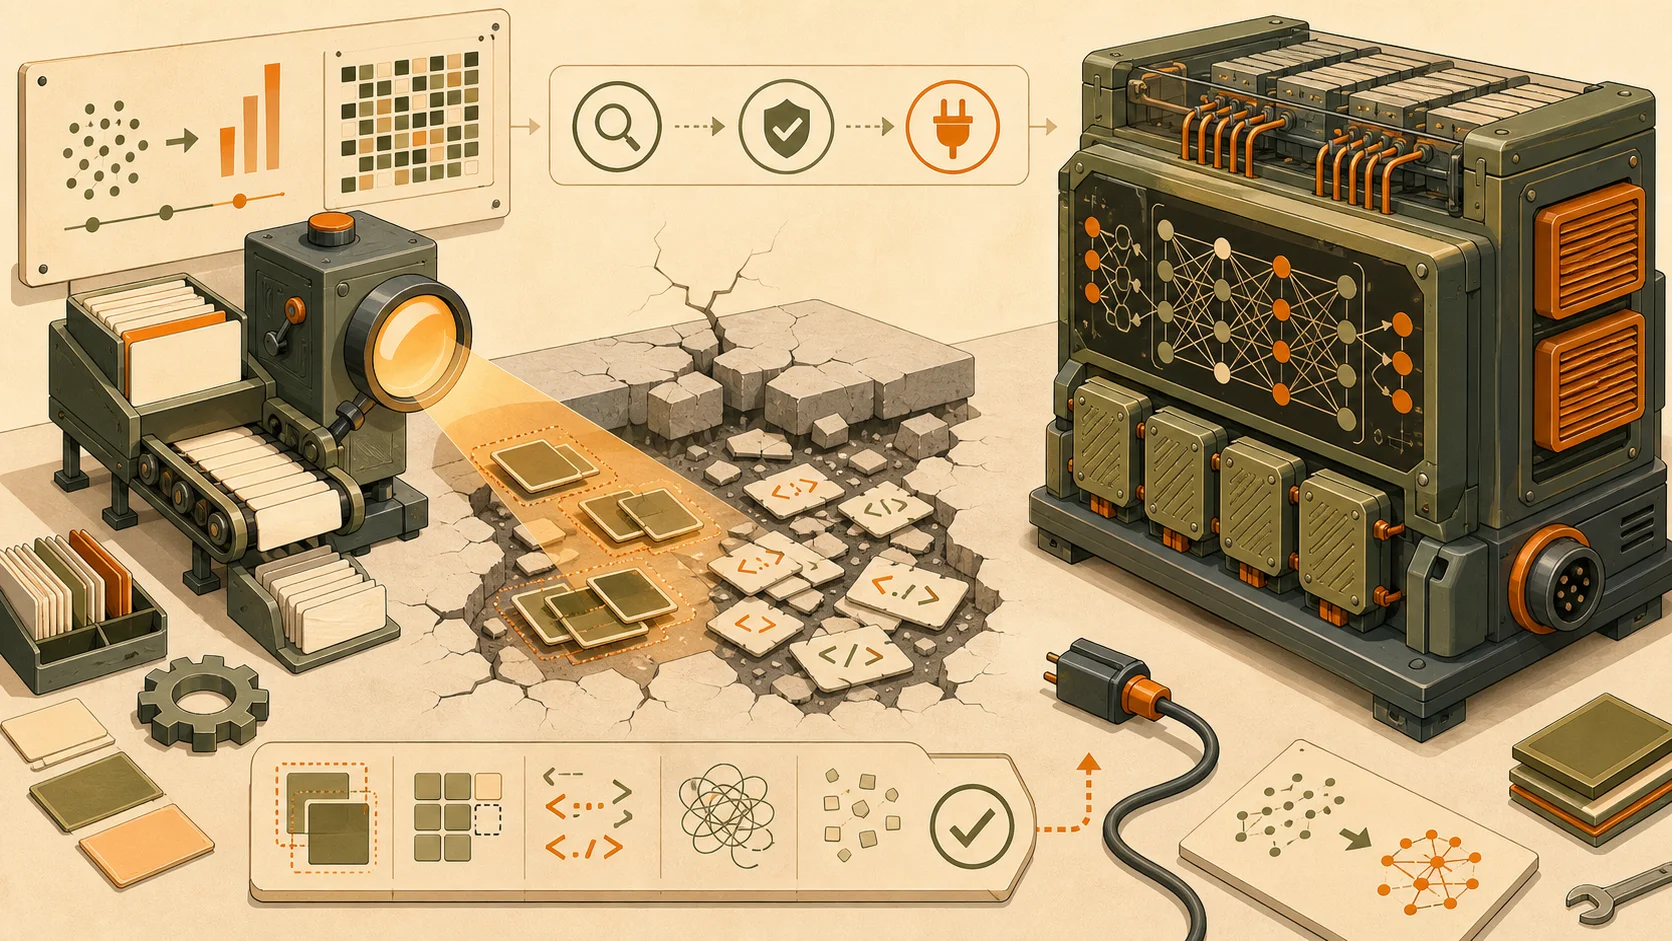
可我顺着它的代码看下去,最想聊的反而不是 LoRA。真正有分量的设计,是作者在启动 GPU 之前,先跑了一个 TF-IDF 加逻辑回归的基线。
这一步不新,也不性感。放在今天的技术文章里,甚至显得有点老派。
但很多小数据项目,缺的正是这块老派的地基。
这份 IMDb 教程公开了完整代码。轻量配置取 5000 条训练评论、2000 条测试评论,用 distilbert-base-uncased 跑两轮 LoRA 微调,最大输入长度设为 256 token,另取 3000 条未标注评论做伪标签实验。
有件事得先说在前面。原文展示的是实验设计和代码,没有贴出一次实际运行的指标输出。所以这篇不讨论 LoRA 到底比 TF-IDF 高了几个点,也不会替一段没跑过的 notebook 发明成绩单。
我们只看一件更有复用价值的东西。
一个模型到底要交出哪些证据,才配从实验本走进生产环境。
先让最便宜的方案站住
情感分类很容易把人带进一种错觉。既然 BERT 类模型理解上下文,LoRA 又能用很少的可训练参数完成微调,那就直接上呗。
听着挺顺。
问题是,模型越复杂,失败原因越容易搅成一团。数据抽样错了、训练集和测试集重复了、阈值不合适、文本被截断了,到头来都可能表现成同一句话,准确率不够高。
你把整套 Transformer 训练链路先架起来,等到指标不对,再去猜是数据、参数、代码还是任务定义的问题,排查成本会迅速膨胀。依赖版本、显存、混合精度、tokenizer、动态 padding,随便哪一处冒烟,都能把一个本来很朴素的分类任务拖进环境配置地狱。
TF-IDF 加逻辑回归的价值,不是它永远比 Transformer 好。它是一个便宜得足以反复重跑的参照物。
在 CPU 上先把数据切分、清洗、特征和评测跑通,你很快就能回答几件要命的问题。标签有没有颠倒,正负样本是否失衡,训练集和测试集有没有泄漏,HTML 残留是不是被当成特征,任务是否真的需要理解复杂语义。
scikit-learn 的文本分类教程里一直保留着这条经典路线。词频特征接线性分类器,看着朴素,却有两个很实用的优点。训练快,特征权重还能直接翻出来看。
如果模型认为 waste of、poorly acted 这类词组强烈指向负面,至少人能看懂它在靠什么判断。要是权重榜里冒出网页模板、评分字段或者数据源标记,你会立刻知道,模型学到的可能不是电影情绪,而是数据管道留下的脚印。
坦率讲,没有基线的复杂模型,只是在跟昨天的自己比赛。
准确率涨了,看起来棒棒的。可它比一个十分钟能训练完的线性模型强多少,为这点增益多花了多少训练与推理成本,没人知道。
这不是工程决策,只是模型展示。
LoRA 省的是训练参数,不是验证责任
LoRA 有点子牛逼的地方,确实是不用把整个基础模型都更新一遍。它把低秩矩阵插进指定层,只训练一小部分新增参数,基础权重大体保持冻结。
Hugging Face PEFT 的官方说明把几个关键旋钮写得很清楚,r 决定低秩矩阵的容量,target_modules 决定适配器挂在哪些层,lora_alpha 控制缩放,modules_to_save 则负责分类头这类需要随任务一起训练和保存的模块。
IMDb 教程把适配器挂到 DistilBERT 注意力层的 q_lin 和 v_lin,采用 r=16、lora_alpha=32,同时保留分类头。这套配置可以跑,不代表换一个模型名字也能原样照搬。
不同架构的层名并不一样。PEFT 文档专门提醒,未知架构需要显式指定目标模块,并用 print_trainable_parameters() 和目标层清单检查适配器到底挂到了哪里。代码没报错,不等于你训练了自己以为的那些层。
厉害了,日志跑了两小时,才发现可训练参数比例不对。这样的事故不热闹,却比排行榜上的零点几个分更接近真实工作。
LoRA 还没有消掉推理成本。你依然要加载 DistilBERT,要分词,要处理 256 token 的长度上限,要维护模型与 tokenizer 的版本,还要决定部署时保留适配器还是合并权重。
所以我始终觉得,LoRA 应该是一笔有验收条款的投资。
它至少要在同一份隔离测试集上赢过基线。最好不只赢准确率,还能在少数类、长文本、困难样本和推理延迟上交出解释。否则你得到的只是更复杂的依赖树,以及一张看起来很现代的架构图。
准确率高,不代表那个 0.95 能信
这份教程比较聪明的一块,是没有停在 accuracy 和 ROC-AUC。它还遍历分类阈值,计算 Expected Calibration Error,也就是预期校准误差,并绘制可靠性曲线。
校准听着有点学术,用人话讲就是,模型说自己有九成把握时,类似预测是不是真的大约九成正确。
这和分类对不对不是同一个问题。
一个模型可以把正负样本排得不错,ROC-AUC 很好看,却习惯把 0.65 的把握喊成 0.99。单看最终类别,你可能察觉不到。等它接到自动审核、工单分流、退款判断或风险提醒里,置信度就会直接影响业务动作。
假设系统把大于 0.95 的评论自动处理,把 0.6 到 0.95 的送人工。未经校准的 0.95 只是一串很有气势的小数,并不天然等于安全边界。
scikit-learn 的概率校准指南讲得很明确,分类概率需要用独立数据检查,校准模型本身也不能偷看训练它的那批样本。否则那条看起来很平滑的可靠性曲线,可能只是又一次过拟合。
怎么说呢,很多项目喜欢讨论模型会不会答错,却很少讨论它会不会自信地答错。后者往往更贵。
教程还专门抓取高置信错误样本。这一步很值得保留,因为平均指标会把最危险的角落磨平。两千条测试数据里错一百条,表格只会告诉你错误率。把其中最自信的三条翻出来,才可能看到讽刺句、否定转折、引用他人观点,或者标签本身就含糊。
错误率告诉你模型会错,高置信错误告诉你它会怎么害你。
256 token 截掉的,可能正好是结论
Stanford IMDb 数据集有 2.5 万条训练评论、2.5 万条测试评论,还有一批未标注数据。评论长短差异很大,长评论经常先铺剧情,结尾才给总评。
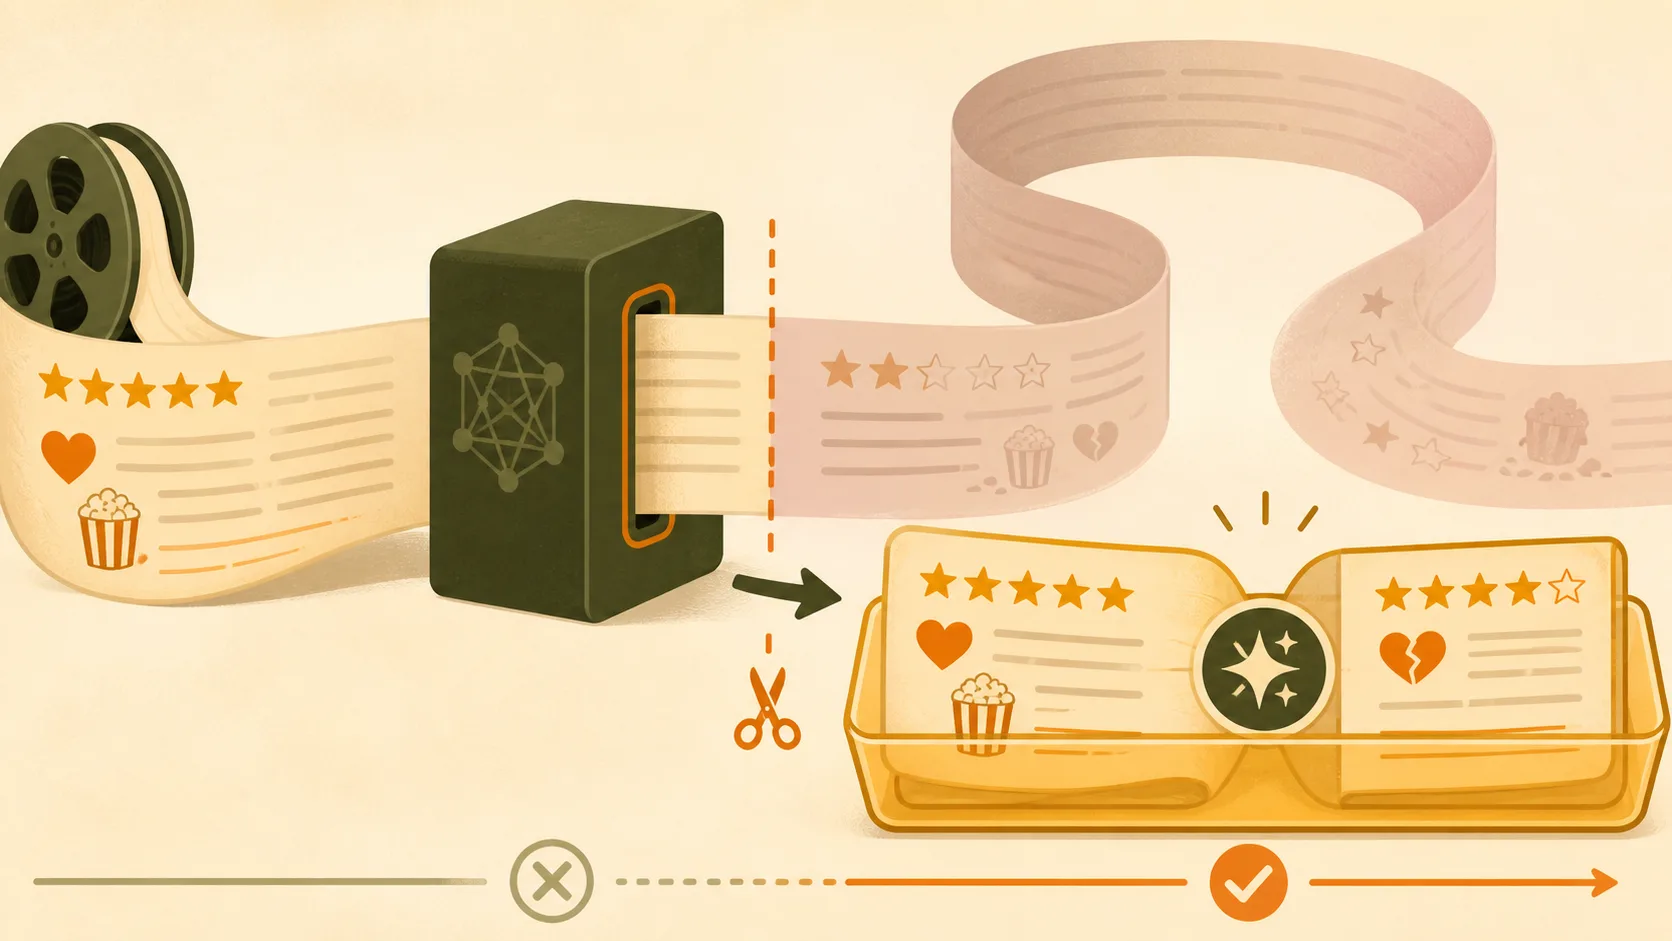
教程把 DistilBERT 输入上限设为 256 token。这个配置省显存、跑得快,也埋下一颗很具体的雷。
默认从尾部截断时,模型留下的可能是一大段剧情复述,把末尾那句 I would not recommend it 切没了。模型不是没理解否定,它压根没看到结论。
原文没有用一句长文本表现差来糊弄过去。它把样本按长度分桶,再拿最长的 600 条评论做了一个很朴素的对照,分别只保留开头 180 词和结尾 180 词,看哪一端更有信息。
这类小实验很对我的胃口。因为它不急着换更大的模型,而是先验证失败来自哪里。
如果尾部明显更有效,可以把开头和结尾拼起来。要是两边都需要,再考虑提高 MAX_LEN 或换更长上下文模型。若短文本也同样差,那就别怪截断,回头查标签、领域差异和任务定义。
你想想看,这就是基线和错误切片的共同作用。它们把一句模型不行,拆成能动手修的故障位置。
教程还做了逐词遮挡。每次删除一个词,观察正面概率怎么变化,用来估计哪些词把预测推向正面或负面。这不等于完整的因果解释,却足以发现模型是否过度依赖几个强情绪词,忽略了前后的反讽和转折。
真正能上线的解释,从来不是给模型配一张漂亮热力图。它得帮工程师决定下一步改数据、改截断、改阈值,还是改模型。
伪标签不是免费数据,是带利息的判断
收尾那段半监督实验也很有代表性。
作者让微调后的 DistilBERT 给 3000 条未标注评论打分,只保留大于 0.95 或小于 0.05 的样本,把预测结果当成伪标签,再塞回 TF-IDF 训练集。
表面看,这像是让强模型替便宜模型批改作业。未标注数据不用人工逐条看,训练集还能变大。
问题又绕回了校准。
如果教师模型的 0.95 根本不可靠,筛选阈值再高也没用。它最自信的偏见会被批量复制给学生模型。数据量变大了,错误也穿上了制服,看起来更整齐而已。
原教程自己写了一句很重要的提醒,伪标签的收益受教师模型上限约束,自训练还会放大教师偏差,必须在干净、隔离的数据上验证。
我会再往前多走一步。除了看整体准确率,还要看被选中的伪标签有多少、正负比例有没有偏、加入伪标签后哪些长度和语气的样本变好了,哪些变差了。随机抽一小批做人工复核,也比完全相信 0.95 更踏实。
半监督学习最容易制造一种繁荣感,样本从 5000 涨到 7000,训练日志更长,指标也许还涨了一点。
可如果新增的 2000 条都来自模型最熟悉、最容易的表达,真正困难的讽刺、长文本和含糊评价一条没补,数据集只是变胖,没有变聪明。
真拿去做项目,我会按这个顺序验收
先冻结测试集。它从第一次比较开始就只负责验收,不能拿来挑阈值、调 LoRA 参数或筛伪标签。阈值和概率校准另留验证集,别让测试集一边当裁判,一边给选手递答案。
然后审计数据。标签顺序、类别比例、重复泄漏、清洗残留、长度分布和业务时间切分,能查的先查。数据有问题时,越强的模型往往学得越快,翻车也越自信。
接着跑 TF-IDF 基线,记录训练时间、模型大小、推理延迟、macro-F1、ROC-AUC 和概率表现。把最重要的 n-gram 权重翻出来看,确认它没抄数据管道的近道。
LoRA 上场后,只允许在同一套数据协议下比较。除了总体指标,把短文本、长文本、否定句、讽刺句和高置信错误分别切出来。增益如果只出现在容易样本上,生产价值可能很有限。
等这些都站稳,才轮到伪标签。先校准教师,再定置信阈值,抽样复核,重新训练,回到那份从未被污染的测试集。复杂度每加一层,都得留下可回退的版本和一张成本账单。
完整 notebook已经把主要代码串好了,适合拿来当实验脚手架。真跑时,建议先保留轻量配置,确认整条链路能复现,再切到完整的 2.5 万训练集。别一上来就让 T4 跑四十分钟,最后才发现抽样前忘了 shuffle。
其实吧,这篇教程最值得拿走的并不是某组 LoRA 参数。
而是一种很克制的顺序。
先用便宜模型把问题照亮,再让复杂模型为每一分增益付证据。检查它的概率,翻它最自信的错误,追问它截掉了什么,再考虑让它给更多数据贴标签。
模型可以越来越新,验收方法最好别跟着失忆。
GPU 先别急着开。让 TF-IDF 把地基照一遍。