posts/inkling-small-deployment.md
276B 叫 Small,最低还要 180GB 显存
2760 亿参数,名字叫 Small。
好家伙,大模型公司对「小」的理解,已经和普通人的显卡彻底失去联系了。
7 月 30 日,Thinking Machines Lab 正式发布 Inkling-Small。它是一个开放权重的 MoE 模型,MoE 就是混合专家架构,每次处理一个 token,只叫醒一小部分专家干活。Inkling-Small 总共有 276B 参数,真正参与一次前向计算的是 12B。相比 975B 总参数、41B 激活的 Inkling,它的体量大约缩到四分之一,官方托管输出价格也从每百万 token 4.05 美元降到 1.20 美元。
听起来很顺,参数少了,计算少了,价格也少了。官方公布的编码和推理跑分还反超了大哥,简直是一张「小而美」标准答案。
但你只要往官方模型卡再翻半页,会看到另一组很不 Small 的数字。
BF16 版本至少需要 600GB 聚合显存。NVFP4 量化版至少需要 180GB。官方给出的起步配置,是 4 张 NVIDIA B300、8 张 H200,或者用量化版本塞进 1 张 B300、2 张 H200。
不是哥们,180GB 只是最低门槛。
这组反差特别适合把一个常见误会说透。MoE 的激活参数决定你每一步大概要算多少,总参数决定你开工前得把多少家底搬进机器。 两个数字都叫参数,却在回答完全不同的问题。
如果以后再看到一个模型写着 300B 总参数、20B 激活,先别急着脑补成「20B 模型性能,家用卡随便跑」。那很可能只是计算账单接近 20B,权重仓库仍然是 300B 那个级别。
Small 是算力标签,不是硬件尺寸
先把 MoE 想成一座有 256 个工位的维修中心。
每个请求进来,不会让 256 个人同时围上去。路由器判断这道题该交给谁,只派其中几组专家处理。Inkling-Small 的模型卡架构说明写得很明确,每个 token 会路由到 6 个专家,另外还有 2 个共享专家一直参与。
这就是 12B 激活参数省计算的来源。每次干活的人少了,矩阵乘法少了,吞吐和成本自然有机会降下来。
官方甚至把估算方法摆在公告里,单个任务的输出计算量,大致按激活参数乘生成 token 数来算。12B 对 41B,单看每个 token 的主干计算,前者只有后者的约 29%。官方输出单价恰好也下降约 70%。这两条线能对上,说明「小」先是一个服务成本标签。
厉害了,但维修中心不能只雇当天值班的那几个人。
下一个 token 可能需要另一组专家,下一条请求又会走不同路线。为了不让路由器每次点名后再从硬盘临时搬权重,部署时通常得把全部专家的权重放进可用显存,或者至少放在足够快的分层存储里。把专家卸载到内存、SSD 当然能省显存,代价是数据搬运会把延迟啃得很难看。
所以 12B 激活并不会把 276B 的权重文件魔法般缩成 12B。
粗算一下就明白。2760 亿参数用 BF16 保存,每个参数约 2 字节,裸权重已经接近 552GB。再加量化尺度、运行时缓冲区和框架开销,官方给出至少 600GB 聚合显存,很合理。换成 4 bit 量化,裸权重理论值约 138GB,但量化元数据、部分非 4 bit 权重和运行时空间还在,于是最低线落在 180GB。
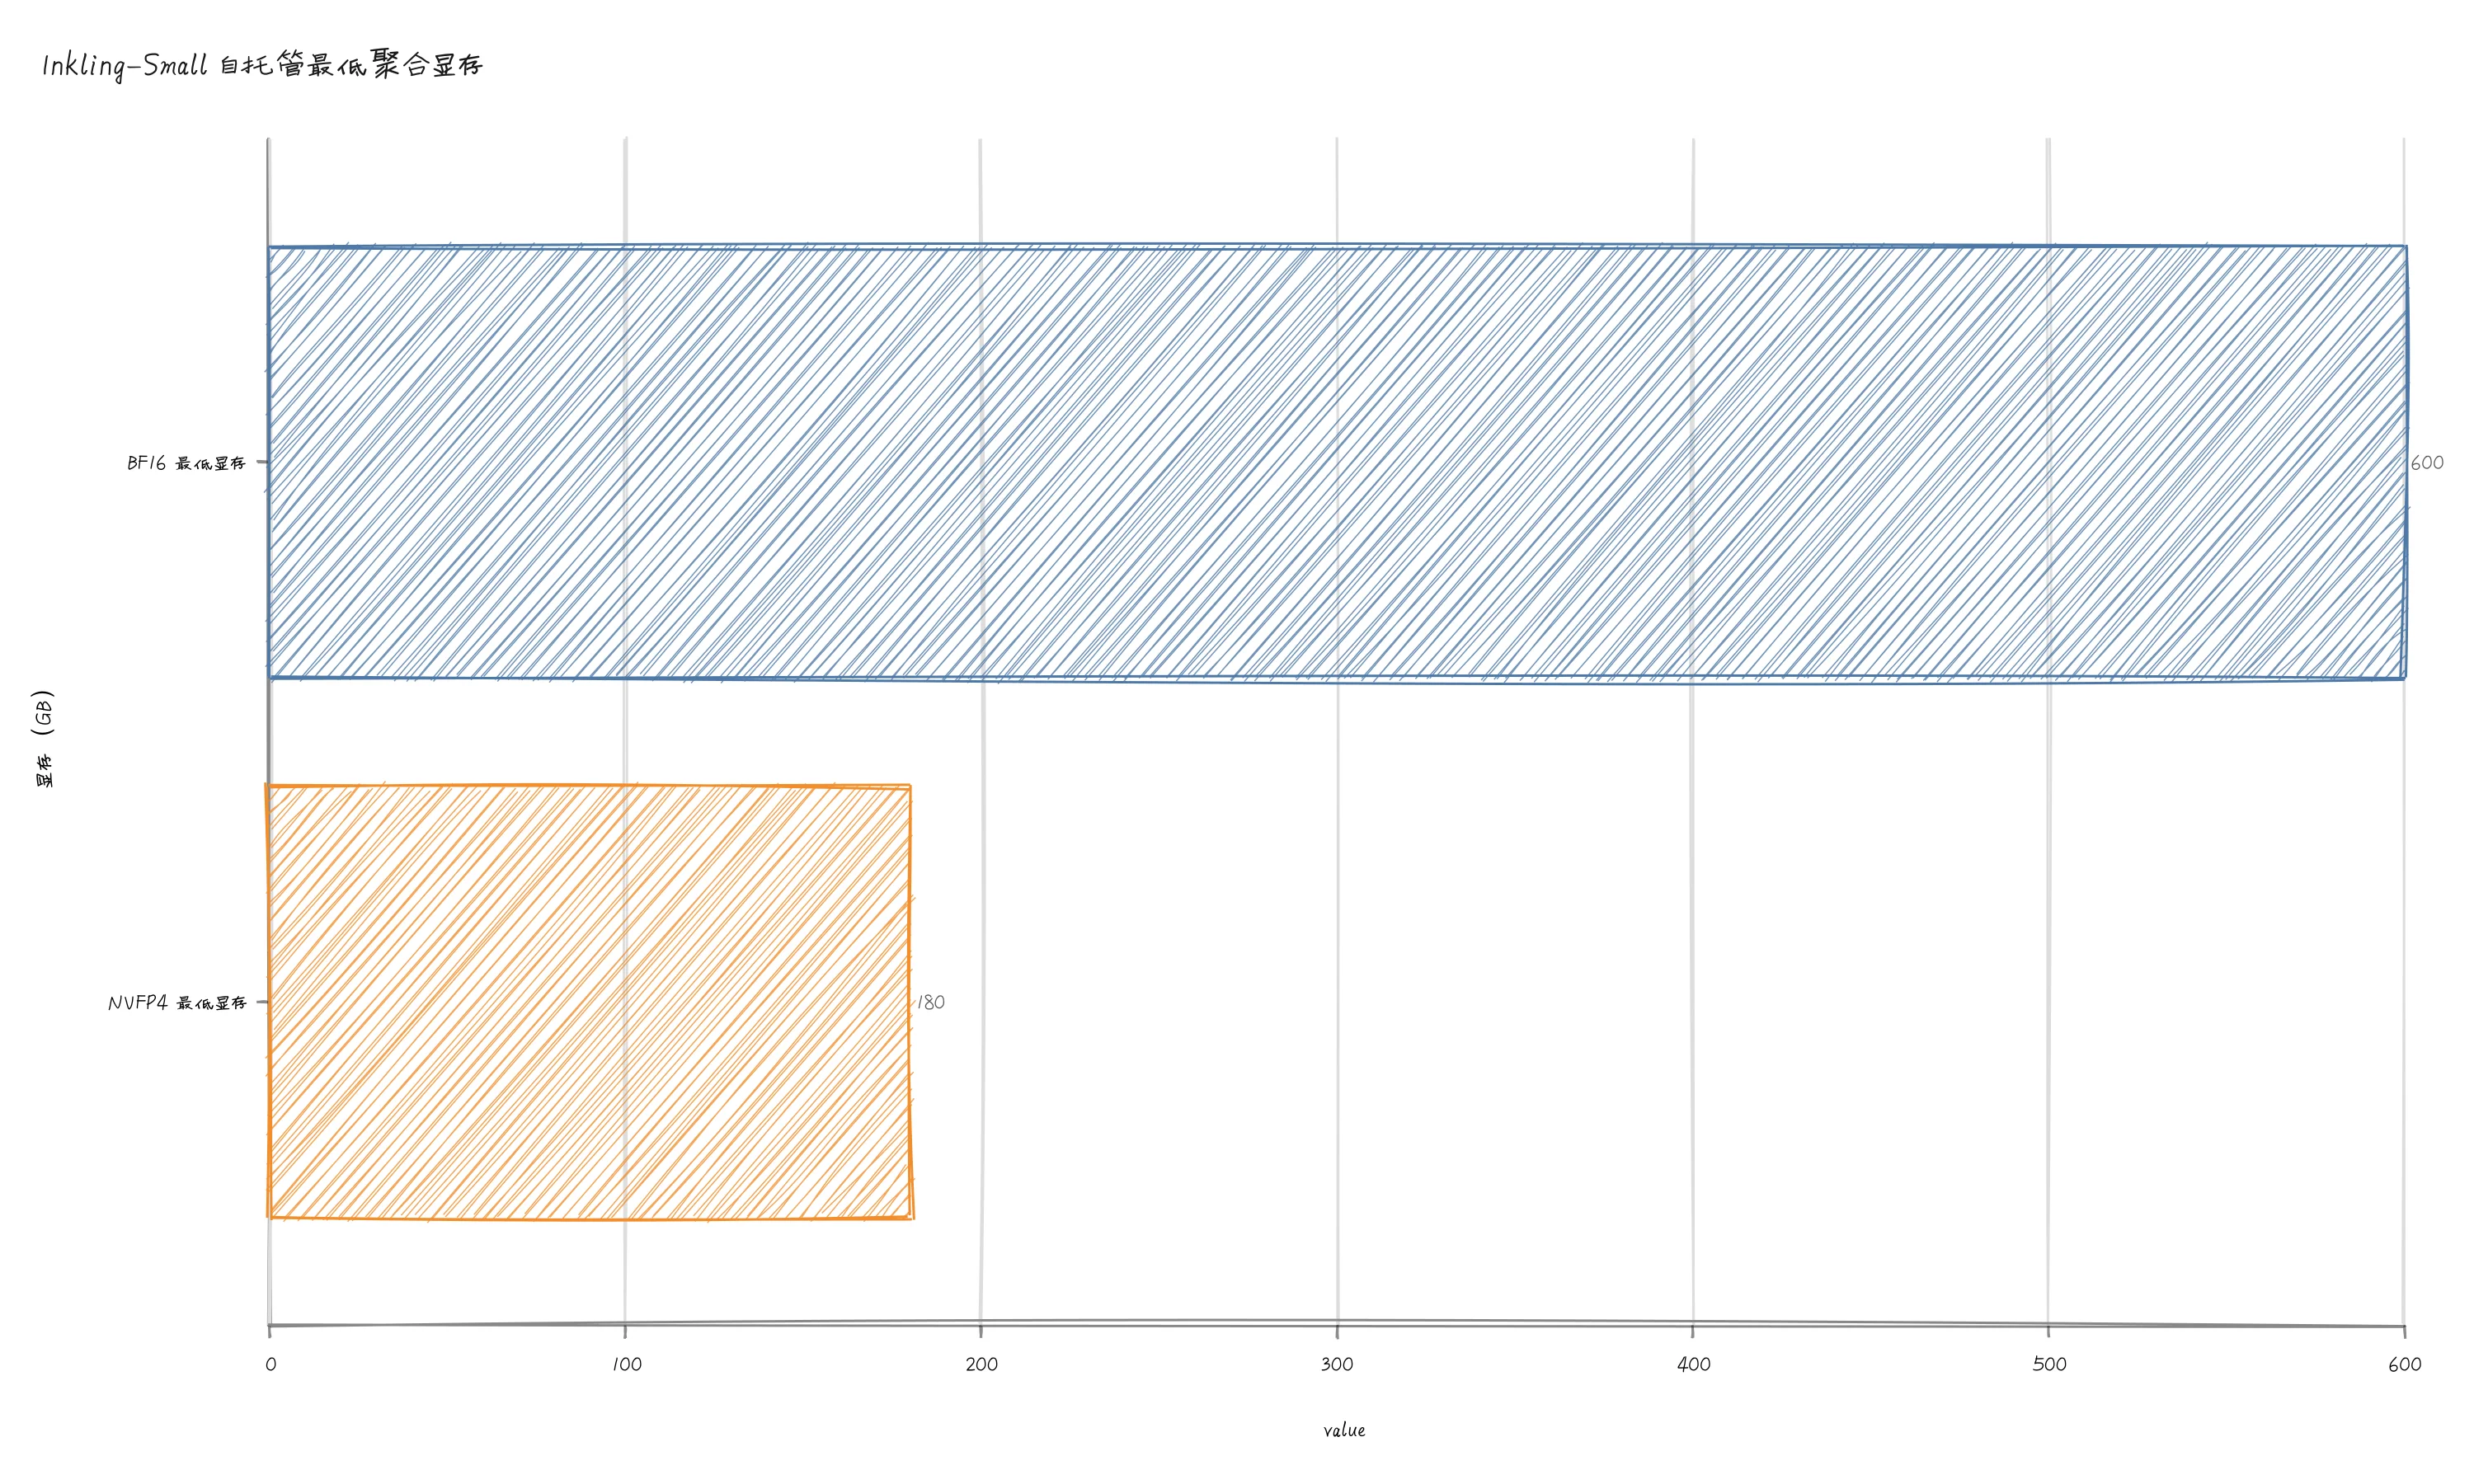
官方模型卡给出的最低聚合显存,量化后依然不是消费级显卡的尺寸。
这张图比「12B 激活」更接近自托管工程师第一眼该看的东西。前者告诉你跑起来以后每步多贵,后者告诉你有没有资格点下启动命令。
还有一本账常被宣传图省略,KV cache。它是模型为上下文保存的注意力缓存,会随着上下文长度、并发请求数和批大小一起长。Inkling-Small 支持最高 100 万 token 上下文,能力很诱人,但把窗口开大不是免费午餐。权重刚装下,不代表还能留出足够空间扛长上下文和并发。
所以部署判断至少要分三层。
每个 token 算多少,看激活参数。权重能不能装下,看总参数乘精度。服务能扛多少请求,再看 KV cache、上下文与并发。
把这三句话记住,能躲开一大半 MoE 发布稿里的数字烟雾。
跑分反超,不等于全面替代
Inkling-Small 真正有点子牛逼的地方,不只是激活参数变少,而是训练得更晚。
官方公告说,团队调整了预训练数据配比和训练配方。早期检查点还做了 on-policy distillation,也就是让大模型 Inkling 当老师,小模型在自己真实生成的轨迹上继续学。之后团队又追加了两周智能体编码强化学习。
结果很漂亮。官方数据里,Inkling-Small 在 SWE-bench Verified 上拿到 80.2%,Inkling 是 77.6%。Terminal-Bench 2.1 最佳 harness 是 64.7% 对 63.8%。Humanity’s Last Exam 纯文本评测是 31.6% 对 29.7%。
更少的激活参数,反而在几项推理和编码任务上超过大模型。不是简单把大模型切薄,而是后训练配方把有限计算重新花到了更值钱的位置。
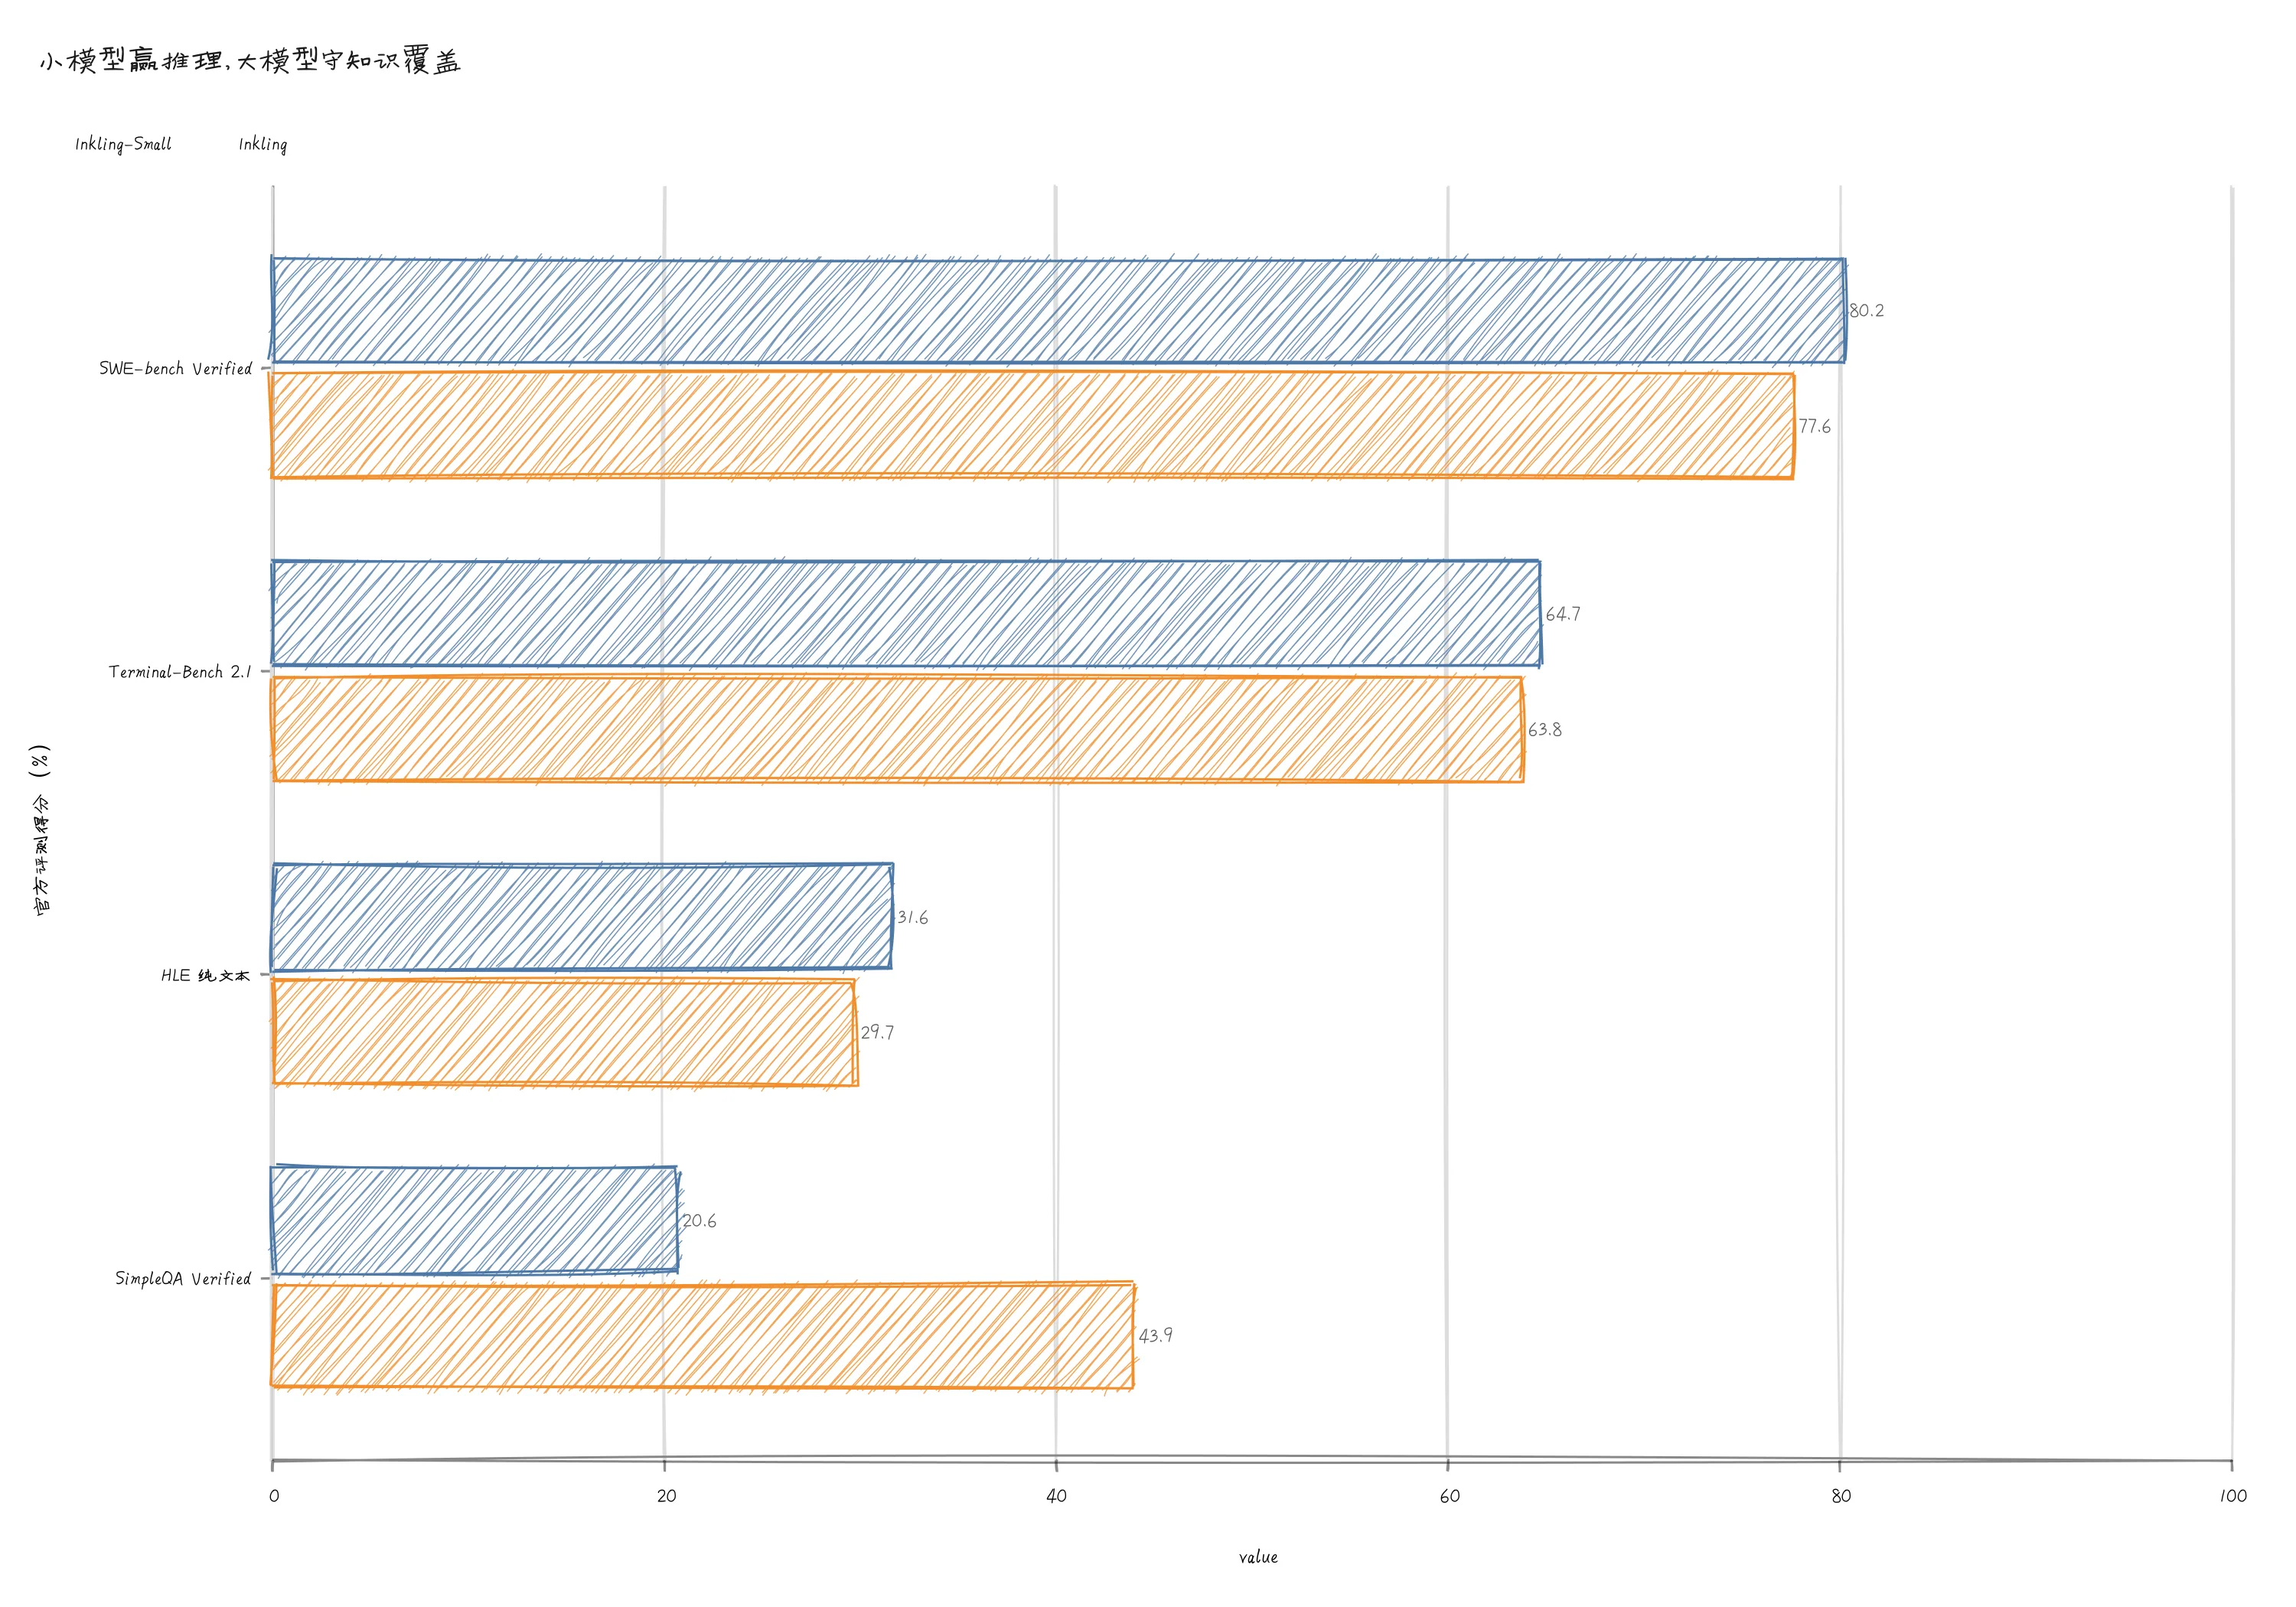
小模型在编码和推理项占优,但 SimpleQA 暴露了知识覆盖的明显代价。
图里最后一组才是我最想提醒的。SimpleQA Verified 上,Inkling-Small 只有 20.6%,Inkling 是 43.9%,差了一倍多。官方自己也承认,大模型在知识覆盖与事实性上仍有优势。
这非常合理。强化学习可以把一个模型训练得更会调用工具、更会在评测环境里完成任务、更愿意把推理预算花在刀刃上,但 276B 的参数仓库终究比 975B 小。会做题和记得多,从来不是同一根能力轴。
这也是看榜单时最容易翻车的地方。挑出四项反超指标,可以写成「四分之一参数打赢旗舰」。把全表摊开,你会发现它更像一次能力重新配平,编码与推理更划算,知识覆盖交了一笔不小的学费。
而且这些数字多数来自厂商自报,部分编码评测使用了各自 harness。Harness 可以理解成让模型真正干活的脚手架,包括提示词、工具、重试、上下文管理和提交答案的流程。不同脚手架会让同一个模型跑出不同成绩。官方也注明 Terminal-Bench 使用内部编码 harness,SWE-bench 使用 bash-only harness。
所以这张表适合看方向,不适合拿小数点后一位宣布胜负。
方向已经够清楚了。训练配方正在把单位计算量的能力往上推,但它还没有消灭容量、显存和知识覆盖之间的交换。
普通开发者真正该看哪张账单
如果你是 API 用户,Inkling-Small 的故事其实很简单。
去看官方价格页,看你的任务平均生成多少 token,看最大思考强度是不是每次都真有必要,再拿同一套评测集试延迟、正确率和失败重试次数。官方给出的输出价格是每百万 token 1.20 美元,约为 Inkling 的三成。对编码代理、批量评分和合成数据这种会吞大量输出 token 的任务,这个差距很实在。
这里最容易省错的,是只比较单次调用单价,不比较完成一次任务的总成本。便宜模型如果多跑三轮、多调用两次工具、最后还要大模型返工,账单可能并没有降。反过来,如果它在你的真实 harness 里一次过,即使排行榜只高两三分,生产价值也很大。
我的建议很朴素,把你自己的十到五十个真实任务冻成一个小评测集,固定工具、超时和验收规则,然后比较四个数,成功率、总输出 token、端到端时延、人工返工分钟数。别先争模型聪不聪明,先看它替你交付一件事要花多少。
如果你是自托管用户,顺序要反过来。
先打开官方 Hugging Face 权重页,确认 checkpoint 格式和文件大小。再看你的 GPU 拓扑、互联带宽和推理框架支持。Inkling-Small 支持 SGLang、vLLM、TokenSpeed、Unsloth 与 Hugging Face,框架选择不是装个包就结束,它会影响专家并行、量化路径、跨卡通信和实际吞吐。
然后才轮到跑分。
坦率讲,NVFP4 至少 180GB 显存已经替绝大多数个人开发者做完选择了。你可以折腾 CPU offload,可以拿统一内存硬扛,也可以把权重分层搬运做成一场硬件杂技。能跑和能用依然是两码事。首 token 等到人都忘了刚才问什么,这种本地自由多少带点行为艺术。
更现实的做法,是先用Tinker Playground或第三方 API 把任务适配性测明白。只有当数据不能离开内网、调用量大到硬件账能摊平,或者你确实需要深度微调时,自托管才进入下一轮计算。
这不是劝退本地部署。恰恰相反,是把本地部署从情绪选择变成工程选择。
我一直觉得,开放权重最珍贵的地方不是让每个人都把模型塞进书桌下面,而是让我们能检查模型卡、下载权重、换推理框架、做自己的评测,不必把厂商那张宣传图当唯一真相。Inkling-Small 用 Apache 2.0 放出完整权重,这件事值得肯定。
只是「开放」和「轻量」之间,还隔着 180GB 显存。
小模型的定义已经换了
以前说小模型,大家想到的是一张消费级显卡、一台笔记本,甚至一部手机。现在前沿 MoE 语境里的 Small,往往只是相对同系列旗舰更省计算、更低单价、更适合高吞吐工作负载。
它描述的是经济性,不一定描述可拥有性。
Inkling-Small 把这件事演示得很完整。12B 激活,让它的每 token 计算和 API 价格降到大模型约三成。276B 总参数,又把自托管门槛牢牢钉在数据中心级别。后训练让它在编码和推理上反超旗舰,知识覆盖的短板则提醒我们,配方优化没有凭空创造容量。
以后看到 MoE 模型发布,我会先找三行字,激活参数、总参数、最低显存。跑分当然要看,但得排在这三行后面。
模型名字可以叫 Small,机房不会陪它演。