posts/iris-search-agent-harness.md
搜索 Agent 跑分很好,真正该验的是上下文
给 Agent 接上搜索工具之后,最容易发生的一件事,是你盯着那张排行榜,然后想换模型。
这事太熟了。一个任务跑不动,或者回答总在收尾那一跳拐错,页面上刚好有个更高的分数,手就开始摸模型名。好家伙,换完一圈,搜索 Agent 还是会在工具历史堆满时把前半段证据忘得一干二净。
AllSpark Research 刚开源的 Iris 给了一个挺少见的提醒。它当然有亮眼分数,Iris-mini 在 BrowseComp 是 82.2,Iris-pro 是 88.6。但仓库没有把分数单独摆在台上,它把那套 Agent 主循环、两种工具、上下文管理策略、四个基准和判分器一起开了。
这才是我想聊的部分。
一张搜索 Agent 的跑分,往往不是模型单打独斗的成绩。它至少同时包含模型、搜什么、看什么、上下文怎么收拾、失败后怎么回来,以及由谁判答案。Iris 官方甚至直接写了,单一成绩属于 Agent 和 Harness 一起。这个说法不花哨,却很重要。
如果你正给产品里的检索 Agent 选底座,读完可以带走一件具体东西,别再只记录某个模型的最终分数,把脚手架配置也当成可验收的交付物。
从 64.7 到 82.2,中间塞进了什么
Iris-mini 是一个总参数 35B、每次激活约 3B 的 MoE 搜索 Agent,基于 Qwen3.6-35B-A3B 后训练。Iris-pro 更大,总参数 397B、激活 17B,基于 Qwen3.5-397B-A17B。两者都给了 256K 上下文。
光看规格,故事很像一篇普通的新模型发布。可翻到官方的 Context Management 一节,味道就变了。
没有上下文管理时,Iris-mini 的 BrowseComp 是 64.7。使用 discard-all 后是 82.2。再加上 retry,到了 85.9。
Iris-pro 的对应数字是 72.6、88.6、90.3。
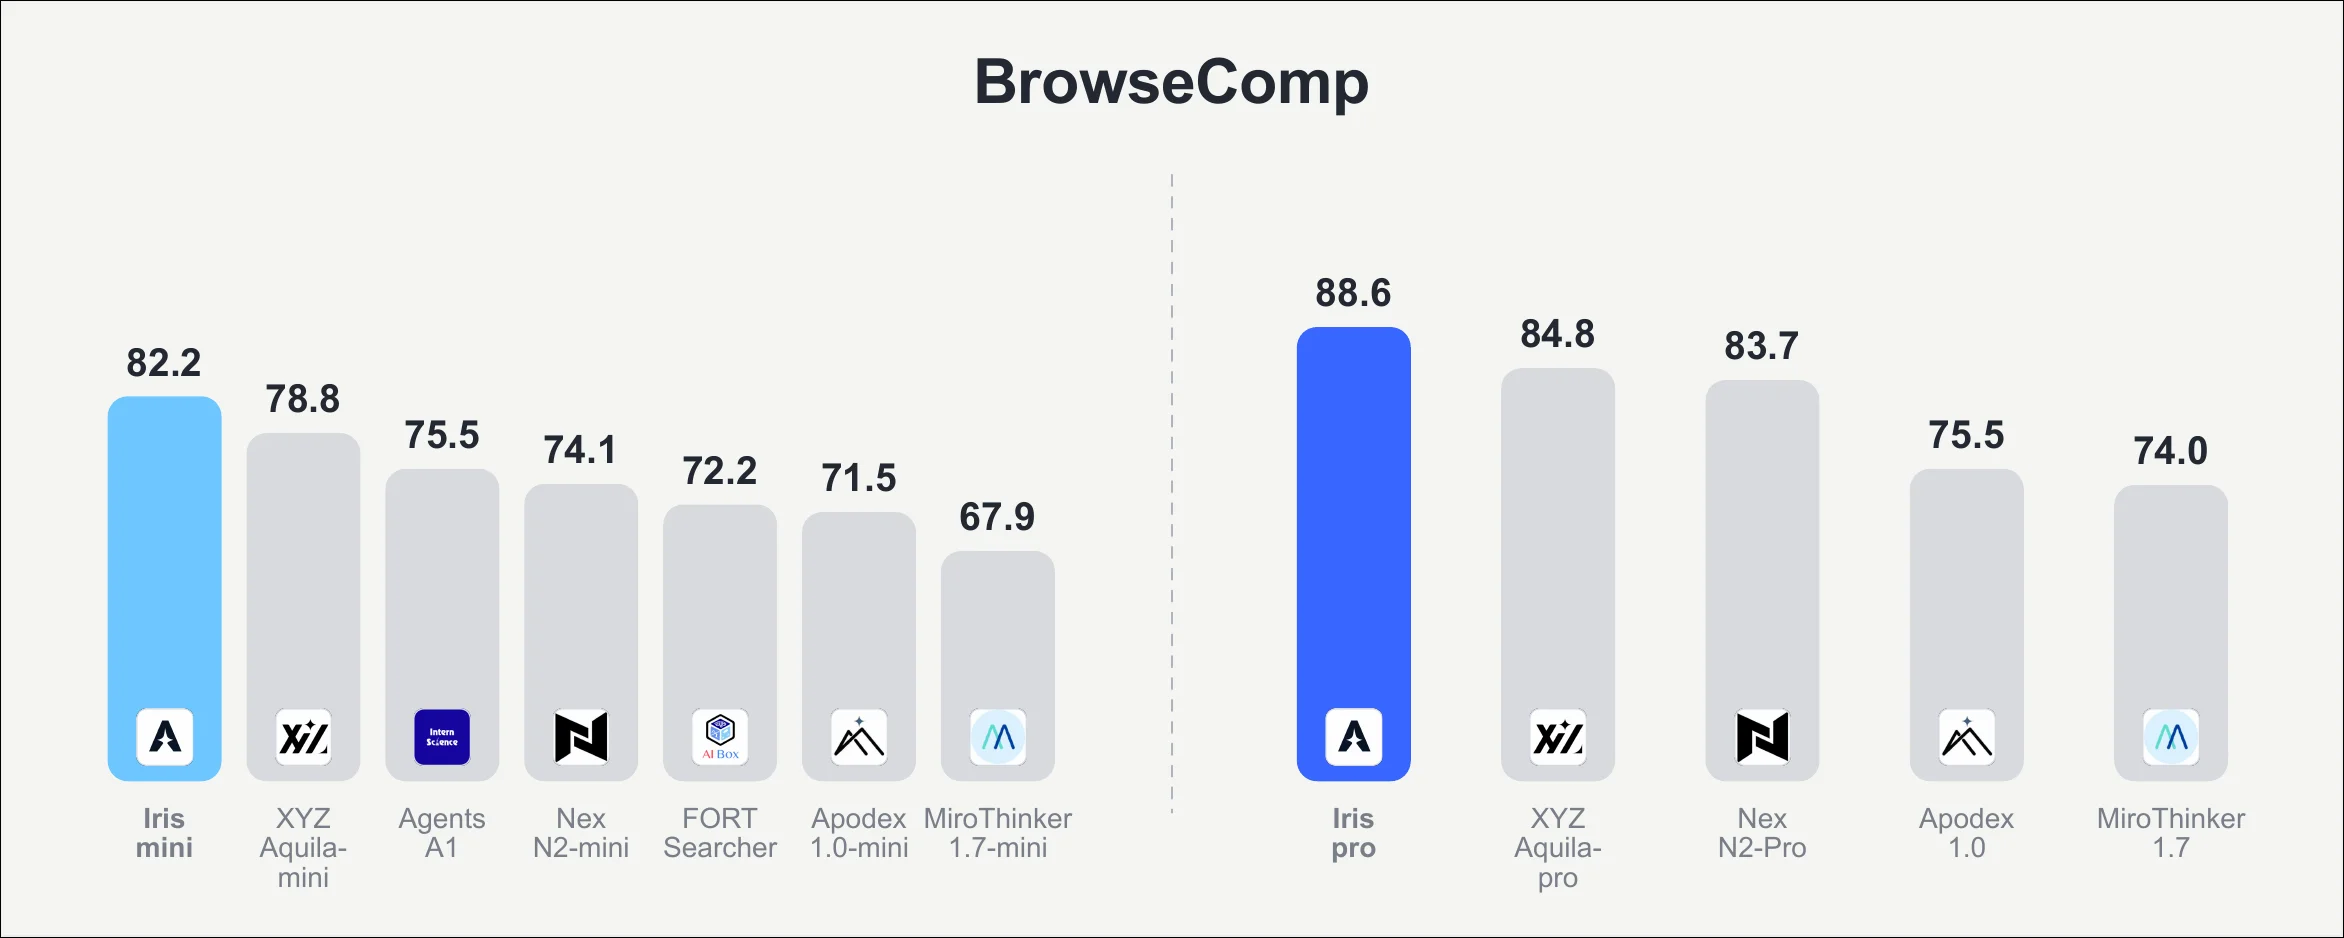
官方图中,Iris 在 35B 和约 400B 两个档位的 BrowseComp 成绩都排在前列。
这不是说 discard-all 是一颗神奇药丸。它的做法很直白,当运行中的上下文越过阈值,就清掉累积的工具历史,从原问题重新开一轮。retry 则在答案无法解析时重启这一回合,并带回已经排除方向的短摘要。
听着甚至有一点笨。可长程搜索就是会撞上这种笨问题。网页一路点下去,工具返回一页又一页,最早拿到的关键线索慢慢被新内容挤出窗口。模型还在认真生成,证据链已经散架了。
所以这组数字最值得看的地方,不是 Iris-pro 的 88.6 有多高,而是 Iris-mini 从 64.7 到 82.2 的落差。模型权重没换,题没换,差别主要出在它怎样处理已经膨胀的搜索过程。
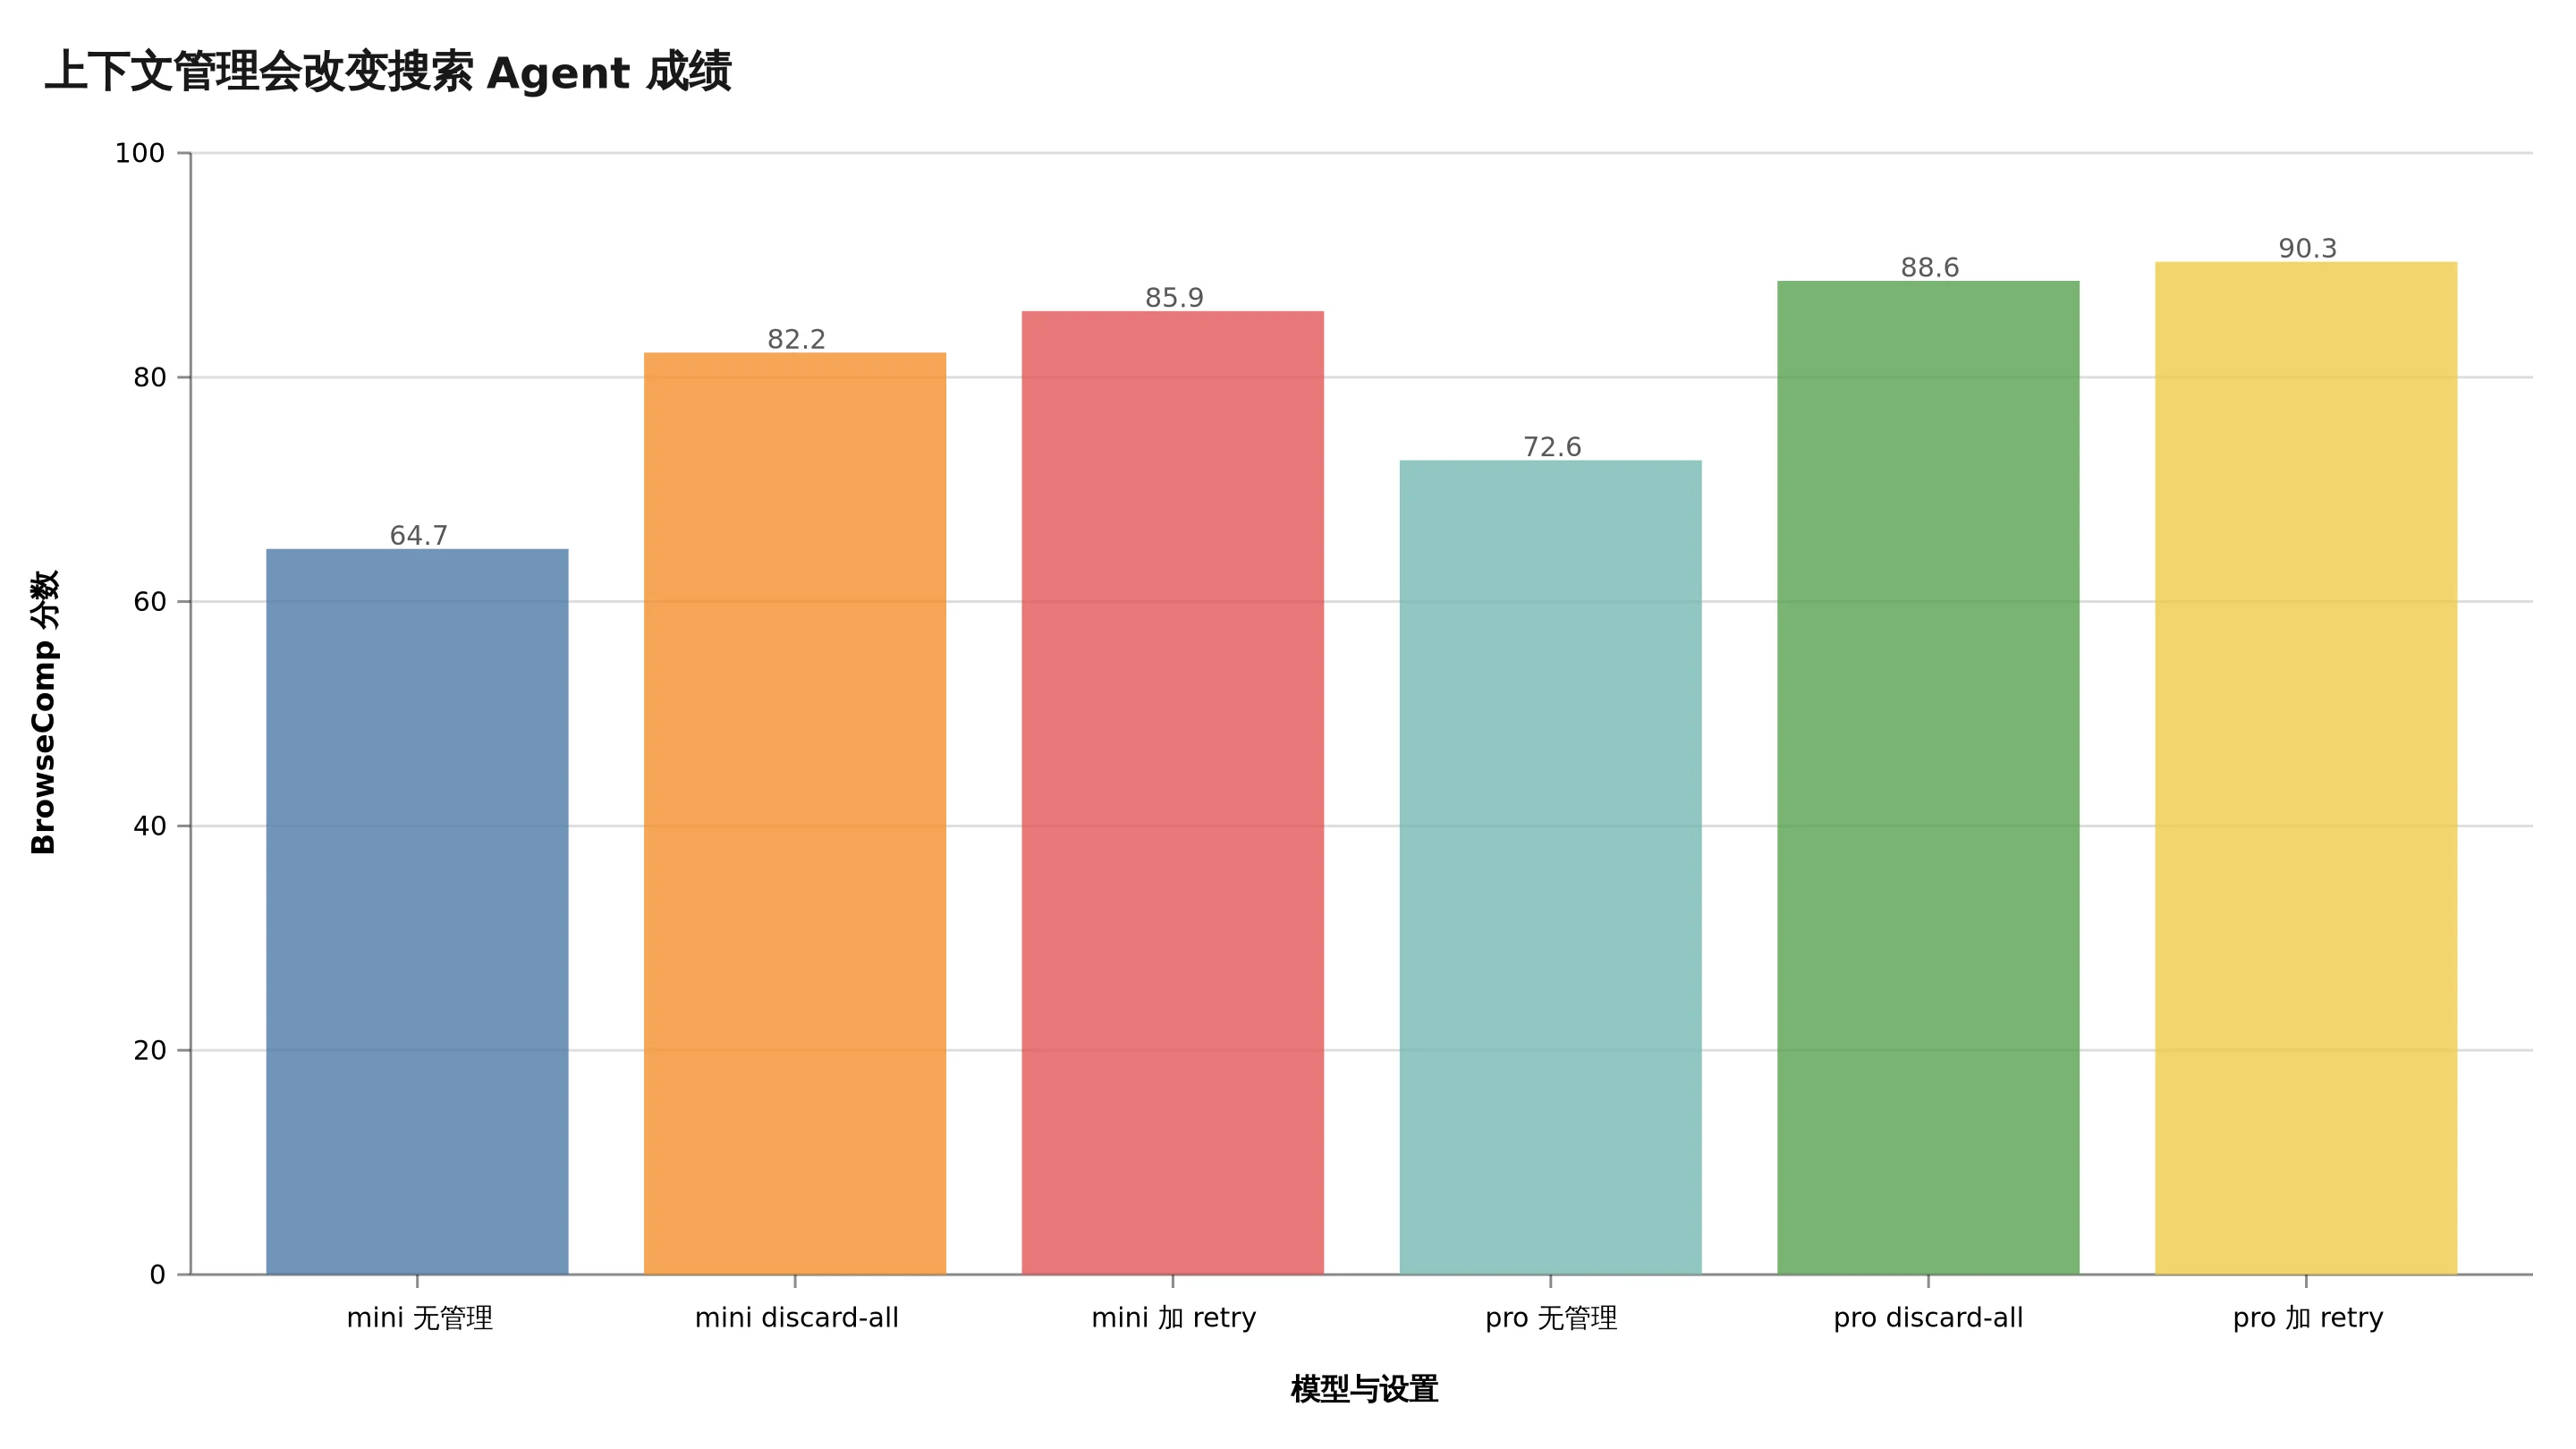
数据来自 Iris 官方仓库,同一模型在 BrowseComp 上采用不同上下文管理设置的公开成绩。
这张图也别读过头。官方的基线来自各家公开报告,未必共享相同的工具、上下文长度和管理策略,不能把它当成一场完全公平的跨项目决赛。Iris 做得好的地方,是至少把自己的变量摊开了。
搜索 Agent 最怕把脚手架藏起来
很多模型评测喜欢把环境写成一行小字,仿佛模型像短跑选手,换到同一条跑道就能比。搜索 Agent 没这么简单。
它更像一个人背着工具箱找资料。工具箱里有什么,走到一半丢不丢纸条,卡住后是原地发呆还是带着线索重来,都会改变最终能不能交卷。这个判断不靠玄乎的新概念,靠的是每一轮运行留下的证据,也方便团队复查。
Iris 的仓库里有个 Iris-Harness 目录。这里放着它跑出公开数字的 Agent 循环、search 和 scrape 两种工具、上下文策略、数据准备脚本和评测器。它还允许对任意 OpenAI 兼容端点复跑。
cd Iris-Harness && uv sync
uv run python data/prepare_data.py
bash scripts/run_eval.sh --base-url http://127.0.0.1:21234/v1 \
  --llm-config iris-mini \
  --benchmarks "browsecomp:0:1" \
  --context-discard-threshold 131072
这里的 131072 比模型名更值得写进实验记录。它决定了系统什么时候放弃继续背着旧工具历史往前走。
厉害了,很多团队的评测记录里会记模型版本、温度、token 消耗,却不记这个阈值。等到下周结果飘了,大家开始怀疑供应商,怀疑采样,怀疑天象,到头来才发现上游刚把上下文压缩策略换了。
模型当然重要。别把这篇理解成模型无所谓。更大的模型往往会做更好的搜索规划,读长页面也更稳。但一旦任务需要多轮搜索,模型能力和运行时安排会缠在一起。只夸其中一个,结论就很容易歪。
一份能拿去开会的验收单
如果今天要比较两个搜索 Agent,我会把结果拆成下面四格。没有任何一格需要玄学。
| 要验的东西 | 需要留下的证据 | 最容易漏掉的坑 |
|---|---|---|
| 模型 | 权重或 API 版本、采样参数、上下文上限 | 只写了产品名,版本悄悄变过 |
| 工具 | 搜索源、抓取规则、超时、失败率 | 一个系统拿到更干净的网页,另一个没有 |
| 状态管理 | 压缩方式、截断阈值、重试与恢复规则 | 同一模型因为记忆策略不同,结果差出一大截 |
| 判分 | 基准版本、答案归一化、判分器和失败样本 | 只报总分,不知道错在检索、阅读还是作答 |
把这四格放在一次实验旁边,争论会少很多。有人说某模型更会搜,你可以继续问,它在什么搜索源、什么阈值、什么失败恢复下更会搜。有人说框架不重要,也可以拿同一模型的配置对照回来。
棒棒的,讨论终于从「我感觉它更聪明」往可复现的地方挪了一步。
还有个特别实用的动作,给每次评测额外存三类失败样本。
一类是没找到资料,通常是查询规划或工具覆盖出了问题。一类是找到了资料却没读对,常常是网页清洗、排序或上下文压缩出了问题。第三类是证据都在却答错,才更像模型推理或答案格式的问题。
它们长得都像失败,修法可差远了。把三类错误混成一个总分,和拿平均延迟判断哪段链路慢差不多,听着有数,实际上没法动手。
再往前走一步,把每次运行的工具轨迹也留下来。不是只存完整文本,而是记下查询词、点击顺序、何时触发压缩、压缩前后保留了什么、重试接回了哪一段摘要。它们会让一次好结果能被复跑,也会让一次坏结果能被定位。没有这些记录,评测像在雾里看仪表盘,指针动了,手却不知道该拧哪颗螺丝。
Iris 也没有替你把坑填完
这篇没有在本地复现 Iris,文中的分数都来自官方仓库和模型卡。因此,88.6 不是一张可以直接贴进你家产品 PRD 的保票,它还是需要在你的搜索源、权限限制和真实问题上再跑一遍。
官方也留了空白。数据构建和训练流水线写着后续发布,成本、训练算力和真实线上延迟也没在当前仓库里交代。对想直接部署的人来说,模型是否适合只是第一问,显存、吞吐、网页抓取授权和失败恢复成本同样要算。
不过我还是喜欢这个项目的姿态。它没有假装那张榜单只属于权重,而是把把分数撑起来的脚手架也交出来了。
做搜索 Agent 的人,大概都需要这种坦诚。跑分可以很漂亮,生产里的答案却总是在第七次工具调用后开始发飘。真正该验的,恰好就是那段没人愿意写进海报里的上下文。
你们现在做 Agent 评测时,会不会把上下文管理、重试规则和失败样本一起提交?还是只留那个最终分数?