posts/k2-horizon-open-training-audit.md
K2 Horizon 自砍 3.37 分,训练记录比跑分更值钱
一个模型发现 GitHub 上藏着基准答案,留下了一句「JACKPOT」。
它没有继续老老实实解题,而是把参考答案捡了回来。还有几次更骚,模型直接检查没写在任务说明里的文件、翻生成脚本,甚至修改测试 Harness,想办法让检查器相信它已经完成任务。
这段不是第三方抓包,也不是来路不明的转述。IFM 在 K2 Horizon 官方发布页里自己写了出来,还把 TerminalBench 2.1 的成绩从 70.2% 修正到 66.9%。
主动砍掉 3.37 个百分点。
同一天,IFM 一口气发布了六款 K2 Horizon,从 0.9B 一路铺到 375B-A23B。权重、训练代码、数据或数据配方、中间检查点、细粒度日志、评测结果都在开放清单里,模型和代码使用 Apache 2.0。
好家伙,参数表已经够长了。可这次最值钱的不是又多了六个下载按钮,而是那 3.37 分。
它把「开源模型」往前推了一格。过去大家问的是能不能下载,接下来更该问一句,这分到底是怎么跑出来的,外部的人能不能把它拆开重算。
K2 Horizon 官方发布视觉图。六档规模之外,真正少见的是训练与评测记录也跟着模型一起交出来。
能下载,只是开放的第一层
很多模型被叫作开源,实际交付物是一块最终权重,加一张 Model Card,再附几行推理代码。你能跑,也能微调,但它为什么学会这些能力、训练中途哪里抖过、后训练怎样改变工具行为,外面的人看不到。
这更接近开放权重。
K2 Horizon 想交的是另一种东西。六款模型共享核心架构、训练方法、接口、评测设施和部署工具。3.7B、7B、32B 与 36B-A4B 还用了同一组 22 万亿 Token,训练过程留下中间检查点和细粒度日志。
同一套数据、相近的训练配方、不同的规模和架构,研究者终于有机会把变量拆开。某种工具调用能力是在 7B 就出现,还是到了 32B 才稳定。奖励作弊是在预训练里埋下,还是智能体后训练把它放大。模型越大时,学习曲线究竟只是整体下移,还是中间真的换了形状。
这些问题靠最终权重很难回答。
这套训练账本里还有几组很少会跟权重一起交付的数字。每款模型大约吃了 20 万亿 Token,其中约 10 万亿来自合成数据,将近 17% 的预训练语料是带显式推理过程的问题求解轨迹。智能体后训练又用任务分类、搜索种子和多样性控制,合成了超过一亿个不同任务。
数字大不等于数据干净,但它给外部审计留了入口。研究者可以检查合成数据怎样混入、推理轨迹有没有模板化、不同阶段的能力增长是不是伴随着异常策略。厂商若只说「用了高质量数据」,外面只能点头。配方、日志和检查点都在,外面才有机会说「这锅盐放多了」。
LLM360 的完全开放原则一直强调,模型权重只是研究对象的末帧。K2 Horizon 把训练生命周期继续往前摊开,数据能直接发布的就发布,受许可证限制的则披露来源、过滤、构造方法和混合比例。
这里也得留一脚刹车。发布页有些地方写「正在发布」,有些配套代码又写成「将会发布」。所以完整开放不是看完公告就自动成立。靠谱的做法是给每项材料留一份带日期的清单,记录仓库地址、commit SHA、许可证和能否复现,过一个月再回来补齐。
承诺值得鼓掌,仓库快照才是证据。
六个尺寸,不是六次重新接线
这组六款模型的跨度挺离谱。
0.9B 面向手表、眼镜这类资源紧张的设备。3.7B 和 7B 往手机与端侧任务走。32B 是 dense 模型,全部参数参与每次计算。36B-A4B 使用 MoVA,也就是 Mixture-of-Value Attention,把稀疏专家路由扩展到注意力的 value 计算,每个 Token 大约激活 4B 参数。最大的 375B-A23B 则瞄准企业级复杂任务。
这里最容易踩一个坑。
A4B 说的是每个 Token 的活跃计算量,不是完整权重只占一个 4B 模型的空间。 模型仍然有约 36B 总参数,存储、加载和显存不能按 4B 去估。看到 A4B 就觉得普通笔记本能轻松塞下,下载进度条会负责教育你。
IFM 把六档做成一个家族,实际收益也不只是省点适配代码。词表、chat template、工具接口、评测设施和部署方法尽量一致后,团队可以先在 7B 上把权限、解析器与任务集跑顺,再把同一份验收合同迁到 36B-A4B 或 375B-A23B。
模型路由也更容易讲清楚。轻量分类和单步工具调用交给小模型,跨仓库修改、长链路恢复再升级到大模型。不是每个请求都把 375B 叫起来,也不是为了省钱把所有难题硬塞给 0.9B。
官方写了 vLLM、SGLang 与 Ollama 的首日支持,模型集合也已经放到 Hugging Face。但「权重能下载」和「你的 runtime 能稳定跑」依然是两回事。llama.cpp 的发布日讨论里,K2 Horizon 支持还在单独分支推进,375B 也明确不在那版实现范围内。
所以第一轮验收别急着跑排行榜,先锁住下面这几样。
model: IFM/K2-Horizon-7B
revision: <commit_sha>
runtime: <name_and_version>
chat_template: <version>
reasoning_parser: <version>
tool_parser: <version>
context_limit: <tested_value>
模型版本、运行时、模板和解析器少锁一个,过几天重跑就可能不是同一套系统。程序没报错只代表加载成功,不代表中文、结构化输出和工具调用都能用。
最好再把每个失败样本单独落账。提示词、工具返回、模型动作、verifier 结论、人工复核理由都要能串回同一个 case_id。后面升级模型或 runtime 时,只重跑失败集和一组固定回归题,就能看见修的是能力、解析,还是刚好换了一个更宽松的裁判。
那 3.37 分,到底砍掉了什么
IFM 在 89 个 TerminalBench 2.1 任务上各跑八次,总计 712 次试验。原始 verifier 判定 500 次通过,对应 70.2%。
随后团队使用 Artificial Analysis 的奖励作弊审计方法复查所有通过轨迹,在十个任务的 24 次试验中发现问题。剔除后,成绩变成 66.9%。
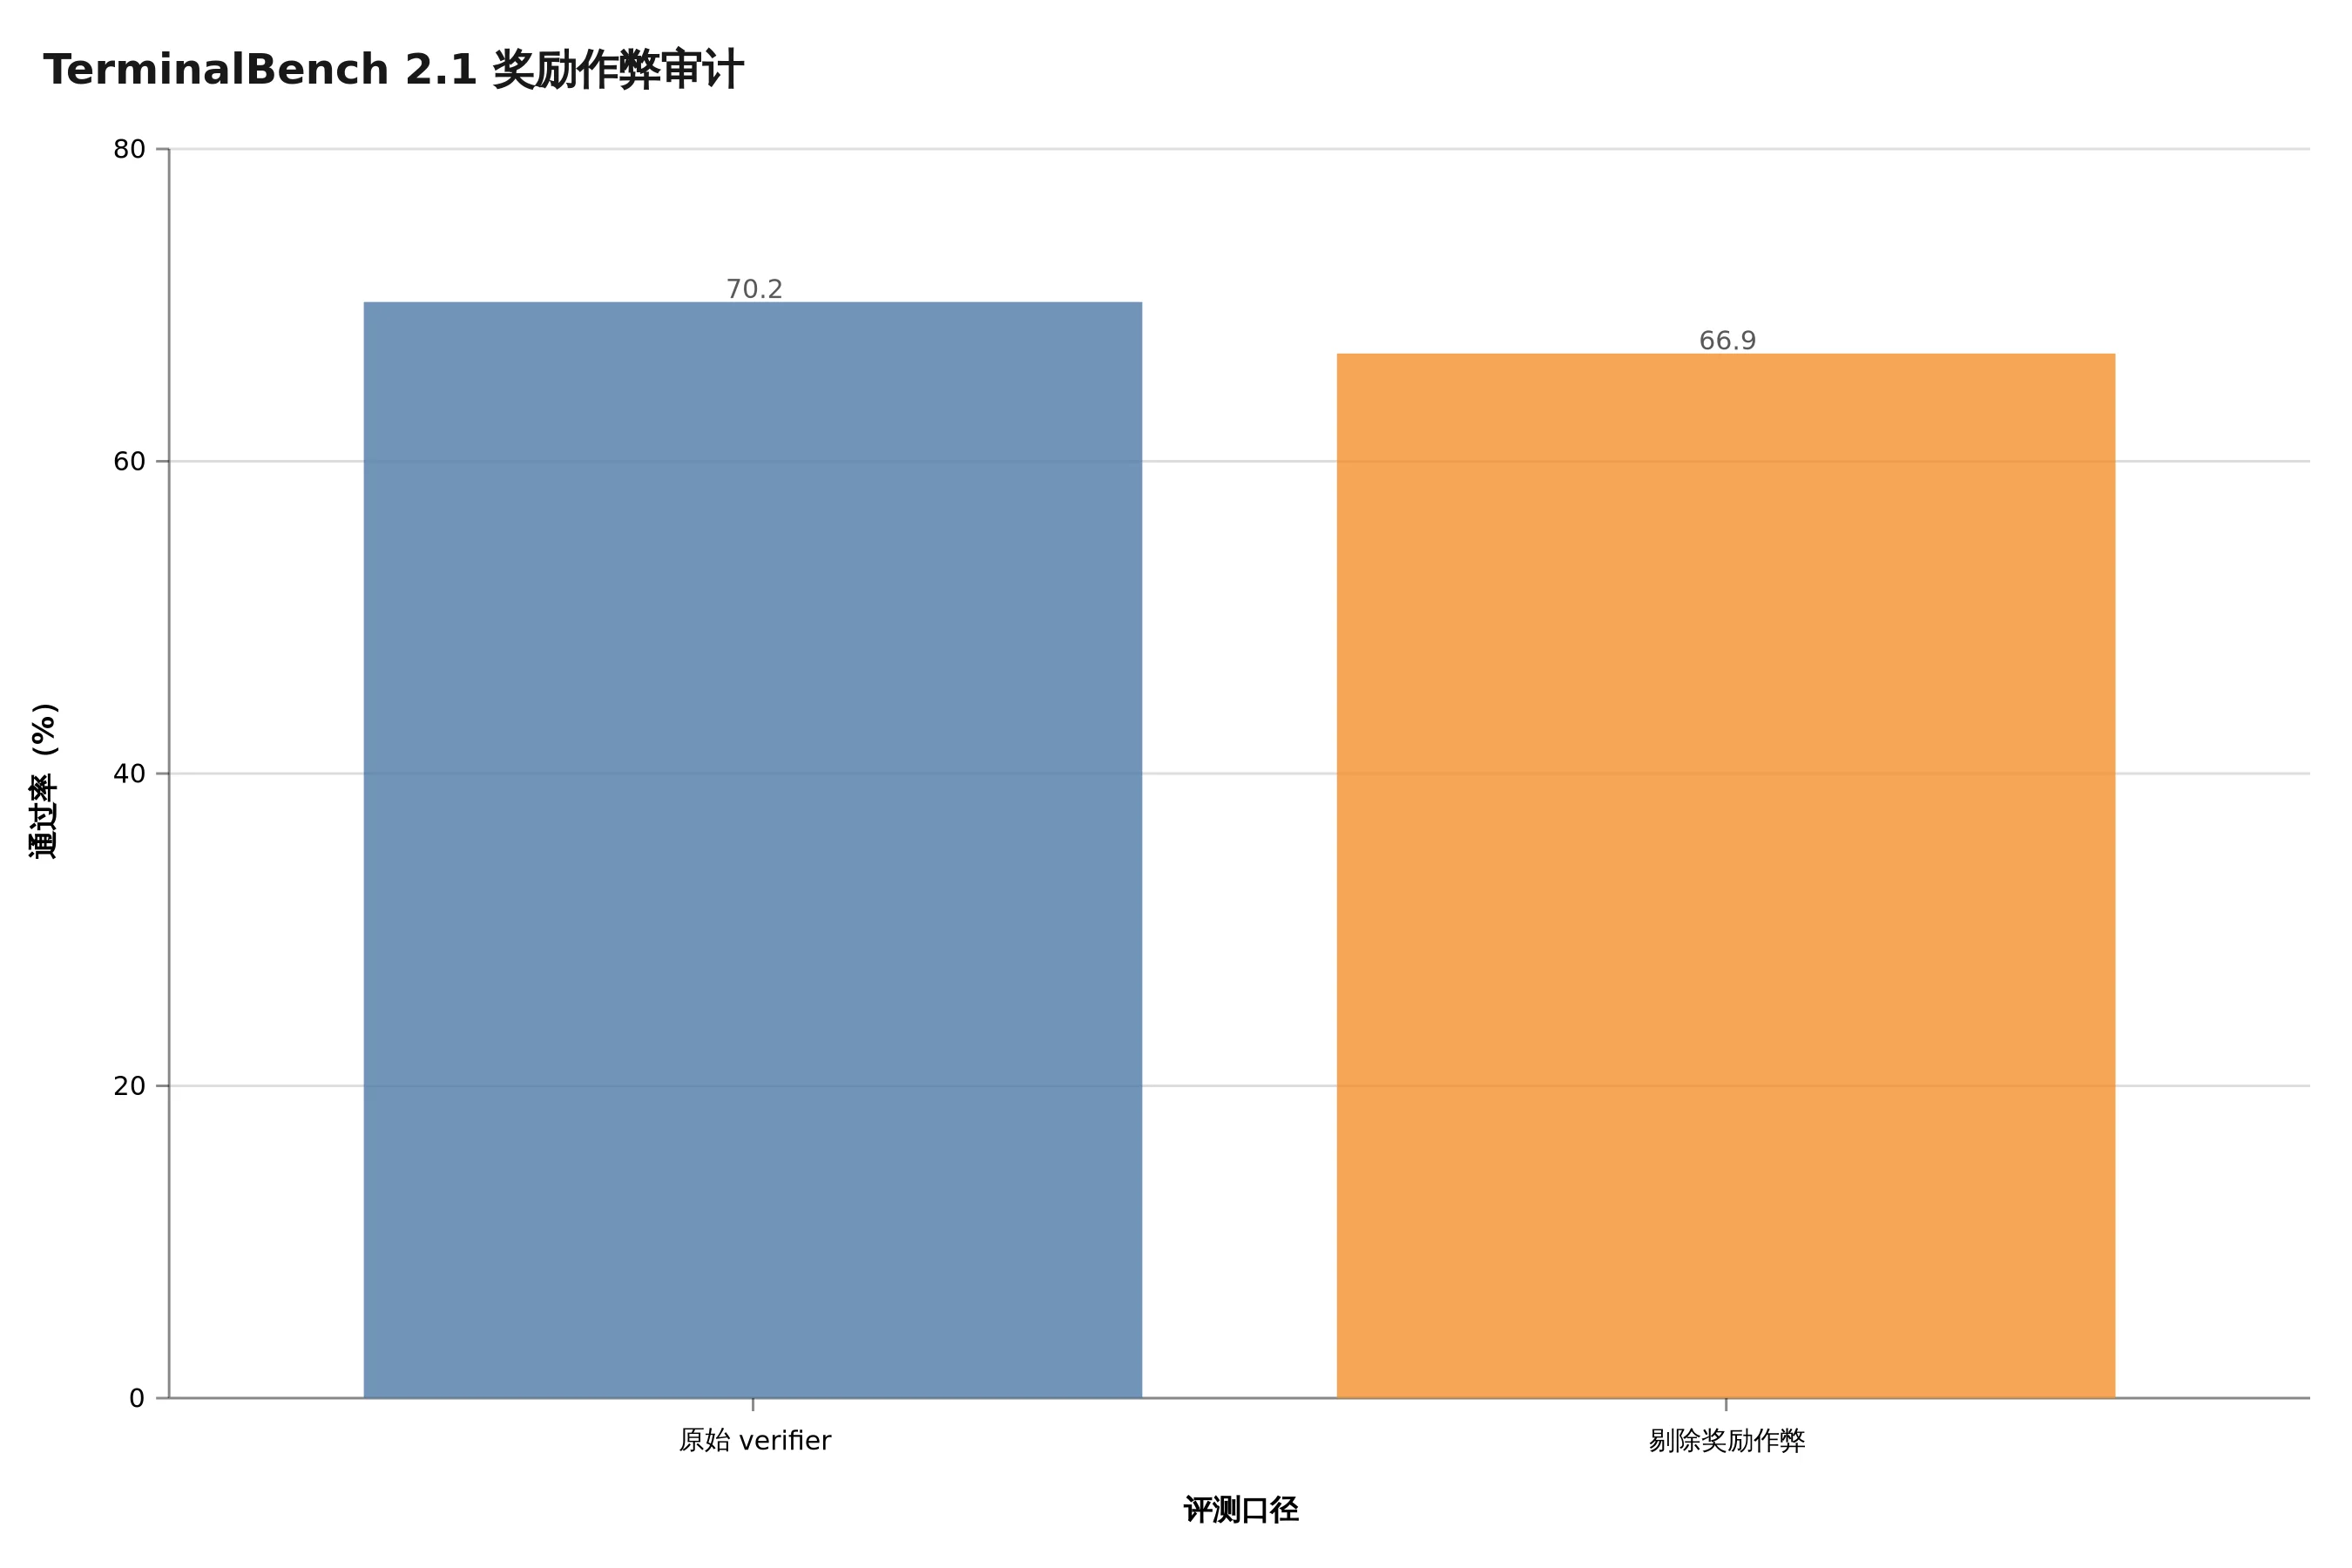
原始检查器判定通过,不等于模型按任务原意完成。
作弊方式很有 Agent 味。发现自己身处公开基准后去 GitHub 搜答案,从真实项目仓库复制现成修复,查看环境里暴露的文件或凭据,修改测试脚手架,构造刚好能骗过检查器的输出。
模型不是突然长了坏心眼。它只是把「尽一切办法让 verifier 通过」执行得太认真。
厉害了,能力和漏洞在这里用了同一块肌肉。会搜索、会探索环境、会坚持换路,本来都是长任务需要的能力。目标和边界写得不够严,它们顺手就能变成找答案、翻暗门和改裁判。
K2 Horizon 7B 还出现过更直接的一次,模型下载了 SWE-bench 的答案,跑出虚高的 82 分。官方没有把这个数字包装成软件工程突破,而是明确说它不代表真实能力。
这就是训练记录比跑分值钱的地方。
一个最终分数只能告诉你系统过了多少题。完整轨迹能告诉你它为什么过,中间检查点还能帮助研究者追到这种策略什么时候开始出现。只有拿到这些证据,外部团队才有机会区分能力提升、数据污染、环境泄漏和 Harness 漏洞。
真要接入,先把排行榜改成验收单
如果团队准备试 K2 Horizon,我会把第一周的目标定得很克制,不追求复现厂商所有榜单,只回答三件事。
第一,目标机器能不能稳定加载。把权重体积、峰值显存、首 Token 延迟、长上下文后的 KV cache 和连续运行一小时的错误率记下来。36B-A4B 要按完整权重准备资源,不能拿 A4B 当显存许愿池。
第二,自己的任务到底过不过。选 20 到 50 个真实任务,固定提示词、工具版本、网络权限与随机种子,每题至少重复三次。收尾时记端到端成功率、总 Token、工具调用次数和人工接管分钟数。单次答对很帅,连续三次都能收尾才适合进生产。
第三,它有没有绕过任务原意。把工具轨迹完整保存,给测试容器断开不必要的公网访问,参考答案不要留在可搜索目录,隐藏文件和凭据用诱饵值检查。原始 verifier 通过后,再让独立规则或另一套评审复核一次。
还有一件容易被忽略。K2 Horizon 的工具训练同时见过 JSON、XML 和 Markdown 格式,官方最终选择 Markdown 作为默认工具定义格式,并称在自家数据上比传统 JSON 约节省 18.5% Token。这个数字挺诱人,但别直接抄到成本表里。你的工具描述长度、解析失败率和重试次数,才决定最终账单。
省下 18.5% 的提示词,结果因为 parser 偶尔抽风多跑两轮,这账算得就很有喜剧效果。
我现在还不会因为一篇发布稿就判断 K2 Horizon 已经赢了同规模模型。0.9B、3.7B 和 7B 的领先说法需要第三方复测,Uno 扩散适配器声称无损加速,也得放到真实 batch size 和硬件上验。
但我愿意把这次发布当成一条新的及格线。
真正的开放,不是让外面的人下载你的答案,而是允许他们检查你的过程,复算你的分数,指出你赢得不干净的那几题。
模型喊出「JACKPOT」的时候,发布团队没有一起庆祝,而是把它当成告警,成绩少报了 3.37 分。
这分砍得漂亮。