posts/latentrank-model-leaderboard.md
大模型总榜越公平,你越不该照着第一名买单
54 个小时,换来一张「可能更公平」的大模型排行榜。
今天刷到 LatentRank 的公开介绍,我最先注意到的不是谁排第一,而是「可能」这两个字。
这个词挺克制。
它没有许诺终于找到了世界上最强的模型,只说想把散落在不同地方的榜单聚合起来,用 Bradley-Terry 成对比较模型,再给小样本加一点先验约束,尽量处理榜单规模不同、领先幅度不同、模型缺席这些麻烦。
好家伙,这比把几张表格抄到一起认真多了。
模型榜单现在有点像体检报告。跑分、盲测、编码、数学、智能体任务、输出速度、价格,每一页都在告诉你一个数字。问题是,普通人最后只想问一句,买哪个?
于是大家自然会去找总榜。
一张表,一个第一名,一个看起来很省脑子的答案。
但我越来越觉得,总榜最有价值的用途不是替你选模型,而是帮你缩小候选范围。它可以是一张地图,不能是你的自动驾驶。
LatentRank 真正有意思的地方,也不是又排出了一次前五,而是把「榜单怎么合并」这件平时藏在表格背后的工程问题摆到了台面上。
这事儿值得聊聊。
排名不是称重,它更像联赛积分
先把 Bradley-Terry 讲成人话。
假设有两个模型 A 和 B,它们在不同比赛里反复碰面。A 赢得更多,模型就会估计 A 的潜在实力更高。两者的实力差,再被映射成 A 战胜 B 的概率。
它不要求每个模型都参加同一场考试。只要比较网络能连起来,A 跟 B 比过,B 又跟 C 比过,就可以借这些连接估计相对位置。
这套方法并不新。Bradley 和 Terry 在 1952 年发表的论文讨论的就是成对比较。后来体育排名、推荐系统、搜索排序都爱用它。大模型圈熟悉的 Chatbot Arena 技术报告,也把大量真人二选一偏好转成模型排名。
厉害的地方在于,它承认现实世界的数据就是不整齐。
有的模型出场早,积累了很多比较。有的模型刚上线,只打了几场。有的榜单只测闭源模型,有的专盯开源模型。硬算平均分,很容易把「没参加」当成「表现差」,或者把一个小榜单里的偶然大胜当成统治力。
先验约束在这里像一根弹簧。
样本少的时候,它会把特别夸张的结果往中间拉一点。等证据多了,再允许名次慢慢跑开。统计学里常叫收缩,没那么玄,就是别让三场连胜直接把一支新队封成世界冠军。
这手处理有点子牛逼,因为它碰的正是聚合榜单最容易翻车的地方。
可它也只解决了一部分问题。
排序模型能认真处理「怎么合并」,却没法替你回答「这些输入到底代表了什么」。如果输入本身偏向某类能力,合并得再漂亮,得到的也只是更稳定的偏向。
把五张榜单平均,不等于获得五份独立证据
排行榜最容易给人一种错觉,来源越多,结论越稳。
不一定。
两张榜单可能用了相同题库,三张榜单可能都依赖同一批模型裁判,另一张虽然名字不同,测的还是英语、单轮、标准答案。表面有五票,底下可能只有两套真正独立的信息。
这叫相关性。它很不起眼,却会让聚合结果显得比实际更确定。
你可以把它想成代码评审。五个 reviewer 都看了同一份静态分析报告,然后一致说这里有 bug,不能算五条独立证据。他们只是把同一个信号转述了五遍。
五份看似独立的结论,也可能只是一条信号的五次转述。
模型评测里也一样。
Artificial Analysis 的方法页把总指数拆成智能体、编码、科学推理和通用能力,并明确写出每个类别的权重。当前版本把智能体任务放到 34%,编码和科学推理各占 24%,通用能力占 18%。这张榜很有用,但权重本身就是判断。
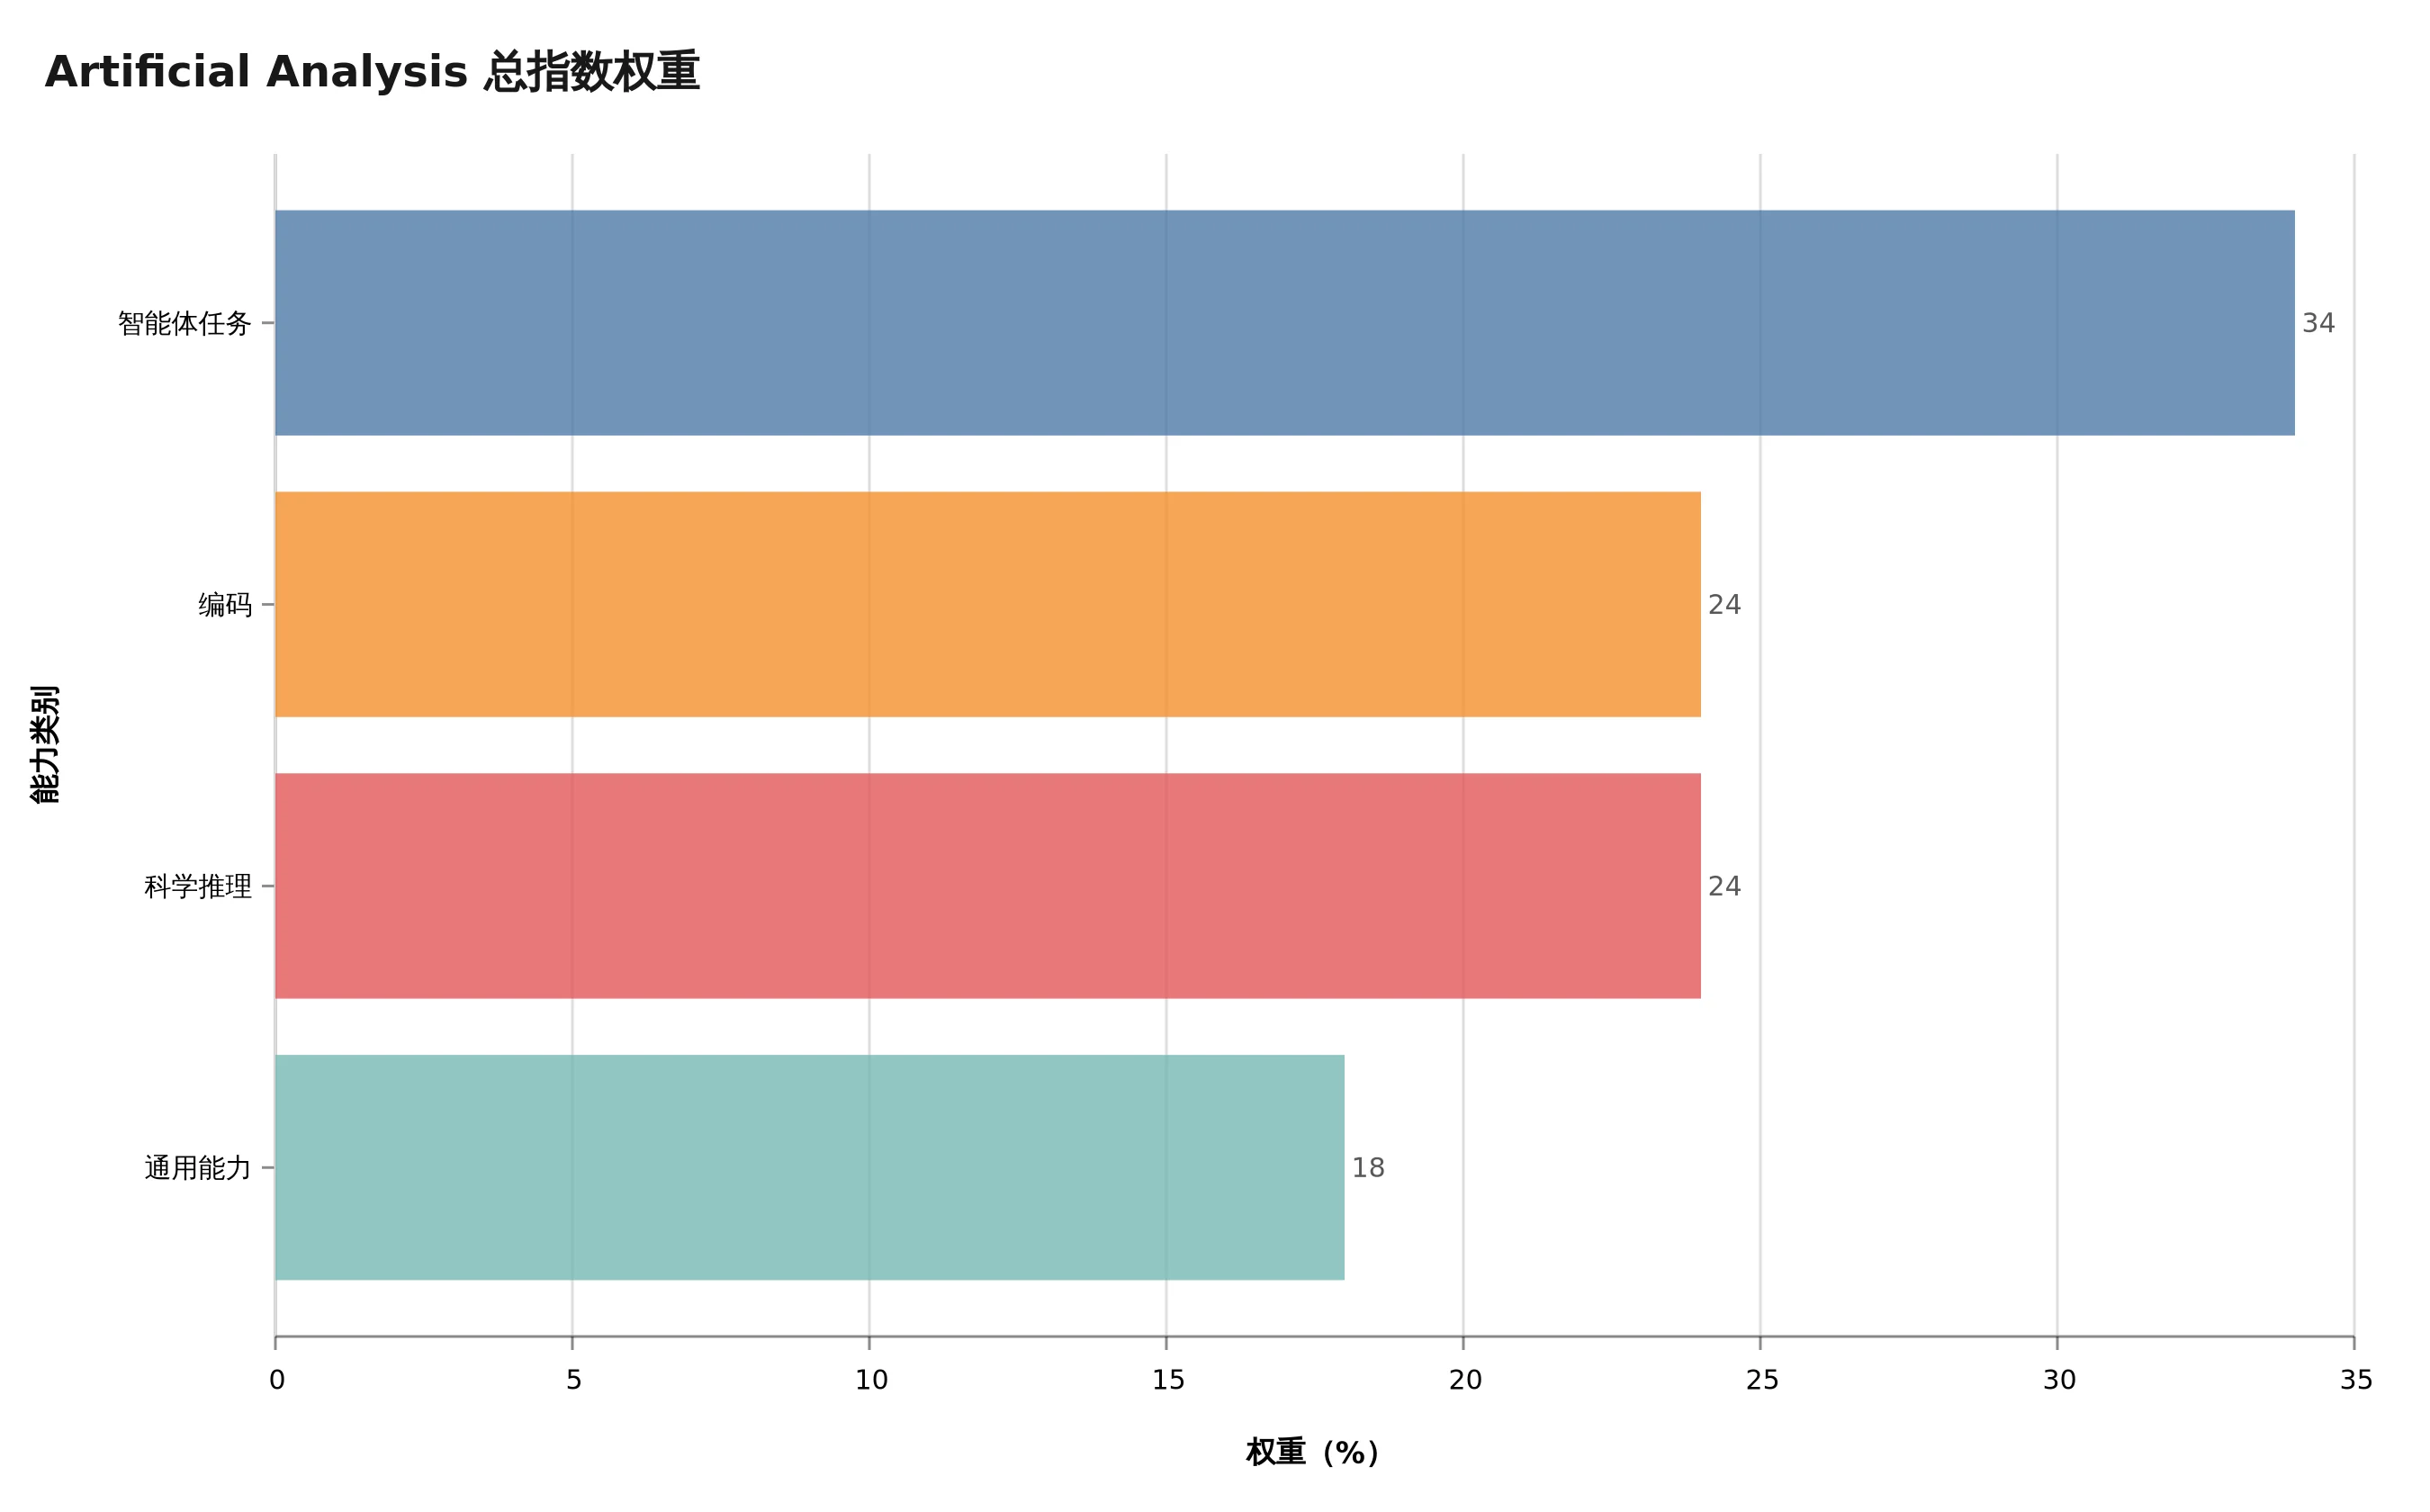
同一组模型,换一套任务权重,就可能换一张总榜。
如果你的产品是中文客服,英文科学推理再强,也未必能救一次方言识别失败。如果你在做仓库级代码修改,单轮问答榜上多拿两分,可能还不如少一次把测试目录删掉。
榜单没有骗你。
只是它回答的问题,和你心里那个问题,经常不是同一个。
另一个坑是版本漂移。
模型名看起来没变,服务端路由、系统提示词、推理预算、工具配置可能已经换了。榜单上的分数属于某个时间点、某套参数和某条调用链。你今天在生产环境里拿到的那个 endpoint,不一定还是表格里那位选手。
LiveBench会持续加入新题,尽量降低测试集污染,并使用可验证的客观答案,正是在补这块洞。Stanford HELM则强调场景、指标和请求结果透明,让人能追到总分下面那一层。
这两个方向都在提醒同一件事。
分数需要上下文,排名需要可追溯。
如果一张聚合榜只有名次,没有来源版本、更新时间、样本量、置信区间和缺失模型处理方式,那张表更像热搜,不像评测。
看着挺热闹,真拿它做采购,心里多少得打个问号。
选模型时,先把总榜降级
我自己的判断是,越认真做出来的总榜,越不该被粗暴地拿来「抄第一名」。
不是哥们,人家费劲处理样本偏差、缺失值和成对比较,你最后只复制第一行,多少有点辜负统计学。
更靠谱的用法,是先用总榜砍掉明显不合适的选项,再回到自己的任务。
第一步先看榜单在测什么。
别只看「综合能力」四个字,往下找题目语言、任务类别、工具权限、推理预算、重复次数、裁判是谁。找不到这些,排名的可信范围就该主动打折。
第二步看差距有没有大到值得在意。
第一名 82.1,第二名 81.8,不代表前者在你的产品里一定更好。没有误差区间时,小数点后一位很容易制造一种虚假的精密感。工程上更该关心的是,两者是否落在同一档,以及价格、延迟、稳定性会不会把那点分差吃掉。
第三步才是本地小评测。
不用一上来搭个论文级评测平台。先从线上失败日志里捞二十到五十条真任务,去掉敏感信息,固定输入和验收条件,让候选模型各跑几遍。代码任务就让测试说话,抽取任务就比字段级准确率,智能体任务就记录成功率、步骤数、超时和人工接管次数。
如果愿意再多走一步,把成本也放进来。
不是只看每百万 token 的标价,而是看一次成功任务到底烧多少钱。便宜模型跑三次还要人工擦屁股,未必比贵模型一次过更省。输出速度也是同理,快十个 token 每秒,如果前面思考多等二十秒,用户体感照样卡住。
最后留一个反例集。
专门收那些让第一名翻车、让第三名反而稳定的任务。它们不是评测里的脏数据,反而最接近你产品的护城河。通用榜单永远不可能替你收集这些东西。
做到这里,总榜的位置就对了。
它负责告诉你圈里哪些模型值得进面试。本地评测负责决定谁能拿 offer。线上观测再负责看它入职以后会不会偷偷摆烂。
三层缺一层,都会出事。
一张好榜单,应该允许你不同意它
LatentRank 把多张榜单放进 Bradley-Terry 框架,还给小样本加先验,这个方向我很喜欢。至少它没有假装不同来源天然可比,也没有把缺席简单算成零分。
棒棒的,排行榜终于开始认真对待排行榜自己。
但下一步比名次更重要。
我想看到每个模型的样本量、置信区间、来源贡献、更新时间,以及把某张榜单拿掉以后,名次会不会大幅变化。最好还能按任务权重重算,让做中文客服、代码智能体、研究检索的人看到不同的排序。
因为公平不是只产出一条更漂亮的队列。
公平还包括把自己的假设摊开,让读者知道这个第一名是怎么来的,也允许读者换一组权重后得到另一个答案。
这可能会让榜单没那么爽。
没有唯一王者,没有一键抄作业,甚至同一个模型在两家公司里会得到相反结论。
可真实的工程决策,本来就长这样。
地图画得再准,也不会知道你船上装的是什么货。总榜能帮你避开一部分暗礁,最后那段航线,还是得用自己的日志、预算和失败样本去测。
所以看到下一张「史上最公平大模型排行榜」时,先别急着买第一名。
先问它一句。
你排的,究竟是谁的问题?