posts/lfm25-dspark-speculative-decoding.md
LFM2.5 提速 3.18 倍,先别急着换大模型
326 tok/s,变成 1000 tok/s。
61 tok/s,变成 137 tok/s。
这不是把 LFM2.5 换成更激进的量化,也不是牺牲输出质量换速度。Liquid AI 给原模型旁边挂了一个约 3 亿参数的「草稿模型」,让它先猜一串 token,再让原模型一次验完。
猜对的留下,猜错的由原模型接管。
好家伙,推理加速终于有了一点「不动主模型,只改解码路径」的味道。
Liquid AI 在 8 月 20 日发布了三组 LFM2.5-DSpark 草稿模型。官方数据里,单张 H100 上最高加速 3.18 倍,M4 Max 上最高 2.87 倍,LFM2.5-2.6B 的多工具调用延迟平均下降 57%。权重同时给了 Safetensors 和 GGUF,llama.cpp 与 SGLang 也有对应实现。
数字够漂亮,代码也真的能跑。
但先别把「最高 3.18 倍」直接写进容量规划。把官方三张表横着看,会发现真正决定收益的不是 DSpark 三个字,而是草稿 token 能活下来多少、你的后端怎么搬权重、以及用户到底在等哪一段时间。
这三笔账没算明白,3.18 倍很容易在生产环境里缩水成 18%。官方数据里恰好就有这么一组。
草稿模型不是更快地回答,它是更便宜地猜
大模型逐 token 生成时,解码阶段常常受内存带宽限制。GPU 或统一内存要不断把模型权重搬进更靠近计算单元的高速存储,真正做乘加的时间反而没那么扎眼。
最浪费的地方在这里,每生成一个 token,都要为庞大的目标模型再搬一轮权重。
投机解码换了个思路。先让一个便宜的小模型连续猜多个 token,再让昂贵的目标模型用一次前向计算批量验证。目标模型的权重还是要搬,但一次搬运可以验好几个候选,成本被摊薄了。
你可以把它想成代码评审。目标模型是资深 reviewer,草稿模型是手很快的新人。新人先把一段补丁写出来,资深 reviewer 不逐字敲一遍,而是整段检查。能过的直接合并,第一处不对就从那里接手。
资深 reviewer 没有失去最终决定权。
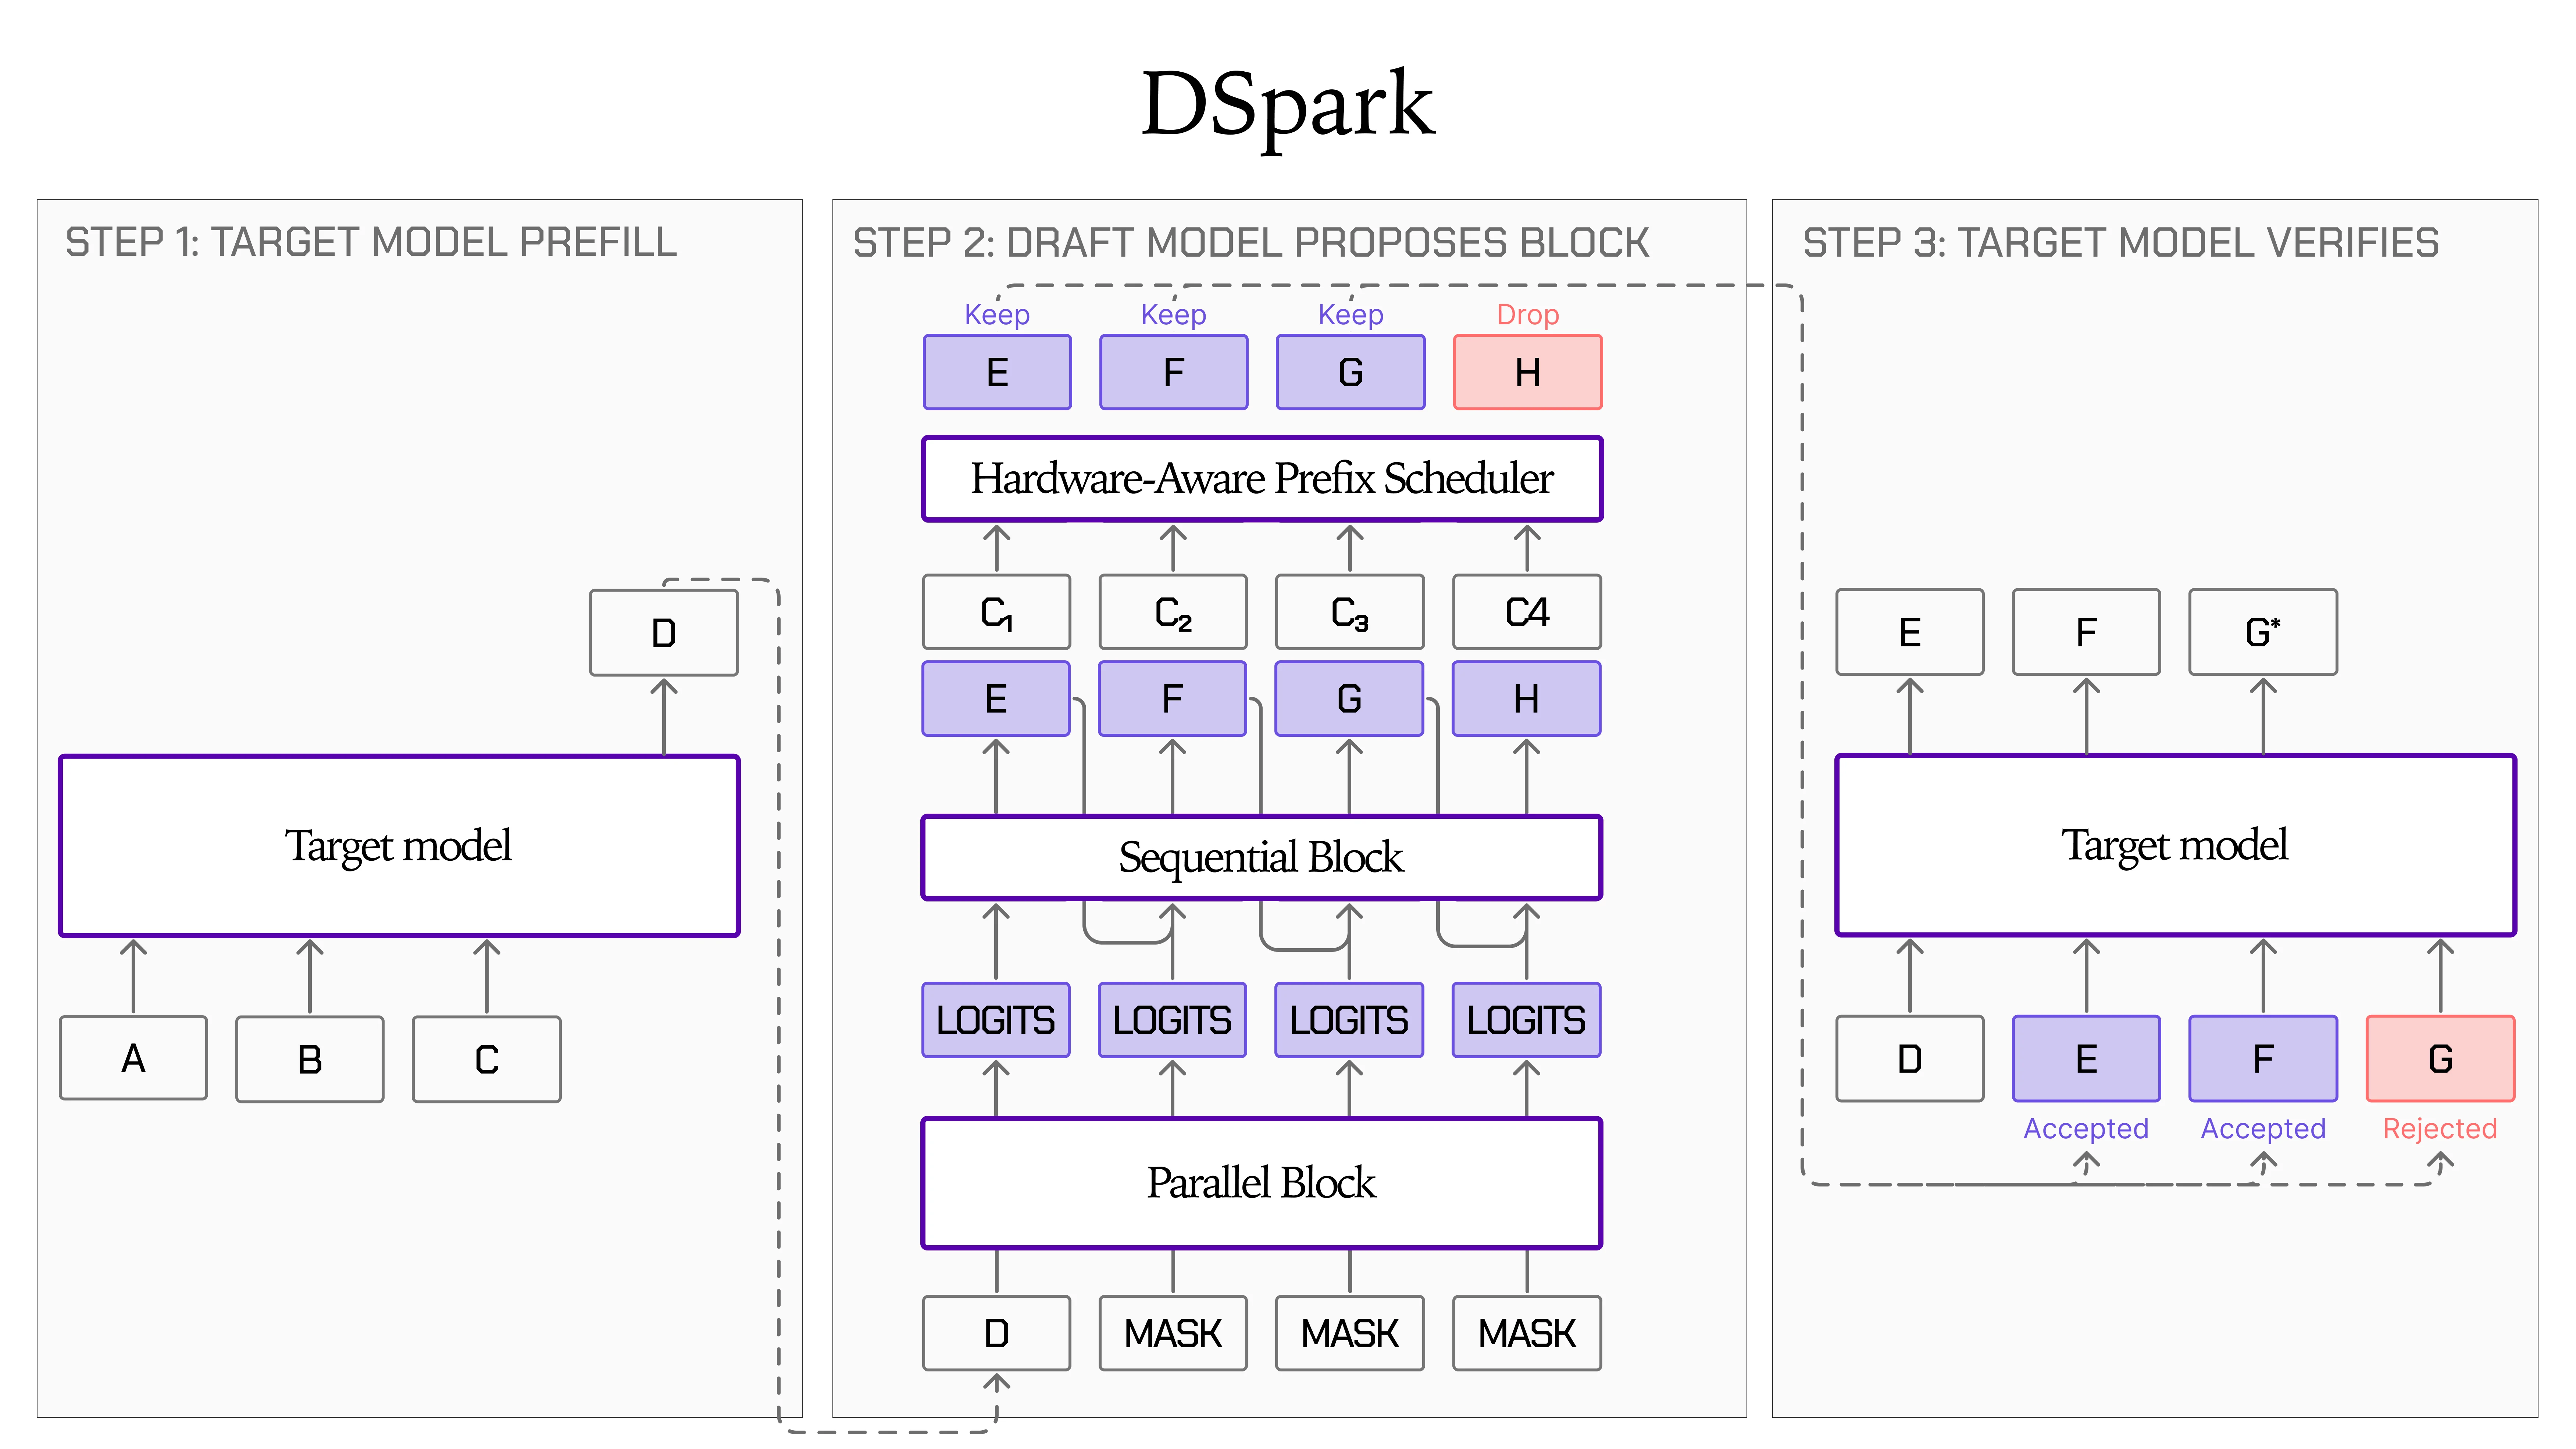
官方 DSpark 流程,草稿模型先提出 token 块,目标模型保留通过项并从拒绝处接管。
这也是官方敢说「不改变输出质量」的原因。在 temperature 0 的贪心解码下,草稿 token 只有与目标模型的分布匹配才会被接受。被拒绝的位置换回目标模型自己的 token,所以最终序列与只跑目标模型的基线相同。
注意限定词,temperature 0、贪心解码、目标模型逐 token 验证。文章给出的质量等价结论落在这套实验条件里,不该顺手扩大成所有随机采样配置都天然相同。
DSpark 论文做得有点子牛逼的地方,是它没有只靠一个小模型硬猜。它把 DFlash 风格的并行骨干、相邻 token 的轻量马尔可夫预测头,以及置信度调度验证器拼到了一起。
并行骨干一次产出整段草稿的隐藏状态,马尔可夫头补上相邻 token 的依赖,置信度调度则负责及时收手。如果后半截候选存活概率太低,它就提前剪掉,免得验证成本比省下来的搬运还贵。
这很像一个知道自己什么时候该闭嘴的新人。
模型不大。三个版本的草稿模型分别是 295.7M、327.7M 和 327.7M 参数。按 FP16 每参数 2 字节粗算,327.7M 权重本身约 655MB,这只是理论权重体积,不含运行时缓存和框架开销。换成 GGUF 量化后还可以更小。
对一台已经能装下 2.6B 或 8B 目标模型的机器,这笔额外权重不算离谱。但「很小」不等于「免费」,显存刚好卡在阈值上的部署,照样可能因为多出这几百 MB 被迫降批量、缩上下文,甚至换量化等级。
省下来的解码时间,要先把这笔内存租金交了。
接受率高,不一定跑得快
官方给每组测试都列了一个接受数,满分 10。它可以粗略理解成每轮提出 10 个候选时,平均有多少个能活到目标模型放行。
直觉上,接受得越多,一次目标模型前向计算就摊到越多 token,当然越快。
LFM2.5-2.6B 在五个数据集上的平均接受数是 4.81。H100 平均从 323 tok/s 提到 864 tok/s,加速 2.67 倍。M4 Max 平均从 61 tok/s 到 139 tok/s,加速 2.27 倍。
这组很舒服。接受率没有高得离谱,硬件两边却都吃到了两倍以上收益。
再看 LFM2.5-1.2B-Instruct,平均接受数还略高一点,达到 5.02。它在 M4 Max 上平均加速 2.54 倍,HumanEval 甚至到 2.87 倍。但换成 MT-Bench,H100 只有 1.66 倍,M4 Max 也只有 1.72 倍。
同一个模型,同一套草稿架构,只是文本分布变了,加速幅度就能差 52%。
原因并不神秘。代码、数学、聊天的 token 可预测性不同,草稿模型擅长的模式也不同。让它补结构固定的函数签名,和让它继续一段开放式对话,不是一份工作。
真正把直觉打碎的是 LFM2.5-8B-A1B。
这是 MoE,也就是混合专家模型,每个 token 只激活一部分专家。它的平均接受数高达 6.95,比两个稠密模型都高。H100 上表现也很猛,平均 2.54 倍,MATH500 达到全文最高的 3.18 倍。
到了 M4 Max,平均只剩 1.18 倍。
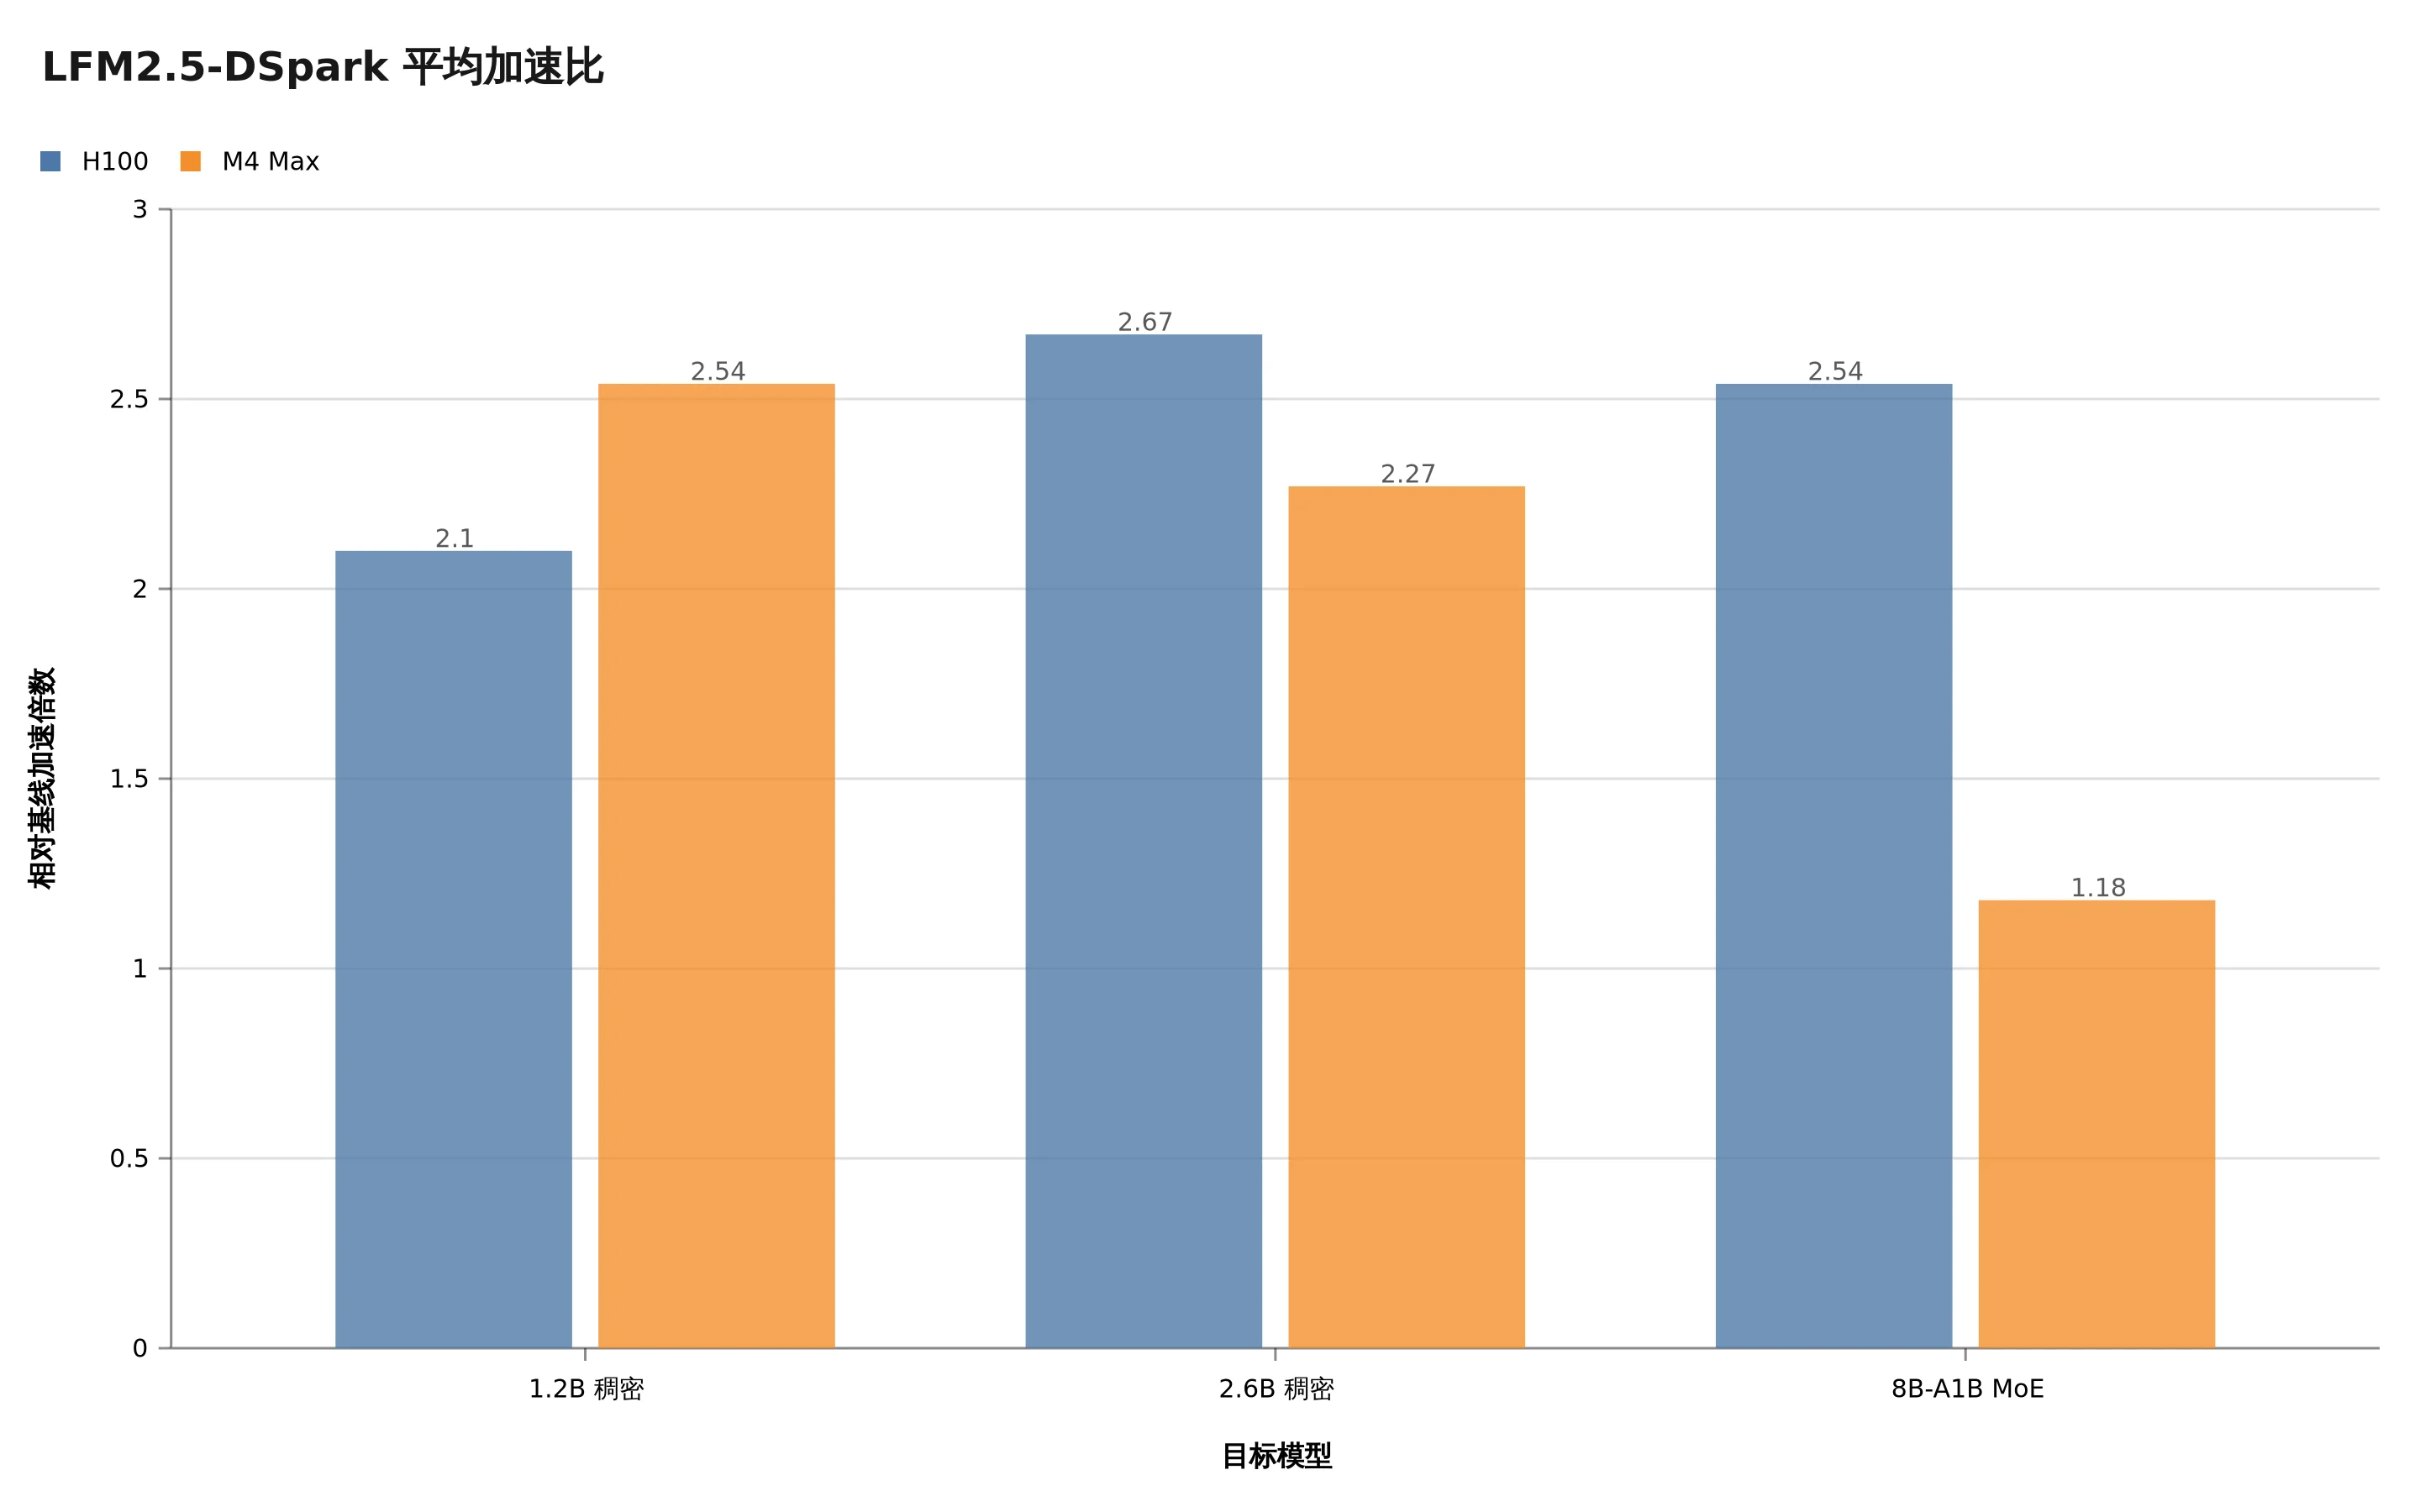
数据来自 Liquid AI 官方五项基准均值。8B-A1B 在 H100 上明显提速,到了 M4 Max 只剩 1.18 倍。
厉害了,草稿猜得最准的一组,端侧反而最慢。
Liquid AI 给出的解释很工程。llama.cpp 当前的 Metal 后端处理 MoE 时,一次验证多个 token 会激活更多专家,带来更多权重搬运。草稿层面省下来的循环,被后端多搬的专家权重吃掉了。
这组数据把投机解码的边界说得很透,接受率是必要条件,不是充分条件。目标模型的架构、kernel 实现、内存层级和一次验证触发的权重流量,都会参与最终结算。
所以别只盯着 draft_n_accepted。它高,只能证明新人写对得多,不能证明 reviewer 的整段评审足够便宜。
3.18 倍吞吐,不等于用户少等 68%
官方测试条件写得很清楚。H100 用单张 80GB 卡、BF16、SGLang。M4 Max 用 FP16 GGUF、llama.cpp 和实验性 Metal kernel。两边都是 batch size 1、temperature 0,最多生成 256 个输出 token,block size 9。
每个条件都在提醒你,别把一个解码阶段的 benchmark 当成整条请求链路。
用户等待时间通常至少包含排队、输入预填充、首 token、逐 token 解码、工具执行和网络传输。DSpark 主要优化的是逐 token 解码。假如你的请求输入两万 token,只输出一句短答案,时间大头可能在预填充。解码翻倍,端到端 P95 也未必有多大动静。
反过来,如果任务要持续生成几百个 token,或者智能体要频繁产出结构化函数参数,解码占比就高得多。官方在 LFM2.5-2.6B 的多工具场景里测到平均延迟下降 57%,这比单看 tok/s 更接近用户体感。
但这里还有个很容易漏的细节。官方 SGLang 启动命令里带了 --disable-radix-cache,基线也使用同样配置。这样做能保证对比公平,却不代表你的生产服务也该关掉前缀缓存。
很多智能体请求共享长系统提示词、工具定义和固定上下文。Radix Cache 一类前缀缓存本来能省掉重复预填充。如果为了照抄 benchmark 关掉缓存,可能在解码阶段捡到两倍,又在输入阶段把时间还回去。
不是哥们,优化不能只看一张表里最亮的格子。
并发也一样。batch size 1 告诉我们单请求解码很快,却没有直接回答多用户动态批处理下的容量变化。草稿模型要占额外显存,验证多个 token 也会改变计算形态。高并发服务里,原本能塞下的 batch 会不会变小,调度器能不能把投机请求拼好,这些都得在自己的流量上测。
因此,3.18 倍不能自动翻译成「同一张卡能多扛 3.18 倍 QPS」,也不能自动翻译成「用户等待时间减少 68%」。这两个结论都需要端到端数据。
这话听着扫兴,但它恰恰是 DSpark 最值得写的地方。官方没有只放峰值,还把 8B-A1B 在 M4 Max 上的 1.04 倍、1.09 倍也摆了出来。最差的格子没有藏,开发者才有机会判断自己属于哪一格。
真要上,先跑一场贴着业务的 A/B
LFM2.5-DSpark 已经给了两条很短的落地路径。SGLang 对应 DSpark 支持 PR,llama.cpp 对应 LFM2 支持 PR。以 2.6B 为例,SGLang 启动时只需挂上草稿模型和算法参数。
python -m sglang.launch_server \
  --model-path LiquidAI/LFM2.5-2.6B \
  --speculative-algorithm DSPARK \
  --speculative-draft-model-path LiquidAI/LFM2.5-2.6B-DSpark \
  --speculative-draft-attention-backend flashinfer \
  --disable-radix-cache --mem-fraction-static 0.75 --port 30000
基线用同一条命令,去掉三个 --speculative-* 参数。llama.cpp 也类似,目标模型用 -m,草稿模型用 -md,响应里的 timings 会返回 draft_n 与 draft_n_accepted。
跑起来只是第一步。真正有用的 A/B,测试集别只放 HumanEval 和 MATH500,直接从自己的生产流量抽样,至少覆盖短回答、长回答、代码生成、函数调用和长输入短输出。敏感内容先脱敏,别为了测吞吐把用户数据拷得到处都是。
然后同时看四类数。端到端 P50 与 P95 告诉你用户少等了多久,time to first token 区分预填充和解码,tok/s 与接受率解释提速来自哪里,峰值内存和可维持并发则决定这条优化能不能进生产。
如果只能留一个判断标准,我会留「每 GB 内存换来的完成请求数」。tok/s 很爽,但生产机器付的是显存、功耗和并发账单。
还有版本绑定。草稿模型不是随便找一个 300M 模型就能接,它要读取目标模型的上下文特征,训练时也针对对应目标做过适配。目标模型权重、tokenizer、运行时 PR 和草稿检查点最好一起锁版本。主模型一升级,草稿模型就该重新过接受率与质量等价测试。
这事儿有点像给数据库换索引。SQL 一行没改,不代表上线不用回归。
坦率讲,DSpark 不是每个部署都该立刻接。短输出为主、预填充占大头、显存已经贴边,或者后端对 MoE 批量验证还不成熟,先把前缀缓存、量化和 batching 调好,可能更划算。
但如果你跑的是 LFM2.5 稠密模型,任务输出较长,函数调用频繁,又主要服务单用户或低 batch 场景,这批开源检查点很值得试。尤其是 LFM2.5-2.6B-DSpark,H100 与 M4 Max 的平均收益都过了两倍,官方还给出了多工具延迟下降 57% 的结果,信号相对完整。
模型行业很爱讲更大、更强、更多参数。DSpark 走的是另一条路,目标模型不动,输出不降级,只在它旁边放一个会猜、也知道何时闭嘴的小搭档。
真正有价值的推理优化,未必让模型变聪明。
它只是让昂贵的聪明,少搬几趟东西。