posts/lfm25-qad-quantization-recovery.md
同样是 Q4_0,LFM2.5 追回 97% 量化掉分
两个模型文件都写着 Q4_0.gguf,都能塞进同一块内存,也都交给同一个 llama.cpp 运行。
结果一个是把高精度模型直接压成 4bit,另一个在训练时就知道自己只能用 4bit。文件名看起来像双胞胎,答题和工具调用却能差一截。
好家伙,量化格式居然开始不够用了。
Liquid AI 刚发布的 LFM2.5 QAD 检查点,把这个差别摆到了台面上。团队给 LFM2.5-230M、350M、1.2B-Instruct 和 2.6B 做了四套新的 Q4_0 GGUF。它们没有换成更大的位宽,没有偷偷加一档显存,也没有要求新的推理引擎。
变化发生在模型变成 GGUF 之前。
Liquid AI 用量化感知蒸馏,也就是 Quantization-Aware Distillation,把高精度教师模型教给一个已经处在量化约束里的学生模型。普通 Q4_0 因压缩丢掉的平均精度,它追回了 97%。四款模型最终分别保留 BF16 基线性能的 97.1%、96.5%、97.4% 和 96.6%。
这两个 97% 不是同一件事。前一个说丢掉的分被救回多少,后四个说最终还剩多少 BF16 性能。宣传页把它们挤在一起很容易看花,工程上得分开记账。
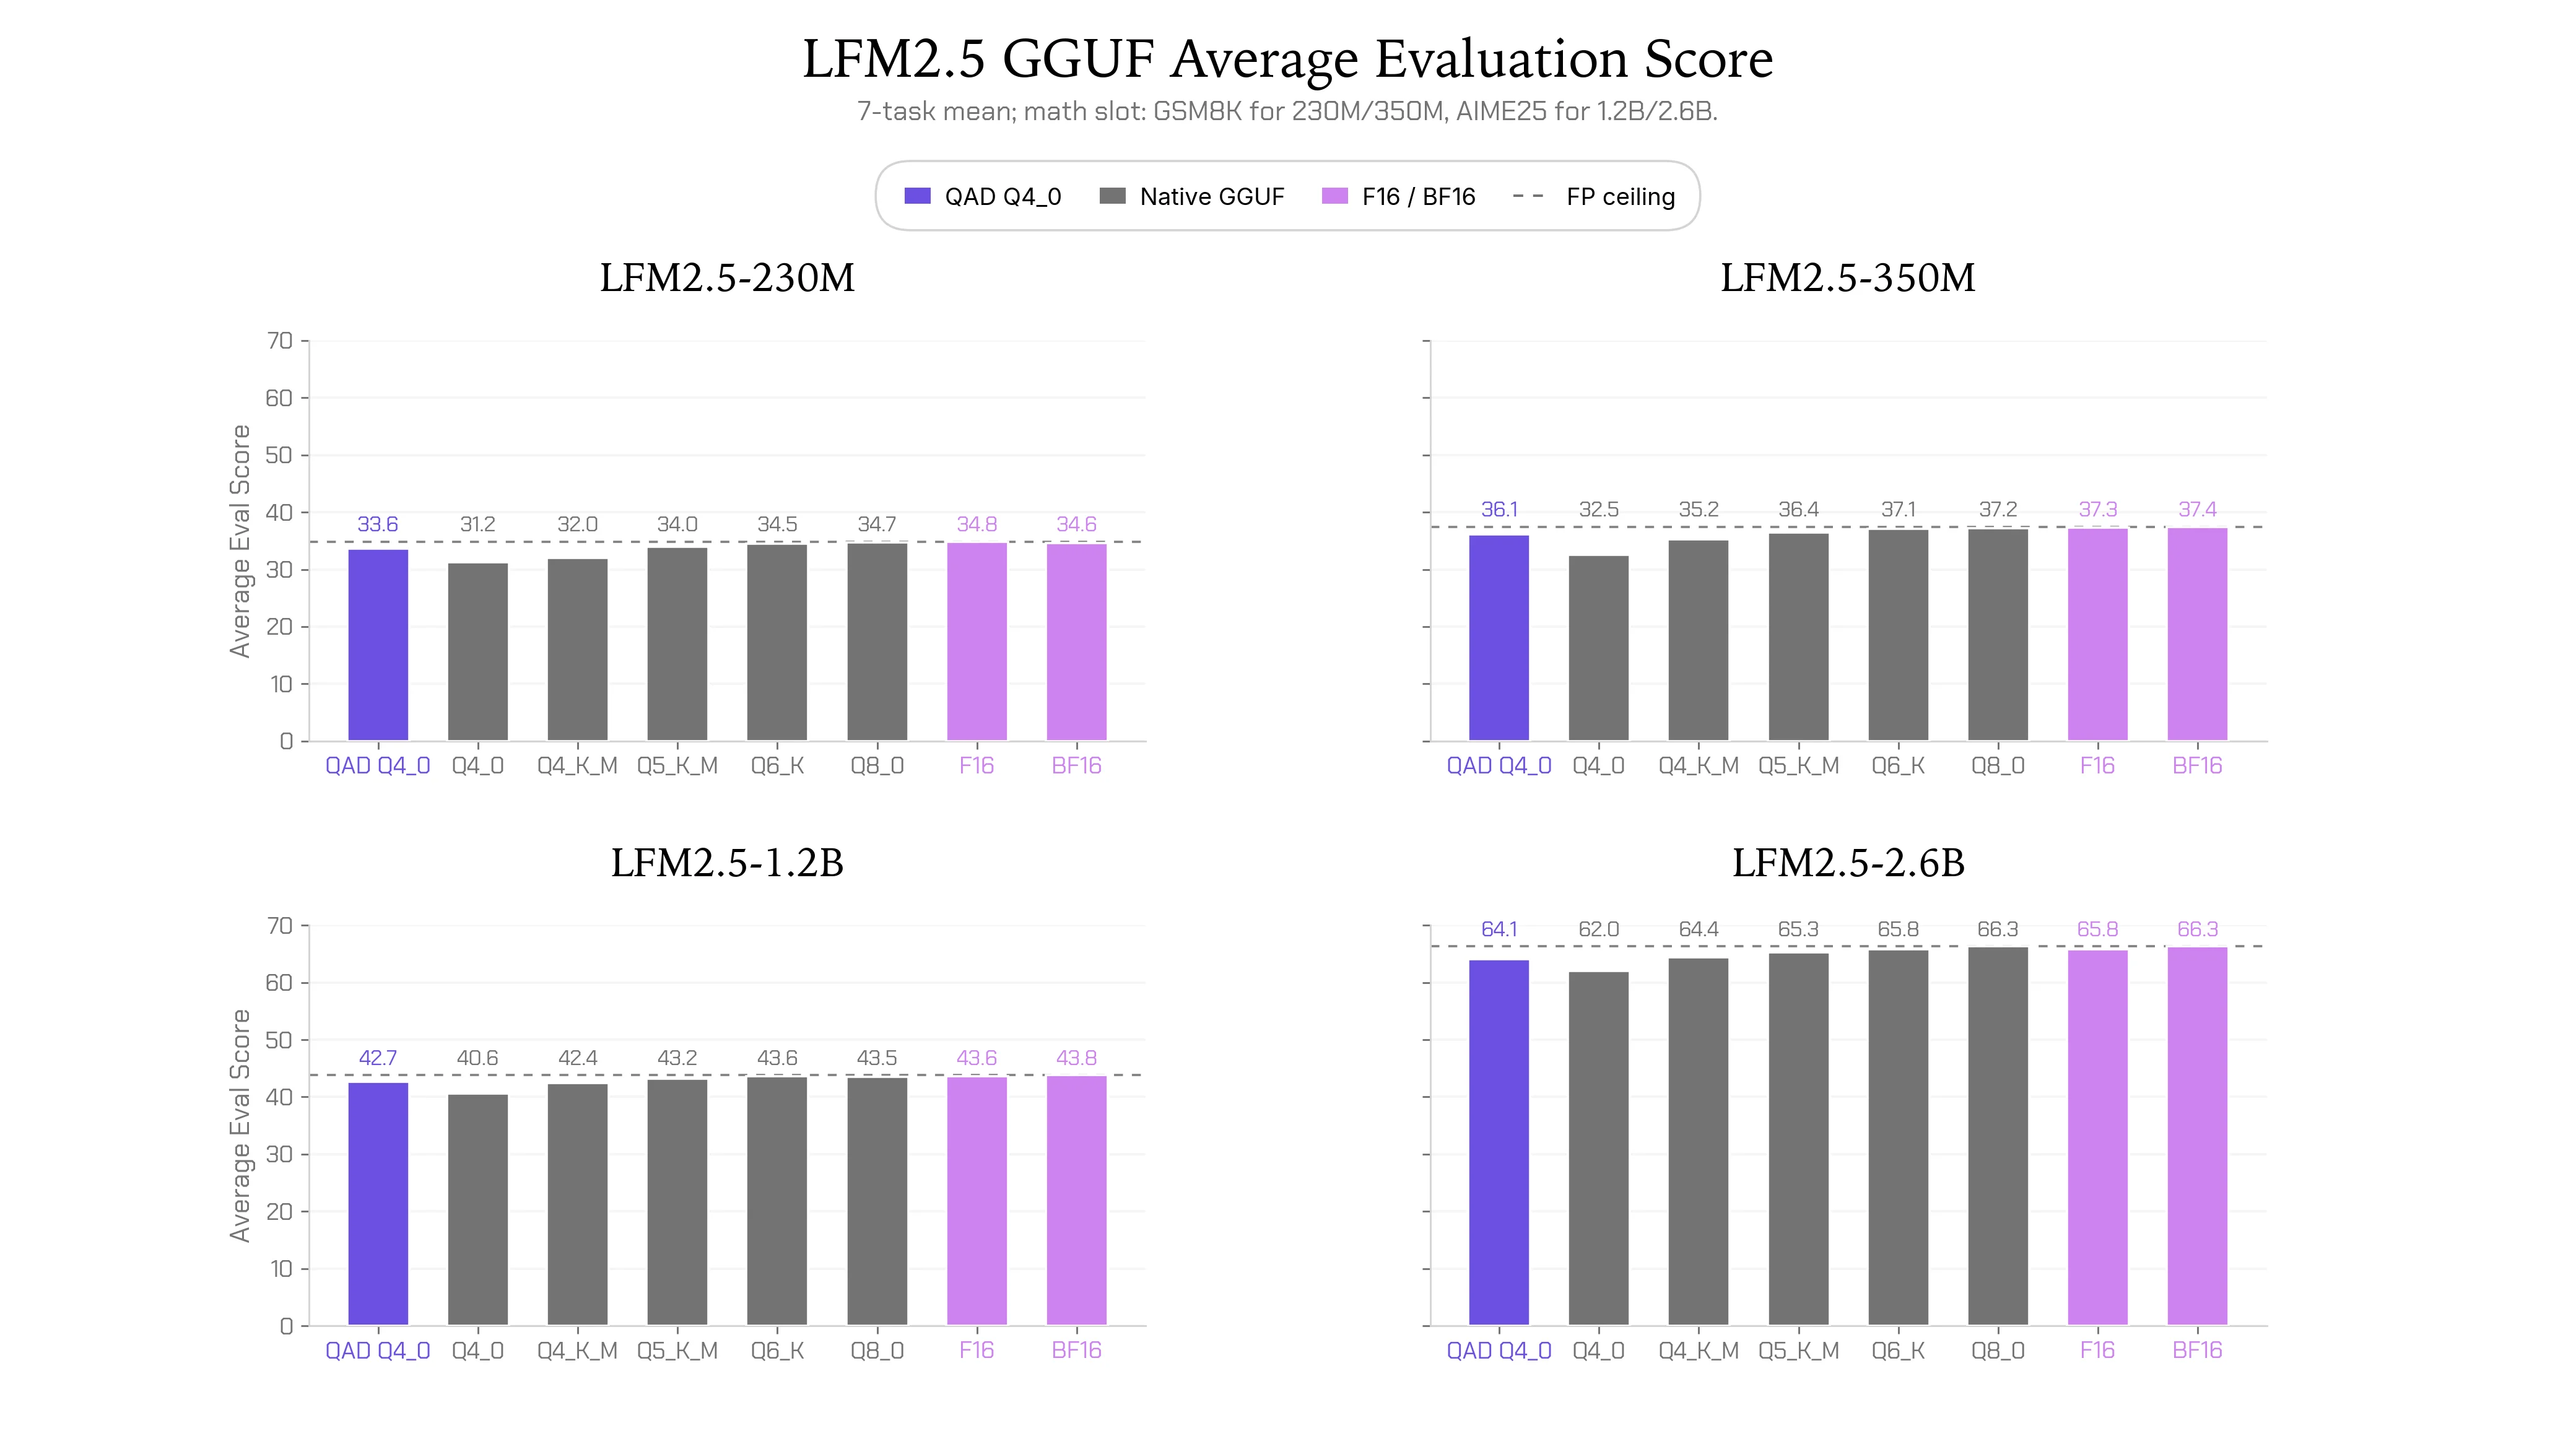
紫色 QAD Q4_0 在四个尺寸上都明显高于普通 Q4_0,并逼近 BF16 基线。
我自己的判断是,这次发布最值钱的也不是 97%。它把本地模型圈一个用了很久的习惯掀开了。
我们太爱拿文件名当质量证书。
Q4_0 只是容器,不是质量证书
很多人第一次下 GGUF,会在仓库里看到一长排 Q2_K、Q4_0、Q4_K_M、Q5_K_M。最自然的理解是,位数越高,文件越大,质量越好。预算紧就拿 Q4,显存宽裕就往 Q5、Q6 走。
这个经验不算错,但它只描述了权重最终被装进什么盒子,没有描述装盒之前发生过什么。
传统训练后量化,英文叫 Post-Training Quantization,简称 PTQ。模型先用 BF16 之类的高精度格式训练完,再把权重映射到更少的数值档位。它像把一张细腻照片导出成低码率 JPEG,压缩动作发生在内容已经定稿以后。你可以调量化算法、分组方式和校准集,原模型却不会回头学习怎样在这些离散档位里表达自己。
QAD 把约束往前挪了一步。
学生模型训练时就活在量化后的数值空间里,高精度教师继续告诉它该往哪个答案靠。某个权重无法再精确落到原来的位置,学生有机会让周围的参数一起调整,把损失搬到不那么要命的地方。不是压完再祈祷,而是在知道行李箱只有这么大时重新收拾行李。
这一下有点子牛逼。
因为推理阶段看到的仍然是普通 Q4_0。运行时不需要理解教师模型,也不用额外跑一层补偿网络。内存占用和吞吐保留在 Q4_0 那一档,训练成本已经被提前结算进检查点。
所以同一个 Q4_0 标签下面,至少藏着三笔不同的账。模型原本是否耐量化,校准或蒸馏时看过什么数据,量化误差有没有进入训练过程。只看位宽,等于买二手车只看排量,不看保养记录。
这也是为什么社区里经常出现很拧巴的争论。有人说某模型 Q4 完全够用,有人说工具调用一压就坏,双方可能都没撒谎。他们下载的虽然都叫 Q4,原始权重、量化配方、聊天模板和任务分布却不是一回事。
这 97% 到底靠不靠谱
Liquid AI 这次没有只给一张平均分总表。官方拿原先由 PTQ 生成的 Q4_0 GGUF、新的 QAD Q4_0 和 BF16 GGUF 做对照,评测覆盖 GPQA Diamond、MMLU-Pro、IFEval、IFBench、Multi-IF 与 BFCLv4。
这里面既有知识和推理,也有指令遵循、函数调用与多轮任务。230M 和 350M 额外跑 GSM8K,1.2B 与 2.6B 跑 AIME25,每个结果重复五次再取平均。
这个设计挺重要。端侧模型真正容易在量化后露馅的,不一定是闲聊,而是格式约束、参数选择和连续执行。回答听起来还挺顺,JSON 少一个括号,银行工具选错一个枚举,Agent 就可以原地躺平。
厉害了,模型质量终归要在最不起眼的 schema 上结账。
官方结果里,四款 QAD Q4_0 都明显高于普通 PTQ Q4_0。更有意思的对照发生在高一档的量化格式上。230M 和 350M 的 QAD Q4_0,在评测波动范围内追平 Q5_K_M,解码吞吐还高 4% 到 33%。1.2B 和 2.6B 则追平 Q4_K_M,吞吐高 3% 到 14%。在可比较的 230M 与 1.2B 上,它也追平了 Unsloth 的 UD-Q4_K_XL。
也就是说,过去想用更多位换回来的质量,现在有一部分可以在训练阶段拿回来。对手机、树莓派和小内存机器,这不是排行榜里半个点的浪漫,而是能不能少占一档内存、少等一截生成时间。
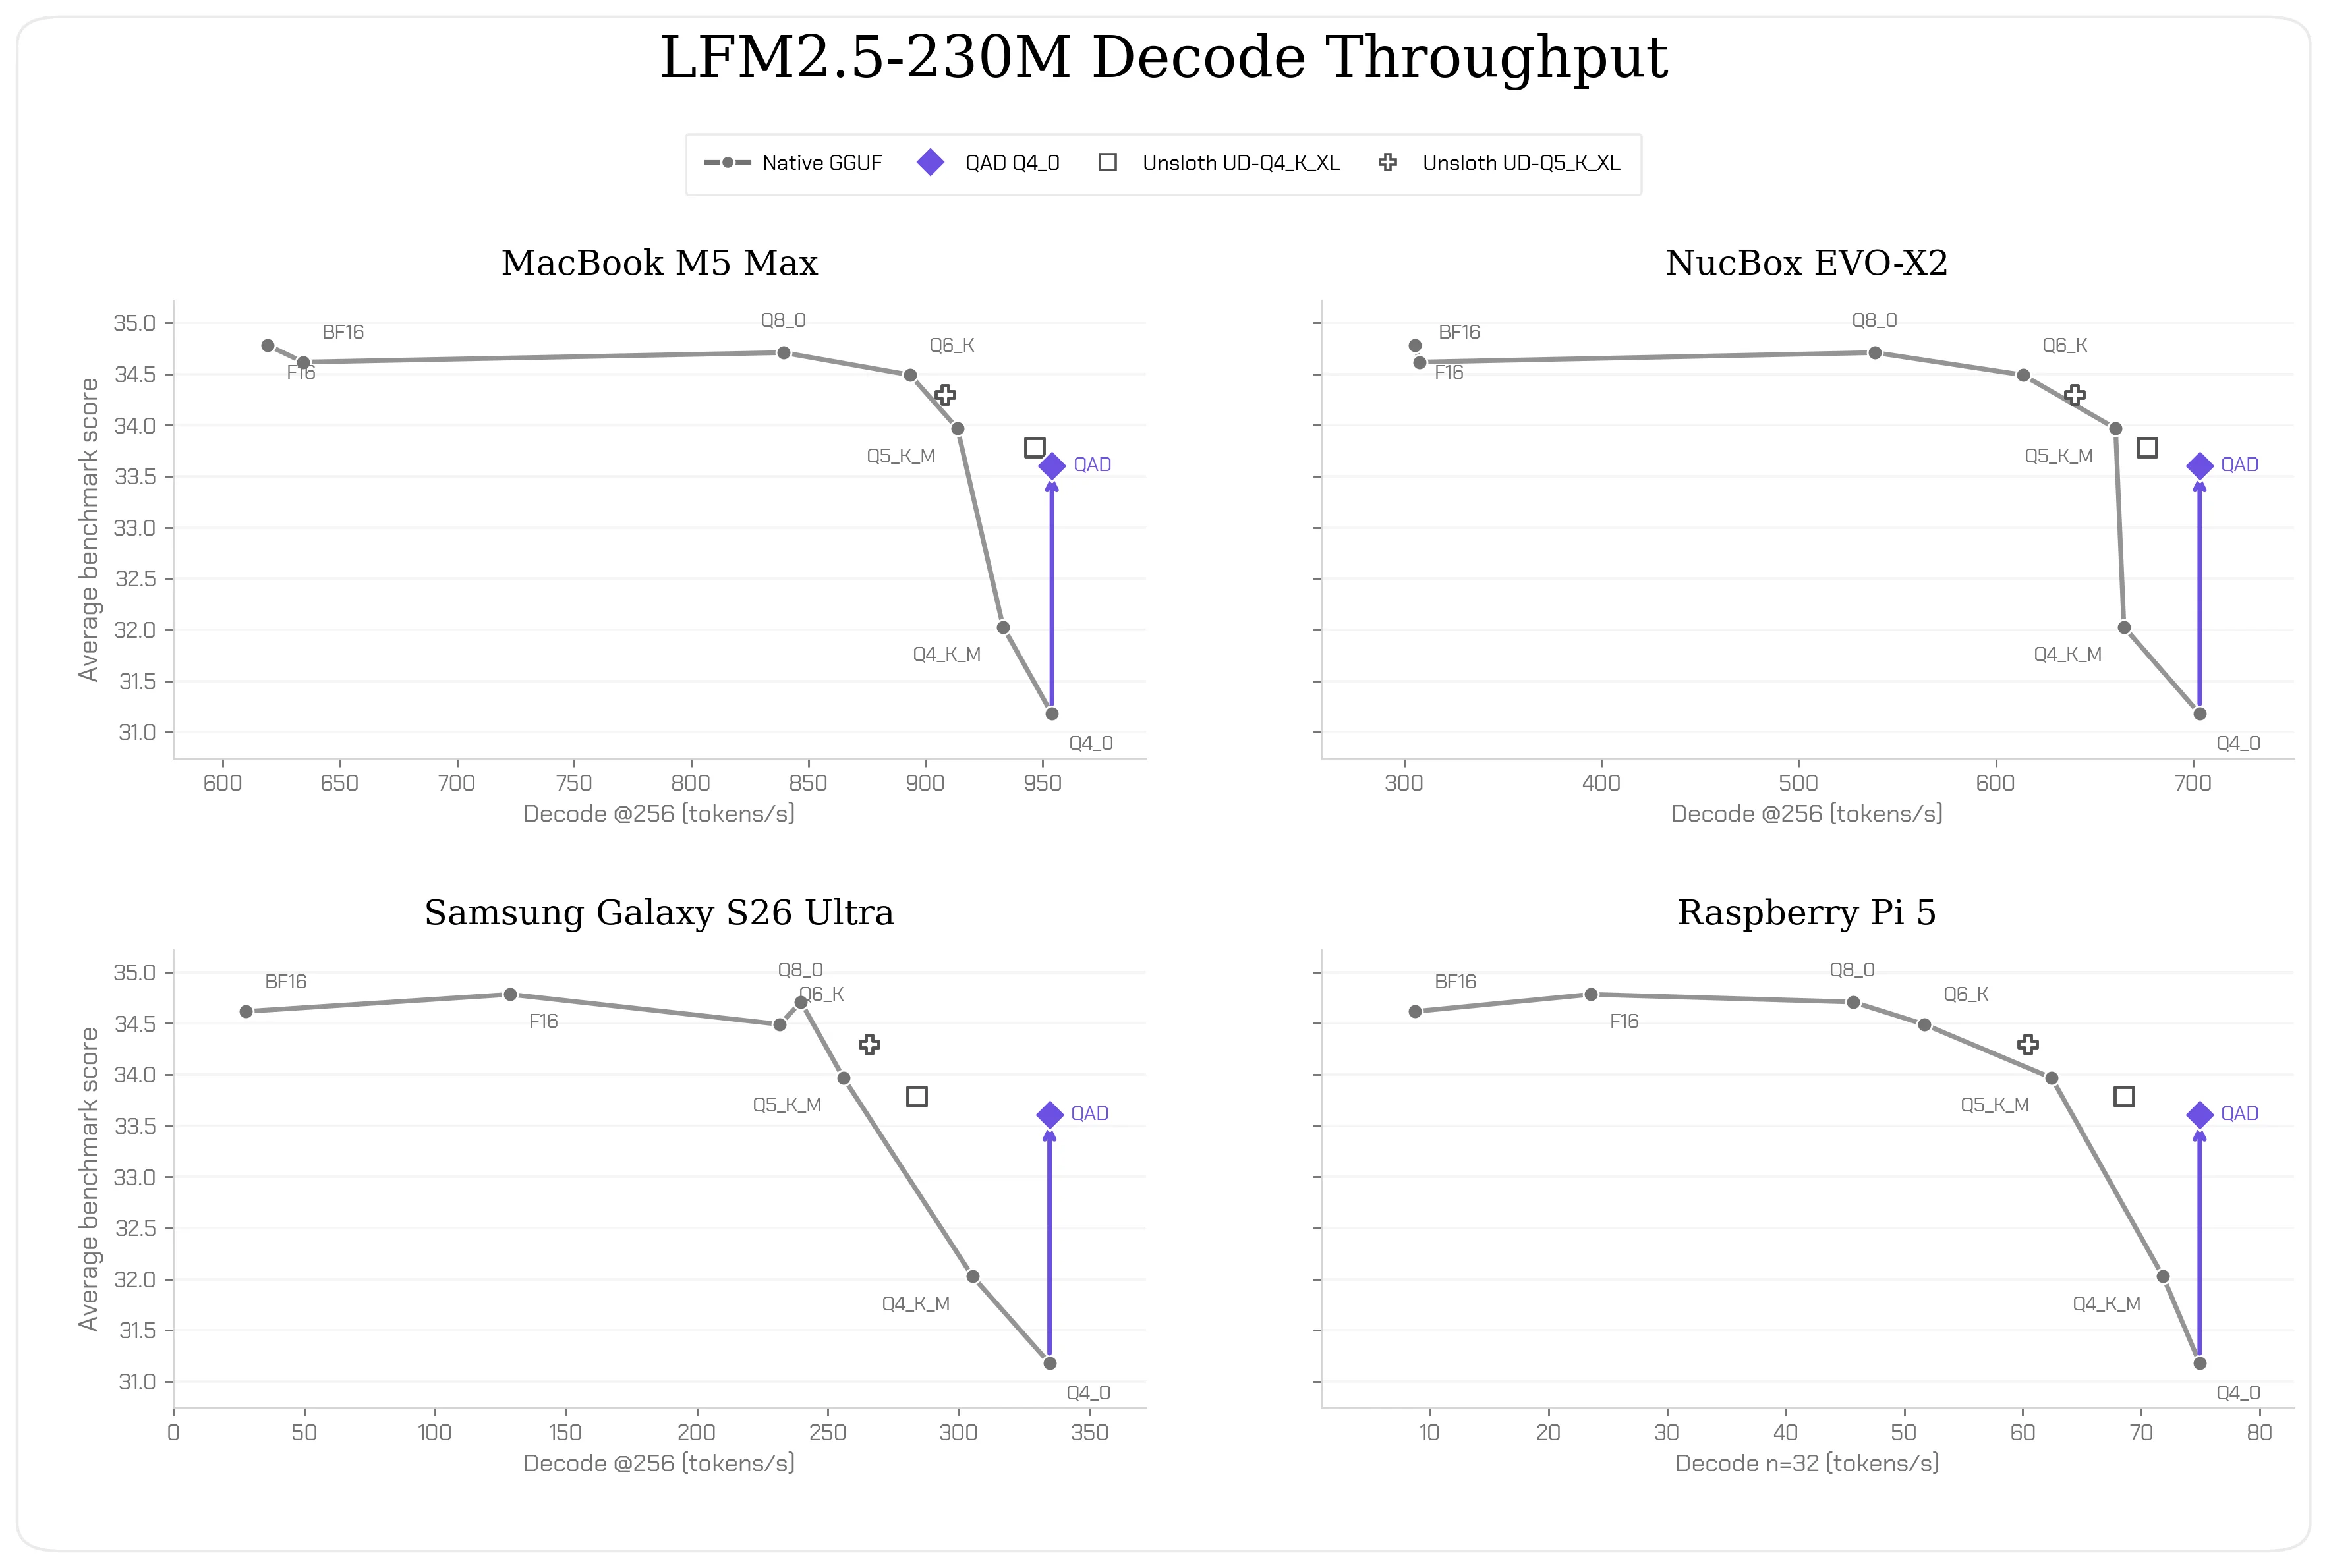
230M 检查点在 Mac、迷你主机、手机和树莓派上都把 Q4_0 的质量向上拉,同时保留同档速度。
官方还把吞吐放到 MacBook Pro、NucBox EVO-X2、Samsung Galaxy S26 Ultra 和 Raspberry Pi 5 上跑。前两类用 GPU,手机与树莓派用 Arm CPU。这个测试没有证明所有设备都会获得同样收益,却至少把模型从桌面显卡搬到了真实的端侧约束里。
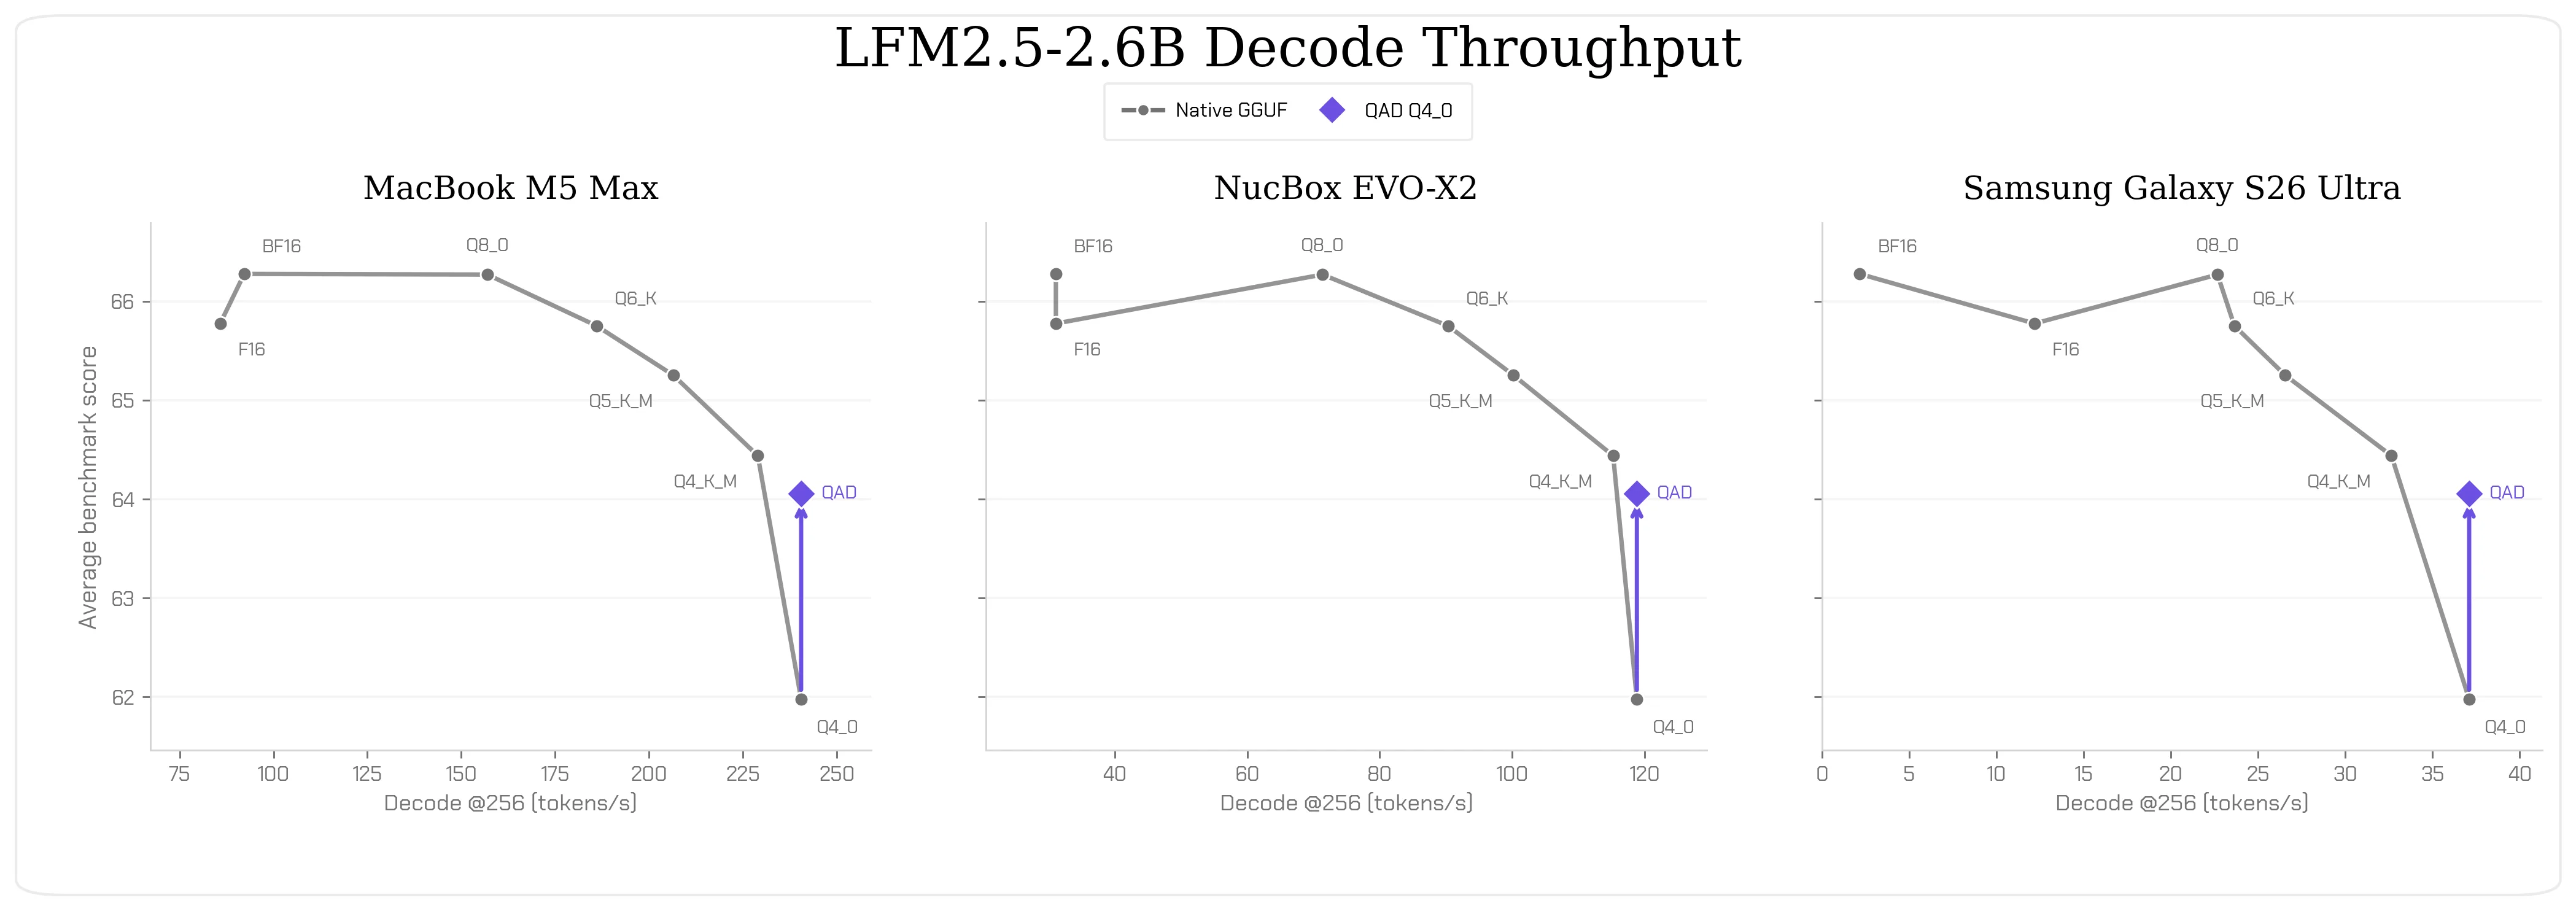
2.6B 的 QAD Q4_0 仍沿用原生 Q4_0 吞吐,却把平均评测分数从约 62 拉到约 64。
坦率讲,仍然有三块边界不能被 97% 遮住。
第一块是评测分布。官方套件对英语推理、指令遵循和工具调用覆盖得不错,不等于你的中文客服、本地知识库或设备控制协议也会保住同样比例。校准和蒸馏越贴近某类分布,团队越要问一句,离开这片水域以后还剩多少。
第二块是平均值。平均追回 97% 的损失,不保证每个任务都追回 97%。生产 Agent 最怕的往往是一个低频动作突然从 99% 掉到 92%,平均分甚至看不出那根断掉的保险丝。
第三块是维护成本。每种模型、每个量化档、每次权重更新都可能需要专门训练和验证。QAD 把推理成本压低了,却没有让训练与发布成本消失。模型更新得很勤时,团队可能会在 BF16、Q4_0、Q4_K_M、ONNX 与不同硬件后端之间养出一片版本丛林。
所以别把 QAD 理解成一个免费的后处理按钮。它更像模型供应方为特定部署档位做的一次正式编译。用户拿到的是更干净的二进制,维护者承担的是多一条构建和验收流水线。
跑本地模型的人该改什么
最直接的动作很简单,别再默认同位宽 GGUF 可以互换。
Liquid AI 已经把四款 QAD 文件放进官方仓库,包括 230M、350M、1.2B-Instruct 与 2.6B。如果你已经在用这一家族,可以保留原 PTQ Q4_0,拿相同 prompt、相同模板、相同采样参数做一轮 A/B。
官方给的启动命令并不神秘。
llama-cli -hf LiquidAI/LFM2.5-350M \
  --hf-file LFM2.5-350M-QAD-Q4_0.gguf \
  -p "What is C. elegans?"
真正要花时间的不是把命令跑起来,而是准备一小组会让你的应用翻车的任务。做工具调用,就放缺参数、错枚举、重复重试和长上下文里的指令冲突。做中文抽取,就放真实字段、否定表达、空值和混合标点。做设备端路由,就看冷启动、峰值内存、每秒 token 数和连续运行后的温度降频。
可能有朋友纳闷,官方已经跑了那么多榜,自己还测什么。
因为你的验收目标不是证明 QAD 先进,而是确认这一个文件能不能替换线上那一个文件。前者看论文,后者看差异样本。只要把两版输出放在同一张表里,标出成功、格式错误、工具选错、超时和内存峰值,很多争论十分钟就能结束。
这块还有一个很现实的判断。假如普通 PTQ Q4_0 已经在你的任务上稳定通过,QAD 可能不会带来可见收益。假如你目前靠 Q5_K_M 才能守住质量,而设备又被内存或吞吐卡住,新检查点才值得认真测。省下来的不是几个百分点,是从 Q5 回到 Q4 后整条部署线获得的余量。
对模型开发团队,门槛会再高一层。以后发布量化模型,只扔一批自动转换文件可能不够了。用户会开始追问,这个 Q4 是从 BF16 直接压出来的,还是在量化约束里训练过;评测跑了几次;工具调用与长任务有没有单独验收;同一格式在手机、CPU 和桌面 GPU 上是否都测过。
这套追问对小模型尤其狠。2.6B 模型少掉一两个百分点也许还能靠冗余能力扛住,230M 的能力余量本来就薄,量化误差更容易吃掉关键动作。Liquid AI 把 230M 一起放进 QAD 阵容,某种程度上比只优化最大模型更有意思。越小的船,越经不起无声漏水。
说真的,我挺喜欢这次发布给出的方向。过去端侧模型的竞争很像压缩比赛,谁能把文件再缩一点、速度再挤一点。QAD 往前走了一步,它不只问怎样把模型压小,还问怎样让模型从训练时就学会在小盒子里生活。
格式没有变,运行命令也没有变。
变的是文件背后的训练契约。
以后再看到一长排 GGUF,别只盯着 Q4、Q5、Q6。那个短短的后缀告诉你箱子多大,却不告诉你里面的人会不会游泳。