posts/ling3-batch1-speculative-decode.md
Ling 跑到 1120 tok/s,投机解码别照抄
如果你把 1120 tok/s 直接填进容量规划,会发生什么?
最乐观的答案,是一个 1024 token 的回答,纸面上不到一秒就能吐完。
更常见的答案,是线上流量把这张表改成另一道题。
好家伙,这个数字放进任何一张模型推理 PPT,旁边都该配一根冲出屏幕的箭头。
它来自 RadixArk SGLang 团队和蚂蚁 Ling Infra 团队刚发的官方优化记录。他们在 4 块 NVIDIA B200、TP4、bf16、并发 1 的环境里,把 Ling-3.0-flash 的 NEXTN 路径从 288 tok/s 推到 606 tok/s,又用 DSpark 做到 1120 tok/s。
确实有点子牛逼。
但如果现在就把 1120 填进容量规划,值班群大概很快会教你重新认识单位。
因为这个数字后面跟着一串条件。固定 8192 token 输入,固定 1024 token 输出,随机合成请求,贪心解码,单并发,同一台机器。DSpark 的平均接受长度是 9.95,而接受长度会跟 prompt、输出内容和采样参数一起变。
官方自己把这些小字写得很清楚。可热闹传播时,小字总是第一个掉下船。
我更想聊的是,1120 tok/s 到底由什么拼出来,以及我们该怎么判断它能不能搬进自己的服务。
先把三个速度拆开
这次优化有两段跃迁。
第一段是 NEXTN,从 288 tok/s 到 606 tok/s,平均 TPOT 从 3.33 毫秒降到 1.53 毫秒。TPOT 是 time per output token,也就是生成阶段每个输出 token 平均花多久。
第二段换成 DSpark,在同机 1000 请求对比里做到 1120 tok/s,平均 TPOT 0.78 毫秒,接受长度 9.95。与调优后的 NEXTN 相比,平均 TPOT 又低了 1.9 倍。
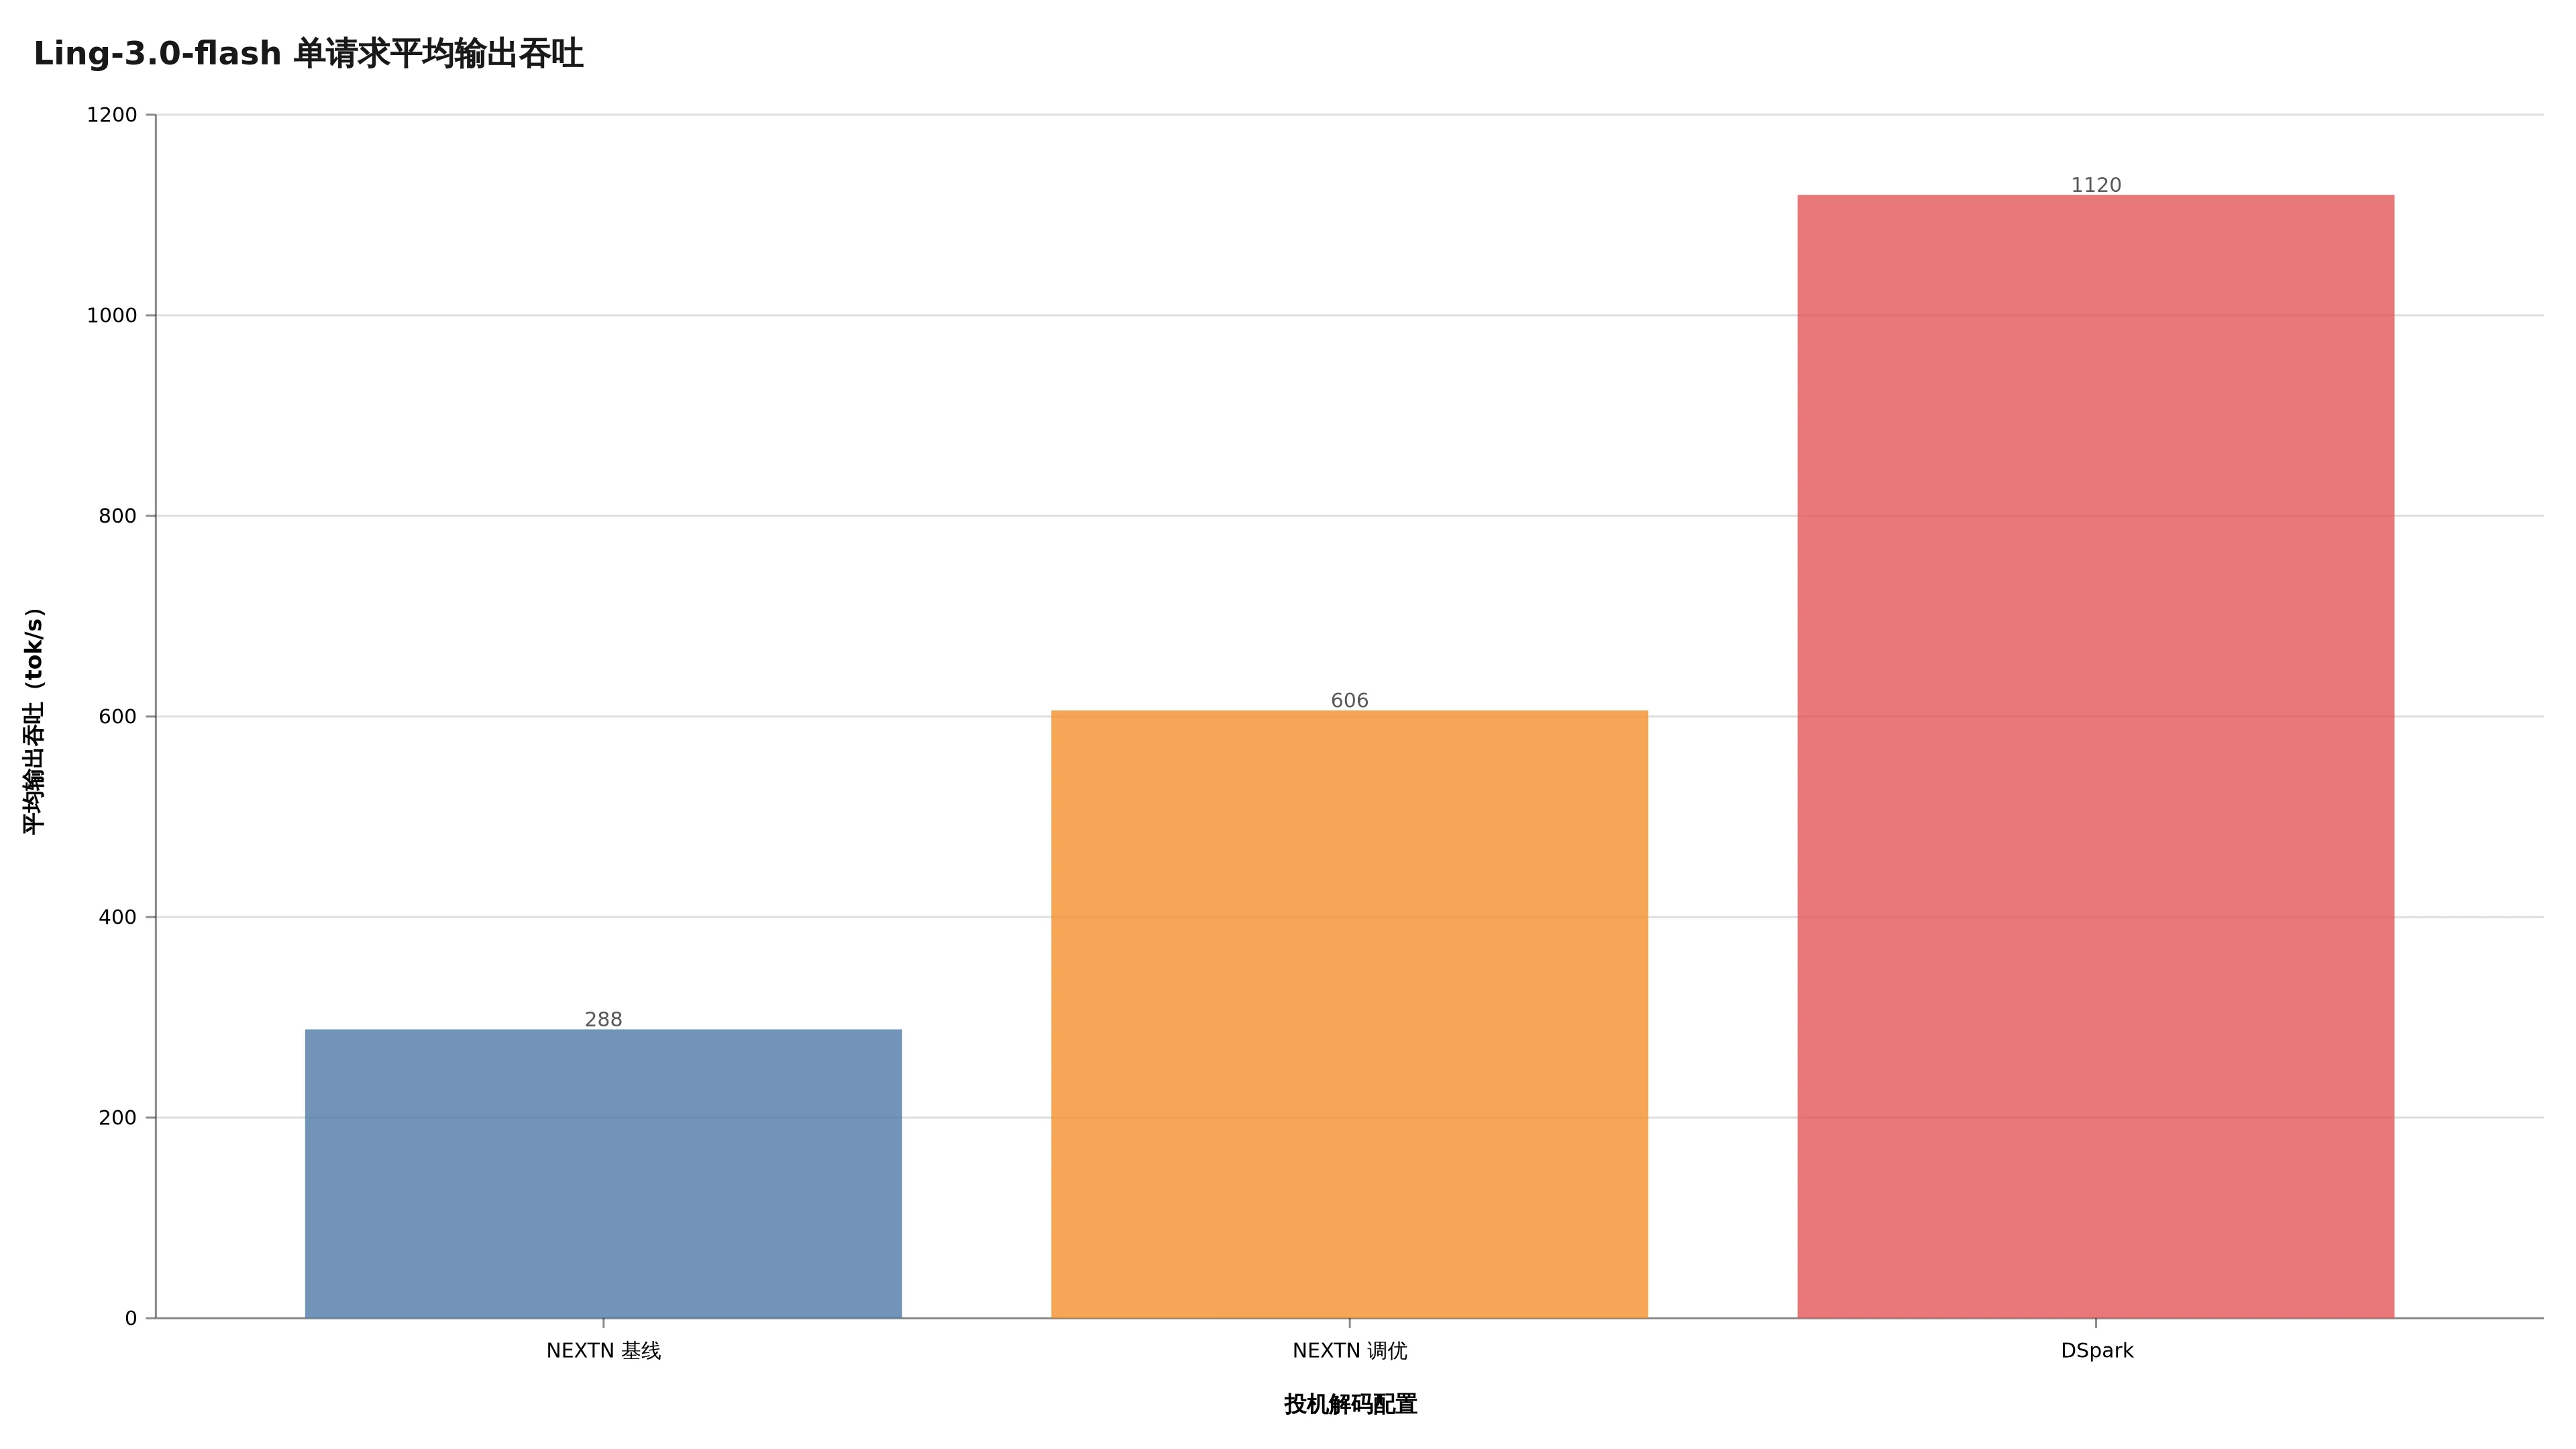
数据来自 LMSYS 官方同机测试,负载为 8192 输入、1024 输出、并发 1、贪心解码。
图很好看,但它不是用户等待时间的完整答案。
SGLang 的 benchmark 定义里,TPOT 不包含 TTFT。TTFT 是 time to first token,用户点下发送到看到第一个字的等待。输出吞吐则用总输出 token 除以整段墙钟时间,会把首字等待、调度和收尾都算进去。
所以哪怕并发只有 1,1 / TPOT 也不等于整条请求的吞吐。
假设你的 Agent 每次只回几十个 token,却要先读一大坨工具结果,TTFT 可能比后面的 decode 更有体感。反过来,长文生成才更容易吃到极低 TPOT 的红利。
这就是第一道验收题。别只问每秒多少 token,要把首字、生成、整条请求分开看。
还有个很容易被忽略的细节。最终 9.95 的接受长度来自 block size 16 的 DSpark 草稿,公开的 DSpark checkpoint用的是 block size 8。你下载公开权重照着启动,不该默认复现同一个 9.95。
厉害了,跑分还没开始,实验条件已经少了一半。
投机解码快不快,接受长度说了算
投机解码可以理解成一个便宜的草稿员先往前写,完整大模型一次验收一串 token。验收通过的直接提交,错的从分岔处重来。
它能提速,靠的是一次昂贵的目标模型 forward 提交多个 token。草稿写得再快,如果目标模型每轮只肯收一个,整套流程就会变成多请了一个人,还天天返工。
官方给了三档 NEXTN 深度的实测。3 步草稿平均接受 3.11 个 token,TPOT 1.51 毫秒。4 步接受 3.37 个,TPOT 降到 1.45 毫秒。继续加到 5 步,接受长度只涨到 3.45,步长却从 4.89 毫秒涨到 5.35 毫秒,TPOT 反而退到 1.55 毫秒。
多猜,不一定更快。
原因并不玄。Batch-1 下,完整模型验证 4 个或 6 个 token 都要读一遍权重,固定成本差不多。多一层草稿只划算到边际接受收益盖过新增草稿与递归计算成本为止。原文给的粗略盈亏线是 Δaccept > 0.05 × accept。
更麻烦的是,最优点会移动。底层 kernel 融合后,原本不划算的 5 步又变成更优配置。权重换成 fp8,固定成本继续缩,深度还得重新扫。
这块我自己的感受是,投机深度根本不是一个配置项,它是一场持续实验。
代码生成、中文对话、JSON 工具调用、长推理,它们的 token 分布不一样。温度从 0 调到 0.7,草稿和目标模型分歧也会变。只在随机 token 上测出接受长度 9.95,然后把它当生产常数,跟拿 localhost 延迟报 SLA 差不多。
别急着找万能参数,没有。
Ling-3.0-flash 的官方模型卡给了低延迟配置,但它更像起跑线。真正要扫的是你自己的请求桶,每个桶单独看接受长度、任务质量和回退比例。
最值钱的修复,居然是别等 CPU
这篇官方记录最让我喜欢的,不是某个炫技 kernel,而是团队先找到了两种完全不同的空闲。
一种空闲在 CUDA Graph 之间。Host 每一步准备 metadata、重放三张图、处理结果,速度跟不上 GPU,图与图之间就出现几条很宽的白缝。
另一种空闲在图里面。几百个 1.5 到 6 微秒的小 kernel 排成一列,启动和前导成本已经快赶上计算本身,再加上 MoE 专家权重从 HBM 冷读,空隙很多却很细。
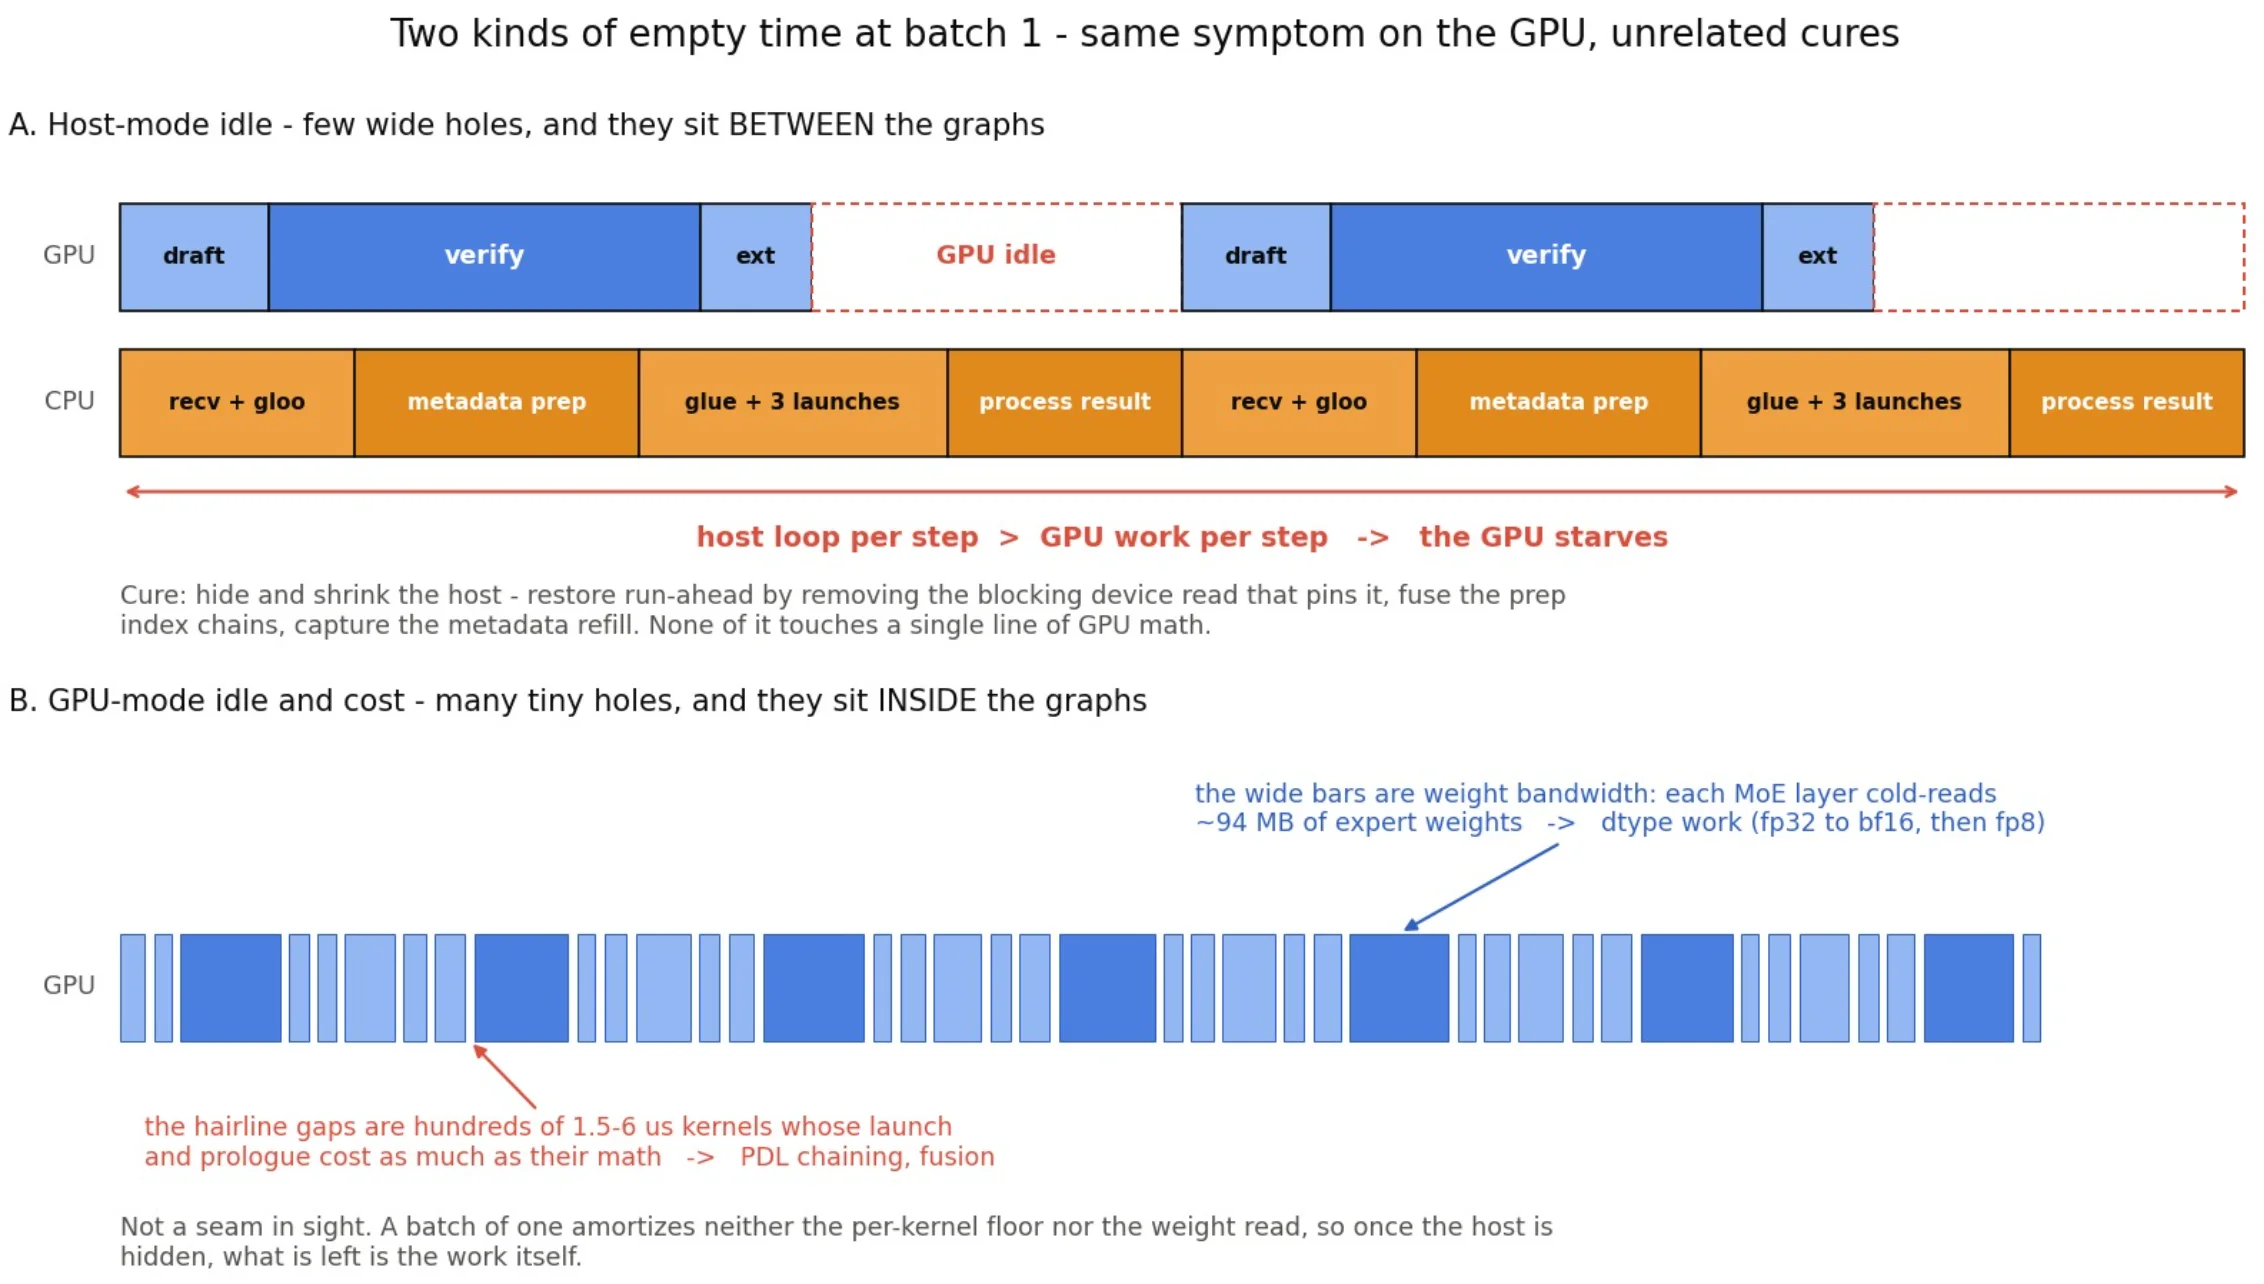
上半部分要修 Host 同步,下半部分要修 kernel 启动、融合与权重带宽。症状都叫 GPU 空闲,药方完全不是一回事。
最初的 NEXTN 路径里,FutureMap.resolve_seq_lens_cpu() 每一步都会把 new_seq_lens 从 GPU 拉回 CPU,再做一次同步。那几字节数据不贵,贵的是 CPU 会等上一张 verify 图彻底跑完。中位数 485 微秒,Host 的 run-ahead 每一步都被清零。
团队检查后发现,KDA 后端根本不需要 CPU 上的序列长度,只是继承了默认的 needs_cpu_seq_lens = True。改成 False,上一步把结果留在 GPU 常驻缓冲区,下一步按请求索引直接读,CPU 就能提前把后续图排进队列。
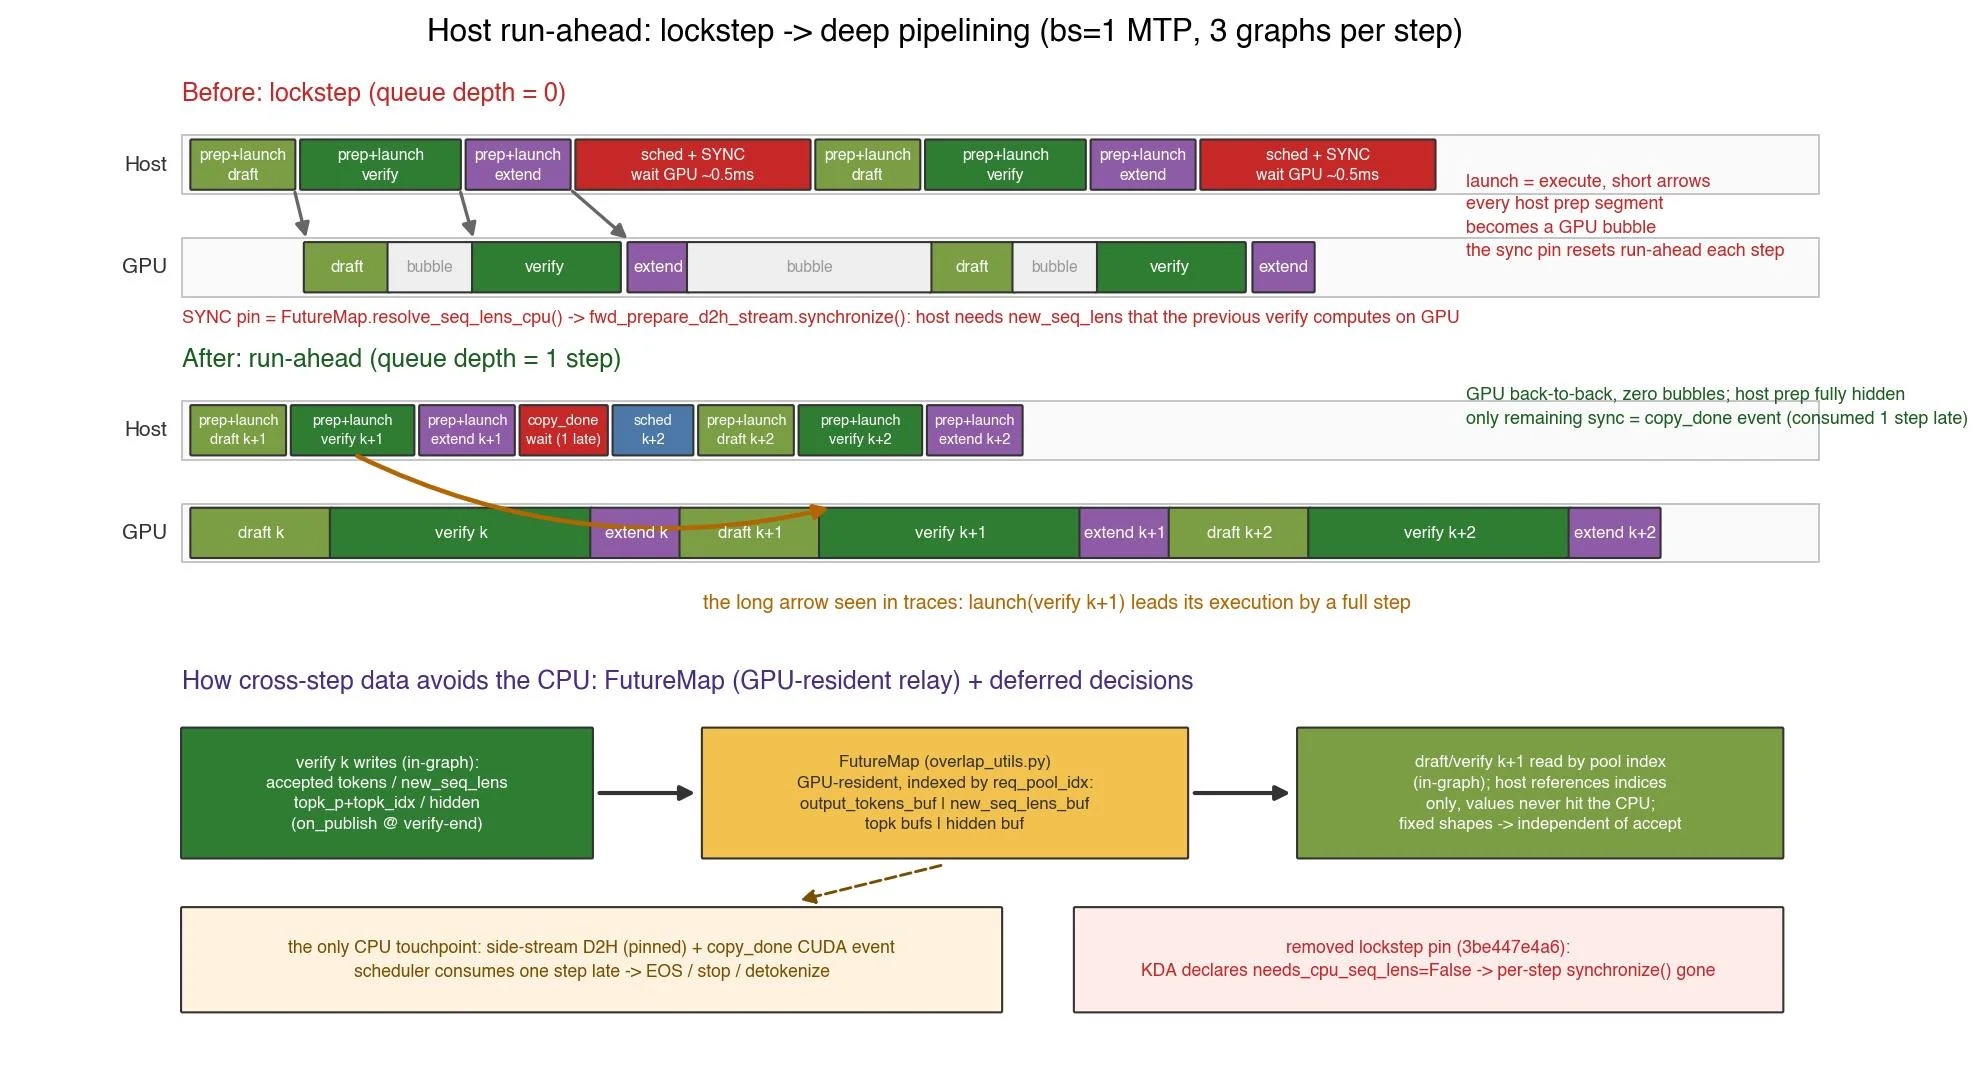
结果不再绕回 CPU,Draft、Verify 与 Extend 三张图得以在 GPU 上背靠背执行。
你看,这个修复没有换模型,没有多买卡,也没有把某个矩阵乘写成火星语。只是删掉一次不必要的设备到主机阻塞读取,整条流水线就松了。
DSpark 后面又踩了一次同样的坑。FlashInfer 的 plan() 会对几个设备数组执行阻塞 .to("cpu"),第一版 trace 里 GPU 空闲 4.99 毫秒,占一步的 47%。团队改成由 Host 用已知长度直接构造计划,三次阻塞 D2H 和四次设备缓冲刷新没了,GPU 又能连起来跑。
同一个性能 bug,换了个函数名,回来敲了两次门。
这事挺像很多 Agent 流水线。我们盯着模型推理耗时抠 50 毫秒,结果外面一个同步日志、串行工具调用或者重复 JSON 编解码,安安静静吃掉半秒。看到 GPU utilization 掉了,别第一反应就换 kernel。先问白缝在图里,还是图外。
剩下的速度,才轮到硬核优化
Host 被藏起来之后,团队才开始挤 GPU 地板。
PDL,也就是 Programmatic Dependent Launch,让消费者 kernel 在生产者尚未完全结束时先上 SM,把不依赖上游结果的权重预取和前导工作做掉,真正读数据前再等。MoE 主链、Router 链和 KDA 链都被接了起来。
它也不是白送的。大 batch 下,过早放出消费者会抢生产者的 SM,所以代码只在小 M 条件启用。那种「打开一个环境变量,全场快 30%」的故事,在真实推理栈里基本不存在。
接着是两次融合、一次 KDA retune,再把 router gate 和 lm_head 从 fp32 改成 bf16。Batch-1 时这两块主要卡权重带宽,字节减半,端到端大约再拿到 10%。改 dtype 会改变舍入路径,团队没有拿宽松 tolerance 糊过去,而是把哪些改动保持 bit parity、哪些改用接受长度和任务指标验收写清楚。
测量纪律也很硬。Nsight Systems 的 CUPTI trace 会给 Host 事件加开销,同一配置在 profile 里是 5.2 毫秒一步,未 profile 的反推值约 4.9 毫秒。热缓存微基准里 7 微秒的 gate kernel,放回真实冷权重路径会变成 11 微秒。固定 1 秒窗口的峰值还有约正负 5% 相位波动。
所以他们用平均 TPOT 乘平均接受长度做 A/B,不追单个窗口峰值。每个改动还要过 256 token 贪心生成逐字节比对、接受长度变化与状态污染检查。
这一段比 1120 更值得抄。
不是抄它的参数,是抄它允许实验失败的方式。
上线前,先写一份会拒绝你的合同
如果手里正好有 4 块 Blackwell,可以照官方复现命令跑第一遍。跑通以后先别发庆功截图,把流量切成真实场景桶。
代码补全一桶,中文对话一桶,工具调用一桶,长上下文报告一桶。每桶都带上真实输入长度、输出长度、采样参数和并发档位,然后写一份能拒绝上线的合同。
workload:
  scenarios: [coding, zh_chat, tool_calling, long_report]
  concurrency: [1, 4, 16]
latency:
  p95_ttft_ms: "不高于当前基线"
  p95_tpot_ms: "不高于约定预算"
  p99_end_to_end_ms: "不高于当前基线"
speculation:
  accept_length: "按场景分别报告"
  fallback_ratio: "不高于约定预算"
quality:
  task_success_rate: "不得回归"
  invalid_tool_call_rate: "不得回归"
correctness:
  greedy_256_tokens: "dtype 不变时逐字节一致"
operations:
  warmup_and_cold_runs: true
  rollback_ready: true
合同里的阈值别照抄别人,要从你现在的线上基线和业务容忍度里长出来。还要同时保留 warm run 与 cold run。只测热缓存,就会把机房里的第一次请求写成不存在。
如果接受长度只在随机负载漂亮,真实工具调用掉到 1 点几,那就关掉投机解码。如果 TPOT 降了一半,TTFT 与端到端 p99 却没动,也别给它记双倍功劳。如果 dtype 优化让任务成功率掉了,吞吐再高也只是更快地产生返工。
棒棒的,1120 tok/s 当然值得兴奋。
但能搬进生产的从来不是一个数字。
是那套让数字过不了关时,敢把开关关掉的验收方式。