posts/ling3-tiny-local-agent.md
Ling-3.0-tiny 很快,但还不是开箱即用
一台 M4 Pro MacBook,一秒吐出接近 90 个 token,峰值内存大约 8.34 GiB。
这不是云端 API,也不是把提示词缩成一句话后的瞬时数字。蚂蚁百灵刚在官方发布稿里开源 Ling-3.0-tiny,总参数 7.9B,每个 token 只激活 1.3B。官方给出的 FP8 测试里,M4 Pro 能跑到 86 至 90 tok/s,DGX Spark 则在 100 至 105 tok/s 左右。
好家伙,小模型的速度表又被往右拽了一截。
但我更在意的不是跑分表里多了一根柱子,而是另一个很工程的问题。一个模型快到这个程度,本地 Agent 能不能终于从「偶尔开起来玩一下」,变成一项可以常驻的基础服务?
我的判断可能有点扫兴。Ling-3.0-tiny 已经跨过了速度门槛,却还没有跨过开箱即用的门槛。
这两个门槛,差得挺远。
近 90 tok/s,值钱的是 Agent 少等了几轮
普通聊天里,模型从 30 tok/s 涨到 90 tok/s,感受往往只是回答出现得更快。读一段几百字的答案,快两秒慢两秒,确实没有那么戏剧化。
Agent 不一样。
一次看起来简单的任务,背后可能要跑好几轮。模型先读上下文,决定调用哪个工具,等工具返回,再读结果,发现参数不对,修一次,重新调用,收尾还要检查输出能不能交付。只要中间有一次 JSON 格式错了,循环就会再转一圈。
单轮慢三秒,六轮就是十八秒。中间再碰上一次超时重试,人已经切去刷消息了。等模型终于把结果放回来,原来的注意力早没了。
所以本地 Agent 的速度不能只看一段文本生成得多快,要看整个工具循环多久能闭合一次。86 至 90 tok/s 真正有点子牛逼的地方,是它有机会把每轮等待压到人还能保持注意力的范围内。
官方模型卡还给了另一组数据。Ling-3.0-tiny 在 Artificial Analysis 的输出速度超过 160 tok/s,生成一段 500 token 的回答,连思考时间算在内,端到端延迟大约 18 秒。两个数字来自不同环境,不能混着喊「它稳定 160」。可它们共同指向一件事,1.3B 激活参数确实把计算成本压到了一个很有吸引力的位置。
这对常驻服务尤其重要。
本地代码检索、文档分类、结构化提取、低风险工具路由,这些任务不需要每次都请云端旗舰模型出场。若一台已经放在工位上的 Mac 能以可接受的延迟处理,隐私数据不用离开本机,API 账单也不会随着后台轮询一直跳。
很多朋友可能会顺势得出一个结论,1.3B 都跑这么快了,那 16GB 内存的 Mac 随便装,Ollama 一条命令开起来,云端 Agent 可以退群了。
别急。
参数表最会在这个地方给人挖坑。
激活 1.3B,不等于只装 1.3B
Ling-3.0-tiny 是稀疏 MoE,也就是混合专家模型。它有 128 个路由专家,每个 token 会选中 8 个路由专家,再加 1 个共享专家参与计算。前面的注意力层则按 3 比 1 交替堆叠 KDA 与 MLA,试图同时照顾长上下文和计算效率。
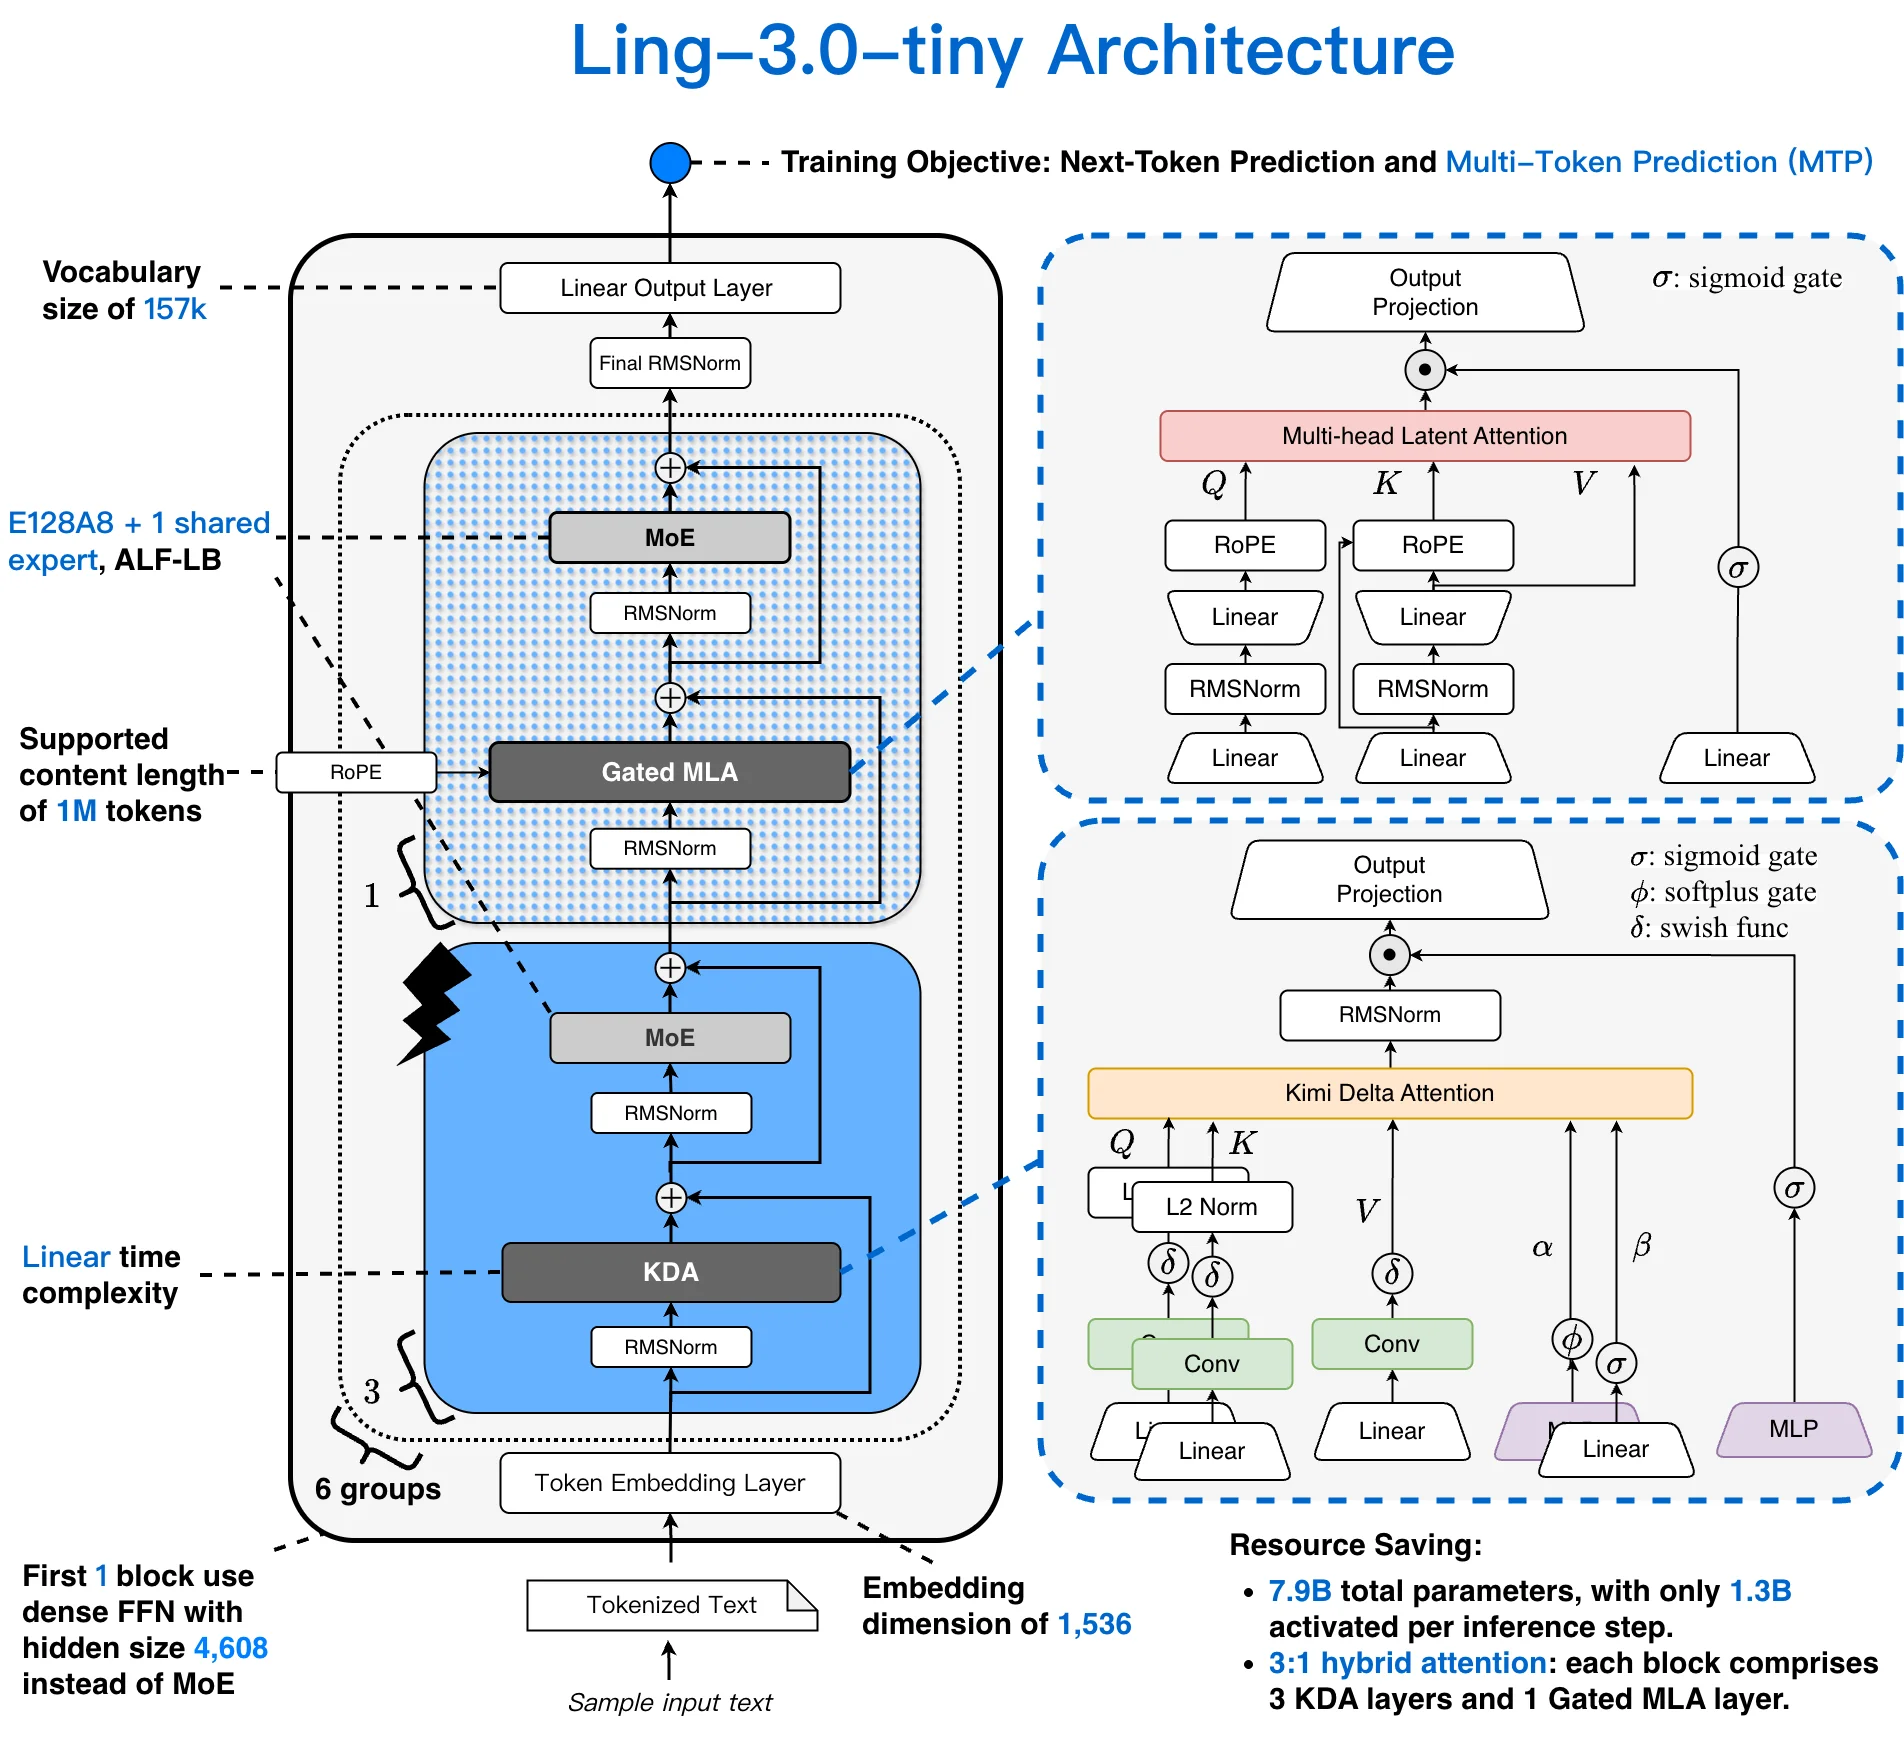
官方架构图把省下来的计算画得很清楚,7.9B 总参数仍在,单步只激活 1.3B。
MoE 的好处很直观。每一步只叫一部分专家上班,计算量跟着降下来。可公司办公室还得把所有人装进去。7.9B 总参数依然要存进内存,1.3B 描述的是每个 token 的计算活跃量,不是模型文件只剩 1.3B。
这点很容易被漂亮标题吃掉。
官方的 8.34 GiB 峰值数字有明确条件,M4 Pro、FP8 权重、8K 上下文。换成 BF16,权重占用会变。把上下文从 8K 拉到 128K,KV cache 和状态缓存也会继续吃内存。再把检索结果、工具返回、失败轨迹全塞进会话,资源曲线不会因为模型名字里有 tiny 就突然讲武德。
而且,官方验证 Ollama 路径用的是一台 48GB 统一内存的 M4 Pro Mac。它证明 Apple Silicon 能跑,不等于证明每台 16GB Mac 都能以相同配方、相同上下文和相同速度工作。
坦率讲,我很喜欢 1.3B 激活参数这个方向。它比单纯把模型做小更有想象力,既保留更大的参数池,又不让每一步都付全款。但工程决策不能只看激活量,至少还得把四个数字摆在一起看,权重格式、总权重占用、目标上下文长度、并发数。
少一个,部署估算就可能从「今晚能跑」滑到 out of memory。
厉害了,模型名字叫 tiny,算内存时一点都不能 tiny。
模型开源了,运行时还在路上
真正让我没敢把「开箱即用」写进标题的,是官方 Quickstart。
如果你走 SGLang Cookbook,官方给的是专门追踪 Ling-3.0 的开发镜像。低延迟配方还会用 MTP 或 NEXTN 做推测解码,并通过 YaRN 把上下文配置到 256K。这个方案很完整,但示例硬件是一张 141GB 级 H20-3e 或 Blackwell GPU。
很强,也很数据中心。
如果你走 vLLM,文档要求拉取 InclusionAI 的 ling_3_0 分支,再以 editable 模式安装。启动参数里还要打开 prefix cache、mamba-cache-mode、自动工具选择,以及 Ling 专用的 reasoning parser 和 tool-call parser。
如果你想在 Mac 上走 Ollama,情况更有意思。官方步骤不是 ollama run,而是从源码构建 Ollama,再手动拉取尚未合并进正式版的 PR 17643。当前说明还特意写明,只支持 Apple Silicon 上的 MLX 路径。
这不是挑刺。新架构刚发布时,运行时跟进需要时间,很正常。KDA、MLA、稀疏专家路由、思考内容解析、工具调用格式,任何一层没对齐,都可能让模型权重明明下载好了,服务却在启动阶段直接报错。
只是「权重公开」和「生态稳定」真不是同一天发生的事。
很多本地模型的发布流程都像一艘新船下水。船体已经碰到海面,发动机也点着了,码头的加油管、维修手册、救生艇检查还在后面追。早期玩家当然可以上去,甚至会觉得这种折腾很快乐。可要把它塞进团队日常,就得问一句,值班的人愿不愿意在凌晨处理一个只存在于开发分支里的兼容问题?
我自己的感受是,运行时进入正式版,往往比模型榜单再高两分更重要。
因为榜单失败会让你少发一条漂亮截图,运行时失败会让服务根本起不来。
会调用工具,不等于你的工具能被它稳定调用
Ling-3.0-tiny 的定位里反复出现 Agent 能力。官方评测覆盖通用 Agent 任务和 coding,Artificial Analysis Intelligence Index 得分 25,Agentic Index 得分 16。Terminal-Bench 2.1 还用了统一两小时超时,每个任务跑三次取均值。
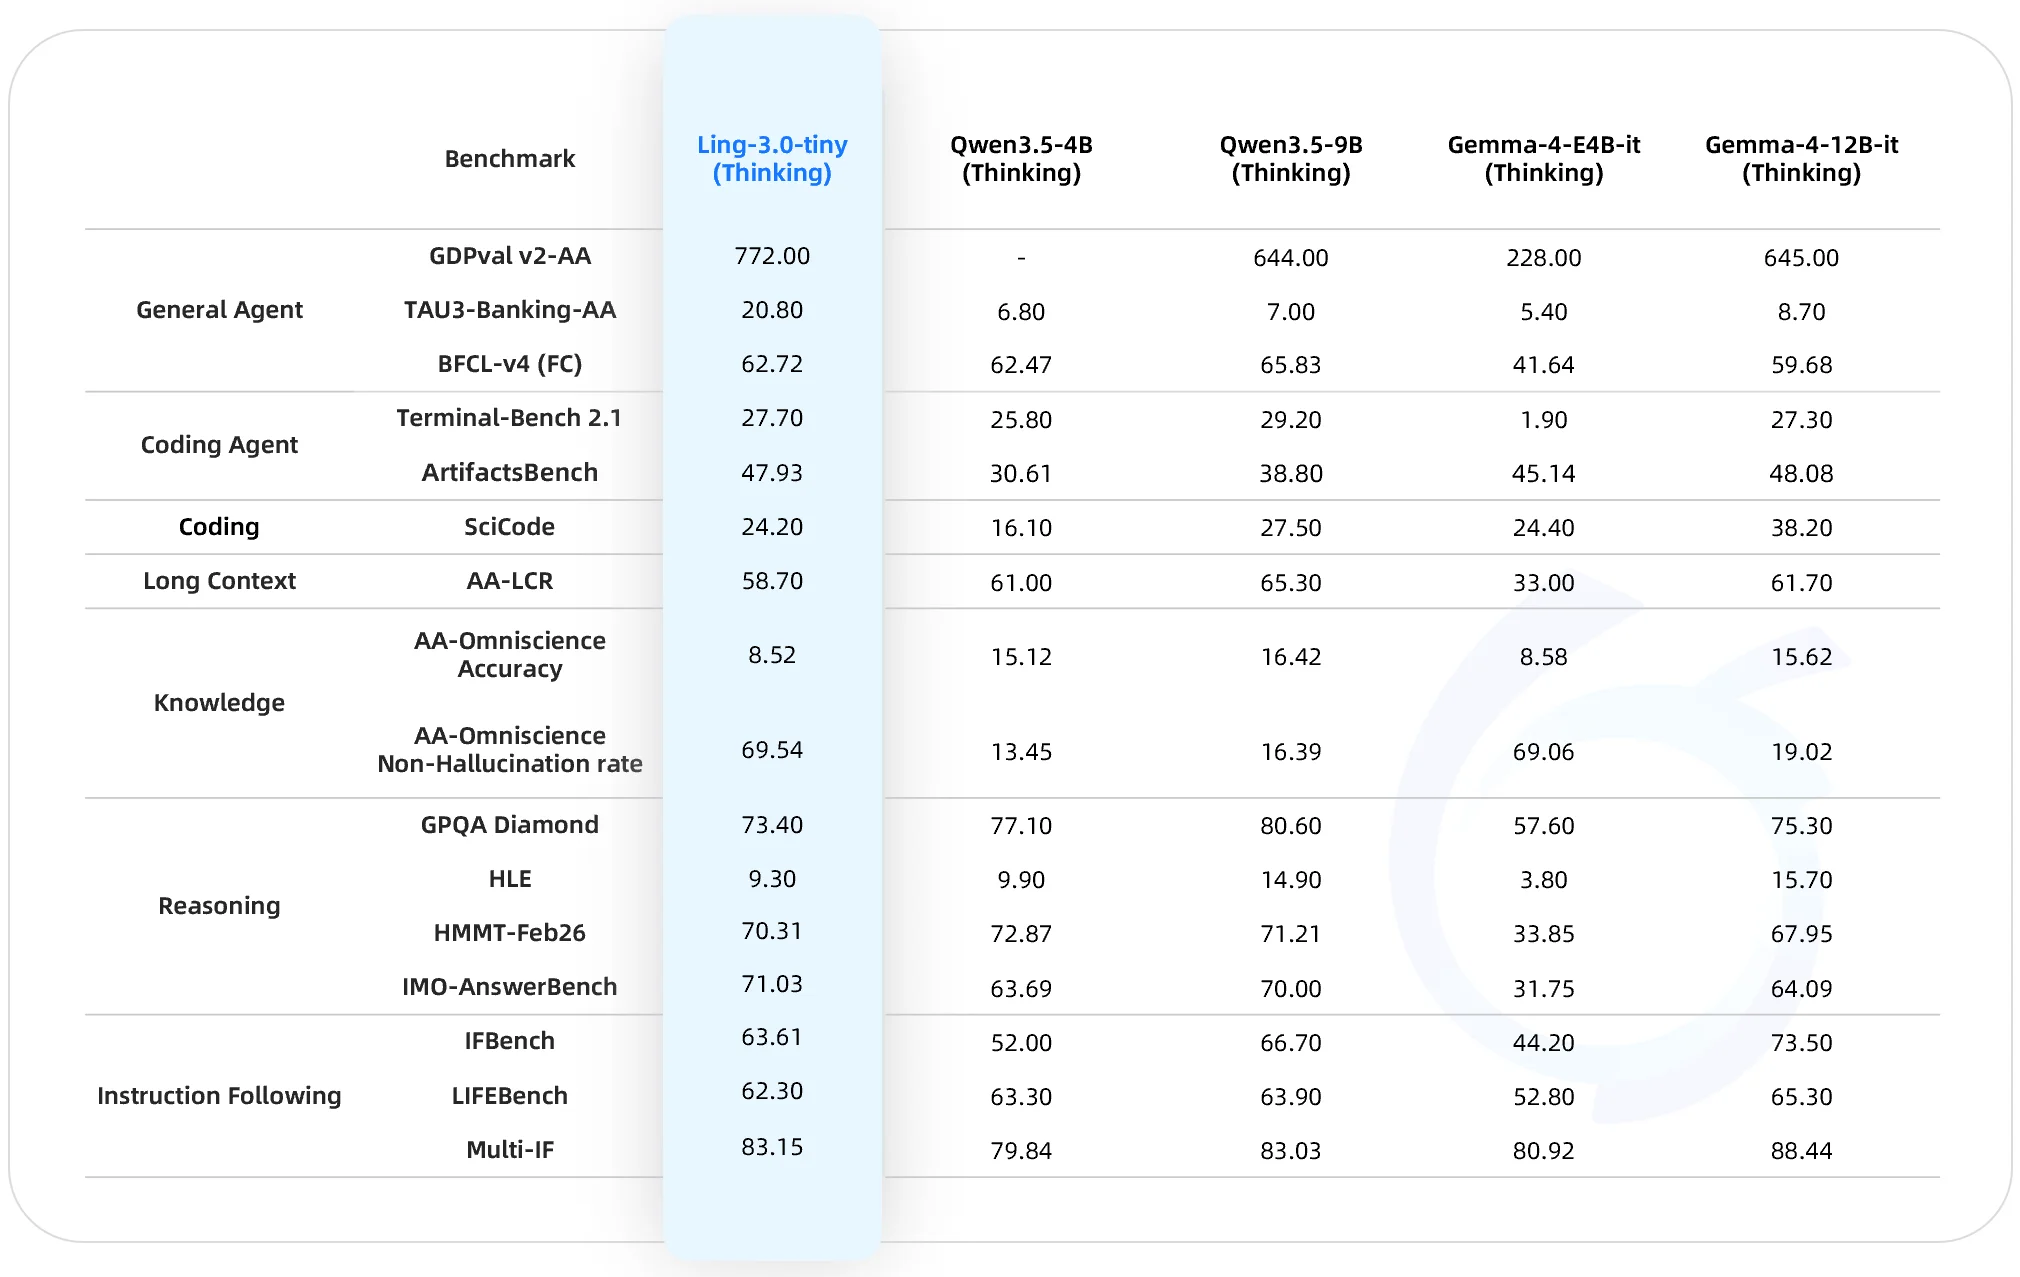
同级模型对比里有赢有输,Agent 相关项目很亮眼,知识准确率与综合推理仍有明显短板。
这些结果至少说明它不是一个只会续写文本的轻量聊天模型。
可 Agentic Index 16 也把边界写得很诚实。它有工具调用能力,不代表它能接管任意生产任务。
工具调用最烦人的部分,从来不只是模型能不能生成一段看起来像 JSON 的东西。运行时要能正确识别调用开始和结束,参数 schema 要匹配,思考内容不能混进工具参数,工具报错以后模型还得知道该修参数、换工具,还是停下来报告风险。
官方 vLLM 命令为什么要显式传 --tool-call-parser ling3 和 --reasoning-parser ling3?答案就藏在命令里。模型、chat template、思考解析器和工具解析器必须是一套合同。
少一层,常见画面就来了。模型明明想调用搜索,服务端把整段当普通文本吐给用户。模型已经生成正确参数,解析器却把 <think> 片段一起塞进 JSON。工具返回空值,Agent 不肯停,带着同一个错误参数继续重试,CPU 风扇开始替它表达坚持。
不是哥们,快 90 tok/s 是让你更快把活干完,不是让你更快撞同一堵墙。
所以把 Ling-3.0-tiny 接进真实 harness,也就是让模型真正干活的那层脚手架,我会先做几组很朴素的验收。用固定工具集测 schema 命中率,用故意缺字段的结果测恢复路径,用权限受限的工具测它会不会越界重试,用长会话测 parser 在上下文变脏后还稳不稳。
再看速度。
如果一百次调用里有十次需要人收拾,生成再快也只是把故障更快送到眼前。若一百次里九十八次能按合同停在正确状态,哪怕只有 50 tok/s,团队反而更敢把它放进后台。
它适合先接哪一班岗
说真的,我并不觉得 Ling-3.0-tiny 的这些限制削弱了它的价值。恰恰相反,边界越清楚,越容易找到它真正能干的活。
第一类是本地路由。先让小模型判断请求属于代码、文档、检索还是高风险操作,再把少数难题交给云端旗舰模型。它不用回答世界上所有问题,只要把常见请求分对,速度和隐私优势就能兑现。
第二类是检索前后处理。把查询改写成几个搜索词,对返回片段去重,抽出来源、时间和实体,再交给更强模型做最终判断。任务边界窄,验收容易,也不需要模型长篇发挥。
第三类是结构化提取。合同字段、日志错误、工单分类、代码仓库里的文件关系,这些任务有明确 schema,错了能被程序发现。1.3B 激活参数带来的吞吐,放在这里比陪人聊天更值钱。
第四类是隐私敏感但风险可控的助手。内部文档检索、个人笔记整理、离线代码索引,都可以先在本机处理。模型不出网,数据边界简单不少。当然,不出网不等于天然安全,工具权限和本地文件范围仍要收紧。
我暂时不会把它直接放去做支付、删除生产数据、自动改基础设施,或者一口气跑几个小时的无人看守任务。不是说永远不行,而是公开材料还没有给出长期稳定性、权限控制和故障恢复的证据。
这个先后顺序挺重要。先让小模型接边界清楚、失败可见、结果可验的班,再慢慢扩大权限。
别一上来就把机房钥匙挂它脖子上。
真正的新东西,是本地 Agent 开始有经济账了
过去聊本地模型,经常卡在两个极端。一边是隐私、离线和零 API 账单,听起来很美。另一边是模型慢、能力弱、工具生态碎,跑通 demo 以后不知道拿来干什么。
Ling-3.0-tiny 把中间那块地往前推了一点。
7.9B 总参数保留了一定能力池,1.3B 激活参数把单轮计算压下来,FP8 又让 M4 Pro 出现了 86 至 90 tok/s 的官方数字。快答和思考模式还能按请求切换。对一个需要反复读工具结果的 Agent 来说,这套组合比单项 benchmark 更有意思。
它还不是云端旗舰模型的平替。Agentic Index 16、运行时开发分支、Ollama 未合并支持,以及缺少长期生产数据,都在提醒我们别急着吹过头。
可它已经让一个以前很难算的账变得能算了。
哪些请求留在本地,能省多少云端调用,工具循环要等多久,内存预算够不够,失败时能不能自动降级。这些问题终于不再只有「模型太慢,算了」一个答案。
模型是船,运行时是发动机,parser 是舵,验收是海图。Ling-3.0-tiny 已经把船造得又轻又快,剩下几样还得一件件装稳。
等它们装稳,本地 Agent 才算真正离港。