posts/ltx25-realtime-video-boundary.md
LTX-2.5 快过实时,家用显卡先别激动
10 秒的视频,6.8 秒生成。
LTX-2.5 今天正式发布,官方把这条成绩摆在了最显眼的位置。视频还没播完,下一条已经算好了。好家伙,AI 视频终于跑到了「快过实时」。
然后我往脚注看了一眼。
两张 NVIDIA GB200,720p,自托管,稳态运行。
这四个条件放在一起,味道立刻变了。它不是你把模型拖进 MacBook,风扇转两圈,六秒后掉出一条电影。它是数据中心级硬件上的厂商成绩。快过实时是真的,家用显卡能快过实时不是同一句话。
所以我对 LTX-2.5 的判断也很直接。它是今天很值得看的开放权重视频模型,但最值得看的不是那条 6.8 秒,而是它把本地部署、API 生成和 ComfyUI 工作流三条路同时摆上了桌面。
跑分负责让你点进来,工作流和账单才决定你能不能留下。
6.8 秒这条成绩,先看脚注
先把发布信息压缩一下。
LTX-2.5 是一套开放权重的视频生成基础模型。新版本换了扩散视频解码器,用来减少动作里的抖动和伪影。它支持原生多镜头,希望角色、环境、灯光和声音在切镜之后还能接得上。文本侧换成 Gemma 4 12B 编码器并加了提示词增强器,也能自动判断一个动作该生成多长的片段。
另外还有原生 4K HDR、RAW 后期流程、真实素材编辑,以及专门留给微调的基础检查点。参数听起来挺满,厉害了,视频模型发布会已经开始用专业调色台的词汇跟我们聊天。
这次还有一个叫 Diffusion Fidelity Rendering 的设计。用人话讲,它不再假设画面里每个区域都同样难算,而是按场景复杂度分配渲染算力。人物快速移动、材质反光、镜头切换这些难的部分多吃一点,简单背景少吃一点。目标不是盲目把整段视频都加算力,而是把预算压到最容易露馅的帧上。
这个方向我是真的觉得比单纯加参数有意思。视频生成最烦人的地方,往往不是整段都烂,而是九秒都挺好,第十秒手指突然开始独立思考。平均撒算力很贵,按难度分配才像在认真做工程。
可回到 6.8 秒,边界必须讲清楚。
官方写的是两张 GB200,在自家硬件上跑到稳态,生成一段 24 fps、720p、目标 10 秒的图生视频。API 的 23.7 秒则通过第三方 fal.run 端到端测量,包含排队时间,而且用的是 1080p 内部数据。对比表里的其他模型也不是全用相同分辨率,还有一个用 8 秒片段。
这不是说成绩没用。恰恰相反,两张 GB200 已经能让开放权重模型跨过实时线,这件事本身有点子牛逼。它说明视频生成正在从离线等结果,往实时预览、交互式编辑和批量生产靠近。
只是别把厂商跑分翻译成家用体验。两者中间隔着显存、量化、解码器、磁盘吞吐、CUDA 版本、节点实现和一堆很会在周五晚上冒出来的 OOM。
本地跑和 API,是两门生意
LTX 给出的本地门槛是最低 16 GB 显存,也说模型能在消费级硬件和 Mac 上运行。注意,「能运行」只回答能不能启动,不回答速度、分辨率、时长和画质能不能同时保住。
你当然可以在显存紧张时降分辨率、缩短片段、用蒸馏权重、开启 CPU 卸载,再让 VAE 分块解码。VAE 可以理解成把模型内部的压缩画面还原成像素的那层解码器,分块能少占显存,代价通常是更多等待和数据搬运。
很多本地工作流往往会变成一组妥协。540p 能跑,720p 开始慢,片段一长就 OOM,两个阶段的高质量流程又要多加载一套东西。棒棒的,模型确实跑起来了,只是「实时」已经跑到隔壁去了。
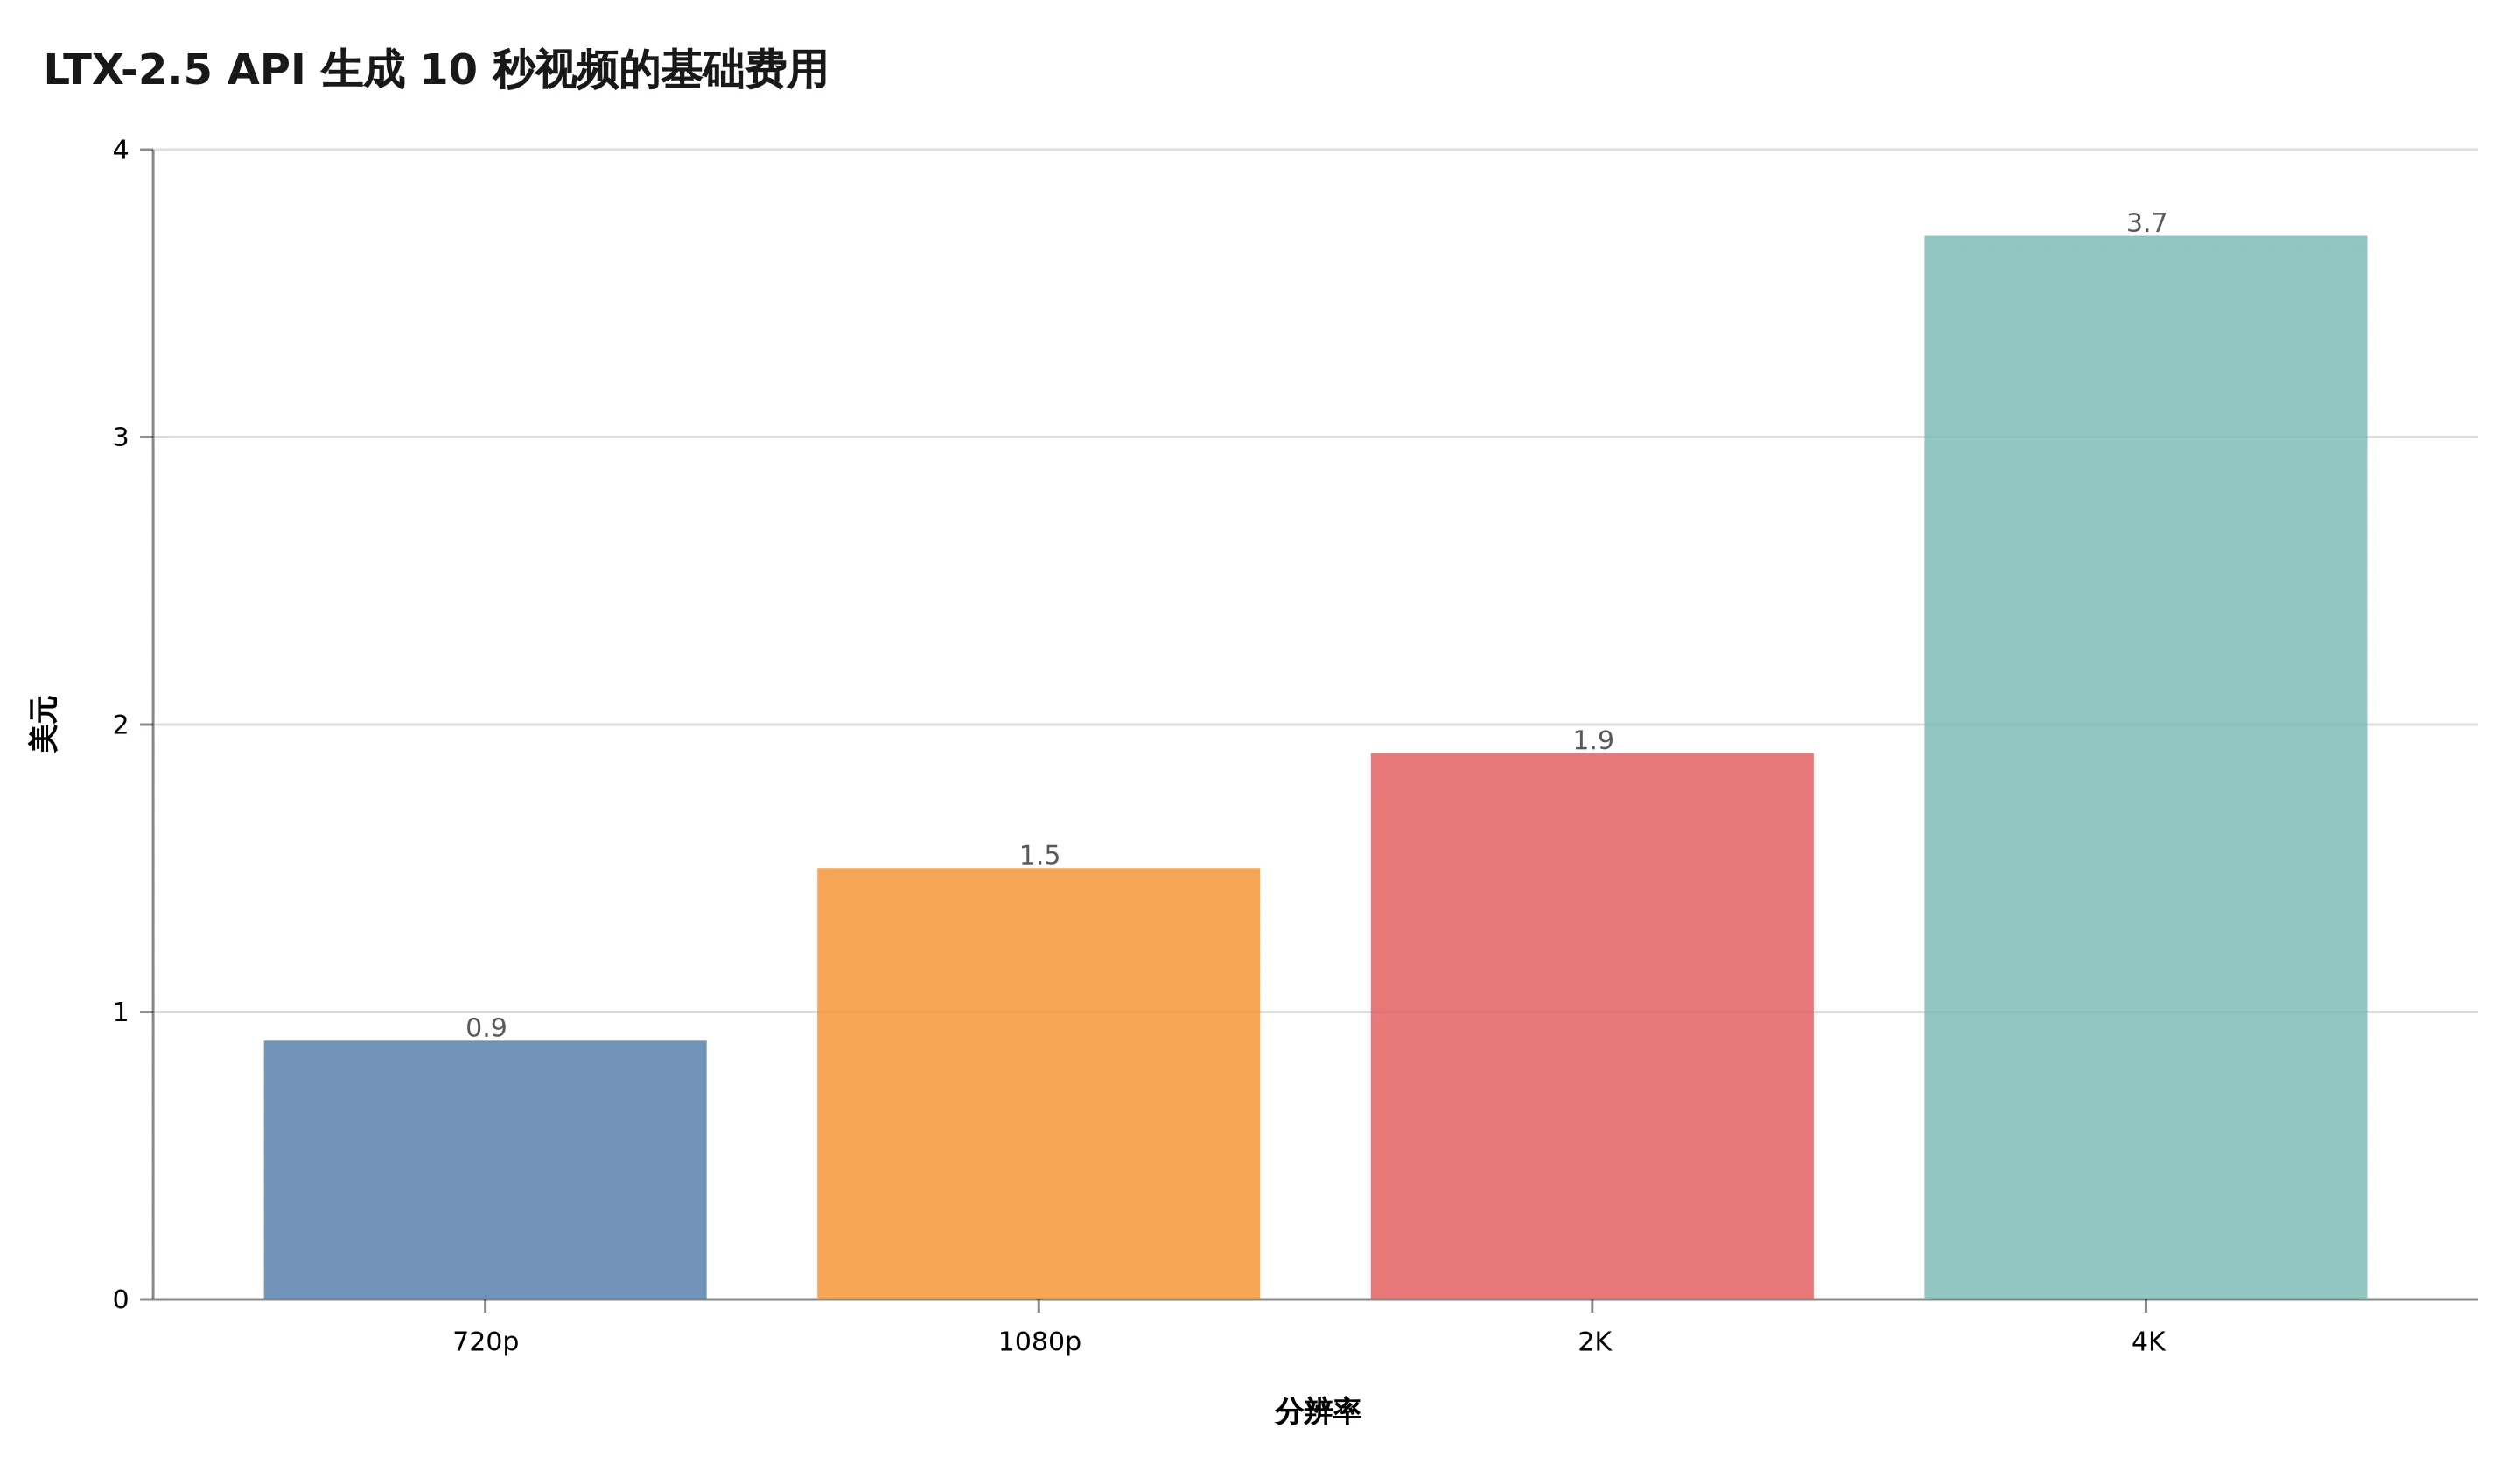
API 是另一条路。官方价格表按生成时长收费,720p 每秒 0.09 美元,1080p 每秒 0.15 美元,2K 每秒 0.19 美元,4K 每秒 0.37 美元。
换成一段 10 秒视频,就是 0.90、1.50、1.90 和 3.70 美元。
单看不贵。真正该乘进去的是重试率。
假如一个镜头平均要试 4 次才留下 1 次,720p 的有效成本就从 0.90 美元变成 3.60 美元。做一条含 12 个镜头的短片,基础生成费从 10.80 美元走到 43.20 美元。这里还没算放大、补帧、音频重做、人工挑片和被客户一句「感觉不对」送回起点的版本。
这只是按公开单价做的预算例子,不是对模型命中率的实测结论。每个人的提示词、参考图和验收标准都不同,4 次只是方便你给表格留一列,不是替项目报销。
但这个算法值得保留。AI 视频的成本单位不该是每次生成多少钱,而该是每条可用镜头多少钱。采购 API 时只盯单价,很容易得到一张便宜得让人开心、月底又让财务沉默的账单。
本地部署也不是免费。显卡折旧、电力、运维、模型下载、工作流维护和空闲资源都要算。区别只是 API 把成本写在请求后面,本地把成本藏进机器和工程时间里。
怎么选呢。
需求还在摇摆、调用量不稳定、团队没有视频推理运维经验,先用 API 更诚实。镜头量长期稳定、素材有隐私要求、需要训练自己的风格或角色,而且团队真能维护 GPU 环境,再认真算自托管。
别因为「开放权重」三个字就先买机器。先拿两周真实任务测出每天生成多少秒、留下多少秒、失败集中在哪个节点,再做决定。硬件销售最喜欢的,就是一张还没填数据的容量规划表。
真正交付的,是九套工作流
这次让我更愿意把 LTX-2.5 当成工程发布看的,是它没有只丢一个权重链接。
发布当天,Lightricks 的官方 ComfyUI 仓库已经放出 9 套 2.5 工作流。文生视频、图生视频、单阶段蒸馏、双阶段蒸馏、视频转视频、局部重绘、扩图、运动迁移、素材控制和文生音频都能找到对应 JSON。
ComfyUI 是节点式生成工作台。加载模型、编码提示词、采样、解码、放大、输出,每一步都是一个节点,线连起来就是可执行流程。JSON 的价值在于,它不只是截图告诉你「我跑通了」,而是把参数、节点和连接关系一起交出来。
对开发者来说,这比一张漂亮样片实用得多。
你可以先导入单阶段蒸馏流程,确认机器能否完成最小流程。画质不够,再切双阶段。需要修改已有素材,就换视频转视频或局部重绘。模型更新后出问题,也能把故障缩到权重、节点、输入尺寸或解码阶段,不用面对一个只有「生成失败」四个字的黑盒。
官方开源文档和代码仓库也把本地入口放出来了,LTX-2.5 权重页则负责模型下载。你想只用 ComfyUI,还是把推理封进自己的 Python 服务,路线都留着。
这块需要注意一下,开放权重不等于完全没有许可边界。LTX 写的是年度经常性收入低于 1000 万美元可免费使用,也不强制品牌露出。个人、小团队和多数早期产品很好上手,但收入跨过门槛的公司必须读完整许可,不能看见下载按钮就默认和 MIT License 一回事。
还有个容易被忽略的价值。九套流程让团队可以做回归测试。
固定几组提示词、参考图、种子、分辨率和时长,每次升级权重或节点就批量跑一遍,比较运动连续性、角色一致性、生成耗时和显存峰值。视频没有单元测试那么干净,但至少能把「这版感觉怪怪的」变成一组能复现的输入和输出。
这才是基础模型进生产的第一步。
不是模型会生成,而是团队知道它什么时候会坏。
谁该现在上车
如果你只是偶尔做几条视频,先走 API。别被双 GB200 的数字带进硬件商店,用公开单价乘上自己的重试率,十分钟就能算出大概。
如果你已经在 ComfyUI 里维护视频流程,LTX-2.5 值得当天建一条独立测试支线。先别替换生产流程,拿同一批参考图对比旧版本,重点看多镜头一致性、动作复杂处的伪影、显存峰值和成片留下率。
如果你在做角色 IP、广告素材或有私有视频数据,开放基础检查点和微调入口才是主菜。你要问的不是榜单第几,而是自己的镜头语言能不能学进去,许可是否匹配商业规模,部署成本能不能被稳定调用量摊薄。
至于家用卡玩家,当然可以玩。说实话我也不确定 16 GB 显存上的各种量化和卸载方案最终会把速度推到哪里,得等更多真实机器数据。但请把目标写成「跑通并摸清边界」,别写成「复现 6.8 秒」。前一个目标会让你得到一套能复用的工作流,后一个大概率只会得到一张显存不足的截图。
LTX-2.5 把视频生成推过了实时线,这条新闻没错。
不过那条线画在两张 GB200 上。普通开发者真正能踩住的,是另一条线,权重能下载,流程能复现,成本能算清,坏了还能找到是哪个节点。
跑得快很漂亮。
跑得明白,才敢上线。