posts/mac-studio-unified-memory.md
512GB 不是突破,Mac Studio 真正变的是网络
把 Apple 的新款 Mac Studio 新闻稿一直往下拖,真正有意思的一行,藏在第 2 条脚注里。
Apple 用来对比的上一代机器,是一台 M3 Ultra、80 核 GPU、512GB 统一内存、8TB SSD 的 Mac Studio。
对,你没看错。
发布页最醒目的 512GB,并不是 M5 Ultra 这一代才有。上一代就已经能选到这个容量。
好家伙,标题里那个最容易让人兴奋的数字,翻到脚注突然变成了老朋友。
这不代表新机器没东西。恰好相反,我觉得 新款 Mac Studio 最有价值的变化,被 4.3 倍 AI 性能和 512GB 统一内存抢走了镜头。
M5 Ultra 把内存带宽推到 1.2TB/s,比上一代高 50%。每个 GPU 核心第一次放进 Neural Accelerator。Apple 又端出一个新的 Core AI 框架,还让多台机器通过 Thunderbolt 5 和 RDMA 组成集群。
单机容量没有继续涨,计算、搬运、软件和互联却开始被放在同一张桌子上。
我的判断是,Mac Studio 正从一台能塞进大模型的电脑,变成一套小型本地 AI 系统。
而系统,向来比芯片难搞。
能装下和跑得快,是两道题
统一内存一直是 Apple silicon 跑本地大模型最诱人的地方。
传统 GPU 服务器里,CPU 内存和 GPU 显存是两座仓库。模型权重要送进显存,CPU 与 GPU 之间还要搬数据。Apple 的 CPU、GPU 和 Neural Engine 共用同一池内存,少了一道最烦人的容量切割。只要整机内存够大,模型就有机会完整留在设备上。
这也是 512GB 看起来那么香的原因。
粗略算一下,一份 4-bit 量化的 70B 模型,光权重大约要 35GB。参数规模再往几百 B 走,权重就会爬到两百 GB 以上,还没算 KV cache、运行时缓冲、长上下文和并发请求。显存卡在 48GB 或 80GB 时,很多模型不是慢,而是根本塞不进去。
512GB 把「能不能启动」这道门往外推了很远。
可模型装进内存,只等于仓库够大。每生成一个 token,计算单元还要反复读取大量权重。仓库通往灶台的路太窄,锅照样空等。
这时候,1.2TB/s 比 512GB 更有信息量。
M5 Ultra 的内存带宽比上一代高 50%。Apple 的厂商自测里,LM Studio 处理 LLM prompt 的速度最高是 M3 Ultra 的 4 倍、M1 Ultra 的 9.8 倍。峰值 AI 计算最高是 M3 Ultra 的 4.3 倍。
两个倍数挨得很近,很容易让人误以为所有本地模型都会快四倍。先踩一脚刹车。
这些结果来自 Apple 在 2026 年 7 月完成的特定配置测试。模型、量化格式、上下文长度、prompt 批次、软件版本都会改结果。prompt 处理快四倍,也不等于逐 token 生成、工具调用、检索和整条 Agent 任务都快四倍。
但方向很清楚。本地推理的瓶颈正在从容量,转向带宽、算子与调度。
有点像你终于租到一个够大的仓库,第二天才发现园区只有一条单车道。
厉害了,容量焦虑治好了,交通治理又开始了。
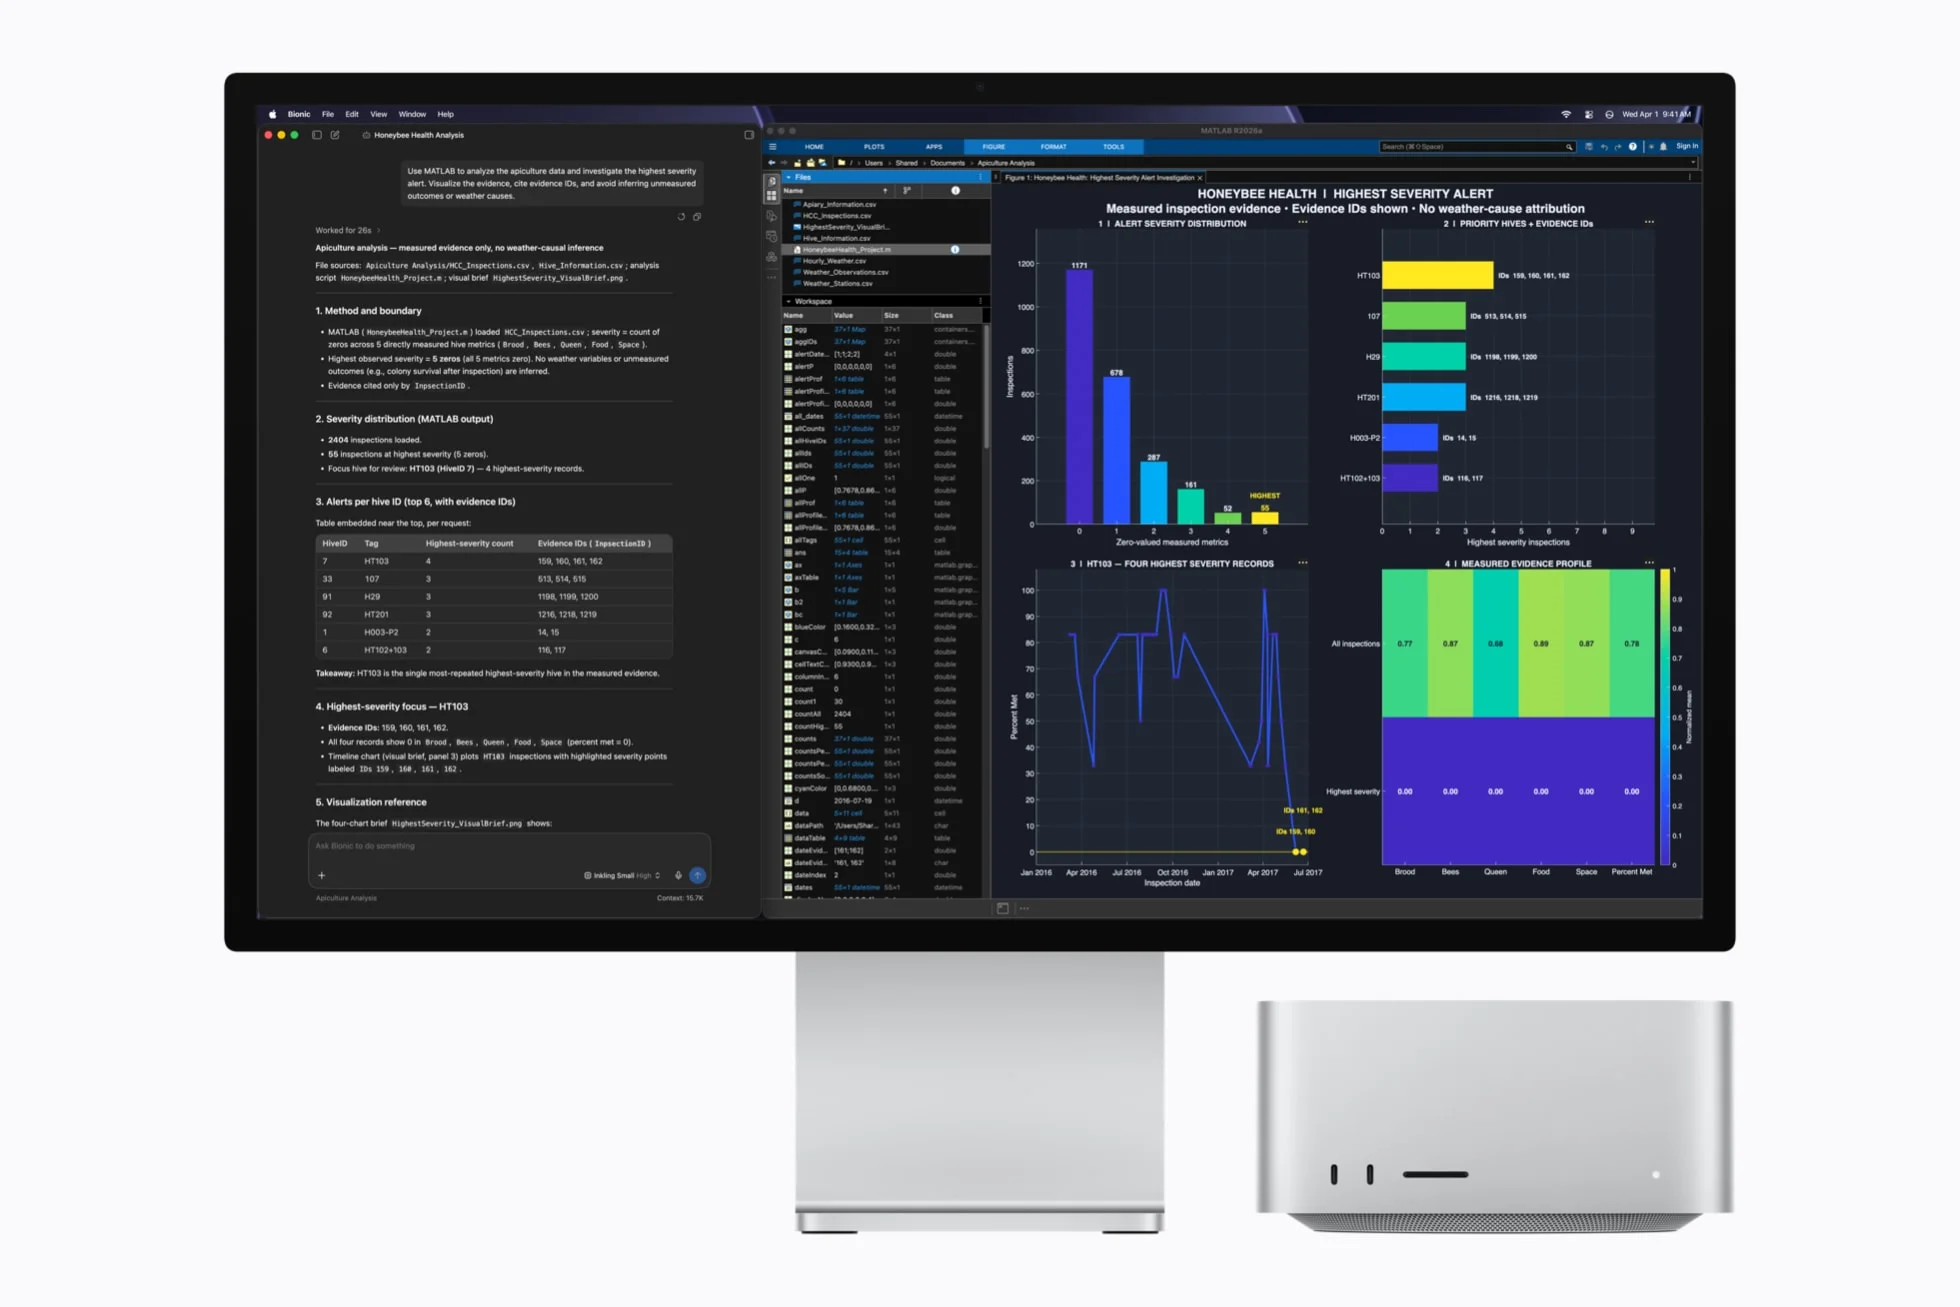
Apple 官方展示的本地 AI 与 MATLAB 工作流,模型、数据和开发工具都留在一张桌面上。
四台只快三倍,这个数字比跑分诚实
Apple 这次还给 Mac Studio 加了一条很容易被忽略的路。
多台机器可以用 Thunderbolt 5 和 RDMA 组成集群。RDMA 是远程直接内存访问,尽量绕开 CPU 层层参与和重复拷贝,让一台机器更直接地读写另一台机器的内存。对大模型来说,这不只是联网,而是把分散在几台机器里的内存拼成一个更大的可用池。
模型单机装不下,就切开。
Apple 的说法是,四台 Mac Studio 可以加载当前体量最大的开放权重模型,分布式 AI 推理速度最高达到单机的 3 倍。
我看到这里反而踏实了一点。
四台不是四倍,是最高三倍。
这组数字把分布式推理那笔藏不住的税直接摆了出来。模型切到四台机器以后,权重要分片,激活值要跨机传输,各节点要同步,慢节点还会拖住整批请求。任务越碎、通信越频繁,互联就越容易从配角变成主角。
按最理想的 3 倍计算,四台机器的线性效率也只有 75%。而且「最高」通常对应厂商挑选过的模型和配置,真实负载未必能守住这个数字。
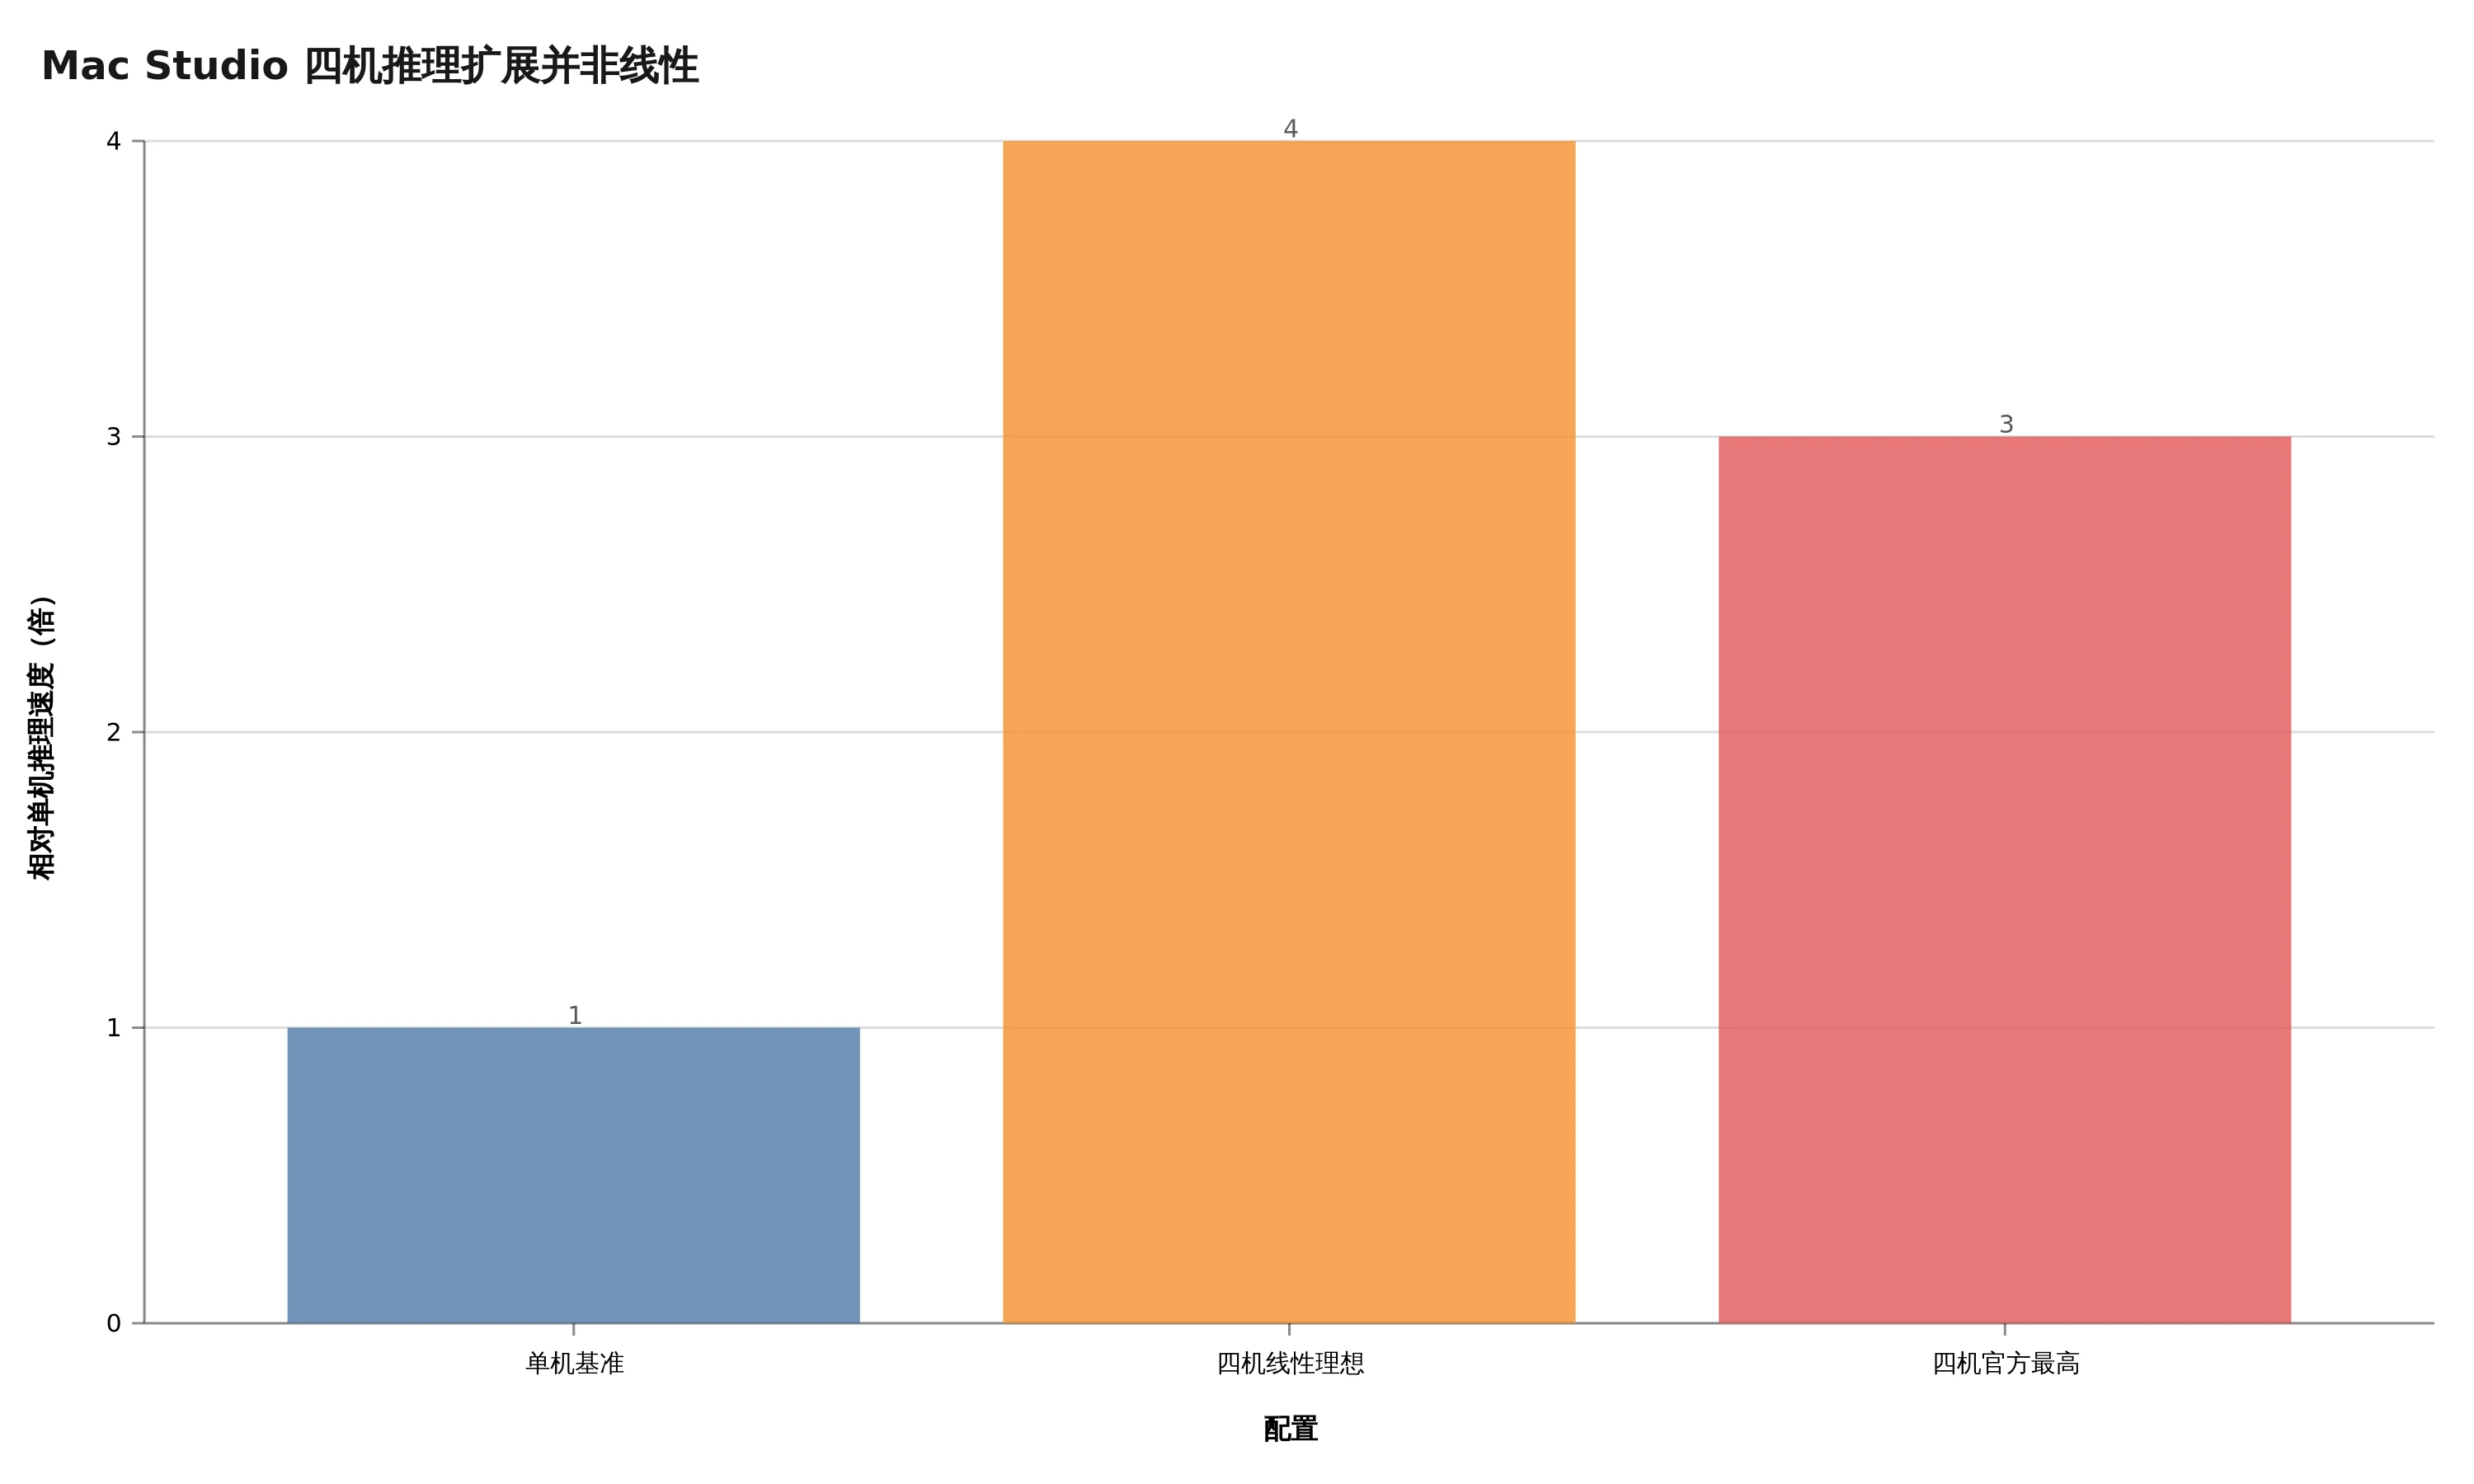
Apple 官方给出的四机最高推理速度是单机的 3 倍,相对四倍线性理想留下了 25% 的扩展损耗。
这不是在挑 Apple 的刺。能把四台桌面工作站通过 Thunderbolt 5 和 RDMA 做到可用,本身就有点子牛逼。真正该警惕的是另一种叙事,买四台就等于得到四倍能力,内存还能像加积木一样无限往上堆。
分布式系统从来不送免费午餐。
网络抖一下,某个节点慢一点,模型切分策略不合适,吞吐曲线就开始长出锯齿。机器越多,电源、散热、交换、监控、故障恢复和版本一致性也会一起进场。
你原本只是想在桌上跑个大模型。
回过神来,桌下已经住着一个小机房。
这也是新 Mac Studio 最有意思的信号。Apple 不再只卖一颗大芯片,它开始承认,本地前沿模型也是一套互联系统的问题。
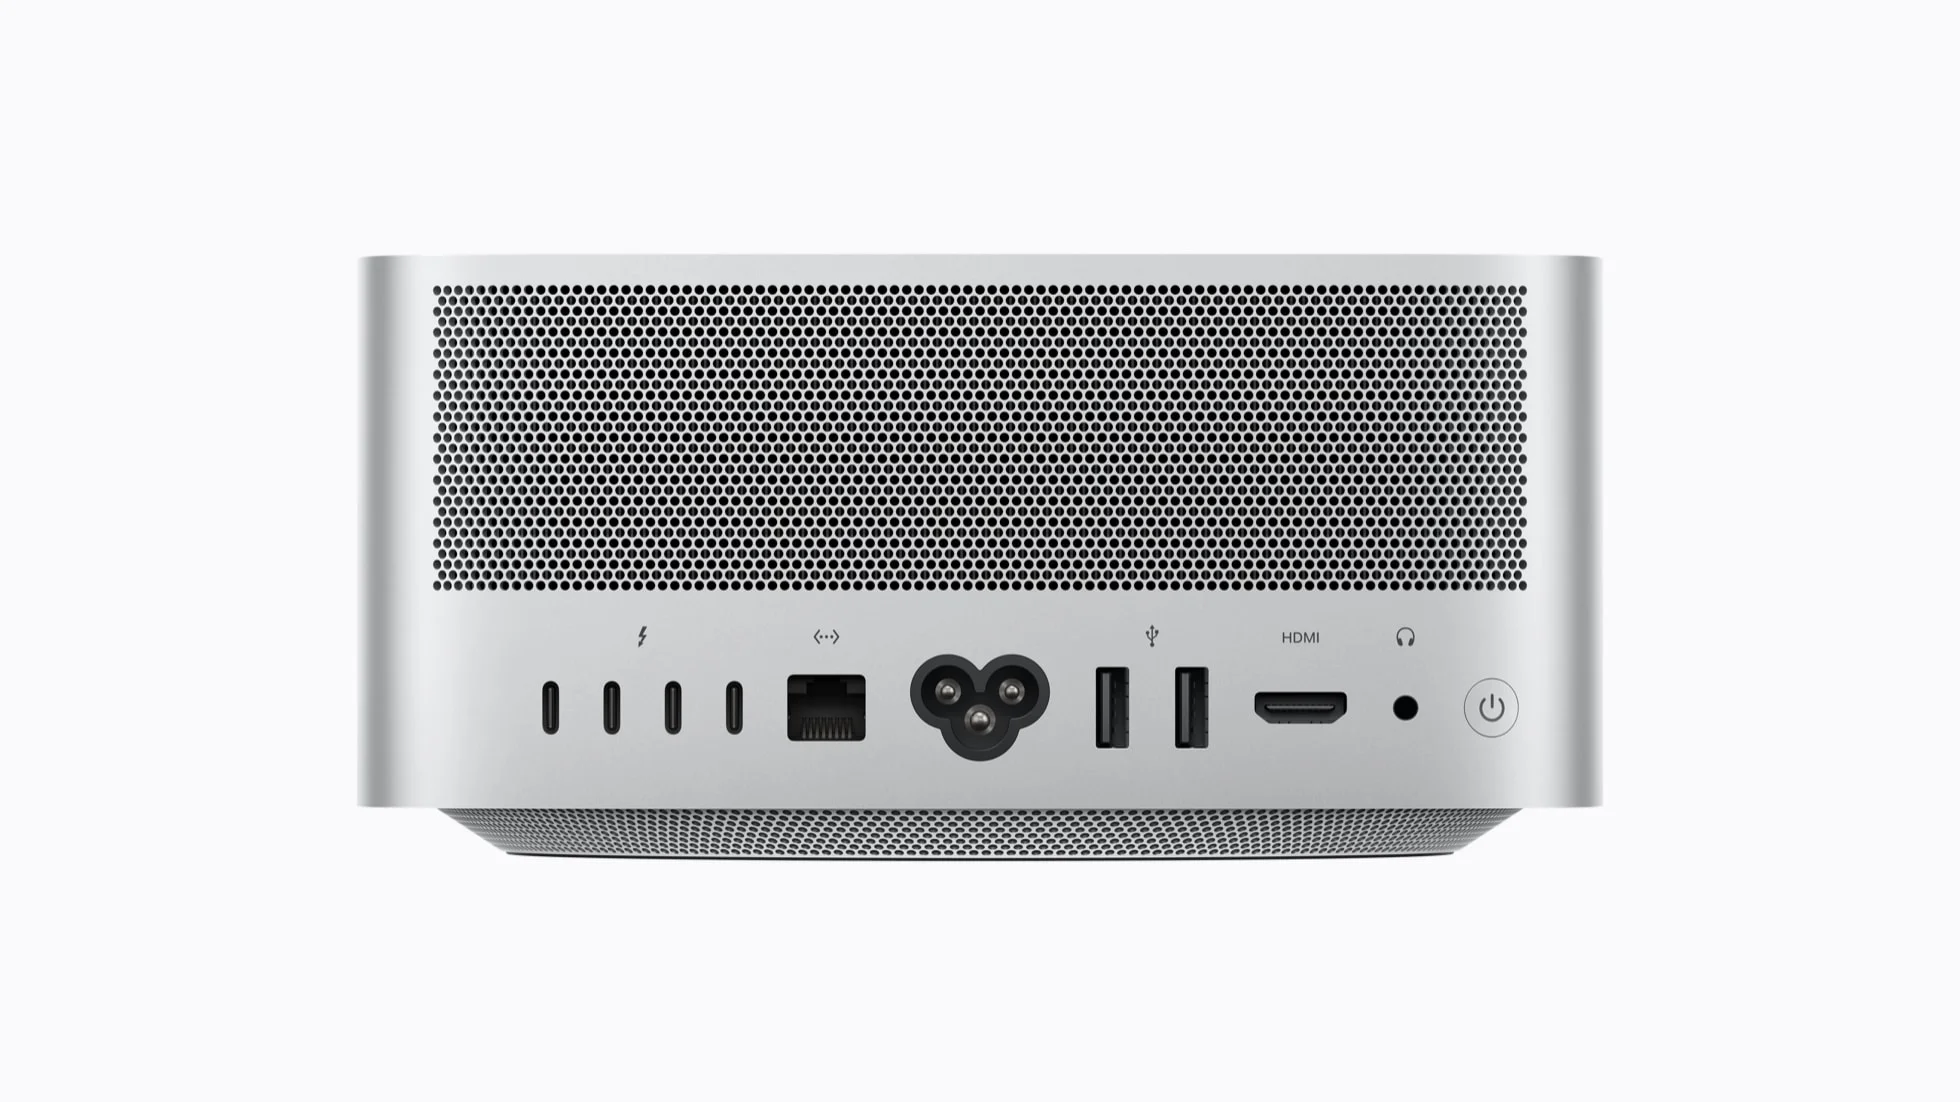
新款 Mac Studio 背部提供四个 Thunderbolt 5 接口,多机集群的路从这里开始。
Core AI 和 MLX,才决定机器能不能变成平台
硬件能跑,不等于开发者愿意长期在上面跑。
本地 AI 最常见的翻车,不是算力不够,而是某个算子没有高效实现、某个量化格式不支持、框架升级以后性能倒退、模型转换卡在一份没人维护的脚本里。
CUDA 的护城河也不只来自 GPU 快。它背后有编译器、算子库、性能分析、分布式通信、推理引擎和多年踩坑留下的文档。换一套硬件,真正昂贵的往往是把这整条软件链重新补齐。
Apple 这次新提到的 Core AI,目标是让开发者在统一内存、CPU、GPU 和 Neural Engine 上构建、运行和部署模型。它和 MLX 的分工还需要更多公开文档与真实项目来验证,但方向很明确。
MLX 更接近研究与开发者工具,适合加载、训练、微调和实验模型。Core AI 被放在「构建、运行、部署」的位置,像是要给应用层一套更稳定的系统接口。
如果这条路做顺,Mac Studio 的价值不只是能跑一个超大模型 demo。开发者可以在同一台机器上完成数据准备、微调、评测、应用开发和私有部署,模型数据不必离开本地。
可现在就宣布软件问题解决,还是早了。
Core AI 刚出现,Apple 没在新闻稿里给出完整 API、模型兼容列表和迁移成本。MLX 生态长得很快,但大量开源项目仍然优先围绕 CUDA、vLLM 和 llama.cpp 优化。一个新模型发布后,Apple silicon 能不能第一时间吃到高性能实现,取决于转换工具、量化支持和社区维护者,不取决于海报上写了多少 TOPS。
坦率讲,本地模型平台真正的验收,不该是「成功吐出第一个 token」。
应该看长上下文会不会爆内存,看 prompt cache 能不能复用,看并发一上来延迟会不会塌,看模型更新能不能回滚,看四机里坏一台后任务能不能降级继续跑。
棒棒的,demo 跑起来只是第一关。
后面全是工程。
本地不按 token 收费,不等于免费
Apple 在发布稿里写得很爽,本地运行模型可以保留隐私,不用数 token,也不用担心云成本上涨。
隐私这点很硬。源代码、客户合同、内部文档、医疗影像或尚未公开的数据留在设备里,能减少数据出网和第三方保留带来的风险。网络断了还能继续干活,也是一种很实在的可靠性。
但「不按 token 收费」和「成本消失」中间,隔着一张挺长的采购单。
M5 Ultra 版 Mac Studio 的美国起售价是 5,499 美元。新闻稿没有公布 512GB 内存和大容量 SSD 的最终配置价。光按入门价买四台,已经是 21,996 美元,还没算内存升级、存储、外围设备、电力、维护和开发时间。
云模型把成本写在账单上,本地模型把成本藏进折旧、利用率和工程时间里。
如果机器一天二十四小时都有稳定负载,本地部署可能把单位推理成本摊得很好看。如果每周只跑几次大模型,剩下时间都在待机,那台不数 token 的机器,可能正在按小时默默数折旧。
还有一个更容易漏的数字,任务完成率。
本地模型便宜一半,但工具调用经常失败,长任务要重跑三次,最终成本未必更低。云模型单价高一点,却能少两轮修复,也可能更划算。做 Agent 的人应该很熟这种尴尬,token 账单只占一部分,超时、重试、人工验收和错误结果才是后半场。
所以别只比较每百万 token 多少钱。
同一批真实任务,在相同质量门槛下,比较每个合格结果的总成本。把机器折旧、电费、运维时间、失败重试和人工复核都放进去。这个数字可能不够适合做发布会海报,但更接近银行卡余额。
谁该买,谁先等等
如果你的工作负载有三种特征,新 Mac Studio 很值得认真算一遍。
数据不能出网,模型尺寸经常撞上显存墙,任务又能持续吃满机器。比如在本地处理敏感代码和企业资料,跑大型开放权重模型做长期批处理,或者 AI 推理与视频、3D、音频工作本来就在同一台工作站上。统一内存和媒体引擎的组合,在这些场景里很难被一张普通 GPU 卡完整替代。
如果你主要做短期实验,模型换得很勤,依赖 CUDA 专属算子,或者负载忽高忽低,先租云机器通常更轻。你不需要为了偶尔跑一次大模型,提前养一个小机房。
想上四机集群的团队,还要再问几句。
你要跑的模型是否已经支持这套分布式路径。四台机器的真实吞吐是多少。长上下文和多并发下,网络占比会涨到多少。某台机器故障后,能不能自动摘掉节点。更新 MLX、Core AI 或模型权重时,如何保证四台版本一致。
这些问题答不出来,先别被共享内存池几个字带着刷卡。
我一直觉得,买本地 AI 硬件最危险的时刻,不是预算不够,而是把「有能力运行」误认成「已经适合生产」。前者看内存和跑分,后者要看软件支持、故障模型、评测合同和长期成本。
回到开头那条脚注。
上一代已经有 512GB,新一代依然是 512GB。真正往前走的,是带宽、加速器、框架和多机互联开始一起工作。
模型能不能装进电脑,Apple 早就回答过了。
这一次,它开始回答另一道更难的题,装进去以后,怎么让整套系统持续干活。
这题没有 4.3 倍那么好看。
但它更值钱。