posts/macos-vm-metal-capability-llm-speed.md
macOS 虚拟机跑 LLM 慢 16 倍,锅不在算力
431.86 tok/s,变成 4,786.70 tok/s。
12.63 tok/s,变成 206.60 tok/s。
同一台 M1 Ultra,同一个 macOS 虚拟机,同一个 TinyLlama 模型,宿主 GPU 没换,客体内核没改,甚至连跑推理的 llama.cpp 都是同一版。
前后差了 11.08 倍和 16.36 倍。
好家伙,这种数字放在发布会上,下一页通常该出现一块新芯片了。可 Cua 团队公开的研究 里,真正改变的只有两个回答。
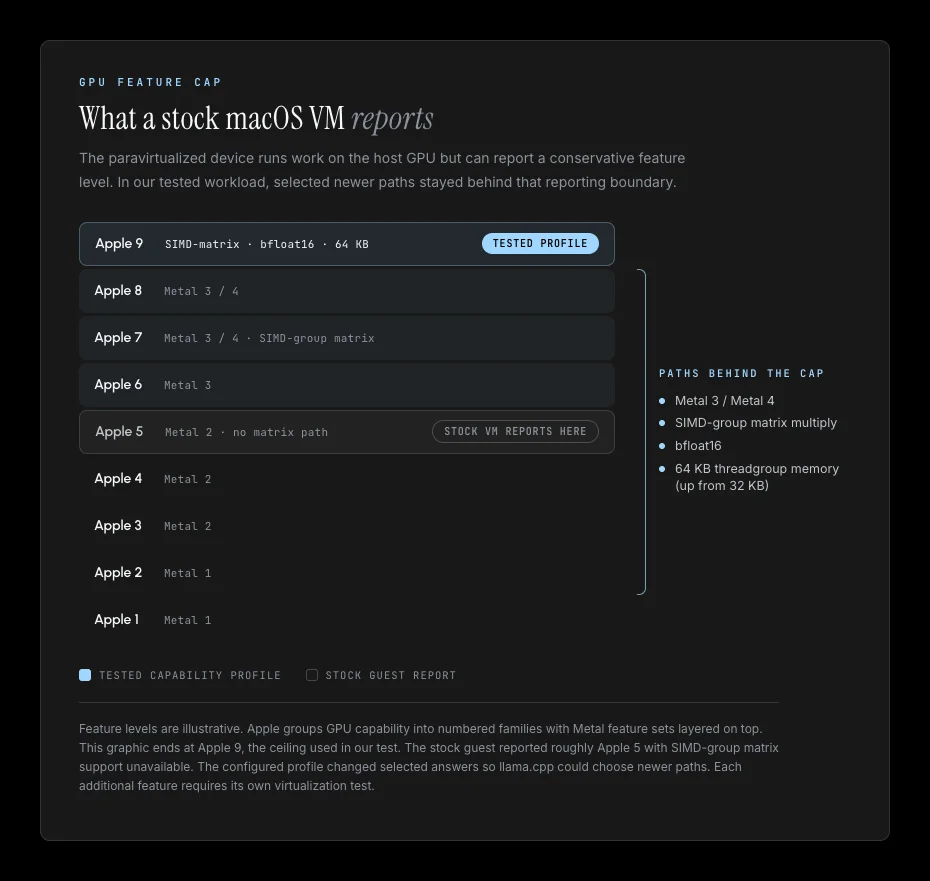
虚拟机里的 GPU 以前告诉应用,自己大概只会 Apple 5 那一档能力,线程组内存最多 32 KB。加上一层只作用于单个进程的兼容层后,它改口说,经过测试的能力可以到 Apple 9,线程组内存可以用 64 KB。
然后 llama.cpp 换了一条更快的 Metal 内核路径。
就这两处。
这不是一篇普通的加速新闻。它更像一张很干净的 X 光片,把 Agent 隔离环境里一个常被忽略的问题照了出来。我们总爱记录模型名、量化版本、显存和 token 数,却很少记录应用启动时到底看见了什么能力。
而软件只会相信它看见的那份世界。
GPU 一直在那里,慢内核也是程序自己选的
很多人看到 macOS 虚拟机和 GPU,第一反应会是直通。
这次不是。
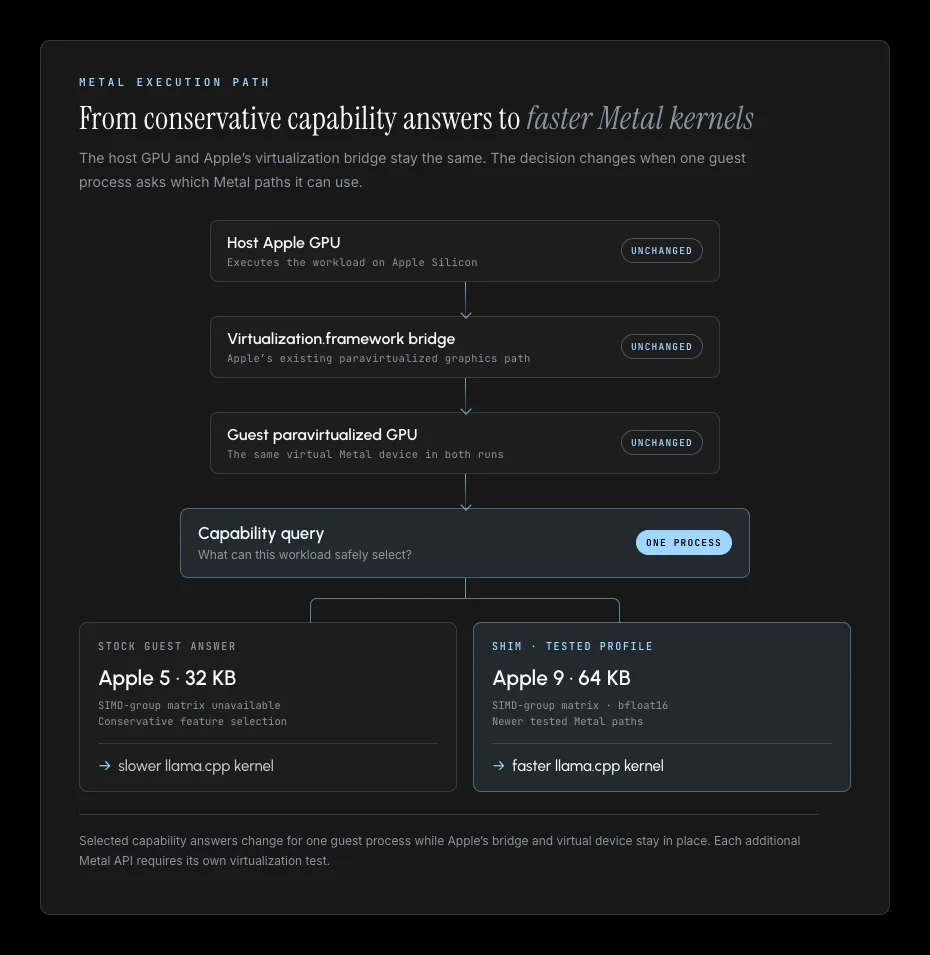
Apple 的 Virtualization.framework 给 macOS 客体系统提供的是半虚拟化图形设备。客体里的任务通过专用驱动提交 Metal 工作,真正执行任务的仍是宿主机那块 Apple GPU。宿主控制硬件,客体拿到一块懂虚拟化协议的设备。
它和 x86 Linux 常见的 VFIO 不一样。VFIO 可以把一块物理 PCI 设备或硬件功能直接分给虚拟机,这才是大家更熟悉的 GPU passthrough。
Cua 的 stock Tahoe 虚拟机里,设备报告的能力很保守。Apple family 大致停在 5,最大线程组内存只有 32 KB,SIMD-group matrix 也显示不可用。
SIMD-group matrix 可以先理解成 GPU 里一组线程协同做矩阵运算的快车道。大模型推理正好有一堆矩阵乘法,能不能走上这条路,差别不会只是几个百分点。
问题在于,应用并没有犯错。
Apple 的 Metal 能力表 本来就要求开发者按 GPU family 和 feature set 做适配,官方文档也建议运行时查询。llama.cpp 看到客体说自己不会,便老老实实选了保守内核。
这是软件世界里很荒诞的一幕。硬件明明能跑,虚拟化桥也能送达,应用甚至非常守规矩,结果却因为能力协商少报了几项,大家一起慢了十几倍。
厉害了,锅没有落在任何一块算力上,落在了自我介绍里。
这个兼容层没有让 GPU 变强
Cua 做的 shim,可以理解成夹在应用和 Metal API 中间的一层薄垫片。
它只拦截被注入进程里的少量能力查询。应用问能支持到哪个 Apple family,它最多回答到经过验证的 1009。应用问最大线程组内存,它从 32 KB 回答成 64 KB。
于是测试版 llama.cpp 能启用更新的 SIMD-group reduction、SIMD-group matrix 和 bfloat16 路径。
这里最值得看的不是改了什么,而是他们刻意没改什么。
Common family、Mac family、Metal family 和工作集大小都保留原值。早期研究 hook 里涉及私有 feature profile、时钟与计时、mesh、光线追踪和 pipeline fallback 的部分也被拿掉。配置缺失或格式错误时,进程回到原始能力路径。
干预面越小,出问题时越容易知道是哪一刀切错了。
这条原则放到 Agent 运行环境里同样有用。一个 coding agent 在隔离 VM 里慢,不一定是模型慢,也不一定是虚拟化天然慢。它可能拿不到 AVX 指令集,可能看见错误的 GPU family,可能被容器限了共享内存,可能在启动时探测到一个降级版库,然后把结果缓存到整个生命周期。
如果评测只记一句 M1 Ultra、16 GB、某某模型,复现的人大概率会收到一份玄学。
至少应该把五类东西钉在同一份运行记录里。
硬件与虚拟设备
宿主与客体系统版本
运行时能力探针结果
模型、二进制与镜像哈希
原始命令、样本分布与回滚开关
这份清单看着不性感,却比一句 GPU 已启用 有用太多。很多性能事故不是机器没给资源,而是程序以为自己没拿到资源。
16 倍很猛,但边界比倍数更值钱
先看最炸的 TinyLlama。
测试机是一台 48 核 GPU 的 M1 Ultra,宿主系统 macOS 26.6.1,客体系统 macOS 26.5.2,8 个 vCPU、16 GiB 内存,Lume 0.5.1。llama.cpp b10167 跑同一个 TinyLlama 1.1B Q4_K_M,提示处理 512 个 token,生成 128 个 token,每行取十次样本的中位数。
原始客体的提示处理是 431.86 tok/s,解锁后是 4,786.70 tok/s,已经达到裸机的 98.25%。生成从 12.63 涨到 206.60 tok/s,快了 16.36 倍,但只到裸机的 72.06%。
也就是说,虚拟机的差距没有消失。只是最离谱的那层降级被拿掉了。
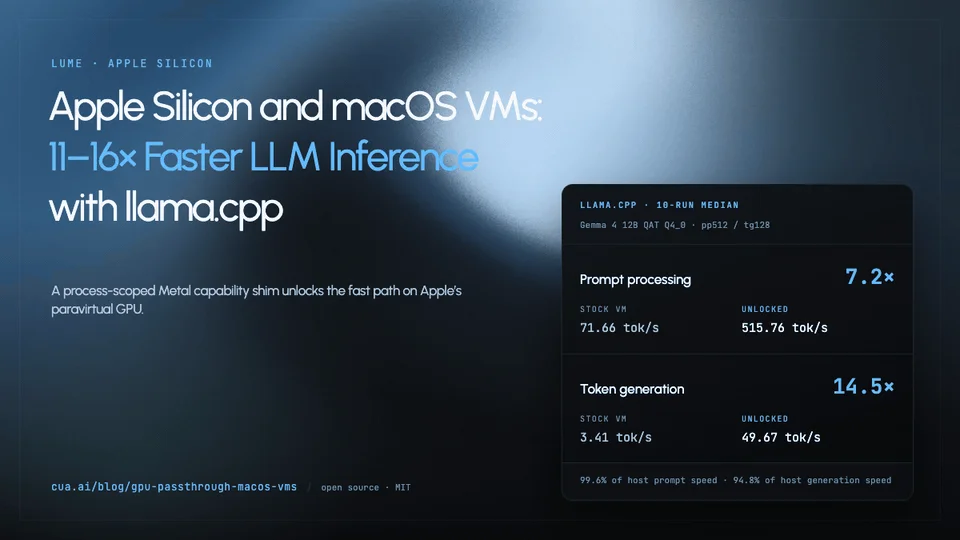
他们又跑了 6.98 GB 的 Gemma 4 12B QAT Q4_0。提示处理从 71.66 涨到 515.76 tok/s,生成从 3.41 涨到 49.67 tok/s,分别提升 7.20 倍和 14.54 倍。保留下来的数据来自同一段无争用时间窗,此前检测到宿主还有其他计算负载的一轮被直接丢弃重跑。
TinyLlama 的公开证据 和 Gemma 4 的公开证据 里,镜像 digest、模型和二进制哈希、命令、JSON、stderr 与校验和都在。
这部分有点子牛逼。不是因为数字大,而是它允许别人沿着同一条路把数字打下来。
Muse Glimmer 30B 也有提升。64 GiB 客体里,提示处理快 7.55 倍,生成快 8.87 倍。不过宿主同时还有另一台偶发 CPU 活动的虚拟机,作者把这个干扰明明白白写进了 Muse Glimmer 证据目录。这组结果只代表文本版 GGUF 通过 llama.cpp 的路径,不代表 Ollama,也不代表多模态 projector 或 speculative decoding。
最有价值的其实是反例。
MLX-LM 在原始虚拟机里已经很快。Llama 3.2 3B 的提示处理在 shim 前后只从 1,656.55 变成 1,665.47 tok/s,生成甚至从 172.09 轻微变成 170.86 tok/s。
啪一下,万能加速器的故事没了。
它修的不是 GPU 性能,而是一条被错误能力回答挡住的 llama.cpp 路径。别的框架如果原本就选对了内核,当然不会凭空再快十几倍。
真要拿去跑 Agent,先把它当研究开关
兼容层源码 已经公开,构建后通过 DYLD_INSERT_LIBRARIES 只注入目标工作负载。长期推理服务可以单独放进一个 LaunchAgent,登录会话里的其他进程保持原样。移除环境变量并重启工作负载,就能回到 stock 路径。
这个作用域设计很重要。
如果你在 Mac 虚拟机里跑的是 computer-use agent、浏览器自动化或代码执行沙箱,一次能力误报可能同时拖慢模型推理、视觉理解和任务周转。快一点当然爽,但让整个客体系统永久伪装成更高能力档,出问题时会非常难收拾。
只给一个进程开,只给验证过的 family,只改验证过的值,旁边放好探针、日志和回滚。
先窄后宽。
Cua 也把限制写得很克制。这套机制依赖客体 Metal 实现里的私有、版本敏感行为,macOS 一更新就可能变化。hardened 或受保护程序可能拒绝动态库注入。当前证据只覆盖一台 M1 Ultra、列出的宿主与客体版本、三组 llama.cpp 模型和一组 MLX-LM 反例。换芯片、换系统、换模型、换 Metal API,都得重新验。
所以,别把 16 倍抄进容量规划表。
把它抄进测试假设里。
我一直觉得,做 Agent 基础设施最容易上头的时刻,就是看到一个巨大的性能倍数。16 倍像海面上突然亮起的一座灯塔,很难不朝它开过去。可真正能让船不撞礁的,还是灯塔下面那几行不起眼的坐标,系统版本、能力回答、二进制哈希、样本方法和回滚路径。
那块 M1 Ultra 从头到尾都没有变快。
只是这一次,软件终于问对了问题,也听见了一个更接近事实的回答。