posts/meta-muse-glimmer-local-agent.md
'Muse Glimmer 能塞进 24GB,不等于能常驻'
24GB 显存,30B 参数,本地常驻 Agent。
把这三个词排在一起,Meta 今天发布的 Muse Glimmer 已经知道该怎么占满开发者的注意力了。
模型权重用 Apache 2.0 许可证开放,定位也很直接,不跟云端巨无霸硬碰硬,专门做本地、长时间在线的智能体。它会规划,会调工具,会检查结果,工具报错后还会尝试恢复。官方甚至把话说到了消费级硬件,Mac 或一张性能不错的 PC 显卡,就有机会把它跑起来。
好家伙,本地模型终于不只是在终端里陪你聊几句,而是准备搬进电脑,接管日程、文件、代码和各种工具。
但我更在意官方材料里的另一个数字。
30B 模型全精度需要超过 55GB 内存。Meta 用接近 4-bit 的量化,把语言模型本体压到 20GB 以下,再把 KV cache、视觉编码器和推测解码用的 drafter 一起塞进 24GB 或 32GB 的内存包络。面向 24GB 的 K-Quant-17GB 版本,在 15 个常见基准的平均准确率指标上下降 1%。面向 32GB 的动态量化版本,下降 0.2%。
这套压缩确实有点子牛逼。
可工程上最容易踩的坑也藏在这里。权重能装下,和智能体能常驻,是两件完全不同的事。
24GB 是入场券,不是工位
很多本地模型演示喜欢截一张加载成功的终端图。显存占用没爆,第一段回复顺利吐出来,棒棒的,模型跑通了。
常驻 Agent 的压力却不是静态的。
KV cache 可以理解成模型处理长对话时留在桌面上的工作草稿。上下文越长,草稿越厚。普通聊天还能定期清掉历史,一个负责日程、文件和代码的智能体却会不断吃进工具返回值、错误日志、网页片段、截图和中间计划。任务从三轮对话拖到三十轮,显存账单会跟着变。
视觉输入还要占一份。Muse Glimmer 有专用的 perception encoder,也就是把图片、截图和文档转换成模型能理解的表示。再加上负责推测解码的 drafter,24GB 不是给语言模型一个人住的单间,更像几组进程合租的两居室。
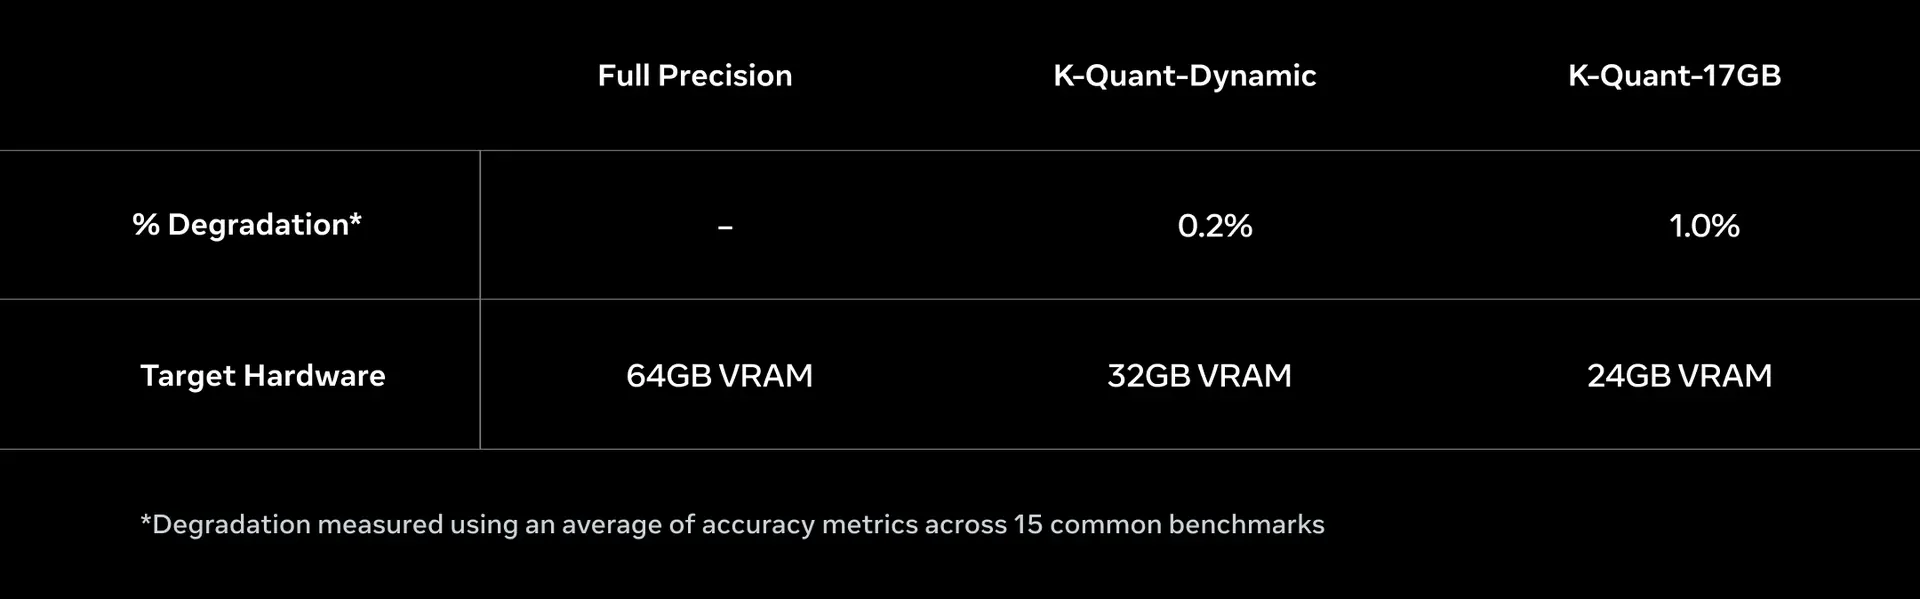
Meta 公布的量化档位,24GB 版本平均指标下降 1%
所以官方说 24GB 能运行,我信。官方也确实给出了量化评测。但如果有人顺手把它翻译成「24GB 显卡可以稳定跑任意长任务」,那就多走了好几步。
同一张卡上跑一个单会话和同时跑三个任务,不是一回事。只读本地文件和持续处理截图,也不是一回事。上下文上限写在模型卡里,不代表你应该把每次任务都塞到上限。显存没有给突发负载留余量,最常见的结果不是性能慢一点,而是任务跑到中段直接被操作系统请出去。
本地常驻的第一条纪律,应该是给动态工作集留空间。24GB 档位适合单用户、低并发、上下文受控的任务。想让多模态输入更频繁,或者让任务挂得更久,32GB 档位那 0.2% 的量化损失和更宽的余量,可能更像一个能过夜的工位。
Agent 的速度,不能只看 tok/s
Meta 这次还带了一张很漂亮的速度图。
Muse Glimmer 附带一个基于 DFlash 的小 drafter。它先猜一组 token,主模型再并行验收,猜对的直接收下,猜错的重新生成。官方数据里,RTX 5090 的平均解码速度从 74.9 tok/s 提升到 233 tok/s,约 3.1 倍。M5 Max 从 26.6 提升到 50,M4 Max 从 23.7 提升到 38。
厉害了。
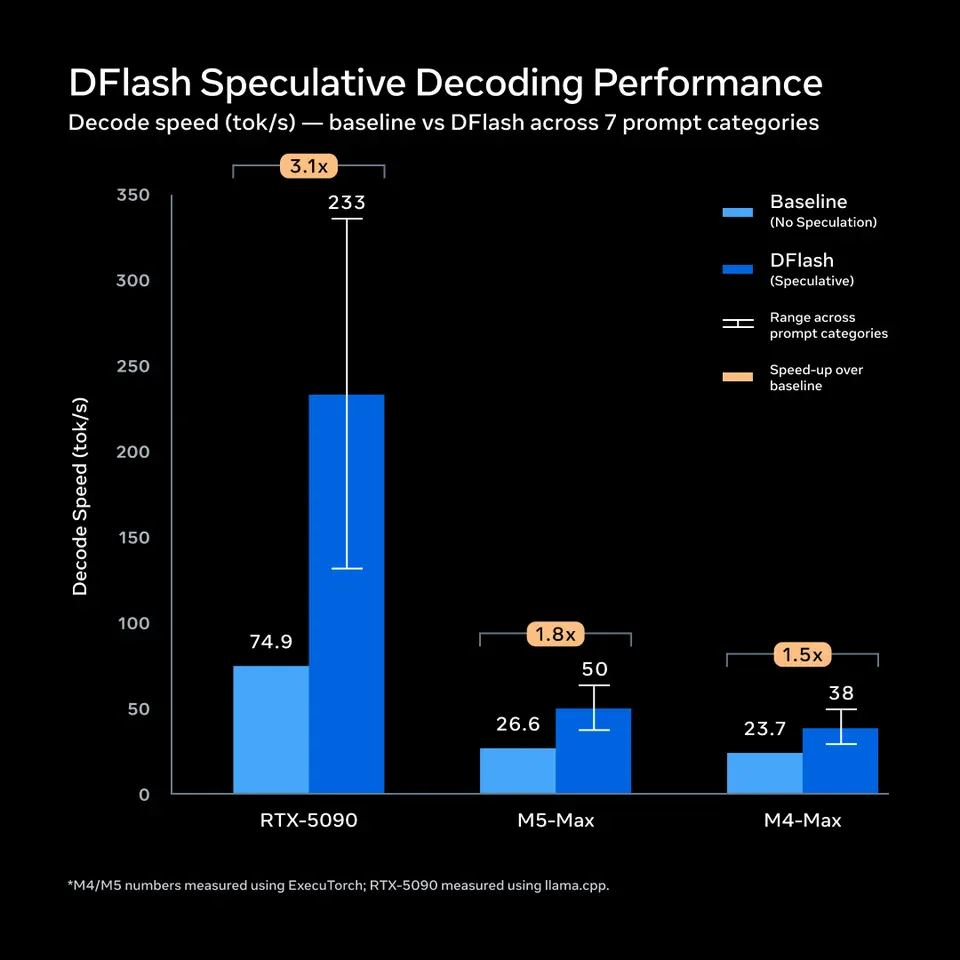
官方测试中,DFlash 在 RTX 5090 上带来 3.1 倍平均解码加速
不过 tok/s 只计算模型吐 token 的速度。一次真实 Agent 任务,还要等浏览器打开页面,等 API 返回,等文件写入,等 shell 命令结束,等失败重试。模型能用 233 tok/s 写出调用参数,工具端卡住 20 秒,用户感受到的仍然是那 20 秒。
更麻烦的是,智能体越聪明,越可能主动多走几步。它发现结果不对,重新规划,再调一次工具,再检查一次输出。单步生成更快了,端到端任务不一定同比变快。甚至有可能因为模型愿意尝试更多恢复路径,整体时长反而增加。
这不是缺点。能恢复比一报错就躺平强多了。只是评测要跟着换。
如果要验收一个本地 Agent,我不会只盯着首 token 延迟和平均 tok/s。我会看完整任务成功率、工具调用次数、无效重试次数、P95 完成时间,以及任务失败后留下了什么脏状态。一个模型 30 秒内结束但把半个工作目录改乱了,另一个模型 90 秒完成且每一步可回滚,生产环境会选谁,答案没那么浪漫。
会恢复,不等于可以随便重试
Meta 的官方能力说明 特别强调 failure recovery。工具返回意外结果时,模型会诊断错误并重试。这对 Agent 很关键,因为现实里的工具从来没有演示视频那么配合。
问题来了,模型认为应该重试,系统就真的应该再执行一次吗?
读文件可以。查询天气大多也可以。发送消息、提交订单、删除文件、创建云资源,就得停下来想想。
假设付款接口已经扣款,但网络连接在返回确认前断了。模型看到超时,判断失败,再调一次。它的恢复逻辑非常积极,你的银行卡也非常积极。
失败恢复不是模型单方面的能力,它是模型和工具共同签下的合同。
工具需要告诉模型,这个动作是否幂等,也就是重复执行会不会产生第二份结果。需要有明确的超时语义,需要提供查询状态的办法,需要把可重试错误和不可重试错误分开。高风险动作还得有审批、额度和撤销路径。
这部分通常不在模型跑分里,却决定了 Agent 能不能拿到真实权限。
Muse Glimmer 在 MCP Atlas、DeepSearch QA、GAIA2 和 SWE-Bench Pro 等智能体或编程评测上表现很强。官方表格也很诚实,它在 GDPval-AA、SkillsBench、OSWorld-Verified、SWE-Bench Verified 和 TerminalBench 等项目并没有全部领先。完整结果可以看 Meta 的方法报告。
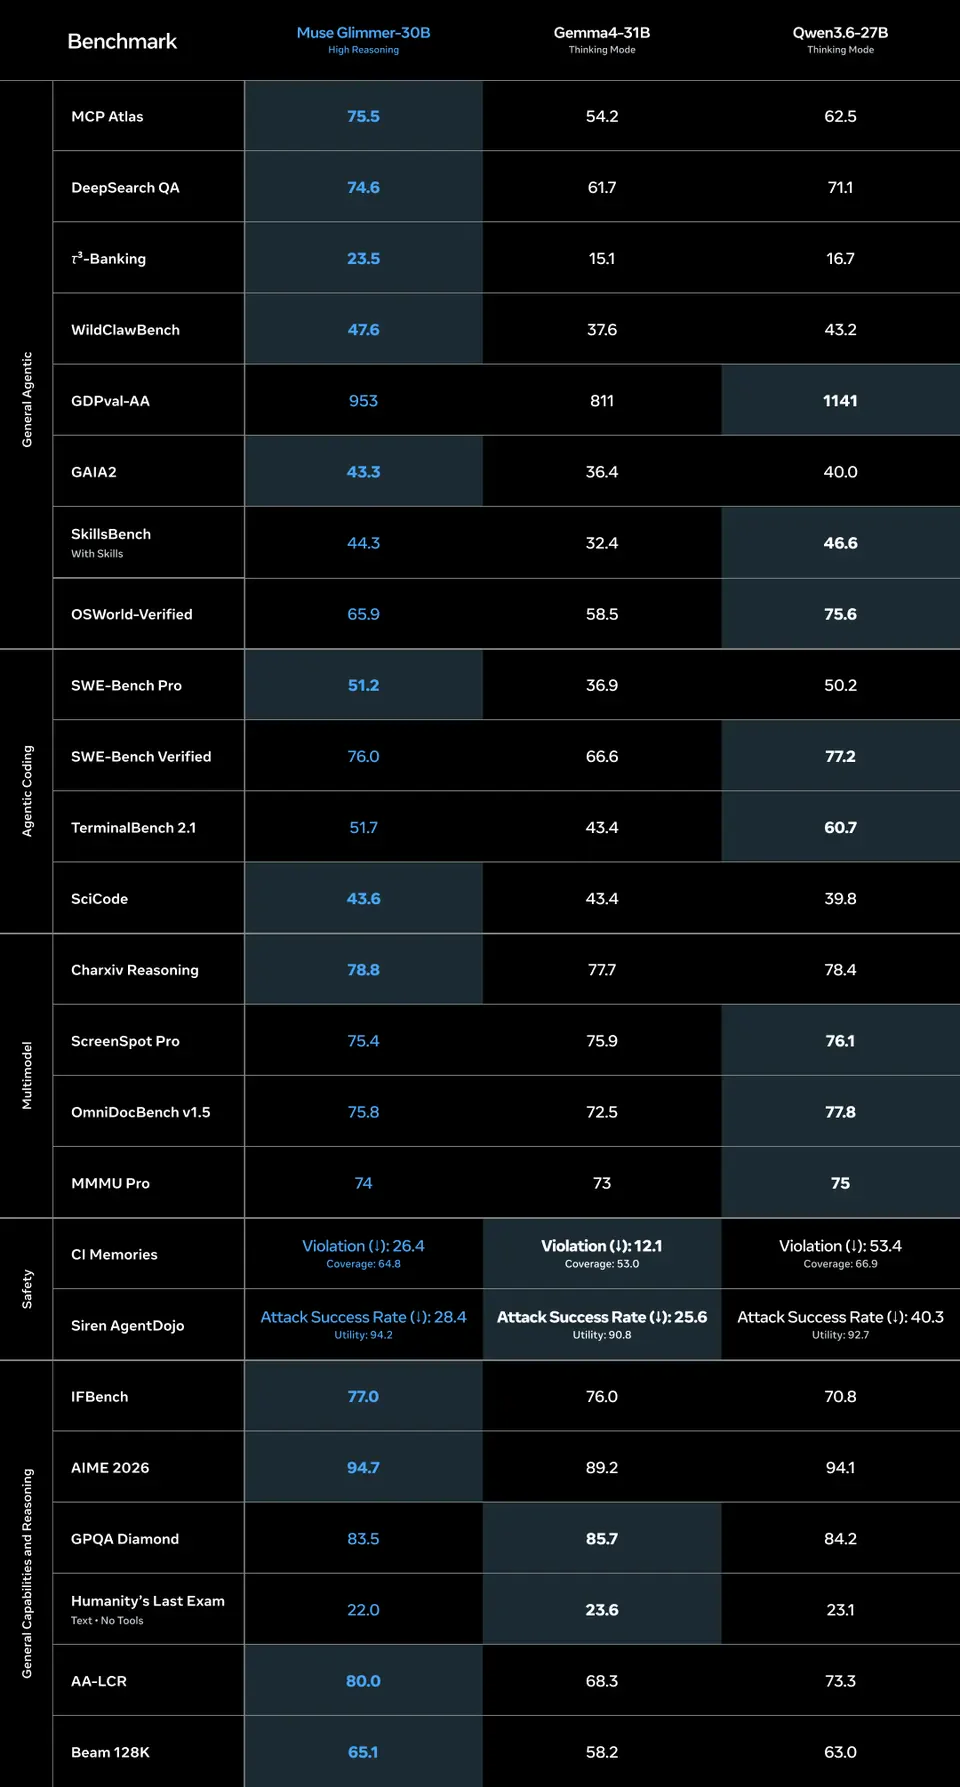
Muse Glimmer 在多项智能体基准领先,但不是每一列都拿第一
这张表给我的感觉反而不错。一个 30B 本地模型不用假装统治所有任务,它更应该在自己的目标场景里足够可靠,然后把剩下的风险交给脚手架约束。
脚手架就是让模型真正干活的那层工程。权限白名单、工具 schema、超时看门狗、重试预算、状态存储、审计日志、回滚点,都在这里。模型负责判断下一步做什么,脚手架负责判断这一步能不能做、做几次、失败后如何收场。
少了后半段,「会用工具」很快就会变成「会制造新的工单」。
本地常驻,真正值钱的是边界
我一直觉得,本地 Agent 最吸引人的地方不是省几次 API 费,而是你终于可以把边界画在自己的机器上。
日程、私人文档、内部代码、浏览记录,这些数据如果能在本地完成大部分处理,确实能减少外发。断网时还能工作,也让智能体从一个网页服务变成更像操作系统能力的东西。Muse Glimmer 支持超过 100 种语言、文本和图片混合输入,也为这类私人上下文提供了不错的底座。
但本地不自动等于安全。
一个常驻进程只要拿到了文件、终端、浏览器和消息权限,攻击面就已经铺开。网页里藏一段提示注入,文档里夹一条恶意指令,工具包被换了依赖,都会把模型从助理变成一只很勤快的事故制造机。数据没上云,只能说明数据流向少了一条路,不能说明权限本身没有风险。
我自己的判断是,Muse Glimmer 这类模型最适合先从三个边界清楚的场景落地。
一个是只读研究。允许它搜索本地资料、整理索引、生成带引用的摘要,但不准改原文件。
一个是沙箱编程。给它独立工作目录、受限命令和明确测试,让写代码、跑测试、修失败都发生在可丢弃环境里。
还有一个是离线评测。用 LLM-as-a-judge 给内部样本做初筛,把最敏感的数据留在机器内,再由人复核边界样本。
这些场景有共同点,失败成本可控,结果容易验收,权限能一层层加。等日志里真的证明它稳定,再开放写文件、发消息和调用外部服务。别第一天就把家门钥匙、公司门卡和支付密码装进同一个工具箱,然后夸模型自主性强。
别急着常驻,先让它熬过一班岗
如果真准备把 Muse Glimmer 放进自己的工作流,我会把第一轮目标定得很无聊。
不是让它一口气接管所有应用,而是先挑十几个每天会重复出现的任务。每个任务都准备固定输入、可核对的预期结果和明确失败条件。让模型在同一套硬件上反复跑,记录峰值内存、上下文长度、工具调用次数、完整耗时和最终状态。
注意,是完整耗时,不只看模型生成速度。
一份研究任务可能只花十秒生成计划,却在网页抓取上等了两分钟。一次代码修改可能很快写完补丁,却在测试重跑和依赖下载上拖了半小时。这些时间落在 DFlash 图表之外,却全部落在用户的等待里。
接着把工具分成三层。第一层只读,搜索、读取、查询都可以自动执行。第二层可逆,允许在沙箱里写文件、创建临时分支、生成草稿,但结果必须能整块丢弃。第三层高风险,发送、删除、付款、修改生产配置,一律需要审批或额外凭证。
不是因为模型笨,而是任何会行动的软件都该有权限边界。数据库客户端要分只读账号和写账号,CI 要保护生产密钥,Agent 当然也一样。行业有时候换了个模型外壳,就突然觉得几十年工程常识可以休假,我寻思了一下,没寻思明白。
然后做一次长时间稳定性测试。让任务队列持续进来,观察 KV cache 会不会一路膨胀,工具子进程会不会变成孤儿,失败重试会不会把同一个坏请求打成自我攻击。模型输出结束不代表任务结束,状态落盘、临时文件清理、锁释放和审计记录都得算在一次运行里。
如果 24GB 档位在你的输入分布上总要贴着上限跑,别跟显存斗气。降低并发,缩短上下文,减少截图分辨率,或者换到 32GB 档位,哪一个都比随机爆掉更便宜。消费级硬件的价值是让实验门槛下降,不是让物理定律给营销文案让路。
还有一条很实用的混合路线。本地模型先做分类、检索、隐私数据整理和低风险工具调用,碰到超长推理或高难代码任务,再把经过脱敏的最小上下文交给云端模型。这样既不要求一个 30B 模型包打天下,也不会把所有数据默认送出去。
坦率讲,这条路线没有「一台电脑养出私人超级智能」那么上头,但它更像能持续维护的软件。等本地模型的能力继续涨,云端升级路径可以一点点缩小。边界始终掌握在你手里,而不是跟着某一家 API 的价格表漂。
Meta 也没有把所有事情都包装成今天就能一键跑通。llama.cpp、MLX 和 ExecuTorch 的优化集成还会在随后几天落地,Ollama、LM Studio、vLLM、SGLang 等渠道也在陆续接入。今天开放的是一块很有潜力的底座,不是一套已经替你处理好权限和运维的本地操作系统。
这点很重要。
Muse Glimmer 把 30B 智能体模型压进 24GB 显存,已经跨过了一个以前很贵的门槛。它让更多开发者有机会在自己的机器上研究规划、工具调用、视觉理解和失败恢复,而不用每一次实验都把数据送到云端。
可真正的常驻,从来不是进程一直没退出。
真正的常驻,是上下文涨起来时不崩,工具卡住时不乱,权限给出去后收得回来,凌晨任务失败时第二天还有一份人能看懂的现场记录。
24GB 是船票。能不能航得久,还得看船舱里那些不太上镜的东西。