posts/metaroce-failure-model.md
百万 GPU 集群,峰值带宽已经不是第一指标
一条链路丢了一个包,为什么能让几千张 GPU 一起等?
这不是那种为了吓人硬凑出来的问题。分布式训练里的 all-reduce,要等一群加速器交换完梯度才能继续。某条路径慢一点,整轮同步就跟着慢一点。昂贵的芯片没有坏,也没有断电,只是在机柜里安静等包。
Meta 在 8 月 24 日发布了 MetaRoCE,一套面向 AI 规模以太网重新设计的 RDMA 传输协议。RDMA 是远程直接内存访问,简单理解,就是让网卡绕开 CPU 的层层搬运,直接把数据送进另一台机器的内存。训练大模型时,GPU 之间那片汹涌的数据,很多都靠它跑。
官方给出的目标很夸张,百万 GPU 规模、通用以太网、无需 PFC,还要高吞吐、低尾延迟、能跨多条路径自动绕开故障。
好家伙,参数看起来像一篇标准的基础设施军备竞赛通稿。
但我把整份设计看下来,最值得聊的并不是百万 GPU,也不是峰值带宽。真正有意思的是,Meta 不再把网络想象成一个永远不丢包、永远按顺序交付、永远需要交换机替端点擦屁股的完美世界。
它直接承认,包会乱,链路会热,平面会坏,运维人员也不可能每次都及时赶到。
然后从这个不完美的前提出发重写传输层。
这条思路,跟我们给 agent(能调用工具并持续执行任务的智能体)搭运行层时学到的教训很像。模型偶尔超时并不可怕,工具调用偶尔失败也不可怕。真正可怕的是,一个局部错误没有边界,转头把整条任务拖死,而且你还不知道它为什么死。
峰值能力决定演示有多漂亮,退化方式决定系统能不能活着上班。
无损网络听起来很美,代价是全网一起屏住呼吸
传统 RoCE 的理想,是让以太网表现得尽量像一张无损网络。数据包最好按顺序抵达,交换机发现拥塞就用 PFC(Priority Flow Control,优先级流量控制)发暂停信号,先别往这里塞了。
这套办法能跑,而且 Meta 自己早就用它支撑过大规模训练。2024 年,Meta 在一篇 RoCE 规模化实践 里写过,分布式训练对网络的要求已经不只是吞吐,还包括可预测延迟和故障恢复。
问题在于,暂停并不会让拥塞凭空消失。它可能沿着依赖关系向上游扩散,让本来没出问题的流也停下来。某个点按下暂停键,旁边的人跟着别动,旁边的旁边也开始等。一路传下去,局部拥塞长成了队头阻塞。
训练集群越大,这个毛病越贵。
Meta 基础设施演进文章 提到的集群已经覆盖数十万张 GPU,并分布在多个数据中心和区域。规模上来以后,故障不再是偶发事故,而是持续背景噪声。硬盘会坏,光模块会抖,某条链路会突然拥塞,某个交换平面会短暂失联。
如果系统设计仍假设网络必须完美,工程团队就只能不断给这个假设打补丁。
MetaRoCE 走了另一条路。它把以太网视为会丢包的普通网络,不要求 PFC,也不要求暂停帧。包不是必须排队走同一条路,而是可以逐包喷洒到多条路径。乱序到达不再被当成异常,而是协议的默认状态。
这个改动看着像网络细节,实际碰的是系统设计里很硬的一条原则。
不要花全部力气消灭失败,要让失败变得局部、可见、可恢复。
交换机只看见包,网卡才看得见任务
Meta 在文中留了一句很漂亮的话,网络结构看见包,NIC 看见意图。
传统做法把很多智能压在网络结构里,交换机负责维持无损和顺序。MetaRoCE 则把判断搬回端点。一个连接下面可以有多条路径,每条路径都维护自己的 RTT(往返时延)、ECN(显式拥塞通知)状态和利用率。
这就像给每条路单独装了一块仪表盘。
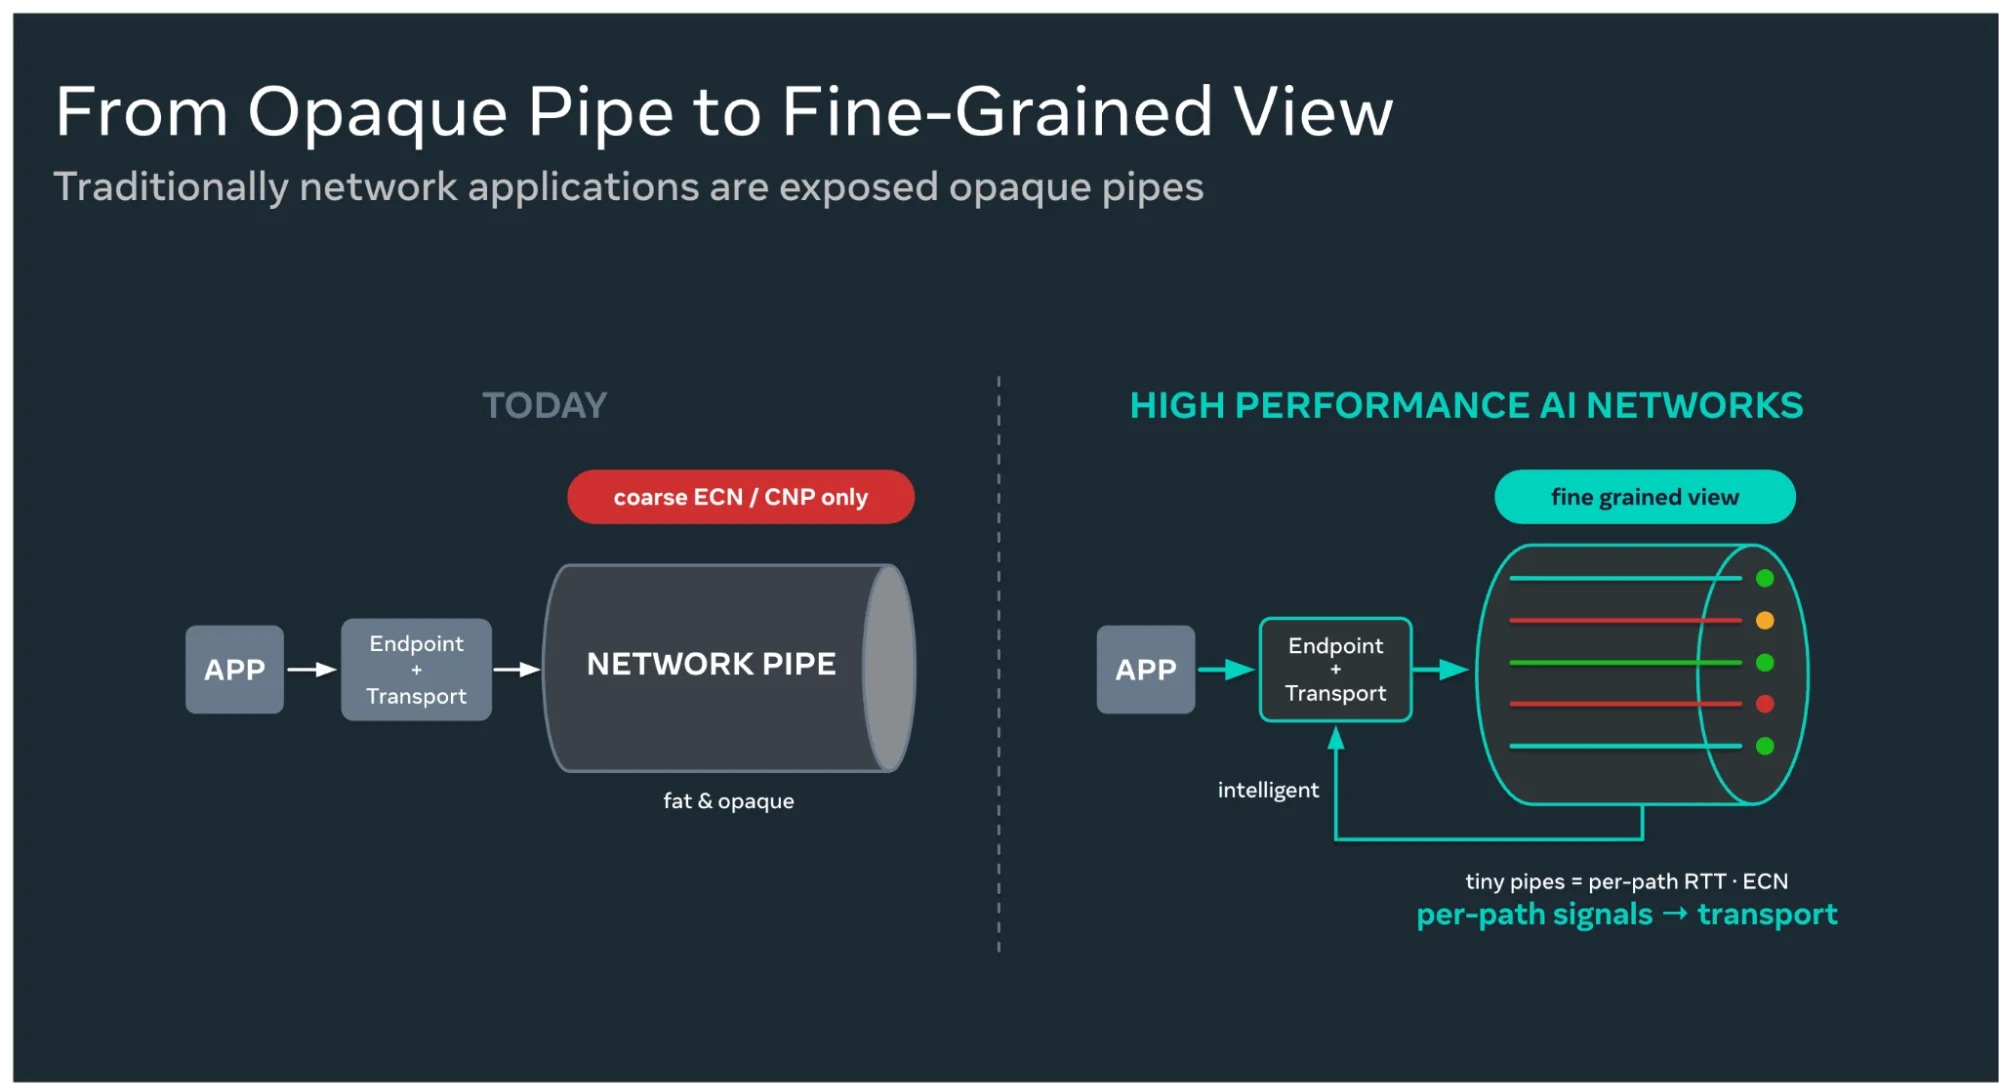
一条路拥塞,系统只缩小那条路的发送窗口,把后续包导向更通畅的路径。一条路坏了,受影响的是那条路,不是整个连接。NIC 能区分拥塞和故障,也能在多平面网络里主动换路,不用等应用发现训练不动了,再叫人半夜翻日志。
更骚的地方在乱序处理。
每个数据包都带着自己的目的地址,到达后可以直接写进最终内存位置。它不需要先塞进重排缓冲区,等前面的包姗姗来迟。对于 Send 操作,包会匹配已经发布的接收缓冲区,即使前面的消息还没到,也知道自己该落在哪里。
队头阻塞被从设计里拿掉了。
丢包识别也跟着变得更精确。每条路径都有自己的有序序列,256 位选择性确认位图里出现缺口,就能判断那是丢包而不是普通乱序。系统只重传丢失的那个包,而不是因为一处缺口把一串已经抵达的数据再搬一遍。
拥塞控制则从两边同时下手。发送端照常根据 ECN 做 AIMD(加性增、乘性减),接收端还会在确认包里告诉发送端,自己给它分了多少入站带宽。大量机器同时向一个接收端回包时,这种 incast 场景最容易把队列打爆。官方说,接收端提示能让流量在一到两个往返内接近公平份额。
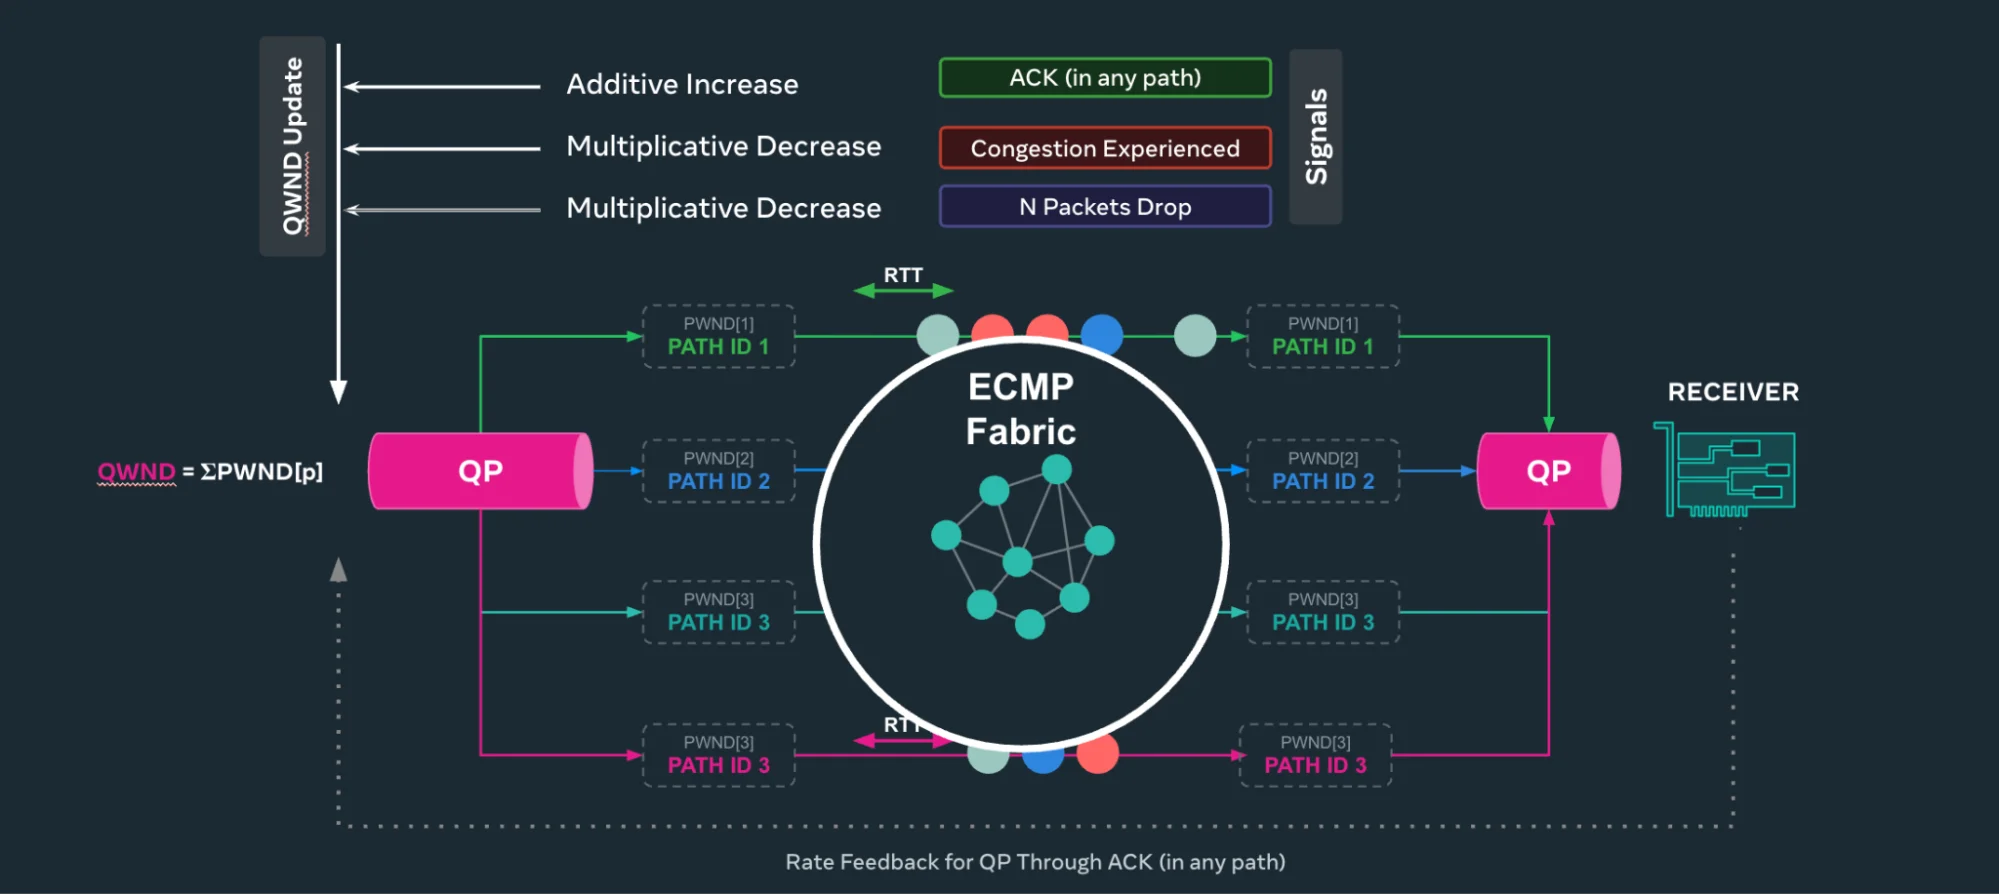
厉害了,这里没有什么玄学优化。它只是让拥有上下文的一端做决定。
这也解释了为什么端点智能正在反复出现。无论是网络、存储,还是 agent 调度,离任务语义越近的地方,越知道哪次重试值得做、哪条路径可以换、哪个局部错误不能扩散。中间层当然还要快,但它不该假装自己知道全部意图。
同一天,Meta 还发布了 MTIA 300。这颗训练芯片把 12 个 800 Gbps RDMA NIC 集成进封装,两组网络 chiplet 合计提供 1.2 TB/s I/O,数据不必穿过 PCIe 总线。芯片和传输协议放在一起看,方向很清楚,网络不再是 GPU 外面那根线,而是计算系统的一部分。
一张跑分图里,最值钱的是没有突然崩掉
Meta 没有只讲架构,还给了一组 64 节点 AMD GPU 集群上的对比。MetaRoCE 跑在 AMD Pensando 可编程 NIC 上,用 RCCL 测 all-reduce 和 all-to-all,对手是 RoCEv2。
结果里最抓眼球的数字不是峰值。
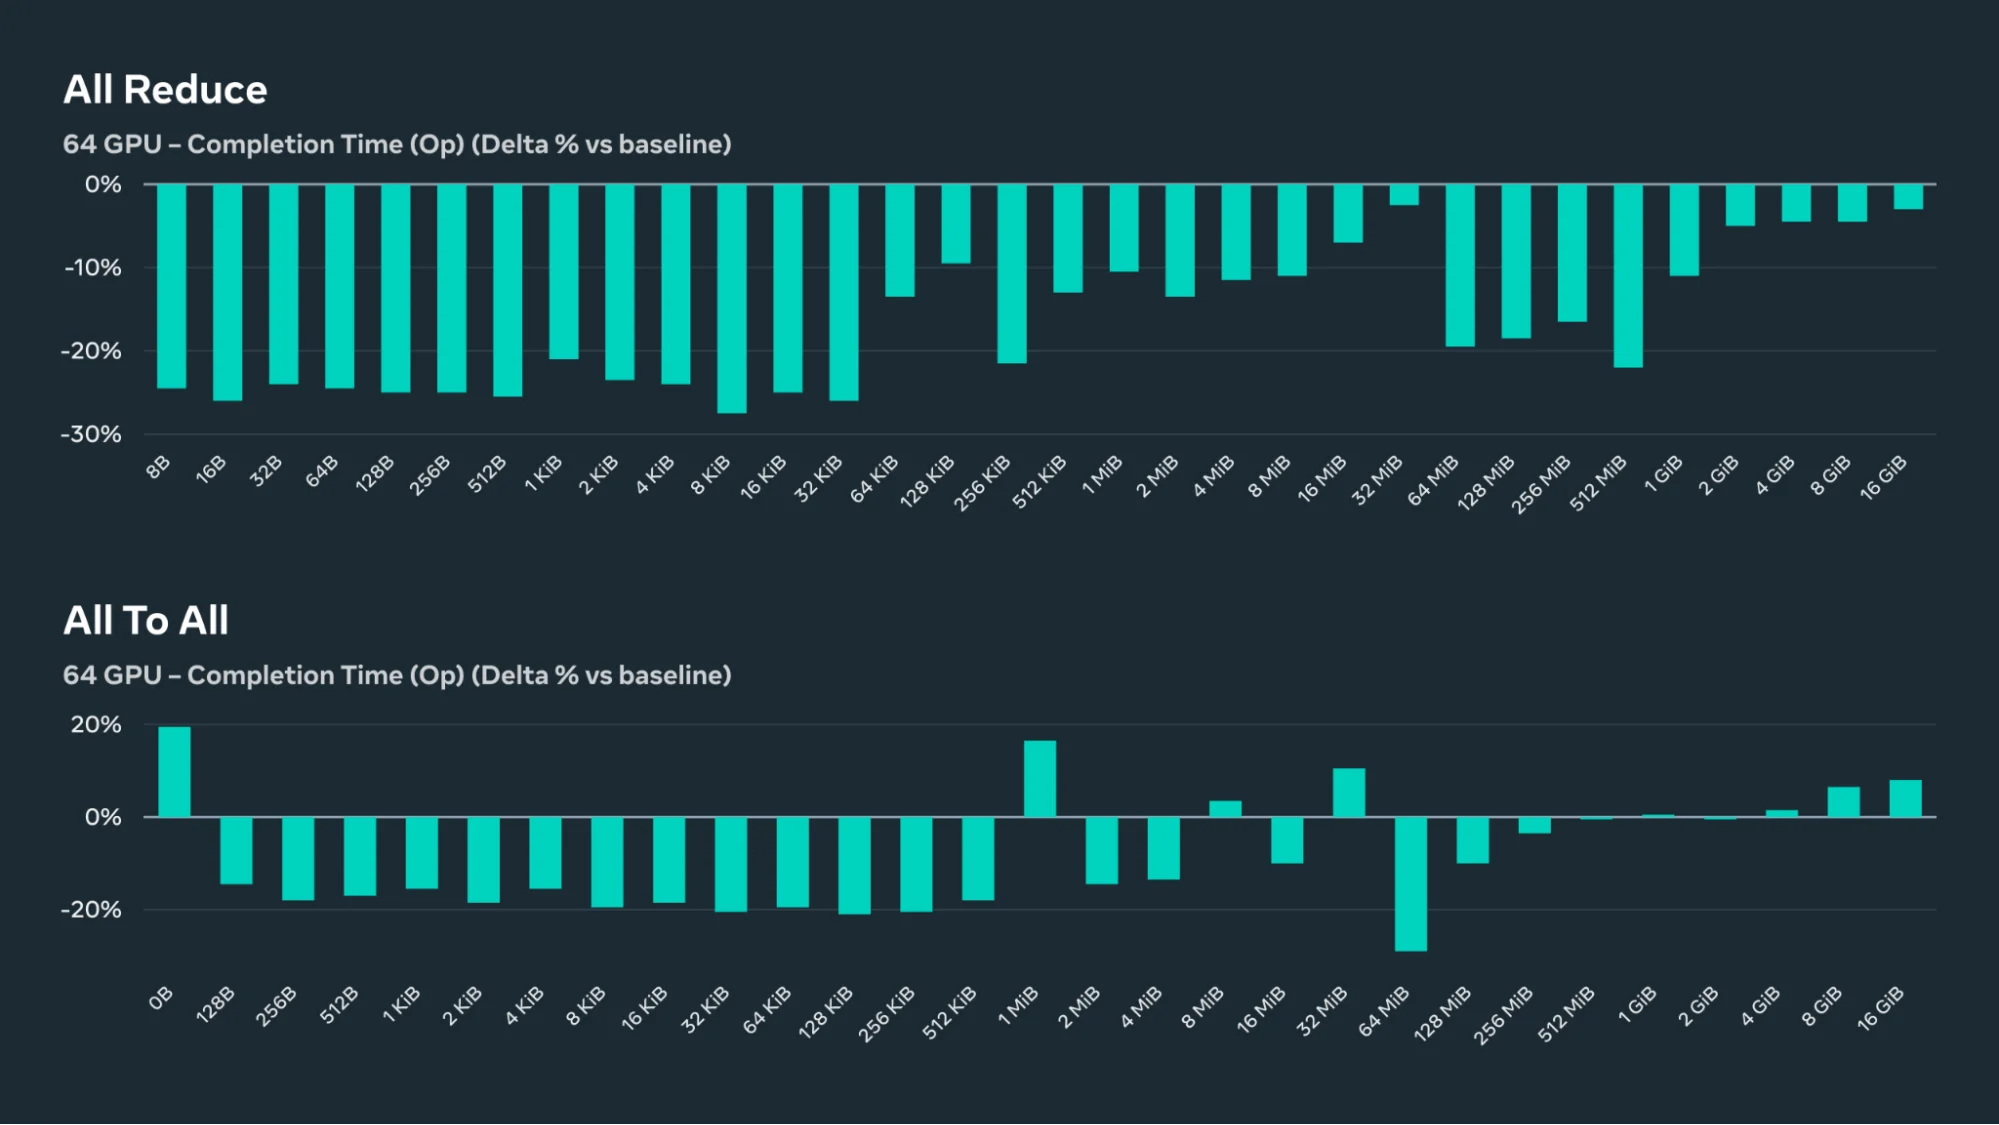
在 1% 丢包率下,MetaRoCE 仍能维持约 86% 吞吐。即使丢包率被推到极端的 10%,它仍能交付有效带宽,没有断崖式坍塌。四平面和八平面拓扑、最多 4000 个并发连接的验证中,吞吐随平面数近似线性增长。模拟整个平面故障时,流量能自动重分配,不需要应用或运维人员介入。
1% 丢包对正常数据中心已经很夸张。把它当日常目标没有必要,拿它做压力测试却很有价值。它测的不是系统在晴天能跑多快,而是天气突然变坏以后,曲线会不会直接掉到地板。
很多 AI 基础设施评测喜欢报一个最漂亮的吞吐数字。多少 tokens per second,每张卡每秒处理多少请求,延迟 P50 又降了多少。数字没错,但 P50 是一个特别会粉饰太平的统计量。用户真正撞上的,经常是 P99 尾延迟,是十次里那一次卡住,是重试风暴把原本健康的实例一起拖下水。
训练也是同一回事。一个同步步骤要等所有参与者,最慢的那个就是集体速度。平均链路很快,没有办法替最慢链路完成 all-reduce。
所以 MetaRoCE 的成绩里,我更在意三件事。丢包只伤到对应路径,拥塞窗口按路径隔离,平面故障能够自动换路。它们共同回答了一个生产系统最朴素的问题。
坏事发生时,损失有没有被关在笼子里?
做 agent 系统也该这么验收。别只测任务成功时用了多少秒,还要主动断掉一个工具、让一个依赖返回限流、把一次回调延迟到超时边缘。看看失败会不会沿着并发任务扩散,重试有没有预算,队列能不能排空,人工接手时有没有足够状态。
模型跑分像峰值带宽,很适合做海报。故障域、重试边界和恢复时间,才决定账单与睡眠。
现在还不能给 MetaRoCE 提前发奖
聊到这里,需要踩一下刹车。
Meta 展示的是 64 节点 AMD GPU 集群,不是百万 GPU 的真实生产验证。百万 GPU 是设计目标,不能偷换成已经跑通的事实。测试数据也来自协议设计方,硬件用的是 AMD Pensando 可编程 NIC,能否在更多厂商、更多拓扑和长期混合负载下保持同样表现,还得等独立结果。
另外,公告里提到开放规范、参考实现和合规套件,但完整产物并没有在发布当天全部落地。Meta 的时间表是 10 月在 OCP Global Summit 发布协议规范、DPDK 优化参考实现和生产合规框架。
现在能看到的是设计、部分实测和开放路线图。
这点必须写清楚。AI 圈很爱把「宣布将开放」缩成「已经开源」,再把「面向百万规模设计」缩成「百万规模跑通」。两次省略,新闻就从工程进展变成了许愿池。
真正决定 MetaRoCE 能不能走出 Meta 的,还有兼容性。官方说现有 RDMA Verbs API 和软件栈无需修改就能运行,这是迁移阻力最低的一环。后面还要看不同 NIC 是否给出可互操作实现,合规套件能否覆盖那些最难复现的边缘故障,以及运维工具能不能把每条路径的状态讲清楚。
协议开放只是起点。能否验证,才是生态。
Meta 把这套思路放进了 OCP 的开放、多厂商路线里,也接上了 ESUN 对 AI 以太网的工作。假如规范、参考实现和合规测试能按计划落地,其他厂商拿到的就不只是一篇博客,而是一套可以实现、对拍、验收的合同。
我一直觉得,基础设施最迷人的地方不在它永远不出错。
恰恰相反,它知道自己一定会出错,所以提前安排好了错误该停在哪里,谁来接住,怎样回来。
百万 GPU 当然很壮观。可真正让这些 GPU 不至于一起发呆的,是那条坏链路终于只拖慢了自己。
这才是 MetaRoCE 最值得看的地方。