posts/minimax-h3-speed-quality.md
MiniMax-H3 的 6.24 倍,不能直接算成六倍产能
8 张 H200,生成一段 10 秒视频,耗时从 217.31 秒压到 34.80 秒。
好家伙,6.24 倍。
这个数字很适合被截进海报,也很适合让老板顺手在群里问一句,既然快了六倍,我们是不是能少买六分之五的卡。
答案没这么省心。
LMSYS、SGLang Diffusion、Cache-DiT、NVIDIA 和蚂蚁团队刚公开的 MiniMax-H3 基准很扎实。固定提示词、随机种子、分辨率、帧率和去噪步数,在同一套 8×H200 上测六组负载,连逐提示词原始数据和复现参数都放了出来。比那种换一半设置再宣布遥遥领先的跑分,靠谱得多。
但它真正有价值的地方,不是证明视频生成终于能快六倍,而是把六倍速度拆成了两笔性质完全不同的收益。
第一笔近两倍,几乎可以白拿。
第二笔再快三倍左右,要拿画面相似度和系统复杂度来付钱。
这两笔账混在一起,才变成海报上的 6.24 倍。很多团队会在这里算错产能。
先把近两倍的免费收益拿走
这次基准的基线是 Hugging Face 的 Diffusers。同样跑 MiniMax-H3,同样 8 张 H200,同样 1344×768、24 FPS、50 个去噪步,SGLang 的密集无损路径已经快了 1.85 至 1.95 倍。
无损两个字很要紧。
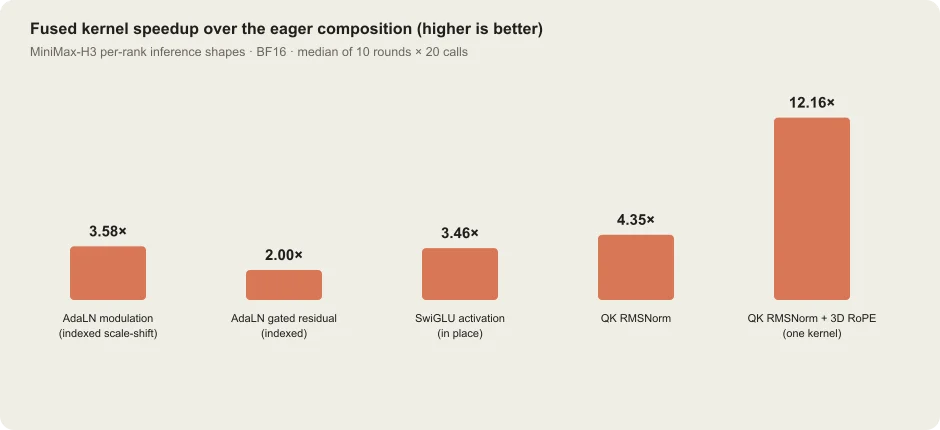
它没有少算去噪步骤,没有跳过注意力块,也没有用另一份画面冒充同一份结果。收益来自运行时本身,包括融合 AdaLN、SwiGLU、QK RMSNorm 和 3D RoPE 这些 kernel,减少中间张量、显存读写和 kernel launch。
其中 QK RMSNorm 与 3D RoPE 的单 kernel 微基准从 1335.6 微秒降到 109.8 微秒,看起来有 12.16 倍。这里也得踩一脚刹车,它只是孤立算子的数字,不能往端到端耗时上直接相加。官方自己把这条边界写得很清楚。
坦率讲,这一层才是大多数团队最该先做的事。
把模型、分辨率、种子和步数钉死,换成 SGLang Diffusion 的 MiniMax-H3 路径,先验证无损结果和资源曲线。能拿到接近两倍,就已经有点子牛逼了。这里没有新质量债,回滚也简单,出了问题还能回到 Diffusers 对照。
很多性能优化项目却喜欢倒着来。先上量化,接着砍步数,再把稀疏阈值拧到底,到头来画面坏了,却不知道是哪一层动的刀。日志里只剩一个总耗时,复盘像在黑屋里摸电线。
先吃无损收益,不只是保守,更是给后面的近似优化留一条可观测的基线。
6.24 倍里,真正有损的部分大约是三倍
最快的 6.24 倍出现在 FL2VA,也就是给首尾帧生成带音频视频的任务。Diffusers 跑 10 秒视频用了 217.31 秒,SGLang 无损用了 114.02 秒,最激进的 SubBlock 0.80 + Cache-DiT stride 用了 34.80 秒。
如果拿最快档直接对 Diffusers,确实是 6.24 倍。
如果拿它对 SGLang 无损,增量大约是 3.28 倍。
这 3.28 倍来自两种近似。
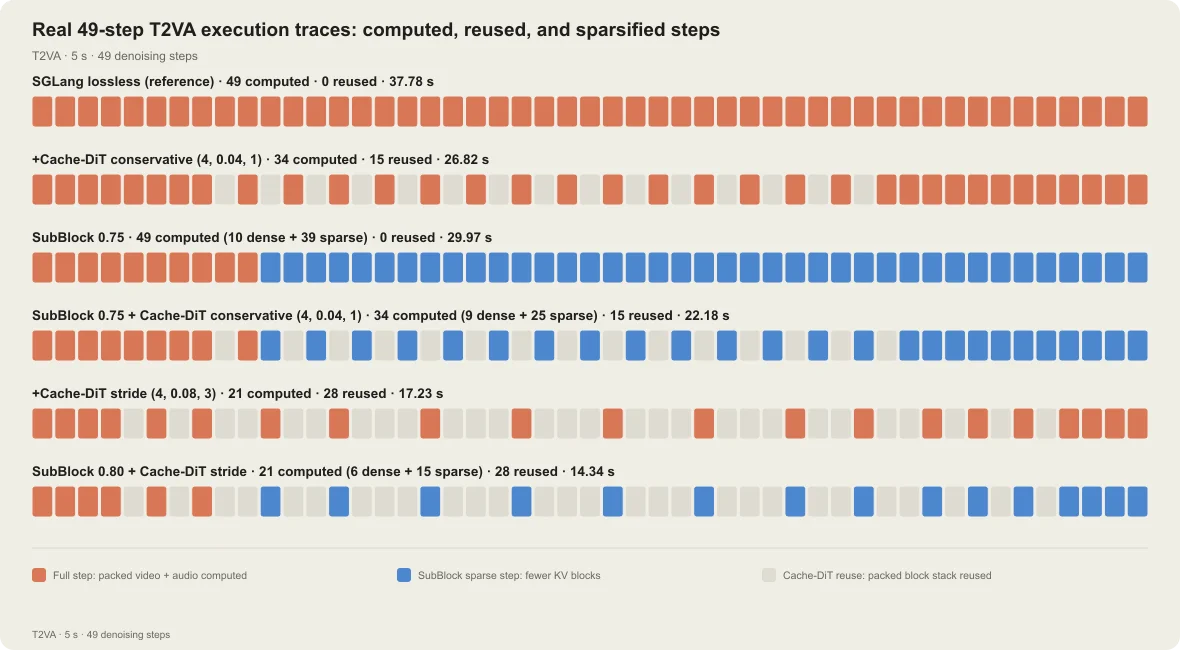
Cache-DiT 会观察相邻去噪步骤的残差变化。变化够小,就复用中间 block 的缓存结果,不把整套计算再跑一遍。Conservative 档的阈值更紧,最多连续缓存一步。Stride 档更激进,阈值放宽,最多连续复用三步。
SubBlock 则对注意力动刀。它把 query 和 key 切成 64-token 的块,再估算哪些 key block 贡献低,只保留高分块进入块稀疏注意力 kernel。sparsity=0.75 不是保留 75%,而是允许丢掉约 75%,最终大约只留四分之一的 key block。这个参数名,多少带点面试题气质。
两者叠起来,一个少跑步骤,一个让仍需运行的步骤少看一堆 token,于是速度继续往上翻。
厉害了。
代价也跟着来了。
同一个开关,在两类任务上不是同一种代价
官方用 SSIM 衡量近似结果和无损结果的结构相似度。SSIM 越接近 1,两段视频在逐帧结构上越像。它不是人类审美分,也不能简单把 0.76 翻译成画质掉了 24%,但它足够揭示一件事,近似误差不是均匀分布的。
FL2VA 在最激进档表现得相当能扛。5 秒与 10 秒视频的 SSIM 分别是 0.8498 和 0.9144,速度达到 5.86 与 6.24 倍。
T2VA,也就是纯文字生成带音频视频,在同一档只剩 0.7584 和 0.7765。速度仍有 5.06 与 5.72 倍,可相似度明显更低。
更有意思的是,Cache-DiT conservative 单独使用时,FL2VA 的 SSIM 能维持在 0.9389 至 0.9771,速度已有 2.78 至 2.99 倍。T2VA 则是 0.8986 至 0.9179,速度 2.65 倍。
这组数把生产系统里一个很常见的误区摊开了。
性能档位不能只跟模型名绑定,得跟任务绑定。
同一个 MiniMax-H3,同一组 H200,同一个近似开关,首尾帧续写和纯文字生成的质量曲线并不一样。你要是给整个集群只配一个全局 fast=true,棒棒的,运维配置很短,质量事故也会来得很整齐。
这还只是三个提示词的中位数。基准足够透明,却仍不是生产 SLA。真实业务里会有字幕、复杂运动、人物一致性、镜头切换、品牌元素、唇形和音画同步。SSIM 能告诉你结构漂了多少,告诉不了你品牌 logo 多了一根线、角色手指突然换数、关键文字写错一个字时,客户会不会退单。
所以 6.24 倍不能直接写进容量规划,更不能直接乘到毛利表上。
线上该怎么开档
如果让我给这套链路设计默认策略,我会把无损 SGLang 当新基线,把近似优化当按任务分配的质量预算,而不是一个全局加速按钮。
可以从一份很朴素的伪配置开始。
profiles:
  final_render: sglang_lossless
  quality_first: cache_dit_conservative
  interactive_preview: subblock_075_cache_stride
  internal_draft: subblock_080_cache_stride
最终交付默认走无损。质量优先但允许轻微变化的批量任务,先试 conservative。交互预览追求等待时间,可以把 SubBlock 0.75 + stride 放进灰度。最激进的 0.80 档先留给内部草稿、分镜探索或明确接受差异的场景。
注意,这不是照抄就能上线的答案,只是一条决策顺序。每个团队得用自己的提示词集重跑。
评测集也别只放十条漂亮样片。应该故意塞进最容易出事的任务,长镜头、快速运动、小字、固定角色、多主体遮挡、首尾帧冲突、音画同步。每条都保留无损输出,把近似档和它做自动指标对比,再补人工盲评。SSIM 可以留着,但至少再加业务自己的失败标签。
接着把运行时版本、模型权重、随机种子、提示词、profile、耗时、峰值显存和缓存命中步数写进同一条追踪记录。SGLang 的这次报告把 49 次真实模型执行里的缓存步数都画了出来,就是很好的示范。参数一变,质量曲线可能跟着变,没有版本化的 profile 只是一句容易过期的愿望。
还有一笔常被漏掉的账。官方数字只统计生成侧推理时间,不含服务启动、预热、HTTP 轮询和 MP4 下载。真实吞吐还受并发、排队、失败重试、显存碎片和长短任务混跑影响。14 秒生成完,前面排队两分钟,用户体感还是一声叹息。
等前面的账算清,才轮到容量规划。
先看你的流量里有多少能走无损,有多少能走 conservative,有多少只做预览。按真实路由占比算加权吞吐,再给回退和重试留容量。别拿最快单元格乘全年请求量,那不是规划,是许愿。
快,不该是一个没有类型的数字
MiniMax-H3 开源时,大家讨论的是视频模型终于能不能自己部署。这次 SGLang、Cache-DiT 和 SubBlock 往前推了一步,问题变成自部署以后,团队能不能把速度、质量和成本做成一套可控制的系统。
我自己的判断是,这份基准里最值钱的不是 6.24 倍,而是它把三层收益分开了。
运行时优化,尽量白拿。
缓存复用,按任务给预算。
稀疏注意力,只在能验收的地方开。
所有原始数据和复现细节都放在公开 benchmark PR里。很多朋友如果真在做视频推理服务,最值得抄的不是某个阈值,而是这种把基线、近似、指标和执行轨迹一起交付的方式。
快当然好。
但生产环境最怕的,从来不是慢一点,而是一个看起来快六倍、实际上没人说得清代价落在哪里的开关。