posts/mistral-agentic-search-retrieval-loop.md
Agentic Search 该加在 RAG 之后,不该替代 RAG
26.7% 到 86%。
这是 Mistral 在 8 月 20 日发布 Agentic Search 时,摆在 FinanceBench 上的一组数字。
同一套文档,同一类问题,传统的一次检索只答对四分之一。让模型自己搜索、打开文件、翻页、读表格、再查一次,正确率接近翻了三倍。
好家伙,RAG 这条老管道突然会自己走路了。
很多介绍到这里就会顺势下结论,传统 RAG 过时了,企业搜索要全面 Agent 化。Mistral 自己反而没有这么说。官方把边界写得很清楚,短文档、直接查值、高并发搜索、来源位置已知的问题,索引检索仍然是更合适的起点。
我更认同这个克制版本。
Agentic Search 应该加在 RAG 之后,负责处理那些第一次没找全、必须继续调查的问题。它不该替代 RAG,更不该让每一句「员工手册里年假有几天」都跑一趟分钟级侦探流程。
真正值得看的,也不是 Mistral 又给 RAG 换了个新名字,而是他们把一次检索改造成了一套可观察的状态机。
一次检索,为什么会在表格面前失灵
传统 RAG 的流程大家很熟。文档先被切成一块块文本,向量化后放进索引。用户提问,系统找出最相关的几个块,塞给模型作答。
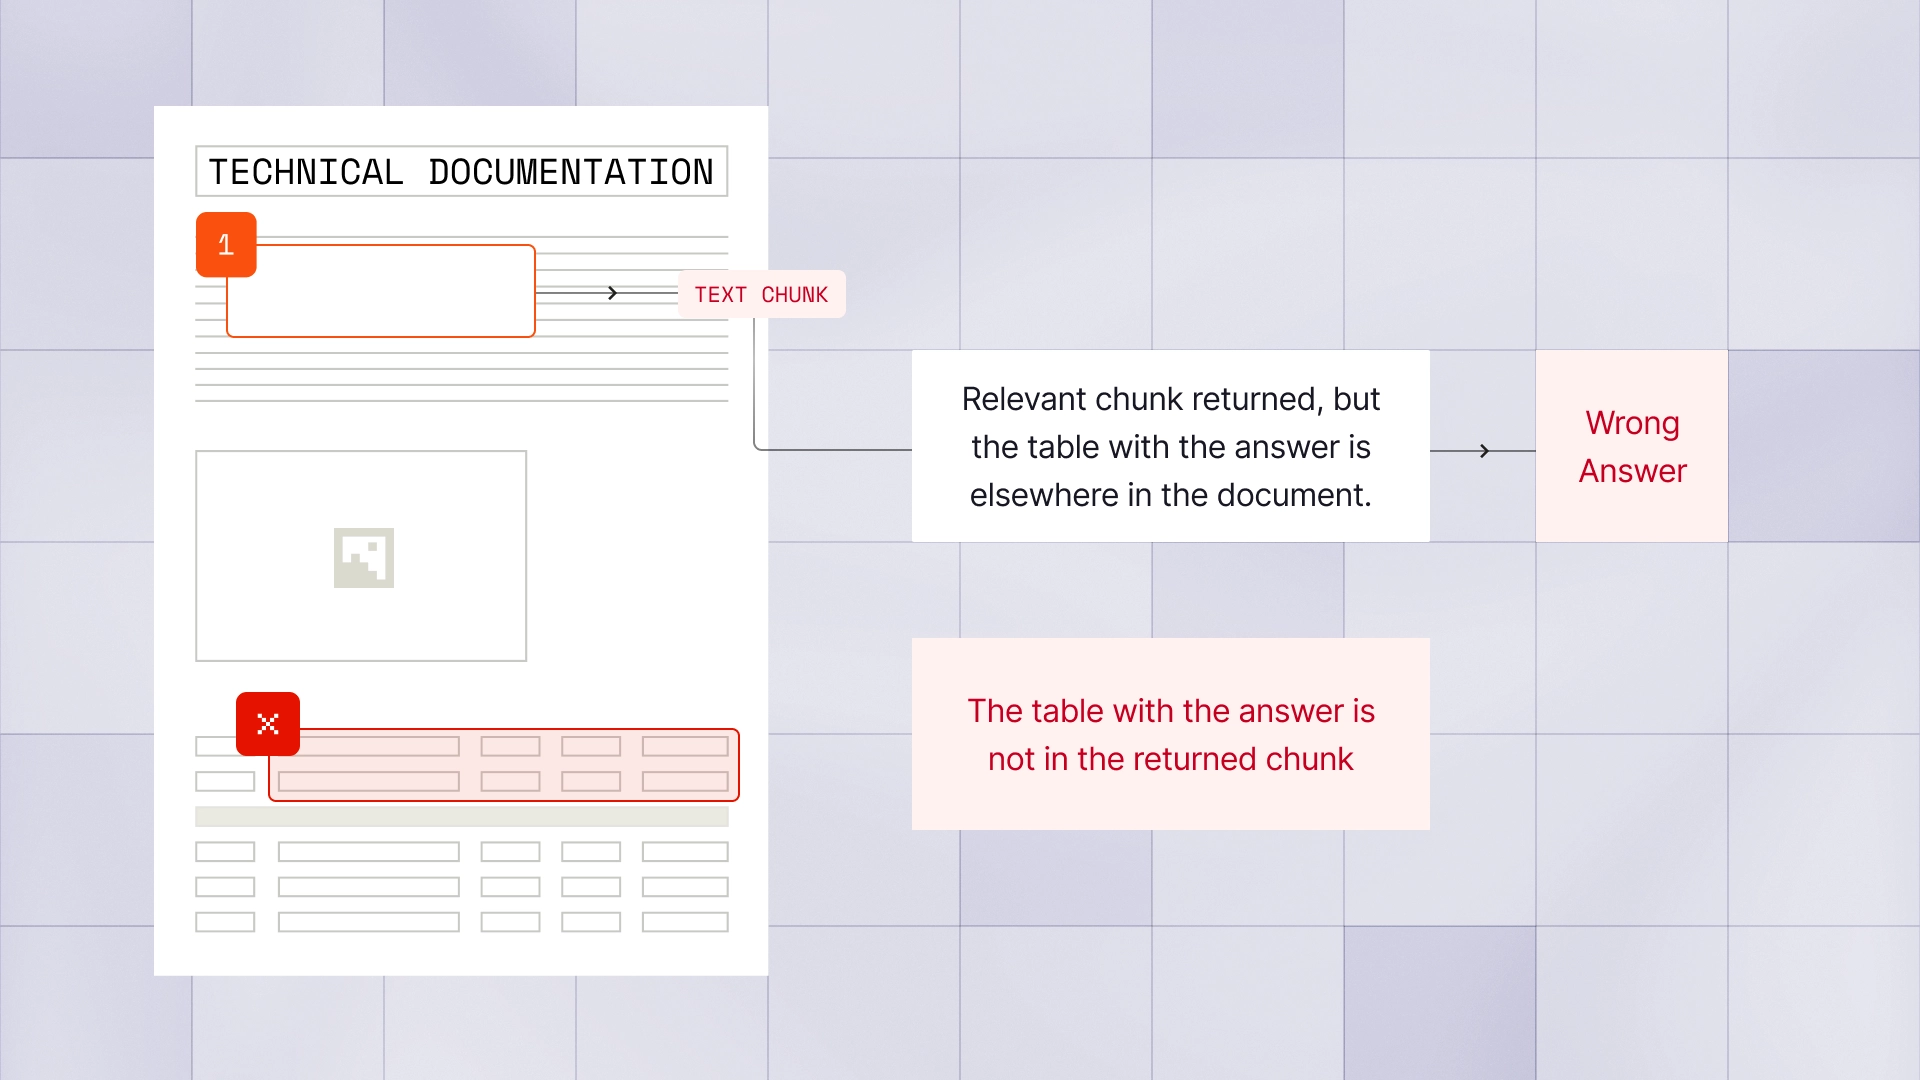
这招对说明文、FAQ 和短答案很好用。问题出在真实企业文档往往不是一段顺滑的 Markdown。答案可能藏在 147 页财报的脚注里,可能横跨两张表,可能要先看定义,再回到另一页取数字。
向量索引找到了「相关文档」,不等于找到了「答案所在的位置」。
Mistral 在官方示例里问了一个很笨重的问题,要把 1953 年美国国防相关支出的 12 个月数字全部加起来。一次搜索命中了财政公报,却只拿到上半年。模型知道资料不完整,但 one-shot RAG 已经把下一步的路封死了。
尴尬就尴尬在这儿。检索系统没有完全找错,它只找对了一半。模型也不是不会算,它只是拿不到另外六个月。
Mistral 的解法不复杂,给模型五把很像文件系统命令的工具。
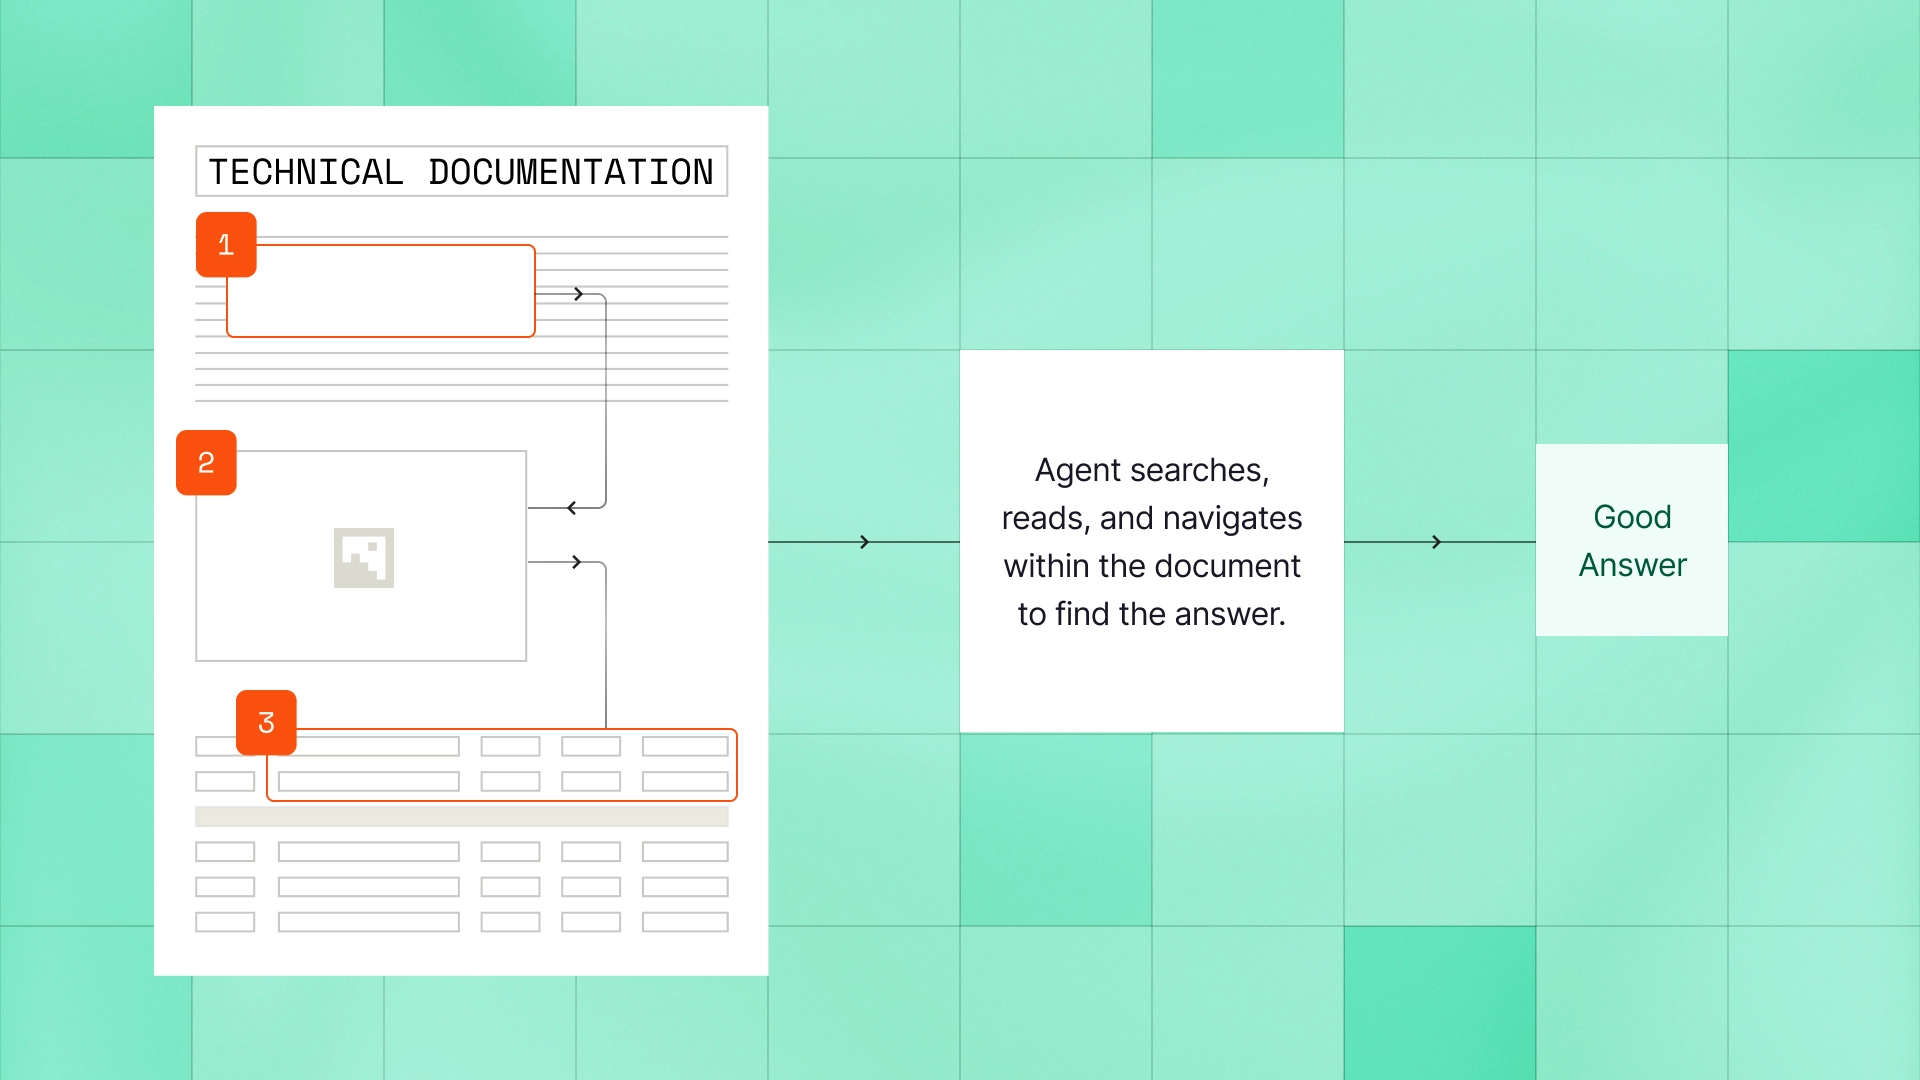
search 找文档,open 打开文档,navigate 移到具体页或章节,read 读取那一块内容,grep 在已打开的文档里查模式。
第一轮搜索只找到上半年,模型可以换关键词,再找包含 11 月、12 月和全年累计的公报。随后打开 1954 年 2 月的文件,跳到第 15 页,读取完整表格,再把 12 个数相加。
这五把工具单看都不神奇。真正有点子牛逼的地方,是模型可以根据当前证据决定下一步,不必被第一次 top-k 结果绑死。
索引继续干它擅长的事,快速缩小范围。Agent 负责往文档深处走,发现证据不够就改道,找到答案后还能留下具体页码和读取轨迹。
这已经不是「多查几次向量库」了。
它是一台检索状态机。
五把工具,把 RAG 变成了调查任务
可以把这套循环想成几种状态。系统先处于「找来源」,命中文档后进入「检查来源」,再进入「定位证据」和「读取证据」。发现材料不足,就退回「找来源」。证据齐了,才允许进入「生成答案」。
每次状态切换都要回答一个问题。
为什么打开这份文档。为什么跳到这一页。当前证据缺了什么。再搜一次能补上什么。什么时候已经足够,可以停。
传统 RAG 往往只保留最终命中的几个文本块。Agentic Search 多了一条完整轨迹。对于财务、法务、合规和运维场景,这条轨迹常常比那段自然语言更值钱。
因为使用者真正关心的不是模型说得像不像,而是它从哪份文件的哪一页拿到这个数字,是否看过上下文,有没有把两个口径不同的表格硬凑到一起。
官方基准也能解释为什么效果会跳这么多。
FinanceBench 有 368 份 SEC 文件,平均每份约 147 页。只把 one-shot RAG 换成能反复搜索的循环,Mistral Medium 3.5 准确率增加 47.3 个百分点,GLM-5.2 增加 52.6 个百分点。再加上打开、导航、阅读和 grep,两款模型又分别多拿到 8.7 和 6.7 个百分点。
更有意思的是,导航没有让系统更浪费。相较只会反复广搜的 Agent,完整工具组让两款模型的 token 消耗分别下降 23.9% 和 33.7%,p90 延迟从 255 秒降到 154 秒。
注意这个比较对象。
154 秒打败的是 255 秒的「只会反复搜索」方案,不是毫秒级的一次索引查询。官方数字证明了精准导航比无脑重搜更省,却没有证明所有问题都值得等两分半钟。
这条小注脚,才是生产环境的分水岭。
一分钟级检索,先别拿去接所有请求
如果把 Agentic Search 直接挂在企业问答入口,每个问题都自动进入五工具循环,第一周可能很惊艳,第二周监控面板就会开始说人话。
延迟飙了,模型调用次数多了,文档服务被频繁打开,用户在一个简单问题前盯着加载动画。更麻烦的是,长尾任务的成本很难靠平均值看出来。大多数问题三步结束,少数问题在相似文档之间来回搜索十几轮,账单和超时一起飞。
更稳的做法是先加一道路由。
直接查值、固定来源、短文档和高频问题走普通检索。跨文档比较、表格核验、来源不确定、首次结果置信度低的任务,才升级为 Agentic Search。
这不是让模型凭感觉选贵的那条路。路由器至少要看问题类型、首次检索分数、来源数量、是否要求引用、是否出现表格或页码,以及业务允许的延迟预算。
可以先给系统两个服务等级。快速通道只做一次检索,目标是秒级返回。调查通道允许多步工具调用,明确告诉用户这是深度查证,给它更长的超时和更严格的证据要求。
同一个搜索入口,背后其实是两种产品承诺。把它们混成一条链路,快问答会被拖慢,难问题又会因为总超时太短而半途而废。
五把工具,也是五个权限入口
检索一旦从「拿回几个文本块」变成「模型可以在文档库里行动」,安全模型也得跟着变。
search 可能跨过用户原本看不到的集合。open 会接触完整文档。navigate 和 read 可能把敏感页带进模型上下文。grep 尤其容易被当成一把万能钥匙,在一份长文件里搜邮箱、账号、合同金额或内部代号。
官方强调 Search Toolkit 可以部署在云端或本地隔离环境里,这很重要,但「数据没有离开内网」不等于「每个 Agent 都该看到所有数据」。
权限必须在每一次工具调用时重新求交集。
用户能看什么,当前任务被授权查什么,索引里哪些字段可以返回,打开文档后哪些页需要脱敏,成稿允许引用到什么粒度。任何一步只靠系统提示词提醒模型自觉,迟早会碰到一条让人睡不着的轨迹。
我始终觉得,企业 Agent 的权限设计应该像数据库查询,而不是像聊天机器人。身份、资源、动作、范围都要能被机器检查,拒绝也要成为正常事件,不是异常崩溃。
这一层如果没做,准确率越高,Agent 找敏感信息也越利索。棒棒的。
没有轨迹,86% 只是演示数字
多步检索另一个容易漏掉的坑,是系统只保存答案,不保存过程。
Agentic Search 的价值恰恰在过程。每次查询词、返回结果、打开的文档、跳转位置、读取片段、工具耗时、token 消耗和停止原因,都应该进入可检索的 Trace。
否则线上答错时,团队只能看到一句流畅的错误答案,不知道是索引漏了文档,重排把正确结果压下去了,模型没打开命中的文件,还是读到一半就被超时切断。
这几类问题的修法完全不同。
索引漏召回,要改摄取、分块或相关性配置。模型路线错了,要改工具描述、查询改写或路由。读到了证据却算错,要换模型或增加确定性计算。到了上限还没答案,应该明确返回证据不足,而不是让模型用已有碎片补一段看起来完整的话。
Mistral Search Toolkit 把摄取、索引和检索放进同一套框架,还提供 摄取配置、索引与排序 以及 检索扩展 的入口。框架能帮你少接几段水管,业务评测还是得自己做。
官方那组 86% 来自 368 份 SEC 文件和 150 个问题。OfficeQA Pro 更难,GLM-5.2 从 6.3% 涨到 51.9%,提升很猛,另一面也很诚实,接近一半的问题仍然答错。
所以别拿厂商基准给自己的合同库签保单。
最小评测集应该来自真实失败。每道题保存标准答案、必需证据位置、允许来源、最大工具步数和可接受延迟。上线前同时看正确率、证据覆盖率、无答案拒答率、p95 延迟、每题成本与越权次数。
只有正确率一根柱子,系统很容易通过多搜、多读、多花钱把分数堆上去,然后在生产里把体验和预算一起吃掉。
停止条件,比再搜一次更难
检索 Agent 最危险的诱惑,是永远觉得下一次搜索可能更好。
当前证据不完整,再查一次很合理。新结果互相矛盾,再找第三份来源也合理。表格缺一列,换关键词还是合理。每一步单看都说得通,连起来就可能变成一条没有出口的循环。
停止条件不能只写一个最大步数。
系统还要判断证据是否已经覆盖问题中的全部子项,新增搜索有没有带来新信息,来源之间是否仍有关键冲突,剩余预算够不够完成阅读与回答。连续两轮没有新增证据,就应该收敛。命中受限文档,就返回权限不足。达到时间或成本上限,就把已找到的证据和缺口一起交出来。
这种失败不是丢脸。
在高风险场景里,「目前证据不足」比一段补齐空白的流畅答案专业得多。
真想试,先跑一个双通道原型
Mistral 已经开源了 Search Starter App。它用 Copier 生成项目,底层接 Search Toolkit、Vespa 索引和混合检索。官方示例需要 uv 与 Docker,几条命令就能把本地样例跑起来。
uvx copier copy gh:mistralai/search-starter-app my-search-project
cd my-search-project
make setup-vespa
make ingest path=sample_data/hello.txt
make search query="hello world"
跑通 Demo 以后,先别急着把公司网盘全灌进去。
挑二三十个普通检索已经能答对的问题,再挑二三十个必须跨页、跨表或跨文档的问题。给两类任务分别设延迟和成本上限。普通问题保持 one-shot,困难问题才打开工具循环,然后比较正确率提升到底值不值新增的时间、token 和运维复杂度。
再故意造几类失败。文档权限不足,两个来源互相矛盾,目标表格被扫描歪了,正确文档完全不在索引里,工具连续两轮返回重复内容。
如果系统能在这些情况下停下来,解释缺了什么,并留下完整轨迹,这个原型才开始像生产系统。
回到开头那组漂亮数字。
Mistral 证明了一个很重要的方向。复杂文档检索不该把模型锁在第一次 top-k 结果里,搜索、打开、导航、阅读和核验可以组成一条更聪明的调查路线。
但路线越长,刹车、路权和行车记录仪就越不能省。
RAG 负责把大海缩成一片海域,Agentic Search 再决定往哪座岛靠岸。两者是前后关系,不是替代关系。