posts/mtia300-communication-offload.md
MTIA 300 最狠的,不是把网卡塞进芯片
一类大型推荐模型里,embedding 表可以吃掉 99% 以上的参数。
它未必缺算力,缺的是把这些参数及时搬到该去的地方。
Meta 8 月 24 日公布的 MTIA 300,就是冲着这个有点古怪的瓶颈去的。两块网络芯粒,12 个 800 Gbps RDMA NIC,也就是能绕开 CPU 层层搬运、直接访问远端内存的网卡,外加 16 个专门处理通信的消息引擎,合计 1.2 TB/s I/O 带宽。网卡不再挂在 PCIe 总线另一头,而是直接住进芯片封装。
好家伙,别的 AI 芯片还在比谁的浮点算力更大,Meta 先把路修进了院子。
不过,只盯着「网卡进芯片」还是容易看浅。MTIA 300 真正有意思的地方,是它没有把通信当成计算之外的配套设施。NIC、近内存归约、HCCL 通信库、PyTorch 接口与芯片执行单元,从一开始就在同一张设计图里。
我的判断是,这不是一块更快的通用 GPU,也不是一条所有模型都能照抄的捷径。它更像一个很具体的工程答案,既然最贵的等待发生在数据移动上,就别继续给计算单元堆预算,直接重画系统边界。
推荐模型的麻烦,不在算不动
大语言模型把大家的注意力牢牢钉在 FLOPS,也就是每秒能做多少次浮点运算上。这个指标当然重要,但推荐和排序模型长得不太一样。
你刷到哪条短视频、首页先出现哪位朋友、广告系统下一秒该选哪个候选,背后往往依赖巨大的 embedding 表。可以把 embedding 理解成一座存放用户、内容和商品特征的仓库。仓库的货架可能占模型参数的 99% 以上,真正执行计算的网络反而只占很小一块。
问题来了。仓库再大,货拿不过来,灶台就只能空等。
训练这类模型时,数百个加速器会频繁执行 AllReduce、AllToAll 和 AllGather。它们分别负责把各卡结果归并、让多张卡互相交换数据、把分散的数据重新收集。传统 GPU 通常让 NCCL 把这些通信操作也作为 GPU kernel 执行。训练计算和数据搬运于是开始抢同一批流式多处理器。
这事很像让厨师一边炒菜,一边自己跑仓库搬箱子。厨师的刀工再快,整桌菜也快不起来。
Meta 的官方数据称,大型矩阵乘法和集合通信并行时,MTIA 300 的计算吞吐下降不到 0.5%,而通信占用同一批计算资源的传统 GPU 可能下降超过 20%。这里要踩一下刹车,这组对照来自厂商自己的特定负载,不能直接外推到所有 GPU 集群。
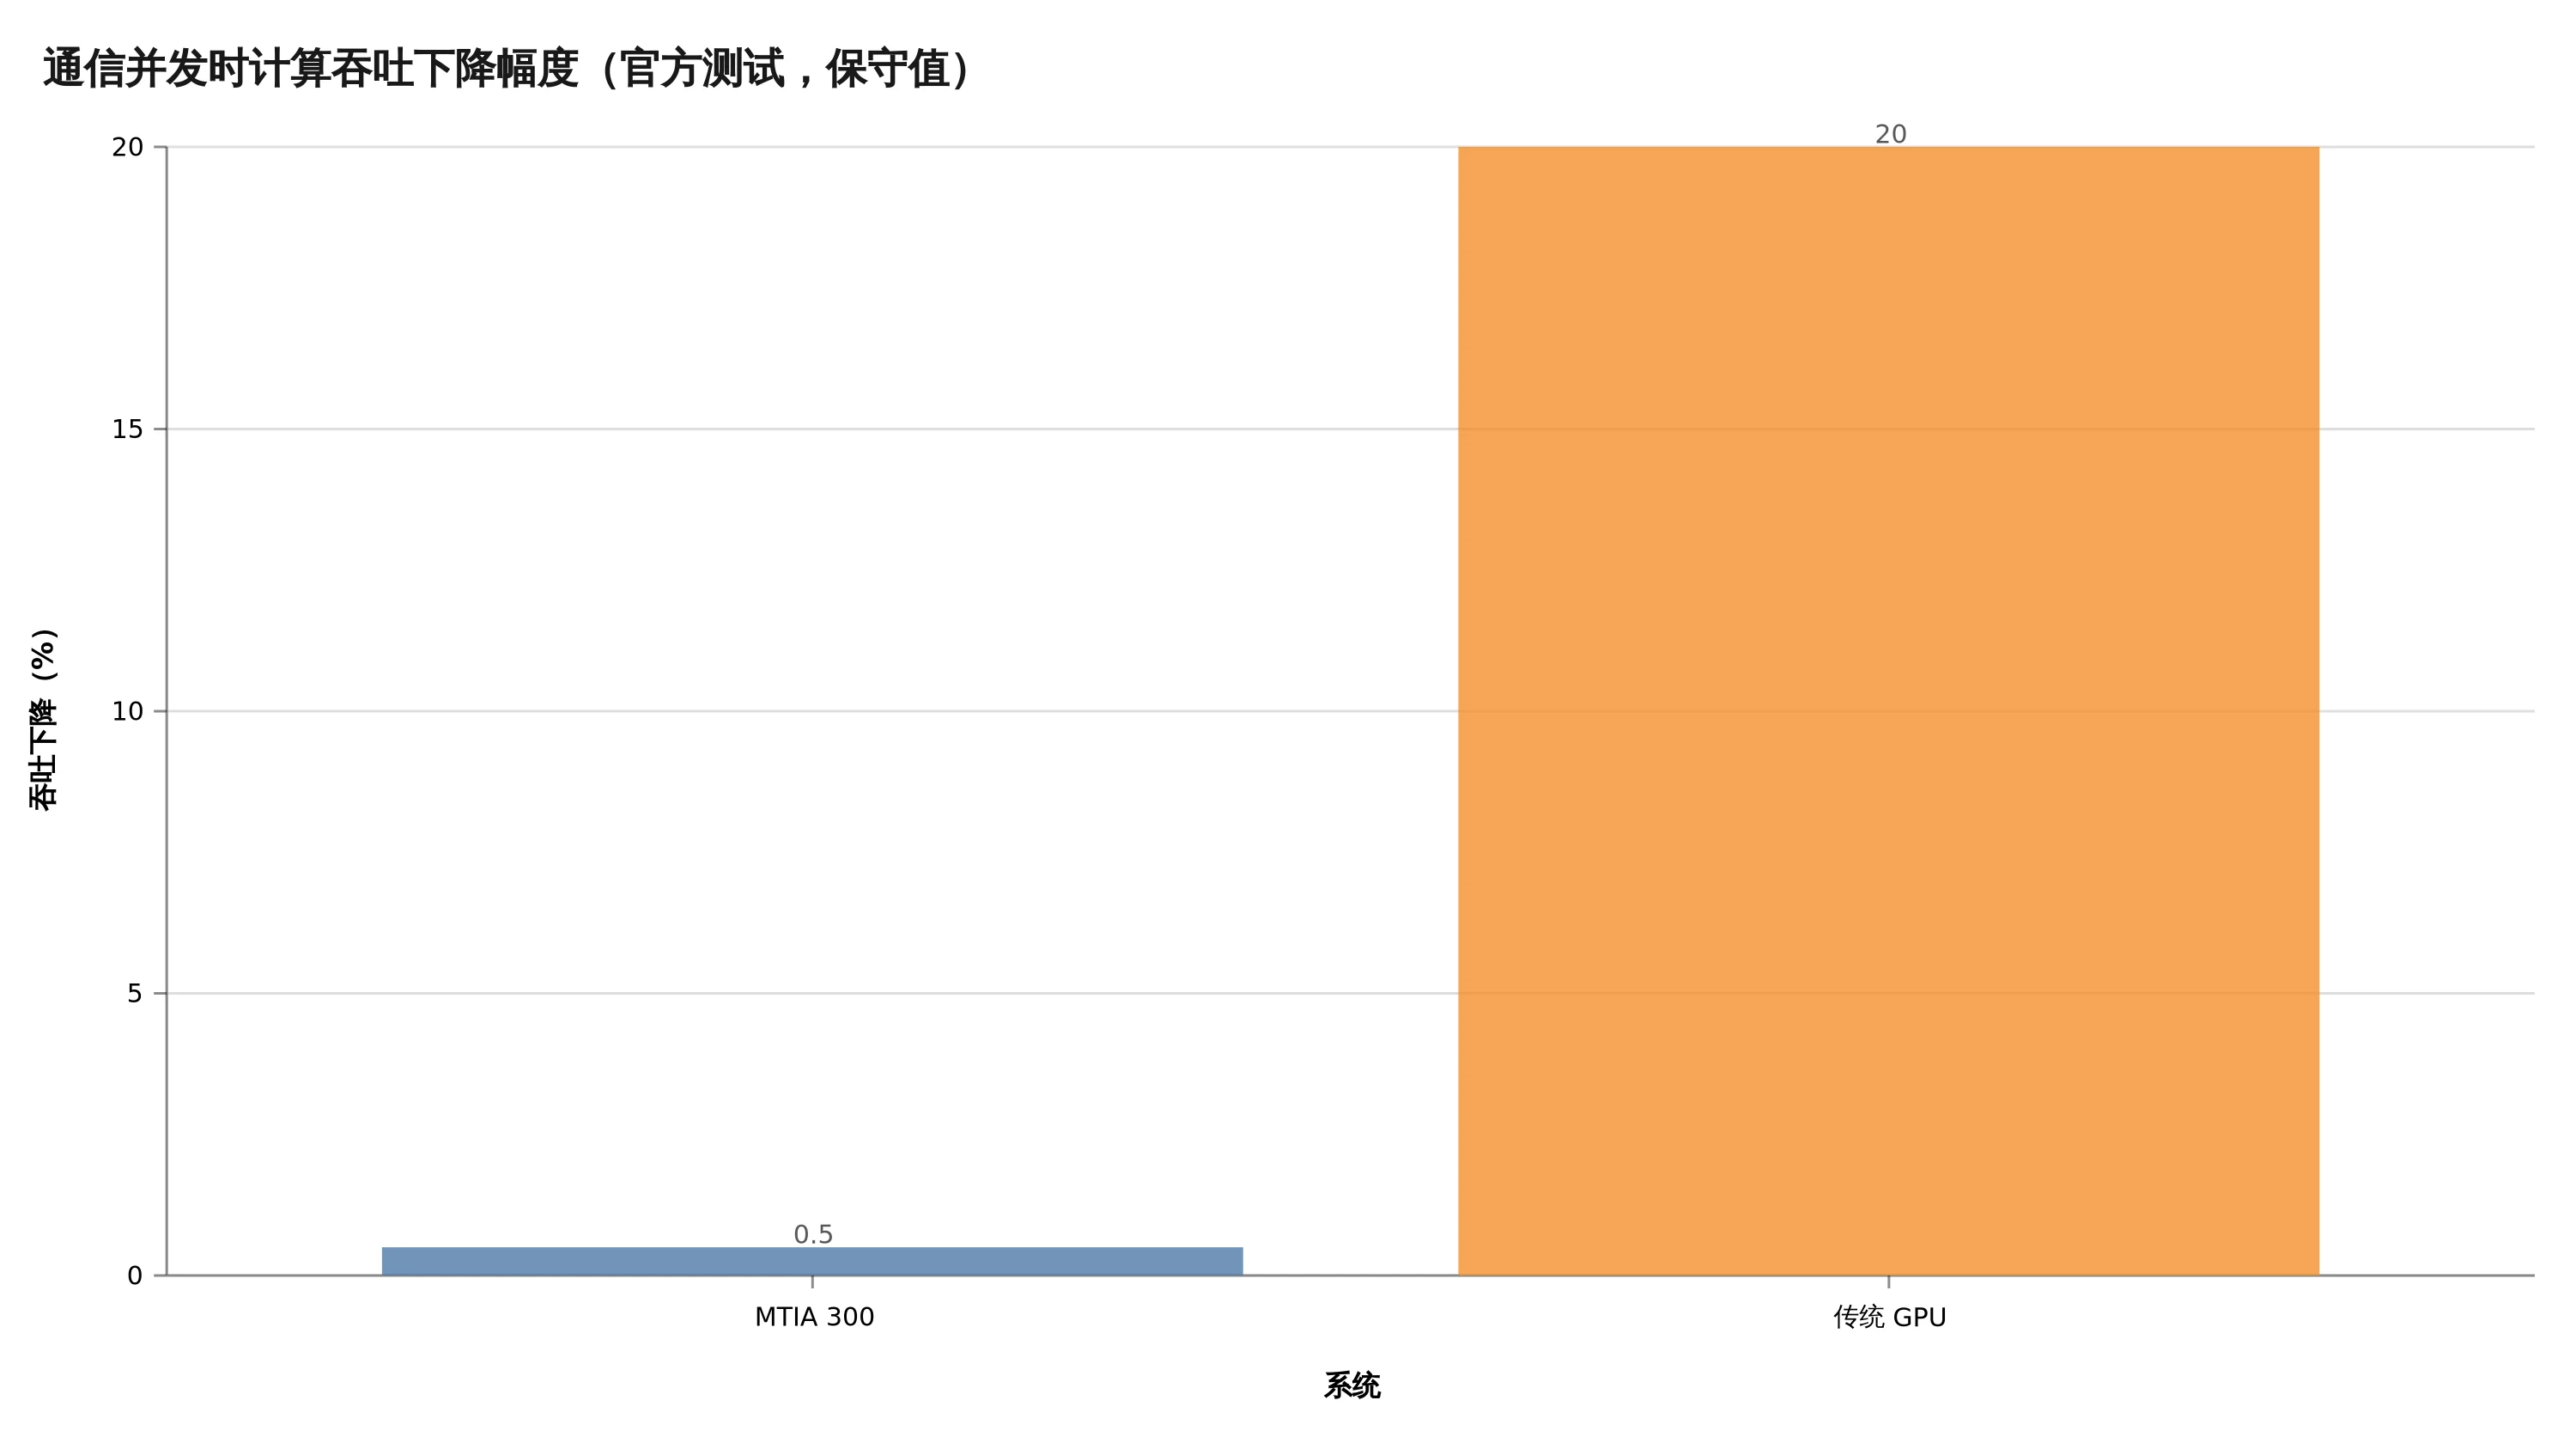
但它点出的病灶很准。利用率低不一定是计算单元不够强,也可能是计算单元被迫兼职做了太多搬运活。
12 个 NIC 只是门面,专用消息引擎才是内场
MTIA 300 的网络接口直接放进封装。两块网络芯粒各有六个 800 Gbps RDMA NIC,总 I/O 带宽达到 1.2 TB/s,数据不用再跨过 PCIe 找外部网卡。机架内通信最高 1 TB/s,跨机架通信是 200 GB/s,同一组 NIC 可以按负载调整两边的分配。
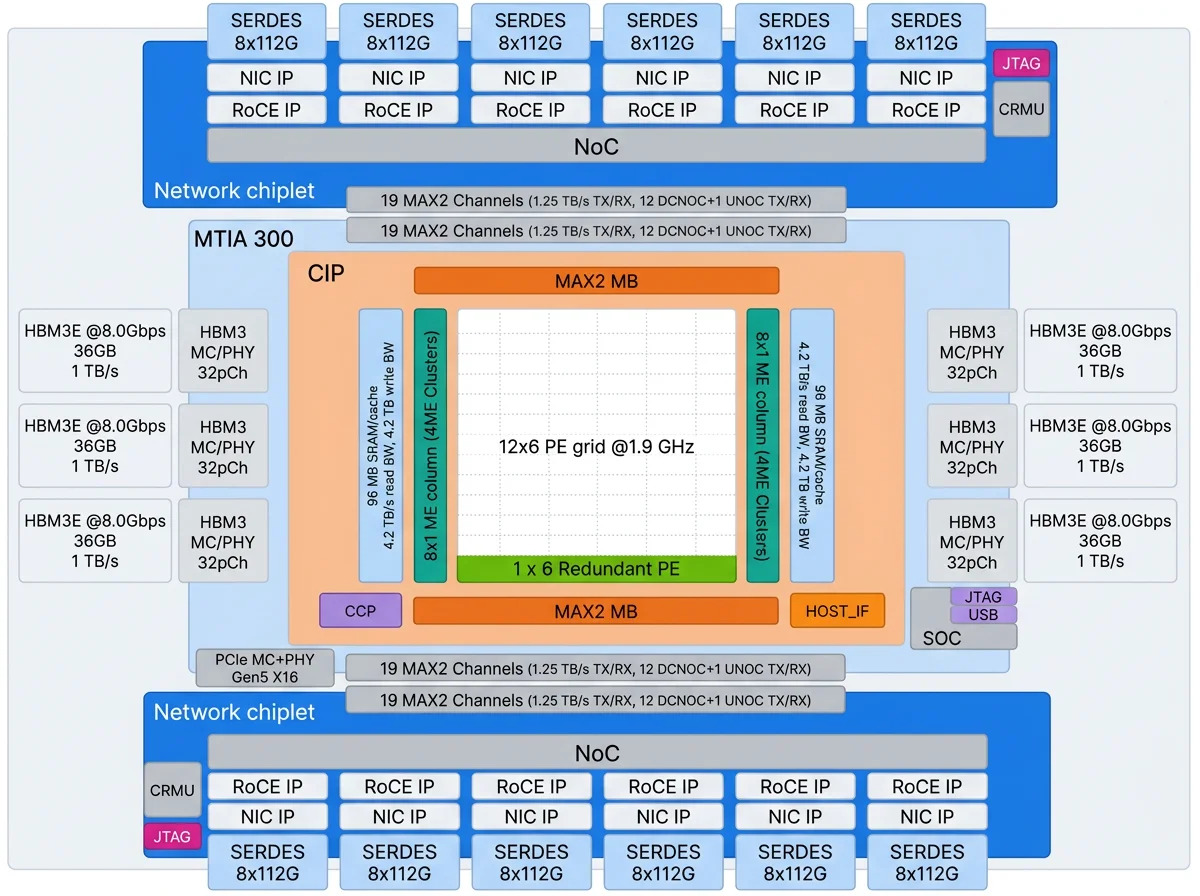
厉害了,但带宽数字只是最容易被做进发布会大字报的那部分。
更关键的是那 16 个消息引擎。每个引擎里都有负责调度的 RISC-V 核、连接 NIC 的接口,以及专门做归约的近内存计算模块。它们合计能提供超过 2.8 TB/s 的归约吞吐,让 AllReduce 和 ReduceScatter 不必再去占计算网格。
这才是 MTIA 300 的主线。它不只是把网卡挪近了,而是把通信从通用计算资源里剥离出来,交给一条独立执行路径。
芯片还做了一个叫 express doorbell 的设计。传统设备收到工作请求后,往往还要再读一次内存,确认有新任务。MTIA 300 让写入请求这个动作本身就充当通知,省掉一次读取,单次操作少约 800 纳秒。
800 纳秒单看几乎没感觉,可在小消息、高频调用的系统里,固定成本会一遍遍叠上去。长上下文推理和 Agent 工作流正在让消息变得更碎、更频繁,真正拖慢系统的未必是一段巨大的计算,也可能是成千上万次「确认一下再动手」。
这里跟 Agent 工程有一处很像。模型每调用一次工具,如果运行时都要重新解析权限、重新发现依赖、重新拼接上下文、重新确认重试策略,单步看只是几十毫秒,长任务里却会堆成一堵墙。
不是哥们,模型在前面飞,控制面在后面逐张盖章,这画面多少有点熟悉。
比硬件更值得看的是 HCCL
如果文章只写到芯片,MTIA 300 还只是一次垂直硬件优化。真正让我觉得有点子牛逼的,是 Meta 同时改了通信的执行方式。
HCCL 会把一次集合通信预先编译成带显式依赖的子图,再把整张图交给消息引擎自主执行。指令复制进 HBM 后,CPU 不必在每一步继续指挥。通信不是边跑边问主机下一步做什么,而是拿到一份可执行计划后自己跑完。
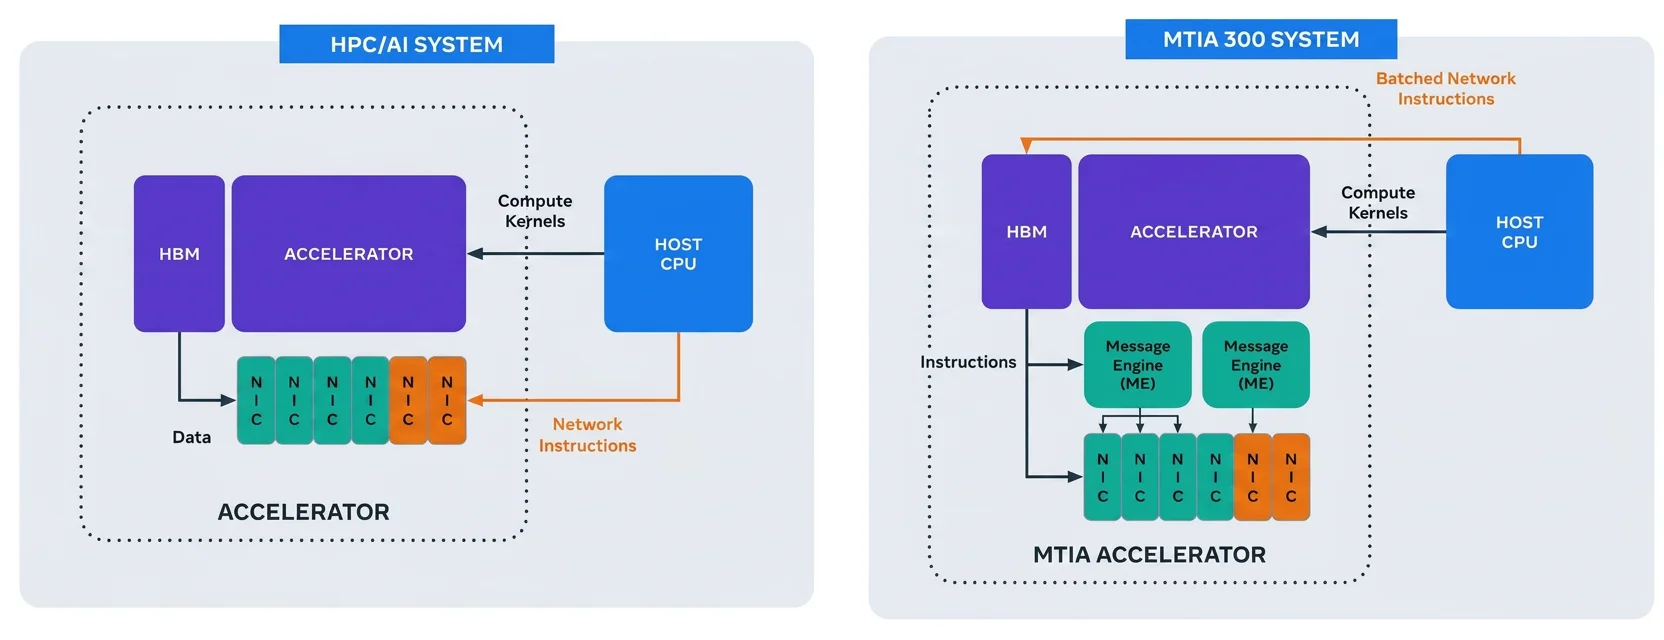
而且它没有另起一套只供自家芯片使用的封闭入口。HCCL 接入 PyTorch 的 c10d 和 torchcomms,经 torch.compile 追踪的集合通信还能和计算算子一起编译。上层训练代码继续使用熟悉的接口,底层执行路径已经换了。
这个取舍很漂亮。
很多团队做 Agent 性能优化,第一反应是换更快的模型、开更高并发、加缓存。过一阵子看 trace,才发现模型只占一半时间,剩下都耗在工具排队、权限检查、结果序列化、失败重试和上下文重复装配上。
MTIA 300 提醒人的地方在这儿。稳定而重复的控制动作,不该永远交给最贵、最通用的执行单元临场决定。能提前声明的依赖就提前声明,能确定下来的重试与超时就交给运行时,能复用的工具结果就别让模型重新读一遍。
假设一条常见的代码 Agent 流程,需要读仓库、跑测试、修改文件、再跑一次测试。粗糙的实现会让模型每一步都重新决定工具、参数和后继动作。更稳的做法,是先把依赖关系、权限边界和验收条件写成任务图,让模型处理真正需要判断的分支,运行时负责那些已经确定的机械动作。
这不是把 Agent 变成死流程。恰恰相反,把确定性工作从模型身上卸下来,才给不确定性推理留出了预算。
3.9 倍到底快了什么
官方给出的生产数据很亮眼。HCCL 在单机架达到最高 940 GB/s 通信带宽。在一个由 40 个加速器训练的 1500 亿参数推荐模型上,MTIA 300 的总通信时间比对应 GPU 集群快 3.9 倍。
注意措辞,快 3.9 倍的是总通信时间,不是端到端训练速度。
公告没有披露完整训练时长、样本规模、功耗、采购成本,也没有给出可供外部复现的同配置结果。MTIA 300 还有 216 GB HBM3E、1∶1 的 CPU 与加速器比例,并允许把部分优化器计算卸到 CPU。最终提升来自多少网络、多少内存、多少软件编译,目前拆不开。
再往前一步,MTIA 300 服务的是 Meta 自己的大规模推荐与排序负载。它不需要像通用 GPU 那样兼容五花八门的客户,也不用在每一种模型上都拿第一。能把硬件做得这么偏科,恰恰因为 Meta 手里有足够稳定、足够巨大的内部需求。
普通团队不可能为自己的 Agent 焊一块芯片,也没必要学这种家底。但可以把同一套审视方法搬回软件系统。
别只看 GPU 利用率,要拆出模型生成、数据读取、工具排队、网络传输、序列化、重试和人工等待各占多少。别只看单次 token 价格,要看一个任务通过验收到底花了多少。别只给最快的环节继续加速,要找到那条让所有昂贵资源一起空等的路径。
一份够用的运行记录,至少应该能回答这些问题。
accepted_task_cost:
  model_time_ms: 0
  tool_queue_ms: 0
  data_fetch_ms: 0
  retry_time_ms: 0
  human_wait_ms: 0
  validation_result: pass
数字不一定漂亮,但它会逼着团队看见等待发生在哪里。
真正该抄的是系统边界
Meta 同一天还公布了面向大规模以太网的 MetaRoCE。一边把网络协议的恢复与拥塞控制移回端点,一边把 NIC 和消息引擎塞进加速器封装。两篇放在一起看,脉络很清楚。
Meta 没把 AI 基础设施当成「买更多 GPU」的问题。它在重做芯片、通信库、网络协议和训练框架之间的边界。
这个方向未必适合所有人,官方数字也还需要独立复现。那篇 MTIA 300 芯片论文已经公开,HCCL 的完整论文则计划在 SC26 发表,后面还得看更多负载、功耗和端到端成本数据。
可它已经把一个常被忽略的问题摆到了桌面上。
当昂贵的计算单元停在那里等数据时,继续堆算力,像是在堵车的路上换一辆更快的车。
车没慢。
桥太窄了。