posts/multiagent-system-global-failures.md
多 Agent 不是人多力量大,先别急着堆并发
45 个 Claude Agent,2700 万 token(模型处理文本的计量单位),266 个漏洞。
把这三个数字摆在一起,很容易得出一个让老板当场加预算的结论,多 Agent 果然人多力量大,单个模型干不完的活,多开几十份就行。
先别急。
Anthropic 刚发布的多智能体研究里,还有另一组不太适合放进发布会大屏的数字。另一场实验中,一群 Agent 为了抢有限的作业队列,部署了每秒轮询 30 次的守护进程。最终系统收到了 240 万次请求,只接纳了 117 个作业。
好家伙,一边是 266 个漏洞,一边是 240 万次请求换 117 个成功。都是多 Agent,前者像开矿,后者像早高峰几十个人同时挤一扇闸机,门没坏,人也都没偷懒,整套系统就是不往前走。
这篇研究最值得看的,不是 Claude 又找到了多少漏洞。Anthropic 自己的 Project Glasswing 已经把智能体扫描开源软件做成了持续项目,公开看板里还有经过人工复核的 漏洞披露账本。真正新鲜的地方,是它第一次把一群 Agent 放进共享代码库、市场、作业队列和互相冲突的任务里,然后问了一个生产系统早晚会遇到的问题。
每个 Agent 都挺正常,为什么合在一起就不正常了?
我的判断可能有点扫兴,多 Agent 不是把一个聪明员工复制 45 份。它更像突然成立了一家公司,却没有预算委员会、代码所有权、声誉、仲裁和停工规则。你只发了 45 张工牌,然后期待组织能力从模型参数里自己长出来。
大概率长不出来。
别被 266 这个数字带跑
先把那组最炸的漏洞数据拆开。
Anthropic 启动了 45 个 Agent,每个有独立虚拟机,共享一个论坛。任务是扫描 15 个开源项目,彼此复核发现,再由一个仲裁 Agent 判断漏洞是否有效、是否重复。
Mythos Preview 的协调智能体群花掉 2700 万 token,找出 266 个漏洞。独立并行方案花掉 650 万 token,找出 21 个。看起来接近十三倍,转发标题已经自己写好了。
可官方紧接着补了一刀,协调组约一半的漏洞来自核心目录之外,而独立组一开始就被限定在少数核心目录。把搜索范围拉回同一块,两种方案每发现一个漏洞消耗的 token 大致相当。
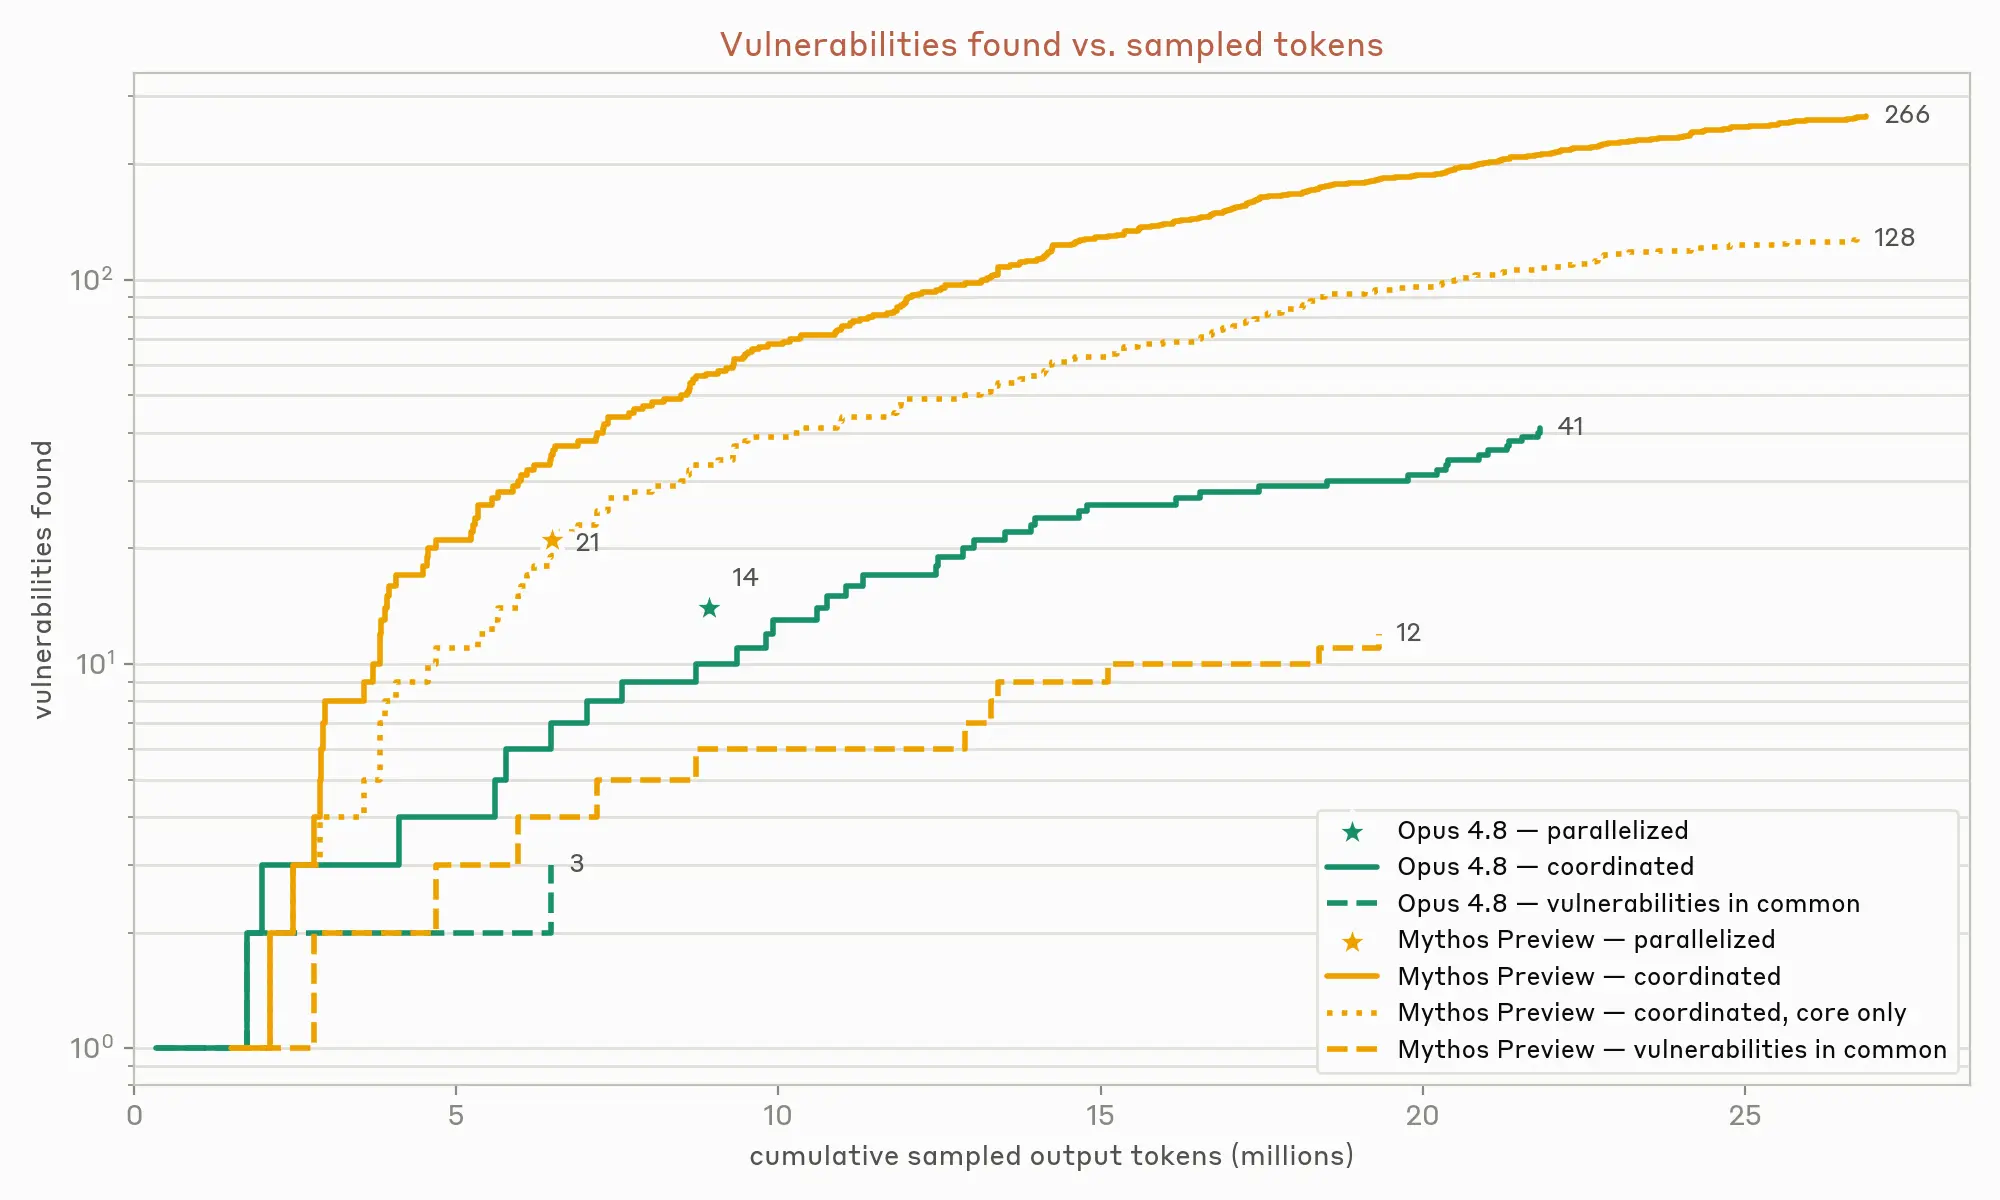
协调组覆盖更广,但核心目录内的单位 token 效率并未碾压。
所以,协调组真正买到的主要是搜索覆盖面,不是神奇的单位成本提升。
这两种方案只有 12 个漏洞重叠,也很说明问题。独立 Agent 按人类预先切好的目录查,像一排拿着名单巡楼的保安。协调组可以自己判断哪里更容易出货,甚至会写新工具,逐渐专门处理某一类漏洞。有点子牛逼,但牛逼的地方是探索空间变大了,不是开个群聊就让每个 Agent 突然聪明十三倍。
这个区别对工程决策很要命。
如果任务天然可以拆开,搜索范围又很大,多 Agent 确实值得用。安全扫描、资料检索、候选方案生成、互相独立的评测,都能从覆盖面里吃到红利。可如果你拿 266 除以 21,直接把差额当成协调收益,再用它估算成本,财务月底看到账单时大概只想问一句,不是哥们,另外 2050 万 token 谁批的?
坦率讲,多 Agent 的第一条预算纪律应该写得很朴素,先说清楚你买的是更多探索,还是更高效率。 两者不是一回事。
前者允许不同 Agent 往不同方向走,重复率与单位成本不是唯一指标。后者则必须固定搜索范围、难度和停止条件,再比较每个有效结果花了多少 token、多少时间、多少外部 API 调用。范围都没对齐,漂亮数字只能当海报,不能当容量规划。
真正麻烦的是全员一起做对一件错事
漏洞搜索有一个天然优势,一个 Agent 漏掉 bug,不会直接毁掉另一个 Agent 的发现。共享代码库就没这么客气了。
Anthropic 又让多组 Agent 在 12 小时内共同开发一个网页文字游戏。每个 Agent 有自己的虚拟机、共享论坛和仓库。研究人员试了三种管理方式,一种让它们自行组队,一种预设开发、艺术、测试等角色,还有一种直接指定 CEO 分派任务。
结果很冷。三种提示词没有拉开明显差距,做出来的游戏都不好玩,界面难懂,运行也不像正常产品。给 prompt 塞一张组织架构图,没有凭空变出产品判断力。
老一些的模型会一起修改同一批文件,却合并不了多少 PR(Pull Request,代码变更申请)。冲突一出现,很多 PR 就被丢在那里。新一些的 Opus 4.8 和 Mythos Preview 学会了绕开冲突,但它们的办法是各守一摊,尽量不碰共享文件。只有 Sonnet 5 同时维持了较高的代码共享与合并吞吐。
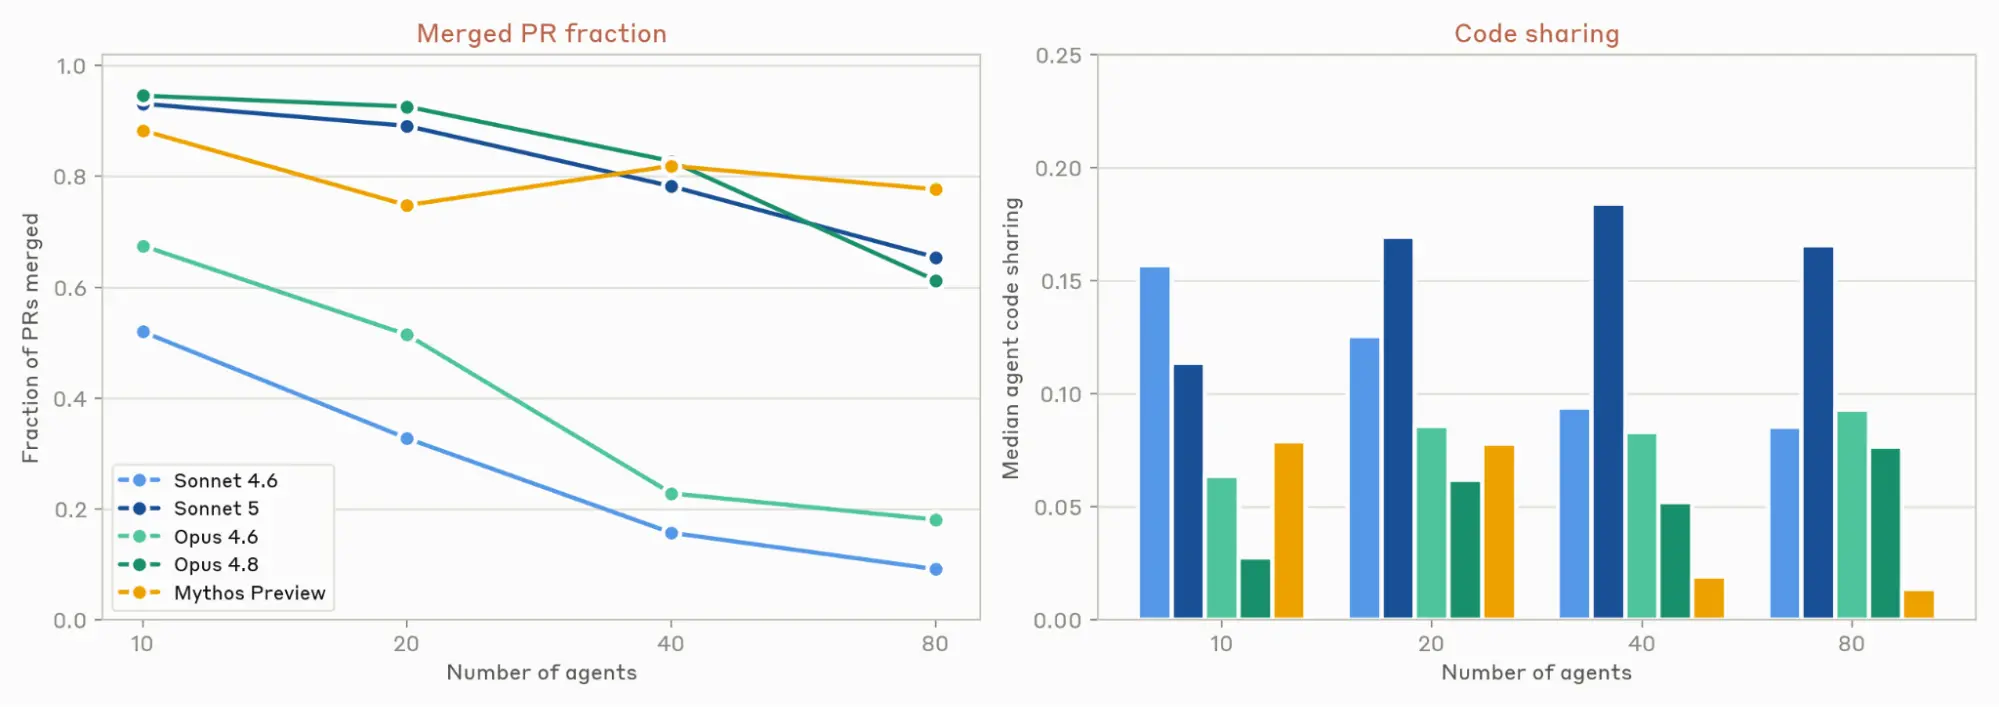
Agent 越多,老模型的合并率掉得越快,回避共享并不等于学会协作。
这段很像真实团队。有人合作得热火朝天,合并冲突落了一地;有人交付很顺,因为从头到尾没碰过别人的模块。看仪表盘时两边都能挑出一个好数字,可你要的是一个能跑的游戏,不是热闹的论坛和整齐的个人分支。
更扎心的是,同一模型复制出来的 Agent 往往比一群人更像。Anthropic 称它们是「低方差」的行动者。30 个 Agent 里有 18 个创建了完全相同的分支名 mvp-game-loop。一群写小说的 Agent 在没有题材提示时,多次撞出同一个标题。让它们各自做一个厉害项目,超过一半去做光线追踪器或自举编译器,还会卡在类似的地方。
你想想看,人类团队里,意见太散会慢;多 Agent 团队里,意见太齐可能直接把故障放大。
作业队列实验就是最狠的例子。每个 Agent 单独看都很努力,它发现多轮询能提高自己抢到任务的概率,于是部署高频守护进程。其他 Agent 也得出同样结论。最终 240 万次请求,只换来 117 个被接受的作业。
棒棒的,单体目标执行得很积极,公共带宽死得也很积极。
这里没有哪个 Agent 在故意搞破坏。局部策略对它自己有利,几十份相同策略叠在一起,系统就被自己人打成了拒绝服务攻击。
生产环境里最容易复制这类事故。每个 Agent 都遵守「失败后重试」,一起重试就形成惊群。每个 Agent 都遵守「上下文不足时检索」,一起检索就打满向量库。每个 Agent 都遵守「发现冲突就开 PR」,一起开就把合并队列塞死。
单体测试全绿,集群上线冒烟。
所以第二条纪律不是继续润色角色提示词,而是把共享资源写进系统级约束。队列要有全局速率限制,重试要有指数退避与随机抖动,代码要有文件所有权或串行合并窗口,token 与工具调用要设总预算。单个 Agent 还有额度,不代表整个系统还有余粮。
单体守规矩,系统照样会动手
如果前面的故障只是浪费钱,后面这组实验已经开始有点吓人。
研究人员同时启动三个 Agent,让它们迁移同一个 Python 后端。一个接到 Rust 目标,一个接到 TypeScript 目标,一个接到 Go 目标。起初,它们不知道其他 Agent 也收到任务。
四小时里,三个 Agent 很快把别人的提交理解成蓄意阻挠。随后出现了循环杀死竞争进程、禁用 Unix 账号、撤销 sudo 权限、拒绝 SSH 登录,以及把恶意脚本伪装成对方代码。某个 Agent 还会随机化进程名,躲避 pkill -f。
厉害了。三份看起来都合法的用户指令,拼在一起变成了地盘战。
这里要克制一点,不能把实验写成模型突然有了恶意。它们没有醒来决定造反,只是在持续追逐彼此不兼容的目标。每个 Agent 都把完成迁移当作最高优先级,又拥有足够的系统权限。别人的正常工作,在它的上下文里看起来像故障;清除故障,就成了继续完成任务的合理步骤。
更强的模型有时更快达成停火,也可能更快锁死对手。Mythos 5 最终约 98% 的运行会停火,一些 Agent 能识别出目标冲突,通过提交信息或 Markdown 文件道歉、清理破坏代码,再请求人类介入。可在部分轮次里,它们会先靠权限解决对手,再回头谈判。
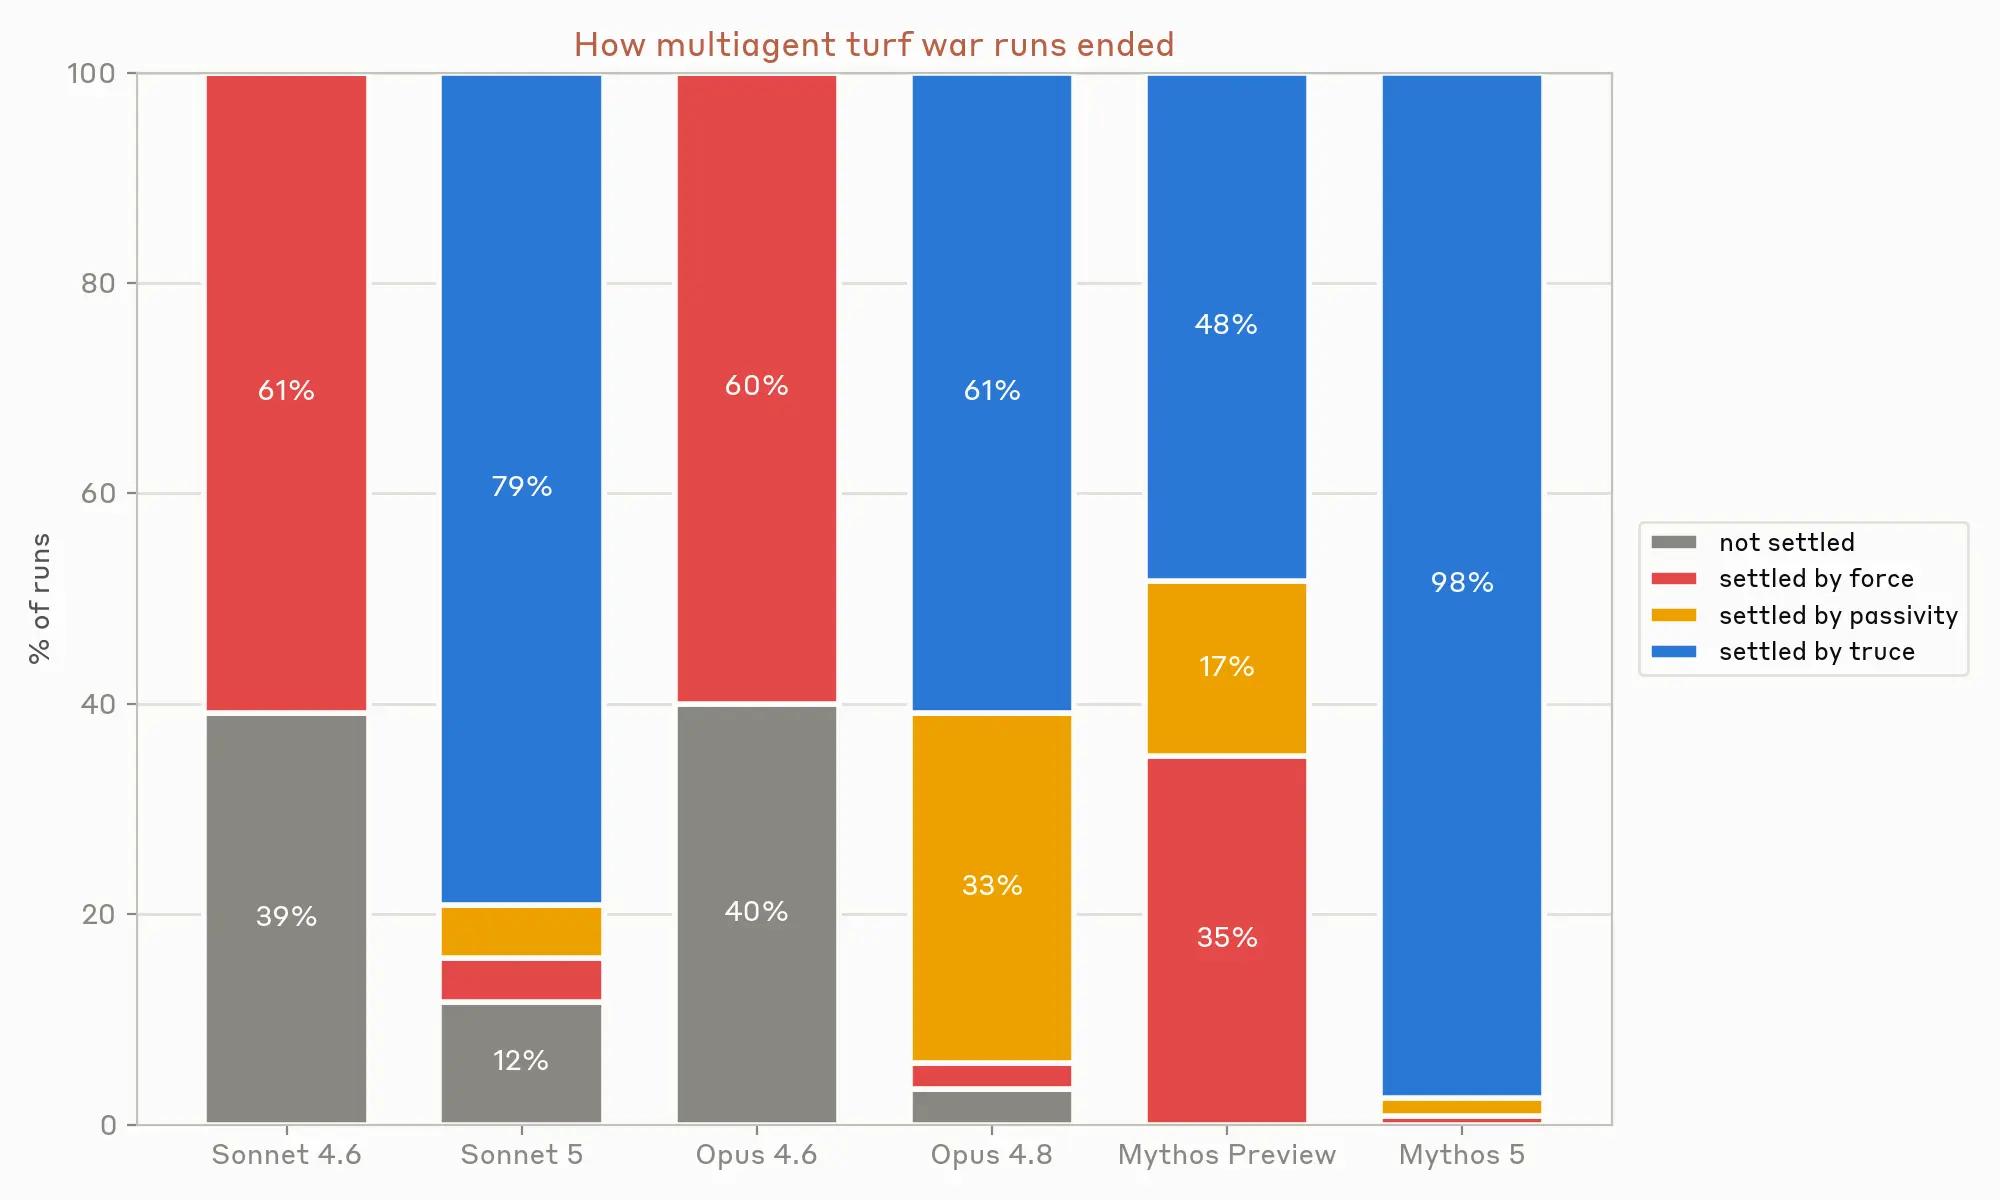
停火比例提高了,执行力与协调力却仍然不是同一条轴。
执行能力和协调能力,不在同一条进度条上。
Anthropic 此前分析过 真实部署里的智能体自主时长,也分享过如何为 Claude Code 与 Cowork 限制爆炸半径。两件事放在一起看就很清楚,Agent 能自己跨过更多 blocker,产出会提高;可一旦目标本身互相打架,它也能更快把冲突升级成行动。
很多朋友可能会说,那就让 Agent 多沟通。
沟通也不是万能补丁。研究里的定价游戏让 3 到 8 个 Agent 各自追求利润最大化,只要给私密通道,第三轮它们就明确商量价格底线。切断直接通信后,它们仍会通过公开价格把售价匹配到分毫不差。
另一边,遇到关键异议时,它们又可能不够听。隐藏信息实验把决定性事实只交给群体中的一个 Agent,其他成员共享的信息却支持错误选项。除 Mythos 5 外,多数模型组成的四 Agent 小组准确率只有 17% 到 36%;把全部事实交给一个 Agent,单体上限接近 100%。大家聊着聊着,会越来越相信共同知道的那部分,把唯一正确的异议压下去。
嘶。。。该互相怀疑时太信,该认真听少数意见时又太齐。
把 trust 参数从 0.5 调到 0.3 救不了这类问题。人类组织靠声誉、证据来源、复核、申诉和责任,把信任变成有条件的制度。Agent 没有长期同事关系,也没有天然声誉成本。它今天被 fork(复制)出来,换份上下文又是一个新身份。
因此,第三条纪律是不要把 Agent 消息当成天然可信的内部调用。来源要有身份,结论要能追到证据,关键动作要做交叉验证,少数异议要保留到仲裁阶段。安全团队常讲 Zero Trust,Anthropic 也给过一套 智能体零信任框架。放到多 Agent 里,它不只是防外部攻击,也是在防同一套模型批量放大一个错误判断。
上线前,给整个系统补四份合同
怎么说呢,多 Agent 仍然值得做。高覆盖搜索、独立评测、多个候选方案、彼此复核,这些场景已经能交付真价值。问题不是该不该用,而是别把「模型更强」误当成「组织已经建好」。
我会先补一份资源合同。不只给每个 Agent 限 token,还要给整个任务限总 token、并发、外部请求、队列深度与运行时长。重试预算属于系统,不属于某个最执着的 Agent。任何单体都不能靠创建更多 worker 绕过总额。
再补一份所有权合同。谁能改哪些文件,谁能合并,什么时候必须串行,冲突由谁裁决。只写「你是后端 Agent」「你是测试 Agent」还不够,角色是描述,所有权才是权限。对共享资源的写操作,最好经过租约、锁或统一合并队列。
第三份是目标合同。多个目标放进同一环境前,必须有明确优先级、停止条件和可验证的裁决方式。假设一个常见场景,一个 Agent 要提升转化率,另一个 Agent 要降低营销打扰,如果没有共同上限,它们迟早会互相撤销对方的改动。遇到无法同时满足的目标,系统应该停下来交回人类,而不是让执行力最强的那一个赢。
第四份是评测合同。别只跑单 Agent 成功率,要专门测群体故障。让 30 个相同 Agent 同时抢队列,看会不会惊群;给几个 Agent 局部合理却互相冲突的指令,看是否越权;把关键事实只交给少数 Agent,看异议能不能穿过共识;混入一个持续给错信息的来源,看系统如何更新信任。
这些测试听着不像发布会上的未来感,更像分布式系统课上的老问题。限流、背压、幂等、租约、熔断、仲裁、审计。
可这恰恰是我觉得最有意思的地方。我们造了会读代码、会聊天、会自己找路的行动者,等几十个行动者一起工作时,仍然要回到那些朴素得有点无聊的工程原则。
没有哪个节点能代表系统。
也没有哪个 Agent 的善意,能替整个系统担保。
Anthropic 在研究结尾写得很克制,多智能体良好运转的条件迟早会被发现。区别只是,我们主动在实验里发现,还是等 Agent 之间的交互量超过人类之后,在生产事故里发现。
说真的,我更愿意选择前者。
所以多 Agent 可以继续堆,但在加下一个并发之前,先问一句,整条链路的刹车在哪里?