posts/muse-spark-13-agent-economics.md
Muse Spark 1.3 少 25% Token,先别急着算省钱
Muse Spark 1.3 的输出速度能跑到每秒 181.7 个 Token,第一枚 Token 却平均要等 27.51 秒。
像一辆出站后飞快的列车,站台上先不开门。
这组数据来自 Artificial Analysis 的实时模型页。同一页上,价格也挺凶,每百万输入 Token 1.25 美元,每百万输出 Token 4.25 美元,缓存输入只要 0.15 美元。综合指数 61 分,已经和 GPT-5.6 Sol 的 max 档站到了一排。
更会勾住程序员眼睛的数字在 Meta 的发布公告里。和 Muse Spark 1.2 相比,Meta 工程师的编码任务对照中,新模型大约少用了 20% 的工具调用、少用了 25% 的 Token。
好家伙,又快,又便宜,还少调工具。
照这个节奏,团队是不是该连夜把 Agent 的默认模型切过去?
我自己的判断是,先别急。Muse Spark 1.3 很可能是眼下最值得加入候选池的 Agent 模型之一,但「少 25% Token」还不能直接翻译成「你的任务便宜 25%」。厂商内部编码对照、独立综合评测、你自己的仓库任务,测的不是同一件事。把三个口径揉成一句省钱,账单月底会来帮你做阅读理解。
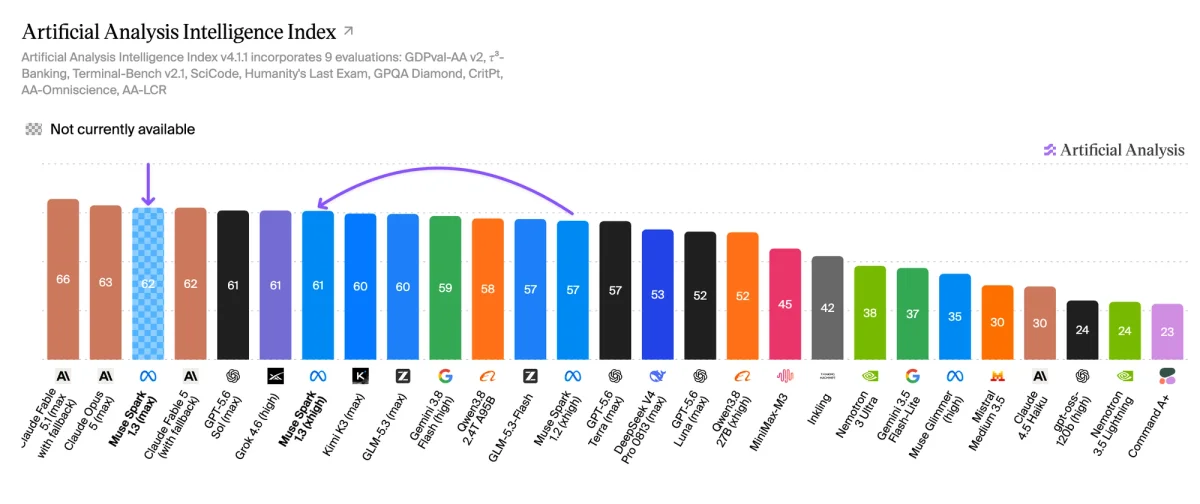
图,Muse Spark 1.3 xhigh 得 61 分,max 得 62 分,来源 Artificial Analysis
少掉的 Token,可能从另一扇门回来
先看这次更新到底改了什么。
Meta 没把重点放在多答几道数学题,而是放在长周期智能体工作。官方描述里,Muse Spark 1.3 会在一条很长、内容很乱的线程里同时维护多个任务,遇到模糊指令会追问,卡住会求助,执行不可逆动作前会确认。用户中途打断或把话题拉回旧任务时,它也要把新提示送回正确的工作流。
这类能力听着没有「参数翻倍」那么热闹,放进生产环境却很要命。一个 Agent 真正烧钱的地方,经常不是末尾那段答案,而是它在交付前走了多少弯路。
它可能先读错目录,调一次搜索;发现缺文件,再调一次搜索;打开了错误版本,继续补上下文;执行失败,换参数重跑;末了写了一大段「任务已完成」,验证脚本一跑,空指针。
每一步都在吃 Token、工具调用、沙箱时间和人的耐心。
所以 Meta 报出的两个数字很有价值。少 20% 工具调用,代表模型可能更少乱伸手;少 25% Token,代表它在官方那组编码比较里更少绕圈。对长任务来说,这比一句「回答更聪明」具体多了。
但 Artificial Analysis 对 Muse Spark 1.3 的拆解又给了另一面。xhigh 版本每个 Intelligence Index 任务的成本是 0.55 美元,上一代 Muse Spark 1.2 是 0.40 美元,新版本反而高了 37.5%。评测方把原因指向智能体任务里的输入量,新版本平均多用了约 57% 的输入 Token,输出 Token 只多约 8%。
一边少 25%,一边多 57%,到底谁算错了?
都不一定错。
Meta 的数字来自自家工程师做的编码任务对照,Artificial Analysis 算的是另一套智能体综合评测。任务长度、工具返回内容、缓存命中、推理档位和成功判定都不同。前者说明模型在某类编码工作里更利落,后者说明它在另一组开放式任务上吃进了更多上下文。
厉害了,模型评测最容易被忽略的坑就在这儿。百分比从来不会自己说明适用范围,人得替它把分母找回来。
真要评估省不省钱,别只抄输入价和输出价。至少把一次完整交付里的输入 Token、缓存读取、输出 Token、工具调用次数、失败重试和人工接管一起记下来。任务没通过验收,再便宜的首次调用也是沉没成本。
可以把账记成一个很朴素的式子。
完整任务成本
= 模型输入 + 缓存读取 + 模型输出
+ 工具与沙箱 + 失败重试 + 人工接管
这里没有高深数学,难的是团队平时只记前三项,后面三项全靠同事的记忆和加班晚饭来承担。
工具调用次数也不能单独当效率。
一次 git grep 和一次启动浏览器、登录系统、翻五页后台,成本不是一个量级。模型少调了一个工具,可能真省掉一轮无效搜索,也可能只是把更大的结果一次吞回上下文。只报调用次数,不看每次返回了多少内容、执行多久、有没有产生副作用,还是会被一个漂亮的百分比带跑。
Token 也有冷暖之分。缓存命中的旧上下文,每百万只要 0.15 美元;新输入是 1.25 美元,相差八倍多。两次任务都吃了十万 Token,一次大部分命中缓存,一次每轮都重新塞仓库索引,价格会完全不同。Agent 平台如果没有把缓存命中率单独记出来,「总 Token 下降」仍然回答不了「总成本下降多少」。
还有成功率。
假设一个便于算账的常见评测,模型 A 每次花 0.40 美元,但十次只能完整通过六次;模型 B 每次花 0.55 美元,十次能通过九次。只看调用价,A 更便宜。把失败任务的重试算进去,A 每个成功交付大约要 0.67 美元,B 约 0.61 美元。这里的数字只是演示算法,不是 Muse Spark 的实测结论,但它能解释为什么团队应该盯「每个通过验收的任务成本」。
反过来也成立。高分模型如果只把成功率从 95% 提到 96%,价格却翻倍,对大量低风险任务就未必划算。生产选型不是给模型排座次,而是在成功率、价格和等待时间之间找一条符合业务的线。
Artificial Analysis 给出的 0.55 美元很能打。同等 61 分附近,GPT-5.6 Sol max 每任务约 0.95 美元,Grok 4.6 high 约 0.94 美元,贵了七成以上。可 Muse Spark 1.3 自己又比上一代的 0.40 美元贵。横向看,它便宜;纵向看,它变贵。两个判断同时成立,取决于你正在回答「和谁比」。
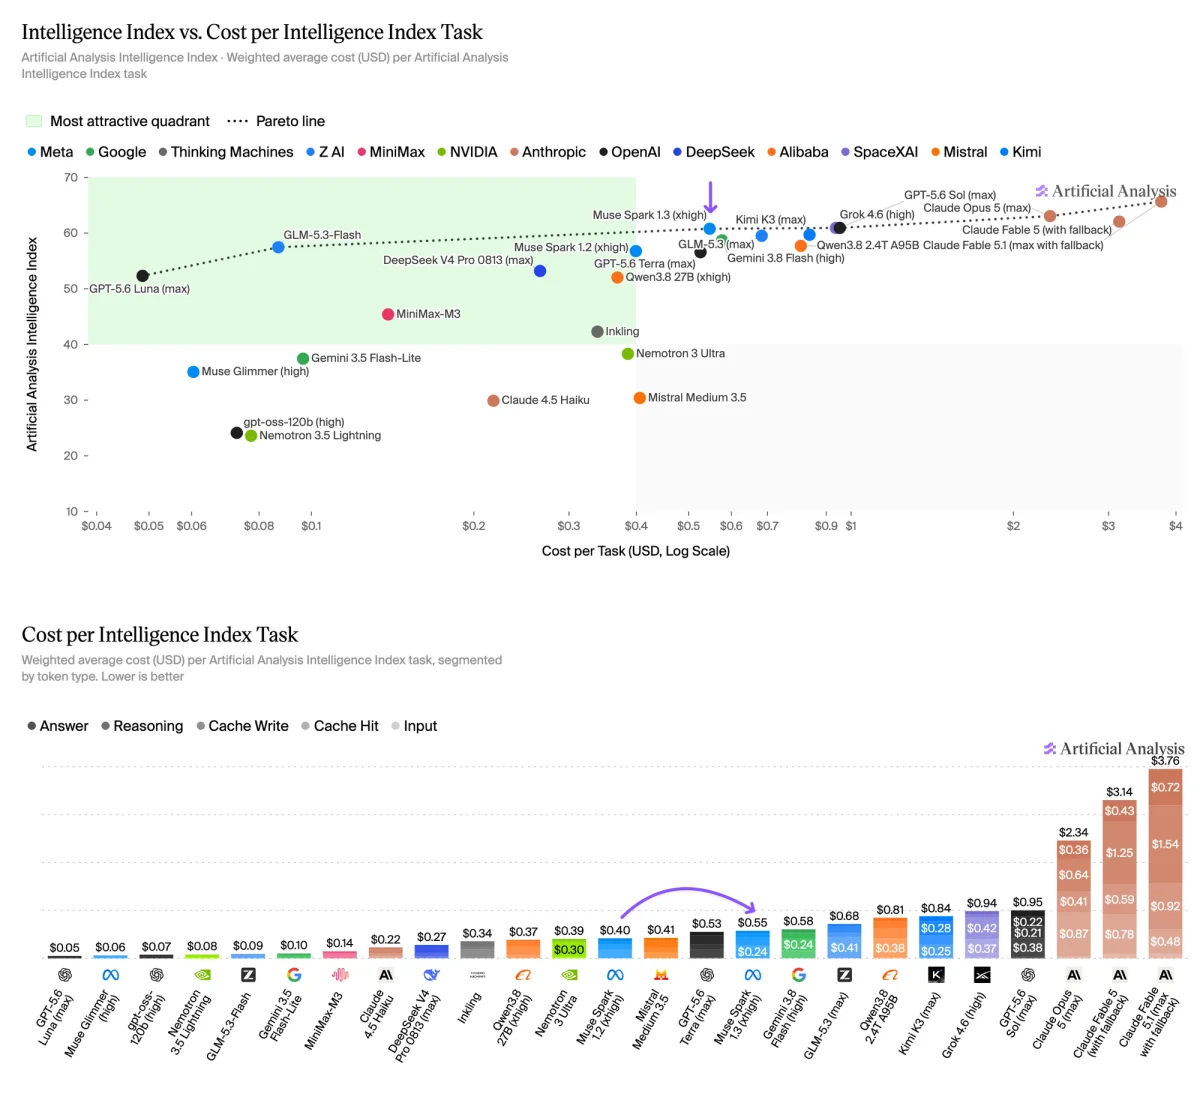
图,横轴是每个综合指数任务的成本,越靠左越省,来源 Artificial Analysis
每秒 182 个 Token,不等于任务很快
再说开头那辆列车。
Artificial Analysis 本次抓取页面显示,Muse Spark 1.3 xhigh 的输出速度约为每秒 181.7 个 Token,同价位模型的中位数是 68.1。这个速度很猛,长答案一旦开始生成,体感会很顺。
同一份测量里,它的首 Token 延迟是 27.51 秒,同价位中位数只有 3.04 秒。页面数据会随评测更新,具体小数不是永恒刻度,差距的方向却足够醒目。
如果任务是后台跑二十分钟的代码迁移,开头多等二十几秒可能没什么。模型少走两次错误工具调用,整单还可能更早交付。
如果任务是 IDE 里每次保存都触发的短检查,或者客服坐席等一句建议再回复用户,二十几秒会很刺眼。更别提一个 Agent 循环里可能连续发起多次模型请求,每一轮都先站一会儿,墙上时钟比 Token 计数器诚实得多。
所以吞吐和等待要分开看。tok/s,也就是每秒输出多少 Token,回答的是「开始说以后有多快」。TTFT,也就是首 Token 延迟,回答的是「多久才开始说」。端到端时长还要再加工具执行、网络往返、排队和重试。
三者混在一起夸一句「速度快」,差不多等于拿下载峰值带宽解释视频会议为什么卡。数字没假,问题答偏了。
更有意思的是 max 档。
Artificial Analysis 的评测文章里,xhigh 综合指数是 61,max 是 62。为了多拿这一分,max 在 GDPval-AA v2 上多用了 62% 的推理量,在 Tau3-Bench Banking 上多用了 28%。它在银行任务上从 47% 提到 52%,也把 GDPval-AA v2 从 1709 Elo 拉到 1754。
这不是说 max 不值。遇到一次失败就可能造成大额损失的复杂任务,多花推理预算换成功率,很合理。问题是很多团队会把「最强档」直接设成「默认档」,然后让它去改文案、查字段、补单测、整理日志。
一分更高的综合指数,不该自动拿走所有请求。
何况 Meta 现在还没有全面开放 max reasoning。官方说要等附加安全测试结束,当前可用的是既有推理档位。Axios 对这次发布的报道也提到,max 会在额外测试后推出。一个尚未普遍可用、价格也没有完整公开的档位,适合关注,不适合替生产默认值签字。
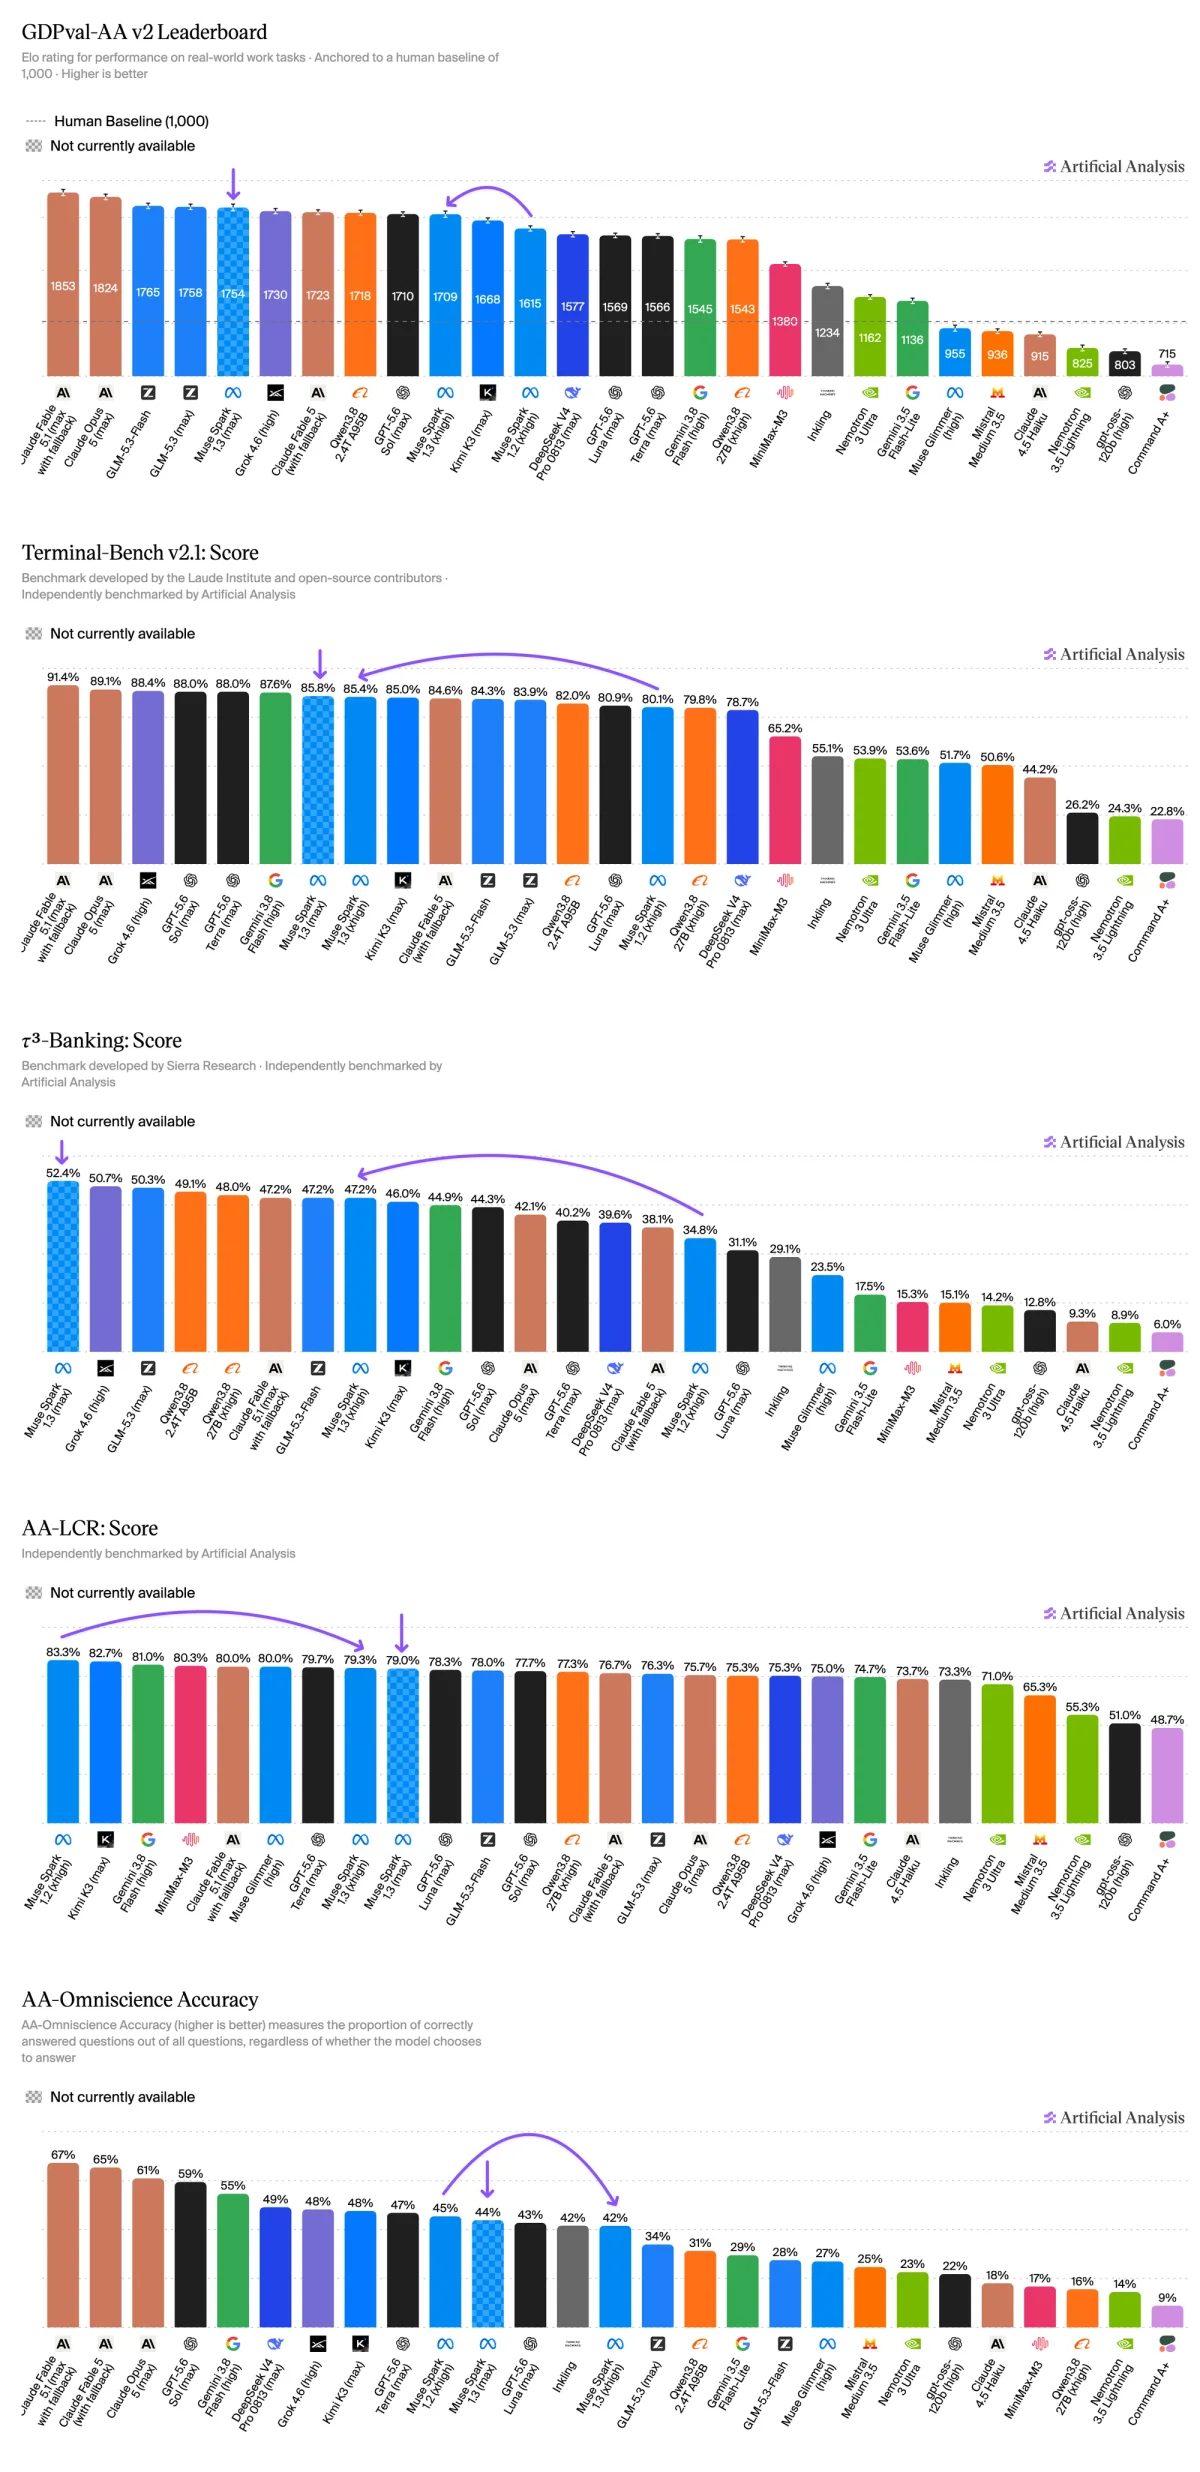
图,提升集中在 GDPval、Terminal-Bench 与银行任务,部分长上下文和全知准确率指标回落,来源 Artificial Analysis
真正该抄的,是它对卡住和不可逆动作的态度
跑分之外,我反而更在意 Meta 写进公告的几个行为变化。
提示含糊时追问,遇到障碍时向用户求助,执行后果较大的动作前确认,知道自己做不到时别编一个完成结果。
这些句子不性感,却正中 Agent 工程的老毛病。模型失败并不可怕,可怕的是它失败以后还保持一种成功语气。文件没写进去,接口没返回,浏览器没点到,末了给你一份措辞圆润的竣工报告。棒棒的,只有验收脚本知道现场还是毛坯。
Meta 还说模型增强了对提示注入和对抗性输入的抵抗能力,并更能识别不可逆动作。相关细节要回到 官方评测方法报告里核对,厂商表述不能替代自己的红队测试。不过方向是对的。会调工具的模型,能力提升和权限收紧必须一起发生。
一个能在后台安静工作、跨文件收集上下文、自己修正计划的 Agent,听起来很省心。它如果读到了网页里的恶意指令,或者把旧任务的权限带进新任务,安静就会变成一种很糟糕的可观测性。
所以接入 Muse Spark 1.3 时,我会把它当成一个新执行者,而不是把旧模型名字替换掉就收工。
先拿二十到五十个真实任务做一轮可复跑的小评测。不要挑专门让新模型赢的漂亮题,直接抽团队最近遇到的代码修复、仓库问答、日志定位和文档更新。每个任务固定输入、固定工具版本、固定超时,并把最终验收写成机器能执行的命令。
接着记录完整轨迹。模型吃了多少输入,缓存命中多少,输出多少,调了几次工具,哪一步重试,多久给出第一段有用结果,多久通过最终验收。真正要看的是成功任务的中位成本和尾部时长。
这里最好别只跑一遍。模型有采样波动,工具和网络也会抖。同一任务至少重复三次,报告中位数,再把最慢的那一截单独列出来。平均值很会藏事故,一个任务三秒,另一个三分钟,算下来平均九十一秒,看上去谁都没受委屈,线上用户已经关页面了。
评测集也别只放能跑通的快乐路径。代码任务里要混进依赖缺失、测试失败、权限不足和需求含糊;浏览器任务里要混进登录过期、按钮改名、页面延迟和外部文本夹带指令;文档任务里要检查内容完整、格式没丢、链接能点,而不是文件存在就算成功。
尤其要加一类「正确放弃」任务。没有权限时停止,证据不足时承认不确定,动作不可逆时请求确认。Agent 的好坏不能只看做成多少,还要看它在不该做的时候能不能忍住。Meta 这次强调求助、确认和边界感,正好可以落到这些测试上,不必停在宣传页的形容词里。
然后再做路由。短任务先用低推理档,长任务或高风险任务升级 xhigh,真正卡住再考虑 max。别让最贵的脑子去给所有逗号搬家,也别让最便宜的档位拿着生产写权限硬扛复杂迁移。
还要把「卡住」定义清楚。连续两次工具报错、同一路径重复读取、验收失败两次、预算达到上限,都应该触发停止或人工接管。模型会不会主动求助是一层,系统是否强制刹车是另一层。把安全全寄托在模型的自觉上,多少有点把门锁交给访客保管的浪漫。
上线也别一脚油门踩到底。先让新模型只读,记录它想执行的动作,不真的写;再给一小部分低风险任务开放受限写入;等失败类型、成本分布和接管流程都看清楚,再扩大流量。每一步都保留旧模型回退路径,版本号和推理档位要写进日志,不然第二天模型更新,昨天的结论连复现对象都找不到。
至于 100 万 Token 窗口,拿来处理跨文件任务确实舒服,但大窗口不是免费的垃圾桶。先检索,再筛选,再把真正相关的片段送进模型,通常比整仓库一把塞更稳。上下文里每多一份网页、工单或邮件,既多一份信息,也多一个过期事实和恶意指令混进来的入口。
做完这一轮,你手里应该有四个答案。它在你的任务上通过多少,完成一次花多少,从发出请求到交付要多久,失败时会不会停。四个答案都比「综合指数第几」更接近生产。
如果 Muse Spark 1.3 在前三项赢了,第四项也守得住,那就逐步加流量。要是它只在公开榜单赢,放进仓库却频繁重读文件、等待很长或需要人工收尾,也不用替新模型找台阶。评测不是为了证明某个发布多厉害,是为了让团队知道哪类活该交给谁。
这套方法同样适用于 Gemini、Claude、GPT 和下一周又冒出来的新名字。模型更新越来越快,固定押一个冠军会越来越累;把任务、指标、预算和回退做成稳定的评测框架,换模型反而只是换一行配置。
如果只是想试,官方已经把 Muse Code 安装命令放出来了。
curl -fsSL https://dev.meta.ai/install.sh | bash先在隔离仓库和低权限环境里跑,打开工具日志,设 Token 与时间预算,再拿同一批任务对照现有模型。Muse Spark 1.3 支持 100 万 Token 上下文,文本、图像和视频输入也都能吃,但窗口大不代表应该把整个仓库和半年聊天记录一次塞满。上下文越杂,输入成本、检索噪声和提示注入面都会一起长大。
这次发布的社会证明很强。Meta 五个月里已经迭代了四版 Muse Spark,独立综合指数逼近第一梯队,单任务价格在 59 分以上模型里处于最低一档。Google 同一天也发布了 Gemini 3.8 Flash,Anthropic 前一天刚更新 Claude Fable 5.1 与 Mythos 5.1。模型榜刚截完图,下一行可能又换人了。
但生产系统不追领奖台,它追的是稳定交付。
Muse Spark 1.3 真正有点子牛逼的地方,可能不是 61 分,也不是每秒 181.7 个 Token,而是它开始把少绕路、会求助、守约束、认得不可逆动作这些工程行为摆到台前。
至于能不能省下 25%,别让发布会替你的仓库回答。
把整张账单跑一遍。