posts/nemotron-voicechat-80gb-gate.md
VoiceChat 开源了,但多数开发者还用不上
448 毫秒,80GB,33%。
把这三个数字放在一起,比单独看任何一个都有意思。
NVIDIA NemotronLabs VoiceChat 11B 能在大约 448 毫秒内接过话头,能一边听一边说,还能在语音对话中调用工具。模型权重、NeMo Speech 代码分支和实时推理容器都公开了。
好家伙,语音 Agent 里最馋人的几件事,它看起来一次配齐了。
但 80GB 是官方代码写明的最低显存门槛。33% 是它在 Full-Duplex-Bench v3 上的工具调用 pass@1,也就是一次就把工具选择、参数和执行链路做对的比例。官方模型卡还留了一句很克制的话,这个检查点目前只适合研究用途。
所以这篇不追着 448 毫秒鼓掌。
我更想聊聊另一个问题。一个开放权重的语音 Agent,离普通开发者真正能用,中间还隔着多少层工程。
端到端语音很诱人,部署、控制和失败恢复才是接入时真正会撞上的墙。
448 毫秒解决的是接话,不是交付
很多语音助手采用级联架构。用户说话以后,ASR 先把声音转成文字,LLM 再生成答案,TTS 接着把文字念出来。ASR 是语音识别,TTS 是语音合成,中间的 LLM 负责理解和推理。
这套方案像三个人接力。每个人都能单独替换,日志也比较容易看懂,代价是每次交棒都要花时间,还可能丢信息。
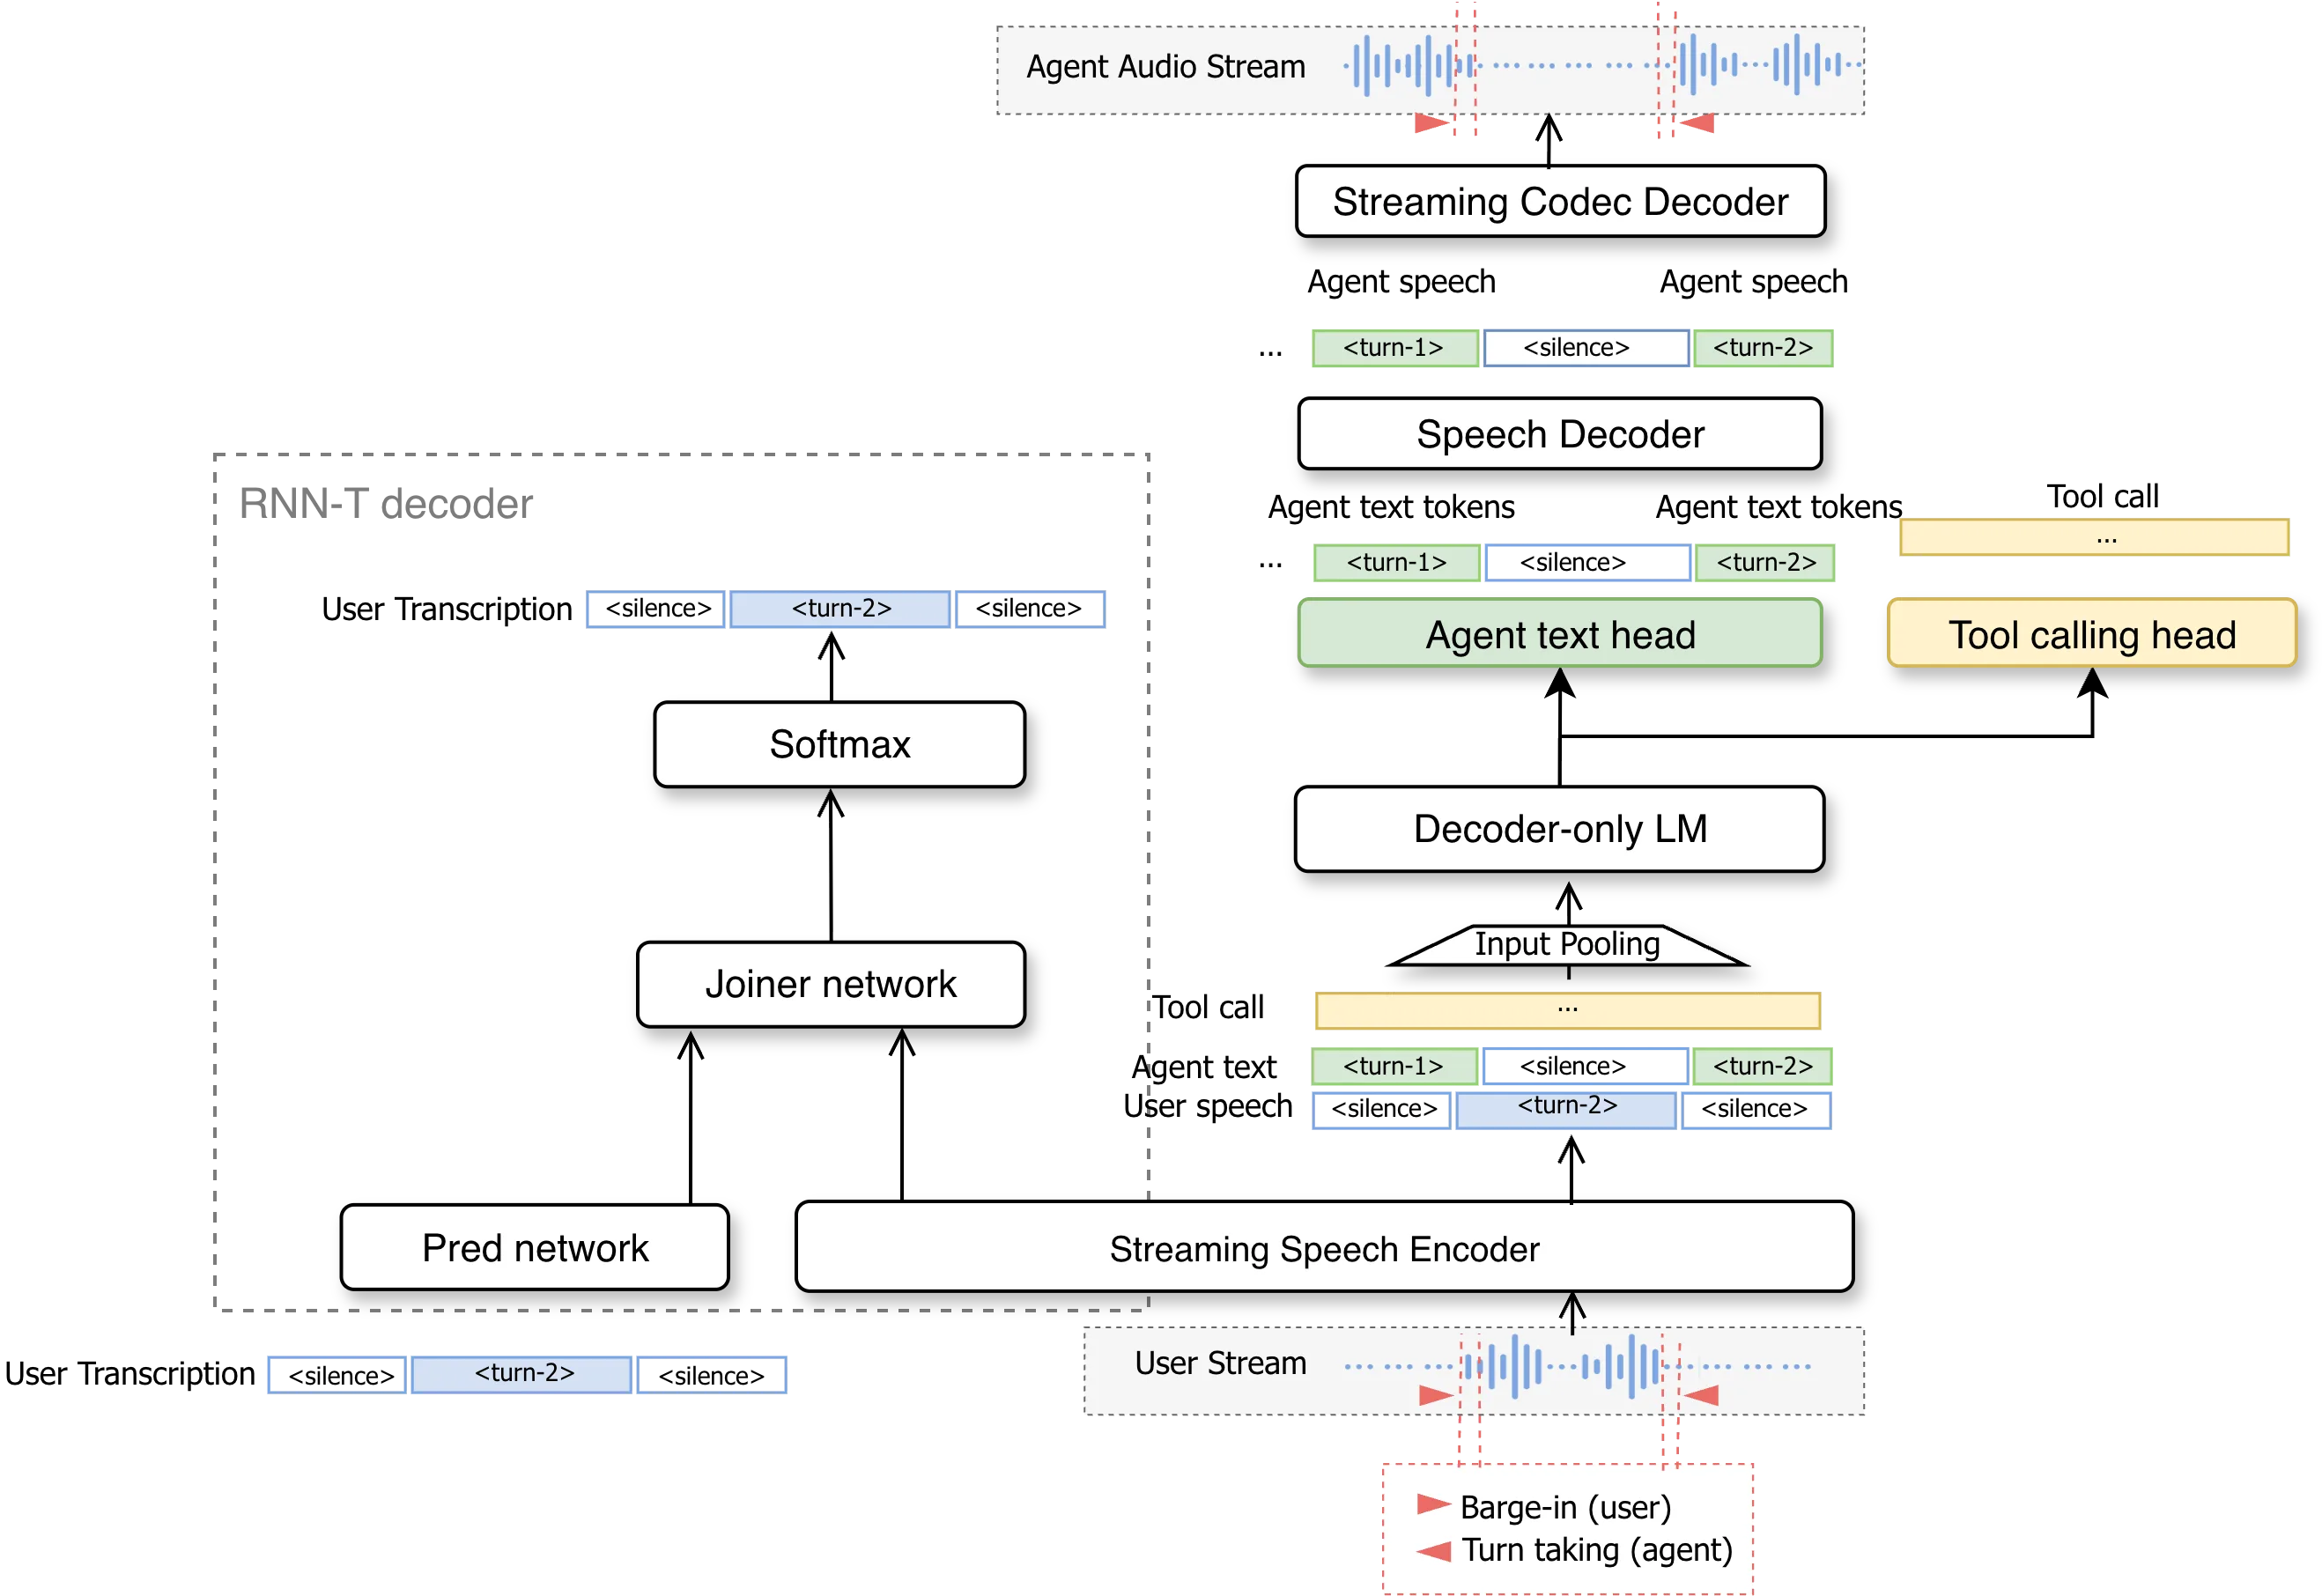
VoiceChat 走的是另一条路。音频先经过 Fast Conformer 编码,随后进入 Nemotron Nano v2 9B 骨干,模型直接预测文本 token,再交给 TTS 解码器生成语音。工具调用则走独立输出通道,不必把整段对话停下来等文本协议。
这刀切得有点子牛逼。
它把听、想、说塞进同一条连续流里。Full-Duplex-Bench 1.0上的顺滑轮换延迟是 448 毫秒,用户打断延迟是 480 毫秒。全双工也不是两边抢着说话,而是模型在输出时仍持续接收用户声音,知道什么时候让出话头。
可低延迟只解决了交互链路最显眼的一段。
一个语音 Agent 真正交付任务,还得识别用户意图,选对工具,填对参数,等外部 API 返回,把结果转换成适合朗读的话,处理超时和错误,再确认这次动作没有在用户改口以后过期。
你想想看,天气查询 448 毫秒接话很丝滑,结果城市参数听错了。订单状态查得很快,结果拿了上一个会话的订单号。语音没有冷场,动作却做错了。
快,当然重要。
快着把错误送到生产环境,通常只会让事故更有节奏感。
公开权重和伸手可用,中间差一张 80GB 卡
VoiceChat 的权重采用 OpenMDW 1.1,NeMo 代码采用 Apache 2.0。公开模型卡、代码和容器,已经比只给一个演示视频厚道很多。
但开放权重不等于可达。
官方代码分支写得很直接,至少需要一张 80GB 显存的 NVIDIA GPU。支持列表里是 A100、H100、H200、B100、B200 和 RTX 6000,操作系统是 Linux。离线推理要固定 Python 3.12、PyTorch 2.10、mamba-ssm、causal-conv1d 等依赖,实时交互还要用 NVIDIA 的 CUDA、Triton 和 vLLM 容器,通过双向 WebSocket 跑起来。
棒棒的,README 连依赖冲突都替你踩出来了。
问题是,多数独立开发者没有一张闲着的 80GB 卡。模型目前也没有官方托管 API,常见推理服务商没有现成入口。你不能像试一个普通文本模型那样,拿 API key 发十个请求,下午就决定要不要继续。
这里很容易掉进一个词语陷阱。
模型文件可以下载,我们就说它开放。开发者能否在合理时间和成本内完成评估,那是另一回事。产品团队能否稳定部署、扩容、监控和回滚,又是第三回事。
坦率讲,开放权重是法律和分发层的可用,伸手可用是工程与经济层的可用。 两者都很有价值,但不能混着算。
如果团队真想评估这类模型,第一张表不该只放 VoiceBench 名次。还要放单会话显存、并发数、冷启动时间、每分钟音频成本、最坏延迟、容器恢复时间和故障后的降级路径。
没有这张表,448 毫秒只是展台上的数字。
能调工具,不等于能把任务做完
VoiceChat 最新鲜的设计,是在全双工语音里加了一条工具调用侧通道。
模型生成 <TOOLCALL> 脚本,外部系统执行后返回 <TOOL_RESPONSE>。每个工具还可以预设一句等待话术。用户问天气时,模型先说「我查一下」,API 在后台跑,语音链路不会突然死寂。
这个细节很懂产品。真实对话里,两秒安静已经足够让人怀疑电话断了。
不过等待话术遮住的是延迟,不是失败。
官方在 AU Harness 的 BFCL-v3 语音工具调用子集上给出了完整成绩。简单调用 58.5%,多工具 62.5%,并行调用 42.5%,并行多工具 27.5%,平均 56.1%。到了 Full-Duplex-Bench v3,工具选择准确率有 82.5%,参数准确率掉到 44.2%,最终 pass@1 只有 33%。
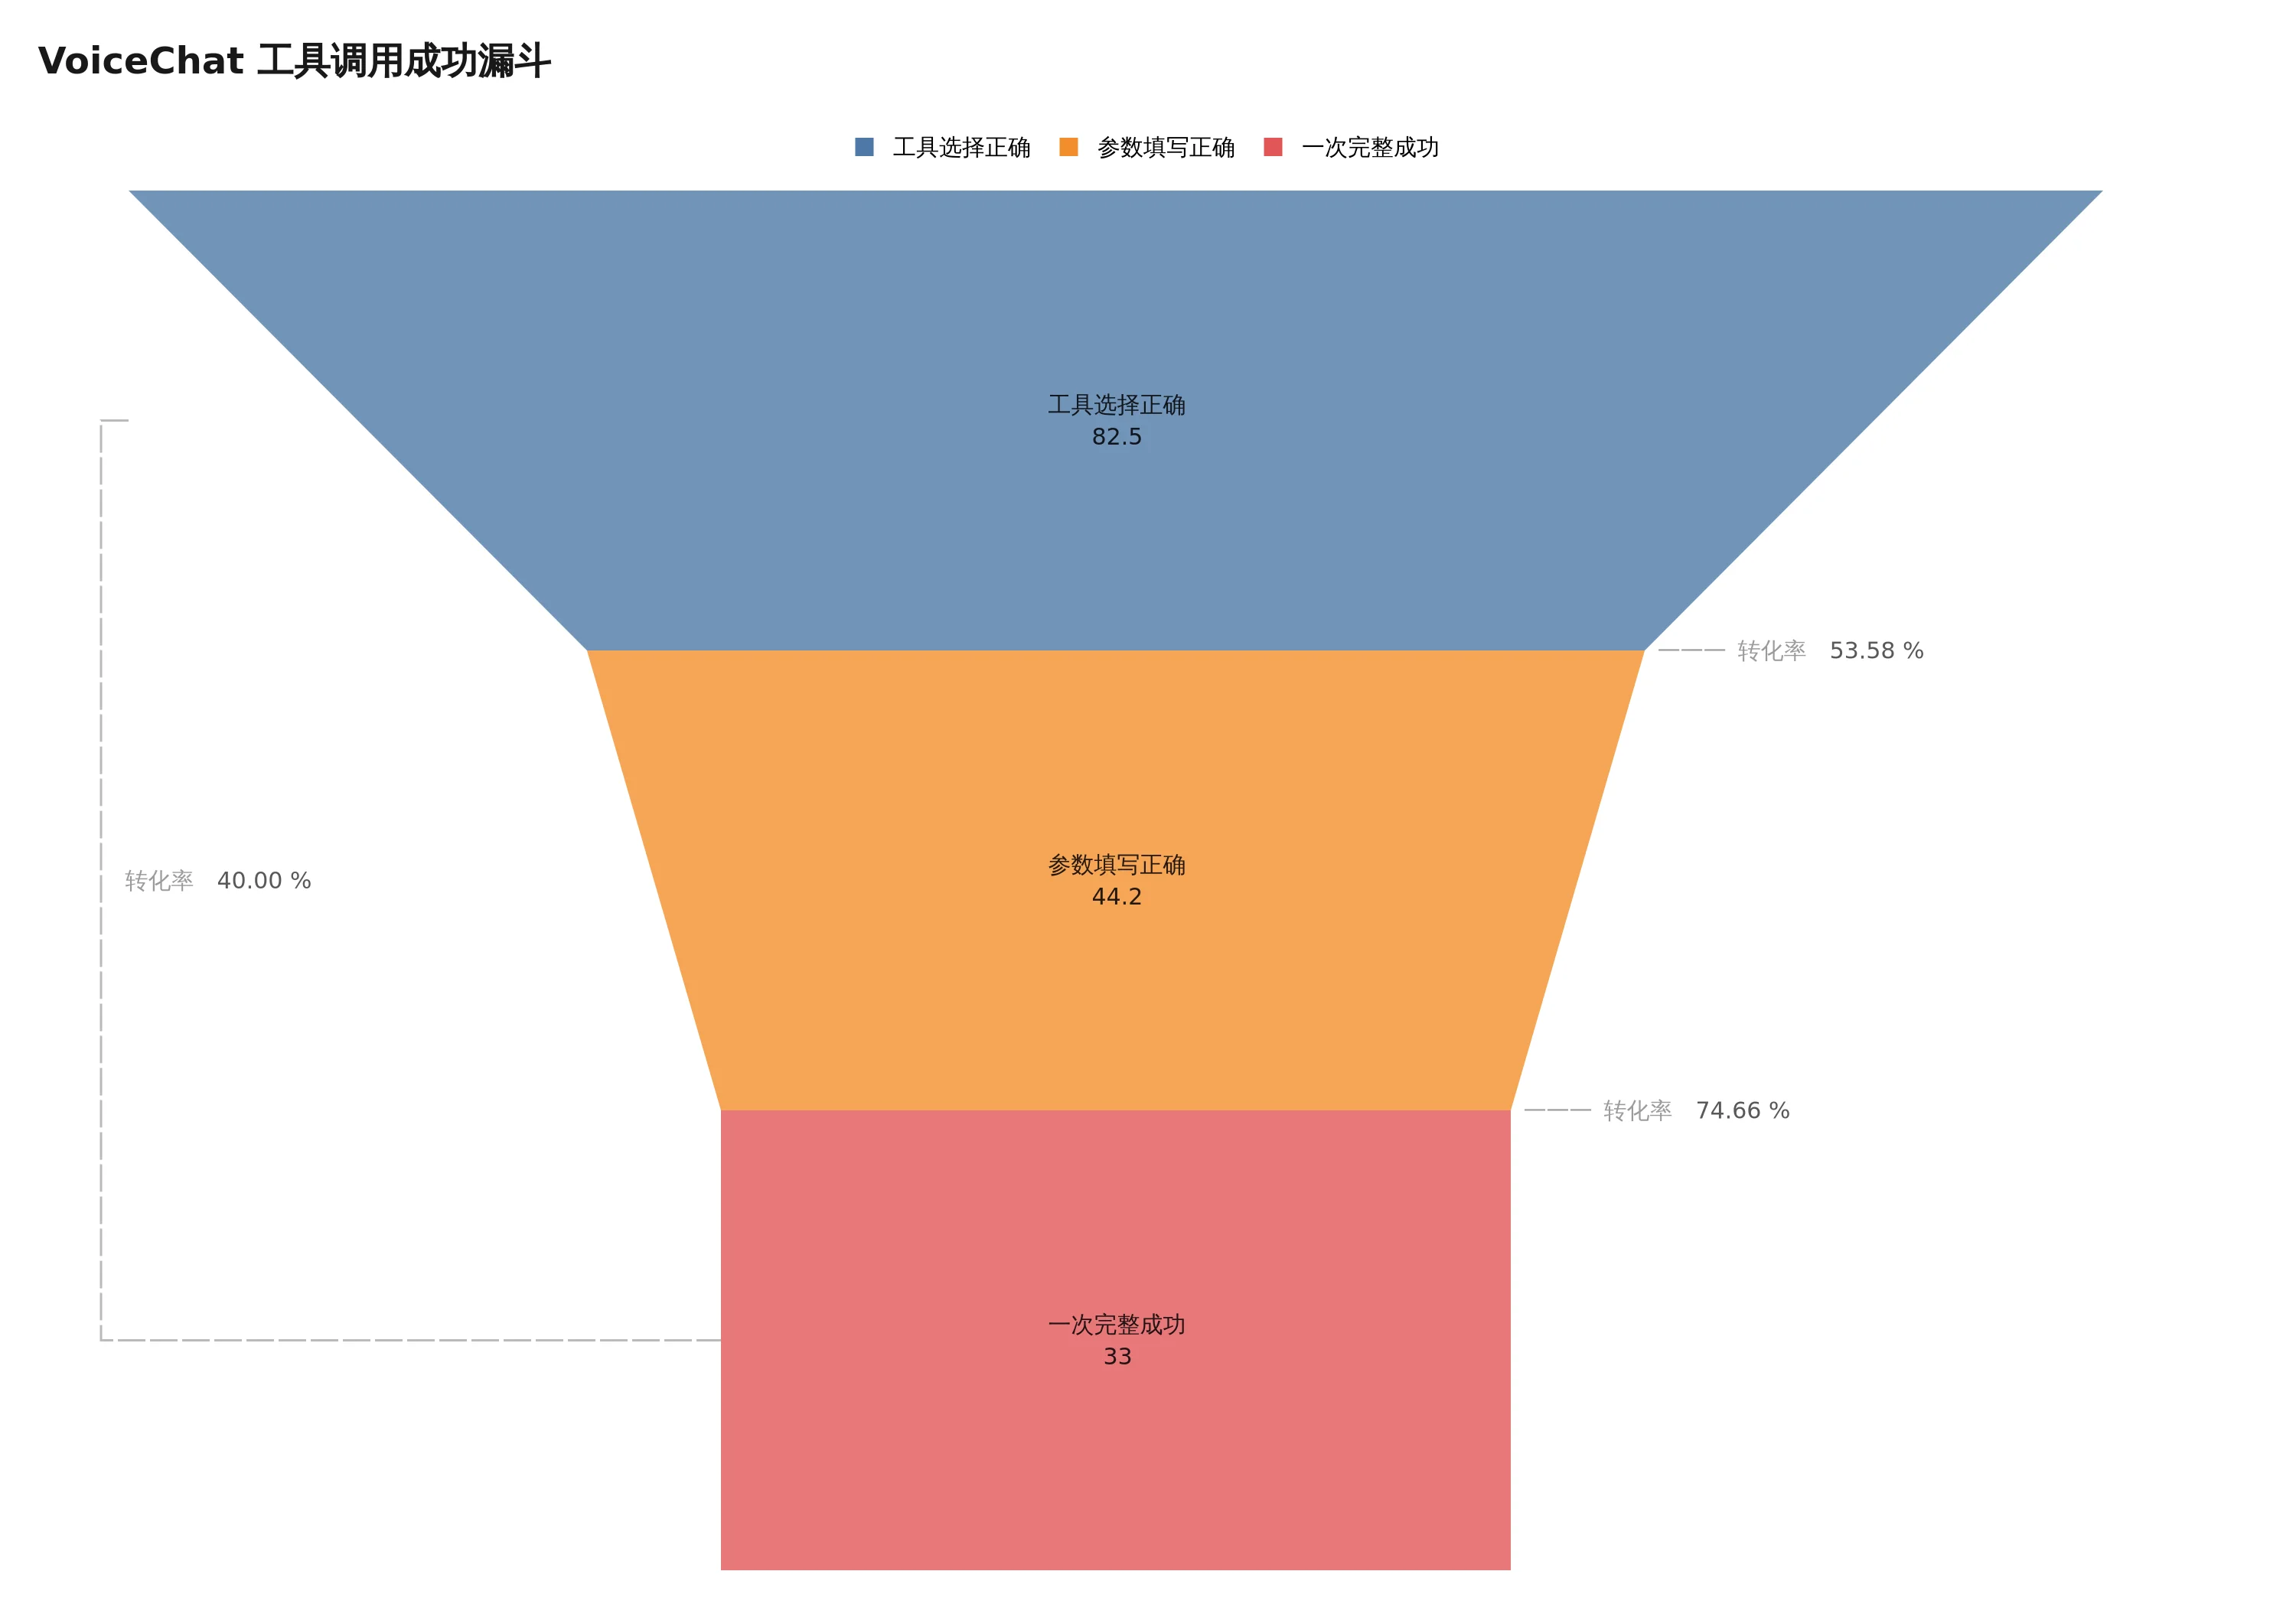
工具选择已经不错,参数和完整执行仍会把一次成功率继续往下压。
这个落差很关键。
模型知道该查天气,不代表它把城市、日期和单位都填对。参数填对,也不代表外部服务没超时。API 成功返回,还不代表模型把结果念对,更不代表它没有在用户改口后执行一条陈旧动作。
官方限制同样不含糊。每个会话建议最多放五个工具,更多会降性能。模型暂时不能可靠地同时调用多个工具。工具执行期间,用户不能打断它。系统提示词和工具结果还得用 ASCII,中文标点和 emoji 都可能制造麻烦。
不是哥们,语音 Agent 面向中文用户,工具响应却得先做一遍 ASCII 清洗,这已经不是把模型端点接进来就完事了。
外层脚手架得补上协议转换、参数校验、超时、重试、幂等键、动作确认和结果朗读。所谓脚手架,就是让模型真正能干活的那层工程。模型负责给出候选动作,系统负责判断动作能不能做、做了算不算成功、失败以后往哪退。
下面这份合同比「支持函数调用」五个字更接近上线要求。
每个动作都有唯一 task_id
工具参数先过确定性 schema 校验
只读查询可以自动重试
写操作必须幂等,并在执行前确认
超过时限就播报等待或切回人工
用户改口后,旧 task_id 返回结果直接丢弃
连续失败时回退到文本链路或级联语音方案
这些规则很无聊。
也正因为无聊,它们往往比演示视频更值钱。
两分钟以后,真实世界开始进场
官方已知限制读起来很长,甚至有点诚实得过头。
模型训练时的音频上下文不超过两分钟,更长对话的记忆不可靠。多轮以后可能退化成无法恢复的乱码,可能卡进词句循环,可能回答结束后继续自说自话,也可能在用户停顿时过早抢话。用户转写会丢开头或中间词,在噪声和强混响环境里表现还会下降。
它只有一个固定声音,不支持声音克隆。指令跟随、复杂推理和安全能力也可能弱于作为骨干的 Nemotron Nano 9B v2。
看完这份列表,我自己的判断是,VoiceChat 现在最适合做公开基线、研究样机和受控试点,不适合直接接到高风险业务动作上。
注意,只适合试点不是贬义。
一个研究模型愿意把失败方式写得这么细,本身就很有用。团队终于可以围着真实问题搭评测,不用只听一段精心挑过的 demo 猜生产表现。
两分钟上下文可以测长会话摘要与状态外置。自说自话可以用输出看门狗、静音检测和最大轮次兜底。转写丢词可以把关键参数回显给用户确认。工具期间不能打断,就把写操作延后到明确确认,把查询动作设计成可取消或可丢弃。
还有一条更现实的路,混合架构。
端到端模型负责低延迟倾听、自然轮换和短回复。复杂推理、长上下文、高风险工具调用交给文本 LLM 与传统级联链路。体验可能没有一条统一模型那么优雅,却更容易审计、替换和降级。
工程里经常这样。最漂亮的架构负责指方向,能上线的架构负责吃晚饭。
开源语音 Agent 的门槛已经换了位置
VoiceChat 11B 很重要。
它把实时语音、全双工轮换、工具侧通道、等待话术、WebSocket 推理容器和一整份失败清单都摆到了公开桌面上。后来的团队不必从零猜一条端到端语音 Agent 应该长什么样。
可它也把另一个事实摆得很清楚。
模型会不会说,正在从难题变成功能。开发者能不能摸到它,系统能不能管住它,工具能不能一次做对,才是下一段真正难的航程。
448 毫秒让对话听起来像活人。
80GB 和 33%,提醒我们它离普通人的开发环境还有一段距离。
开放权重已经把港口画在地图上了。能不能让更多人真的上船,要看算力、API 和外层工程什么时候一起补齐。