posts/nvidia-equity-investments.md
算力预算别只看 GPU,990 亿美元也得算进去
做算力预算的人,大概都熟悉那张表。
GPU 单价,云上折扣,电力,机柜,交付周期。再加一列模型团队预计会烧掉多少 token,会议就可以开始了。
可现在,这张表少了一项,而且越来越贵。
英伟达在最新一份 10-Q 季度报告里披露,截至 7 月 26 日,它的股权投资规模是 990 亿美元,另有 250 亿美元的投资承诺。
好家伙。
一家公司卖 GPU,账上却放着接近千亿美元的生态股权。这个数字不是一条适合午休时划过去的财经快讯。它会改变我们理解算力需求的方式。
以前看需求,问题很直白。客户要不要买卡,模型团队会不会扩容,云厂商是不是缺货。
现在还得多问一句,客户有没有钱把这轮扩容走完。
990 亿美元不是一笔采购订单
先把边界划清。
990 亿美元是英伟达披露的股权投资规模,不是单季收入,也不是所有客户已经下好的 GPU 订单。报告还写明,其中公开持有的证券会跟着市场价格波动,部分资产有锁定期。它同时披露,对基础设施融资方采用权益法核算的投资为 33 亿美元。
所以别急着把它翻译成「英伟达给客户塞了 990 亿美元去买芯片」。财报撑不起这么粗暴的结论。
但另一头也别装作这只是财务部的边角料。媒体按公开披露做的对照是,规模大约从两年前同期的 22 亿美元,升到一年前的 70 亿美元,再到现在的 990 亿美元。同比口径来自 The Next Web 的报道,原始的当前规模则回到 10-Q 核对。
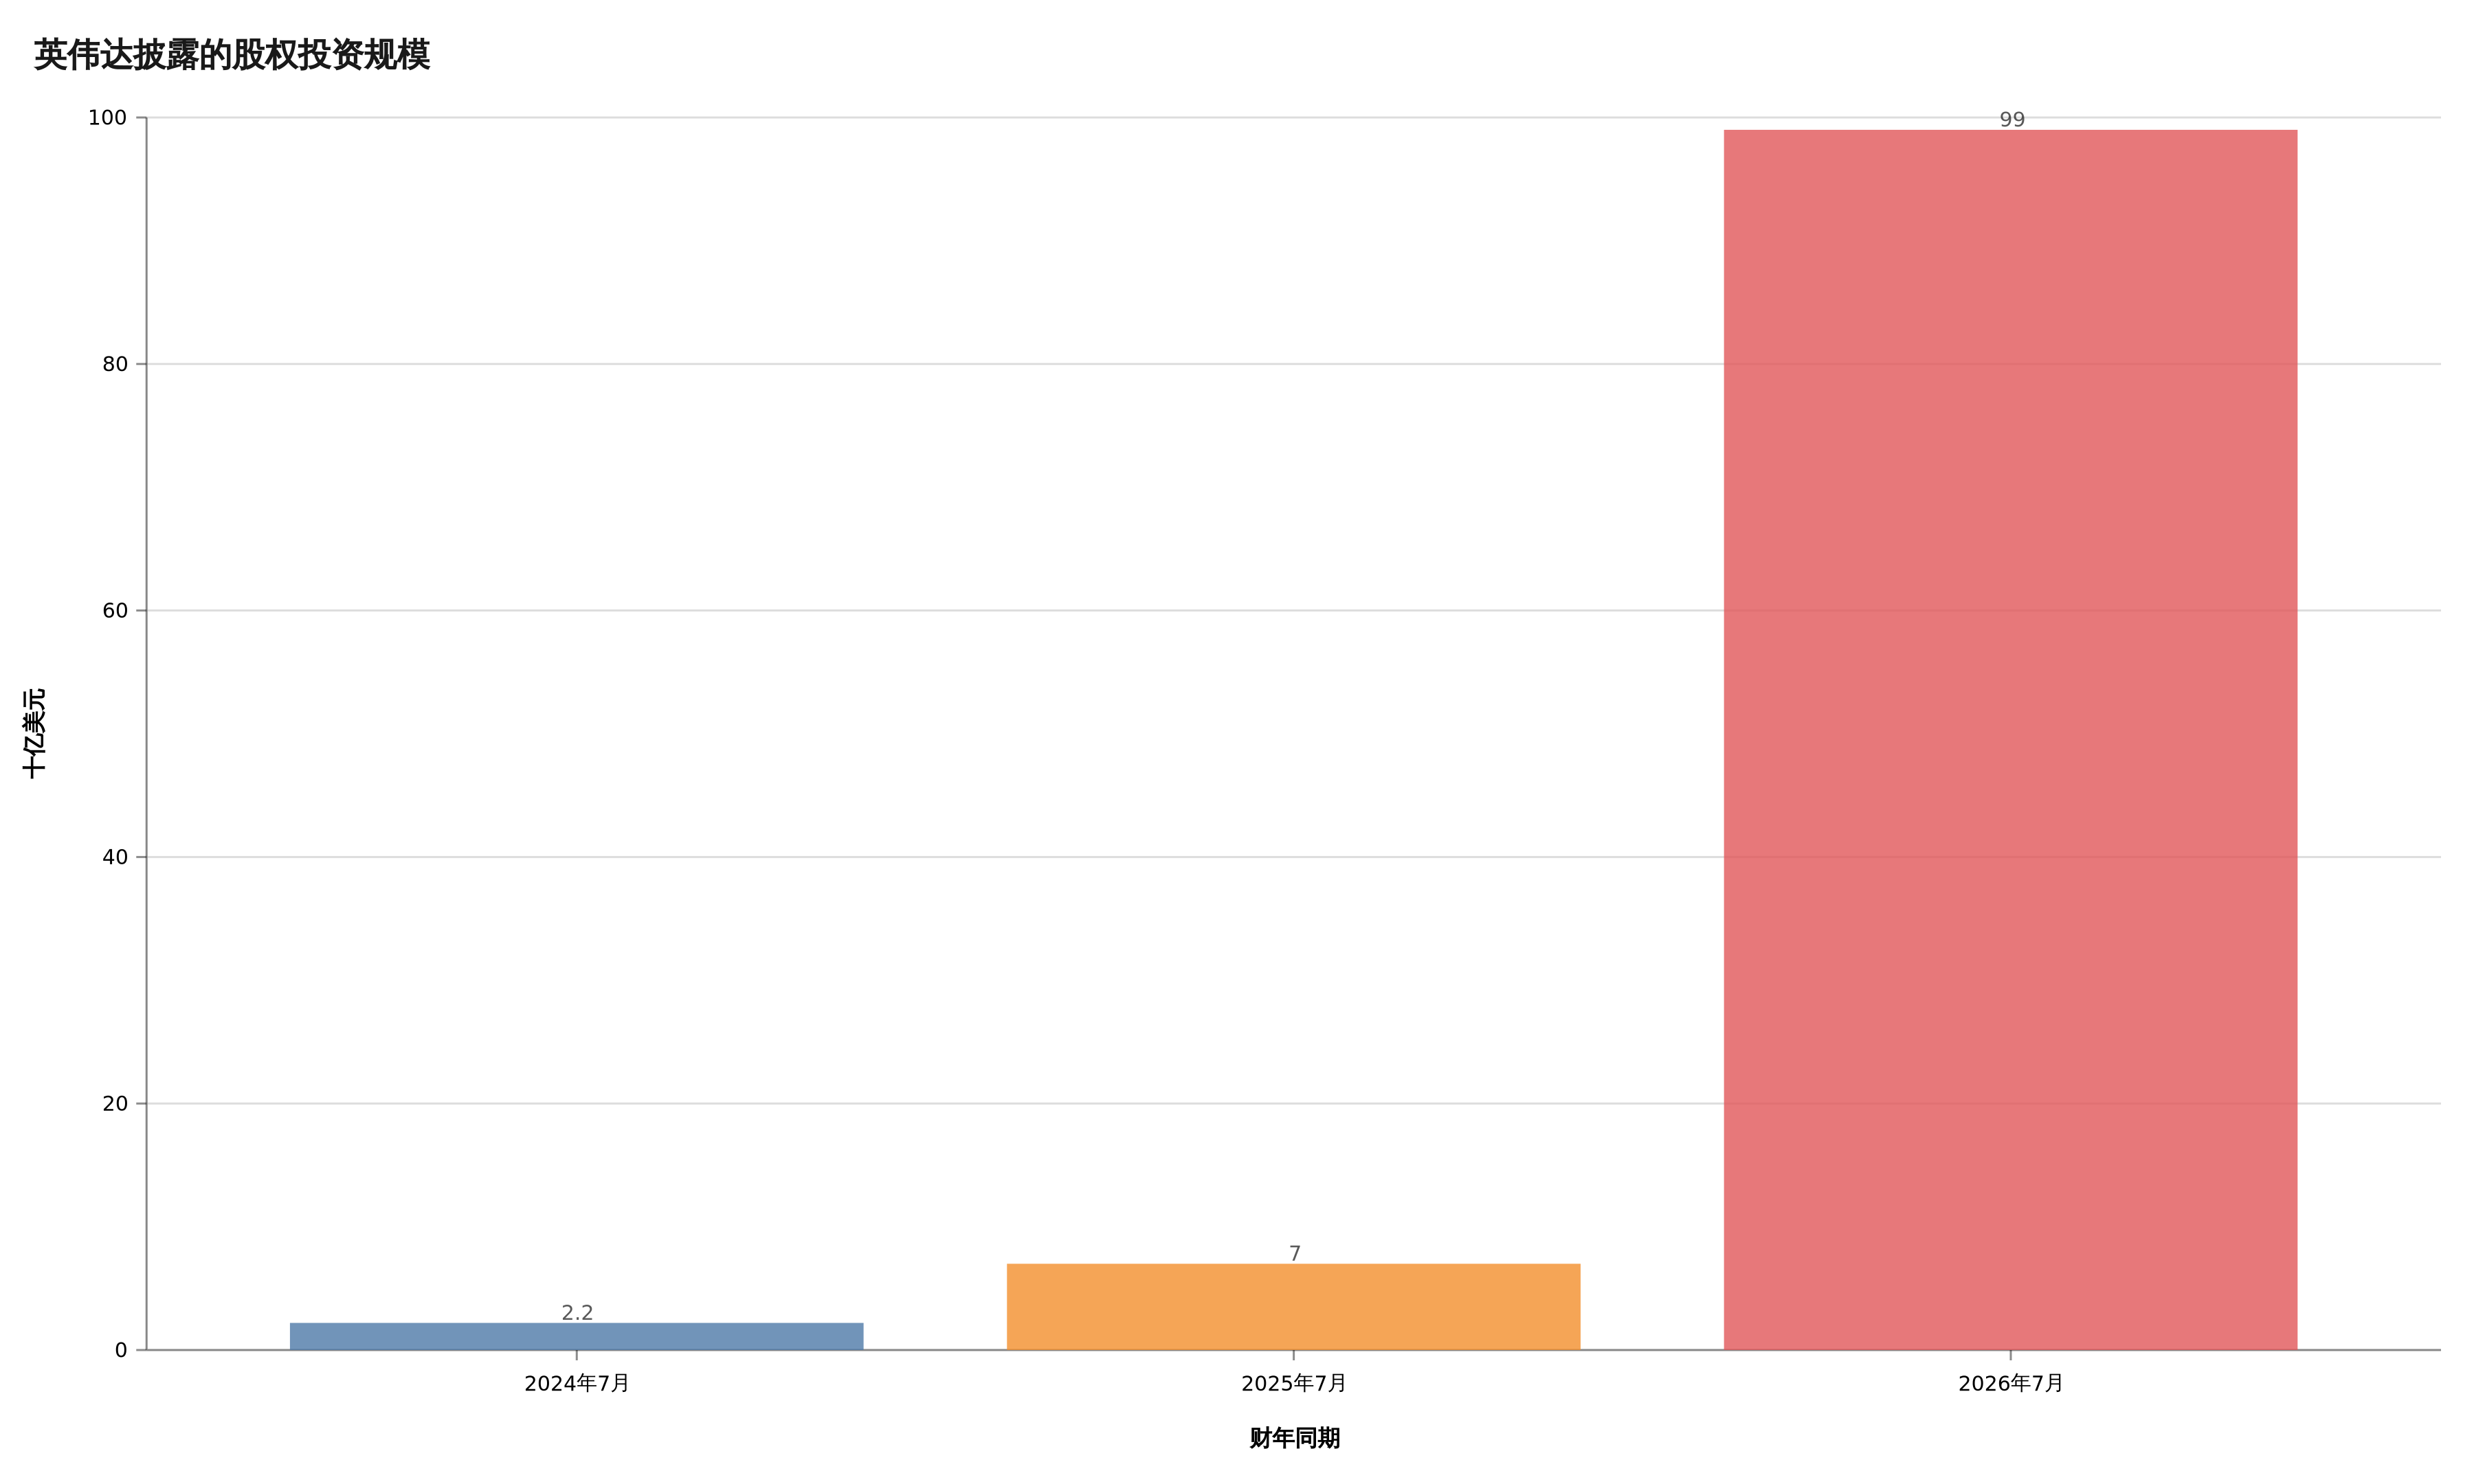
媒体报道的同比对照与英伟达 10-Q 当前披露。单位为十亿美元。
这条线的意义不在于给谁的估值加戏,而在于英伟达的角色变了。
它不只是在供货。
它也在帮生态里的公司获得把算力项目做下去的资本、信用和时间。卖铲子的人,开始更认真地研究谁能把矿挖完。听着有点绕,实际非常工程。
一个需要数年建设的数据中心,最怕的并不是今天少几张卡,而是明年钱、机柜、电力和实际使用率里有一项掉链子。GPU 交付了,训练没跑起来,推理量没长出来,资产依然会在账上折旧。棒棒的,容量规划直接变成了昂贵的收藏。
供应链开始替需求做融资
英伟达在报告里说,这些投资和承诺用于增强增长机会、培育生态、强化竞争位置。公司在 8 月还宣布,和多家金融机构合作,计划长期动员超过 5000 亿美元第三方资本建设 AI 基础设施。官方公告写得很明白,目标是把算力和全栈基础设施做成全球资本愿意持有的资产。
这一手有点子牛逼,也有点让人不敢只看演示稿。
对卖方来说,客户拿到更长期、更便宜的资金,项目才能跨过最难的那段建设期。对买方来说,融资能把一次性资本开支摊平,早点拿到容量。对生态来说,更多模型、云和应用公司能继续拉高需求。
这不是阴谋论,也不需要拿「资金自我回流」几个字把所有交易一锅炖了。公开材料只能确认投资、承诺和融资平台存在,不能替我们判断某一笔交易的因果,更不能保证每一座机房都会被满载使用。
真正需要盯住的,是后面的兑现。
如果 GPU 出货、融资落地、数据中心通电、模型调用和客户收入一起向前走,这是一条扩容链。要是前面几个环节涨得很快,末端的调用和现金流没跟上,风险就会一路倒灌回来。
很多团队算 Agent 成本时已经知道,不能只看每百万 token 的单价。长任务的重试、工具调用、人工接管和峰值并发,往往才是账单里最会搞事情的部分。
基础设施也是同一个道理。芯片报价只是第一行,后面还有融资期限、交付节奏和使用率。这三项不在一张表里,就很容易被会计上“已经拿到容量”的幻觉骗过去。
下一次规划会,给这三栏留位置
如果你负责模型平台、训练集群,或者要给老板解释下一年的云预算,我会把原来那张表拆成三栏。
第一栏,成本。单卡、网络、电力、云上预留、迁移费用。这个大家已经算得很熟。
第二栏,容量。什么时候交付,能用多少,峰值要留多少余量,模型切换后闲置的机器怎么办。别把合同里的容量和真正跑起来的容量混为一谈。
第三栏,信用和使用率。项目的钱来自哪里,承诺是不是有条件,客户业务能不能持续消耗这些算力。这里不是让工程师去当投资经理,而是提醒大家,长期容量不等于确定需求。
这三栏放在一起,很多看起来很热闹的消息会自动降温。
还有一个很实用的小动作,把每个容量项目按时间拉开。签约日、融资确认日、机房可用日、第一批训练任务上线日、稳定推理量出现日,别只留一个「预计上线」。前面四个节点都能完成,稳定推理量还没来,项目对业务的价值就仍然是待验证。
这不是故意泼冷水。做平台的人都知道,容量要提前准备,等调用量暴涨了再去排队,基本只能看着 P99 延迟冒烟。问题在于,提前准备和提前把未来收入算进今天,是两回事。
尤其在 Agent 开始跑长任务以后,利用率不是一个静态百分比。白天可能是客服、代码审查和文档处理,夜里可能是评测、批量迁移和离线训练。谁能把这些负载错峰塞进同一批机器,谁才真的把容量用成了资产。否则再漂亮的采购折扣,也只是给空机柜拍了一张好看的证件照。
某厂又签了大单,不只问金额,还问交付期和是否有附带融资。
某云又开了新园区,不只问装机量,还问客户工作负载是否已经到位。
某模型公司说要扩大训练,不只问参数量,还问之后会不会有稳定的推理业务把机器吃满。
厉害了,原来算力预算的尽头不是选哪张卡,而是判断哪一种需求能活到机器开机那天。
算力项目要同时穿过交付、融资和真实工作负载三道关。
不要把一份季报读成结论
这里还有两个坑,得提前放在桌面上。
第一,股权投资的账面价值会波动。它可以因为市场价格、估值变化或会计处理而大幅变化,不等于公司在同一时期拿出了等额现金。把 990 亿美元直接当作本季度新增投入,会看歪。
第二,生态投资和真实消费之间不是等号。客户即便融资顺利,也可能延后建设、调整模型路线,或者把工作负载迁到别的架构。公开报告没有给出每个项目的 GPU 利用率,更没有承诺未来收入。
所以这篇不是投资建议,也不是替任何一方唱多或唱空。
它只是想把一个容易被忽略的变量放回工程讨论里。过去我们用芯片交付、模型能力和 token 单价来解释 AI 的扩张。接下来,资本能否撑住那条扩张链,也得进监控面板。
英伟达把 990 亿美元摆进季报,值得看的不是一个夸张数字,而是一个角色切换。硬件供应商正在更深地参与需求能否发生的过程。
下一次你们开算力规划会时,会不会把「客户能否持续使用并付得起这批容量」单独加成一栏?