posts/nvidia-huggingface-distribution-layer.md
NVIDIA 129 亿要买 Hugging Face,最贵的是模型入口
129.303 亿美元。
不是约 129 亿,NVIDIA 的公告把零头写到了 30 万美元。好家伙,一笔 AI 收购案,价格精确得像刚跑完的账单。
9 月 3 日,NVIDIA 正式宣布已同意收购 Hugging Face。同日公开的信息里,有几组数字很抢眼。超过 1800 万名开发者,超过 300 万个模型,50 万个数据集,100 万个应用,还有超过 20 万家公司在用这个平台。
更严谨一点讲,现在是签了收购协议,不是所有交割动作都已经完成。NVIDIA 向美国证券交易委员会提交的 8-K 文件 也用的是拟议收购,并专门列出了交易与后续整合的不确定性。
金额当然大。但我自己的判断是,NVIDIA 买的并不是 300 万个可以下载的文件,也不只是一个被叫作「AI 界 GitHub」的网站。
它买的是开发者决定用哪个模型的入口。
129 亿美元没有买走一个文件夹
很多人第一次接触 Hugging Face,是在一段 Python 代码里看见一个 repo_id。
模型名字填进去,权重下来,Tokenizer 加载,推理开始。顺的话两三行代码,模型就在显卡上吐字。开发者感受到的是下载按钮,平台真正积累的却是一整套默认路径。
你去哪里搜模型,看哪张 Model Card,信哪个下载量,挑哪个量化版本,复制哪段推理代码,接着选哪个托管推理服务,这些选择往往都发生在 Hugging Face 里。一个模型能不能被看见、被试用、被做成衍生版本,再被塞进生产链路,平台每一层都在场。
Hugging Face 自己在 8 月发布的 开放模型生态观察 里给过一组更能说明问题的数字。公开模型仓库已经增长到 296 万个,但 85.6% 的模型终身下载量少于 200 次,1.5% 的仓库拿走了 99.2% 的下载。
同一排货架,大部分商品没人伸手。
所以平台的价值不只在「存了多少模型」,更在「流量如何找到模型」。推荐、搜索、榜单、文档模板、兼容标签、推理入口,这些不起眼的默认项会把注意力压到极少数仓库上。模型作者要的是被发现,开发者要的是少踩坑,云和芯片厂商要的是让模型顺着自己的运行栈落地。
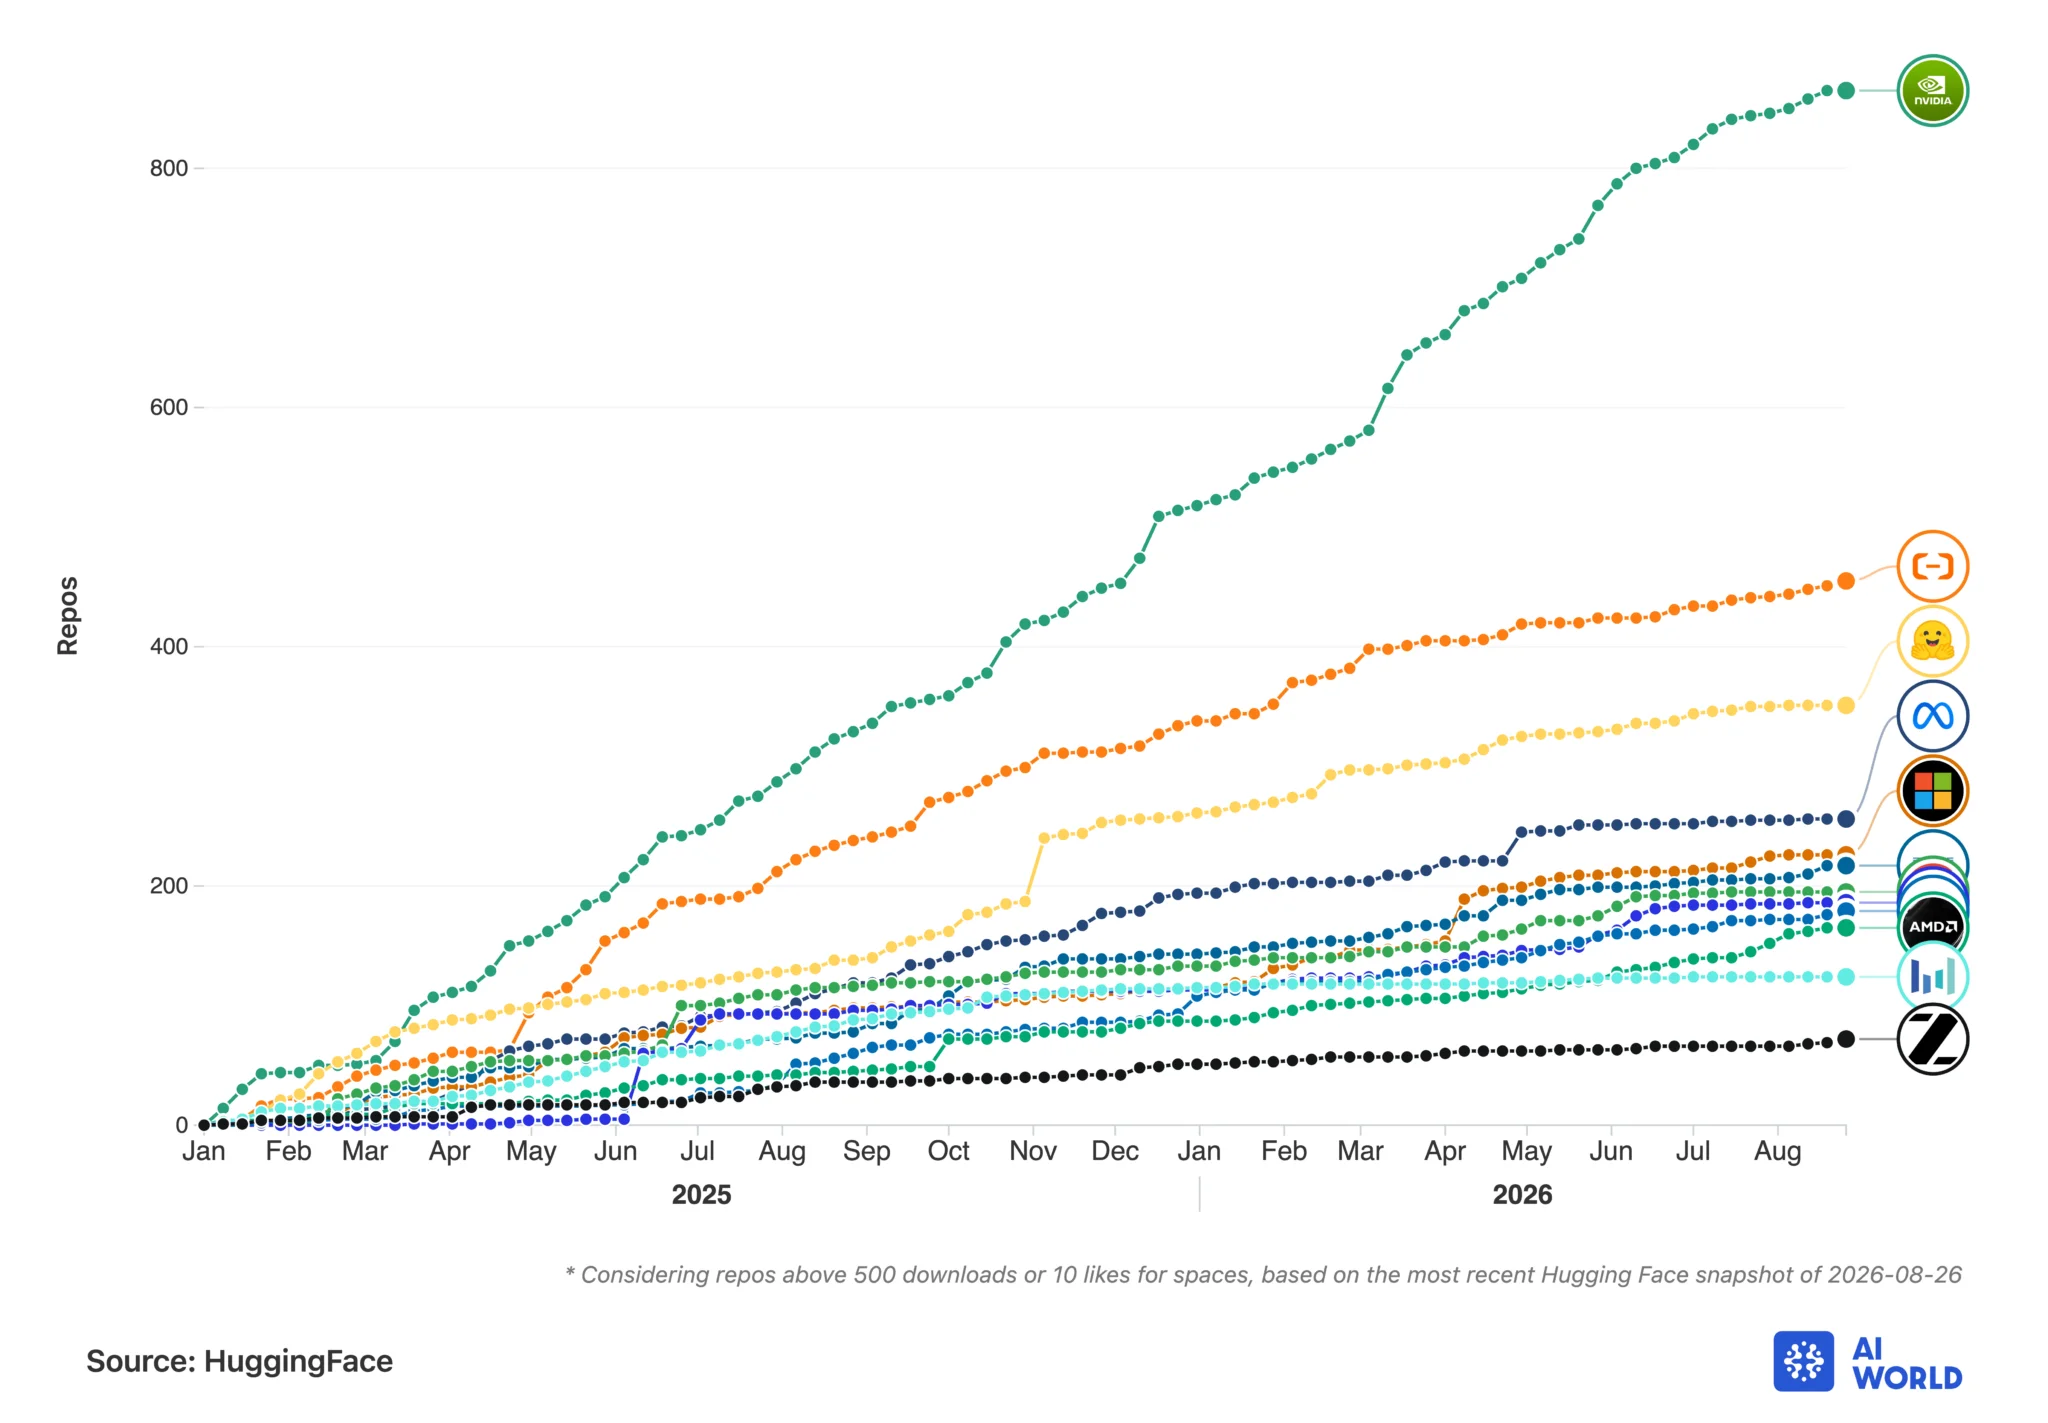
NVIDIA 原本已经在这条链路里很深。官方称自己是 Hugging Face 上开放模型和数据的最大贡献者,已经发布超过 500 个模型和 250 个开放数据集。现在它从货架上的大供货商,变成了货架的所有者。
这一步有点子牛逼,也天然让人多看一眼。
不是因为一家公司拥有平台就一定会把门锁上。微软收购 GitHub 后,Git 仓库没有集体消失,开源社区也没有按下暂停键。真正需要盯的,是那些一开始看起来只省一次点击的默认设置。默认推理后端是谁,默认优化路径偏向哪种硬件,搜索结果如何排序,托管部署把哪个服务放在前面。
开发者很少被一堵墙赶走,更多时候是沿着最顺的路慢慢走进一个生态。
「继续开放」该怎么验
NVIDIA 在公告里给了相当明确的承诺。Hugging Face 会继续支持所有模型开发者,继续支持多云和多加速器,开发与部署不要求使用 NVIDIA 算力。
这几句话很重要,也应该被完整记下来。坦率讲,现阶段没有证据可以把它改写成平台马上会封闭。把担忧写成既定事实,除了制造情绪,对工程决策没什么帮助。
可工程师也不能只收藏公告,然后等未来打脸或者被打脸。
「开放」不是一个开关,它至少有四层。
最里面那层是权重和许可证。文件能不能拿到,能不能修改,能不能商用,许可证改变时有没有清楚的版本记录。
再往外是分发中立。不同组织、不同模型、不同硬件的结果,是否还能在搜索、榜单和推荐里公平出现。
第三层是执行可迁移。同一份模型能否在不同云、不同加速器和本地环境里跑起来,还是表面能下载,离开某套专有优化就只剩理论可用。
最外层是运营可替代。账号、权限、缓存、推理接口或区域服务出问题时,你的生产系统能不能从另一条路径恢复。
你想想看,如果权重许可证很宽松,但线上服务只认一个端点,业务仍然被端点绑住。如果页面写着支持多加速器,但量化文件、内核和示例只在一种硬件上维护,迁移成本照样高得离谱。反过来,平台所有权发生变化,也不等于你明天必须搬家。
判断中立性,别猜动机,测可替代性。
今天就能做的四个检查
第一个检查,把生产模型从 main 分支上拿下来。
Hugging Face 的 下载文档 明确支持用完整 commit hash 固定 revision。默认下载最新版本,在试玩时很方便,在生产里却像让依赖文件每天自己换。模型权重、Tokenizer、配置和自定义代码只要有一个变了,昨天的评测结论就可能失效。
一个最小的固定版本动作长这样。
from huggingface_hub import snapshot_download

snapshot_download(
    repo_id="org/model-name",
    revision="完整的四十位提交哈希",
    local_dir="./vendor/model-name"
)
代码里的引号和参数当然要用半角,这里别被中文排版带跑偏。重点只有一个,生产环境不要把「最新版」当版本号。
第二个检查,给关键模型留一份可以校验的清单。
不是把整个 Hub 连夜下载一遍,那会先把财务同事吓醒。只整理真正进了业务链路的模型,记录 repo_id、完整 revision、许可证快照、文件哈希、Tokenizer 版本、推理库版本和镜像位置。Hugging Face 的仓库本来就基于 Git,官方也提供了 仓库克隆与历史管理指南。大文件走 Git Xet 或对象存储镜像,元数据进你自己的依赖清单。
可以把它理解成模型版的 package-lock.json。平时安静得像不存在,真到上游改文件、端点抽风、权限出错时,它就是救命绳。
第三个检查,从一台干净机器做冷启动。
别用已经塞满缓存的开发机证明系统可恢复。找一个没有 Hugging Face 缓存的新环境,只用清单和镜像把服务拉起来。测下载、验哈希、载入 Tokenizer、跑一组固定输入,再把输出和基线对上。
这里最容易冒出来的坑,不是模型能力突然变差,而是你以为自己依赖一个模型,实际还暗中依赖了远程自定义代码、某个没有固定版本的 Python 包、一个临时鉴权令牌,以及开发机里半年没清过的缓存。
厉害了,一个 from_pretrained 背后能藏出一支依赖考古队。
第四个检查,把硬件可迁移写进测试,不要写进愿望。
至少保留一条不依赖特定托管端点的离线推理路径。业务逻辑不要直接吞某家服务独有的响应结构,在中间加一层很薄的适配。对于真正关键的模型,定期在第二种环境里跑小规模兼容测试,可以是另一家云,也可以是另一种加速器,甚至先用 CPU 验证功能正确性。
性能未必一样,能跑和跑得快是两回事。但如果另一条路径从来没有启动成功过,那就别在架构图上把它画成备份。
这四项动作听起来没有 129 亿美元刺激,甚至有点朴素。固定版本、列清单、做冷启动、测第二条路径。可生产系统的安全感,通常就是这些不太适合发海报的东西拼起来的。
真正需要盯的是默认项
这笔交易还有一个容易被金额盖住的细节。
NVIDIA 在 SEC 文件里直接写到,Hugging Face 平台聚合了来自全球的热门开放模型,任何限制平台支持某些地区模型的规则,都可能对平台和 NVIDIA 的业务造成重大影响。这个风险披露很诚实。Hugging Face 的价值来自生态够杂、选择够多,少掉一大块模型来源,平台本身也会变薄。
所以 NVIDIA 有很强的商业动力维持开放。开放模型越多,训练、微调和推理需要的算力越多。哪怕开发者没有被强制使用 NVIDIA,平台规模增长仍然可能扩大它能参与的市场。
这也是我对交易最感兴趣的地方。过去大家常把开源和商业放在桌子两边,好像一边赢,另一边就得输。Hugging Face 这 129.303 亿美元提醒了另一种关系,开放生态可以不直接收取高额许可证费用,却能在分发、托管、评估、部署和硬件需求上积累巨大的商业价值。
钱不是为免费代码付的,是为默认路径付的。
那开发者接下来该盯什么?不用每天刷新收购新闻。每个月看几个朴素指标就够了,搜索与榜单有没有明显偏向,非 NVIDIA 硬件的文档和示例是否同步维护,第三方推理服务有没有被藏深,下载与托管价格是否改变,许可证和区域可用性有没有悄悄收紧。
承诺写在公告里,方向藏在产品默认项里。
我也不敢断言几年后 Hugging Face 会变成什么样。现在就喊开放已死,太早。完全不做准备,也太乐观。比较稳的姿势,是继续用这个全世界最方便的模型社区,同时把版本、镜像和迁移路径握在自己手里。
棒棒的,平台继续开放。
更棒的是,你的系统不需要靠任何一家公司的形容词才能继续运行。