posts/open-model-long-tail.md
296 万个开源模型,99.2% 下载流向 1.5% 仓库
296 万个公开模型仓库。
其中 85.6% 的模型,终身下载不到 200 次。
而 1.5% 的仓库,吃掉了 99.2% 的下载量。
这三组数字放在一起,有点像一条挤满新店的商业街。招牌每天都在换,开业花篮一路摆到路口,真正有人反复进去买东西的,还是那几家老店。
好家伙,AI 圈每天喊着模型爆炸,炸完一看,大多数连 200 次下载都没等到。
数据来自 Hugging Face 刚更新的开源模型生态夏季报告。2026 年前七个月,Hub 上的公开模型仓库从 243 万涨到 296 万,数据集从 71.1 万涨到 100 万,Spaces 从 100 万涨到 144 万。
如果只看总量,这是一场盛大繁荣。
可那条 99.2% 的长尾分布告诉我们,发布一个模型越来越容易,让它进入别人的代码、定时任务和生产管线,还是难得要命。
我觉得这份报告最有意思的地方,在于它绕开了中美模型座次,直接把「大家正在讨论什么」和「大家真的依赖什么」硬生生掰开了。
开源模型的竞争,早就不只发生在权重文件里。
热闹和依赖,是两套排行榜
Hugging Face 把 2026 年新增下载量前 25 的仓库,与点赞前 25 的仓库放在一起比较。
只有一个重合。
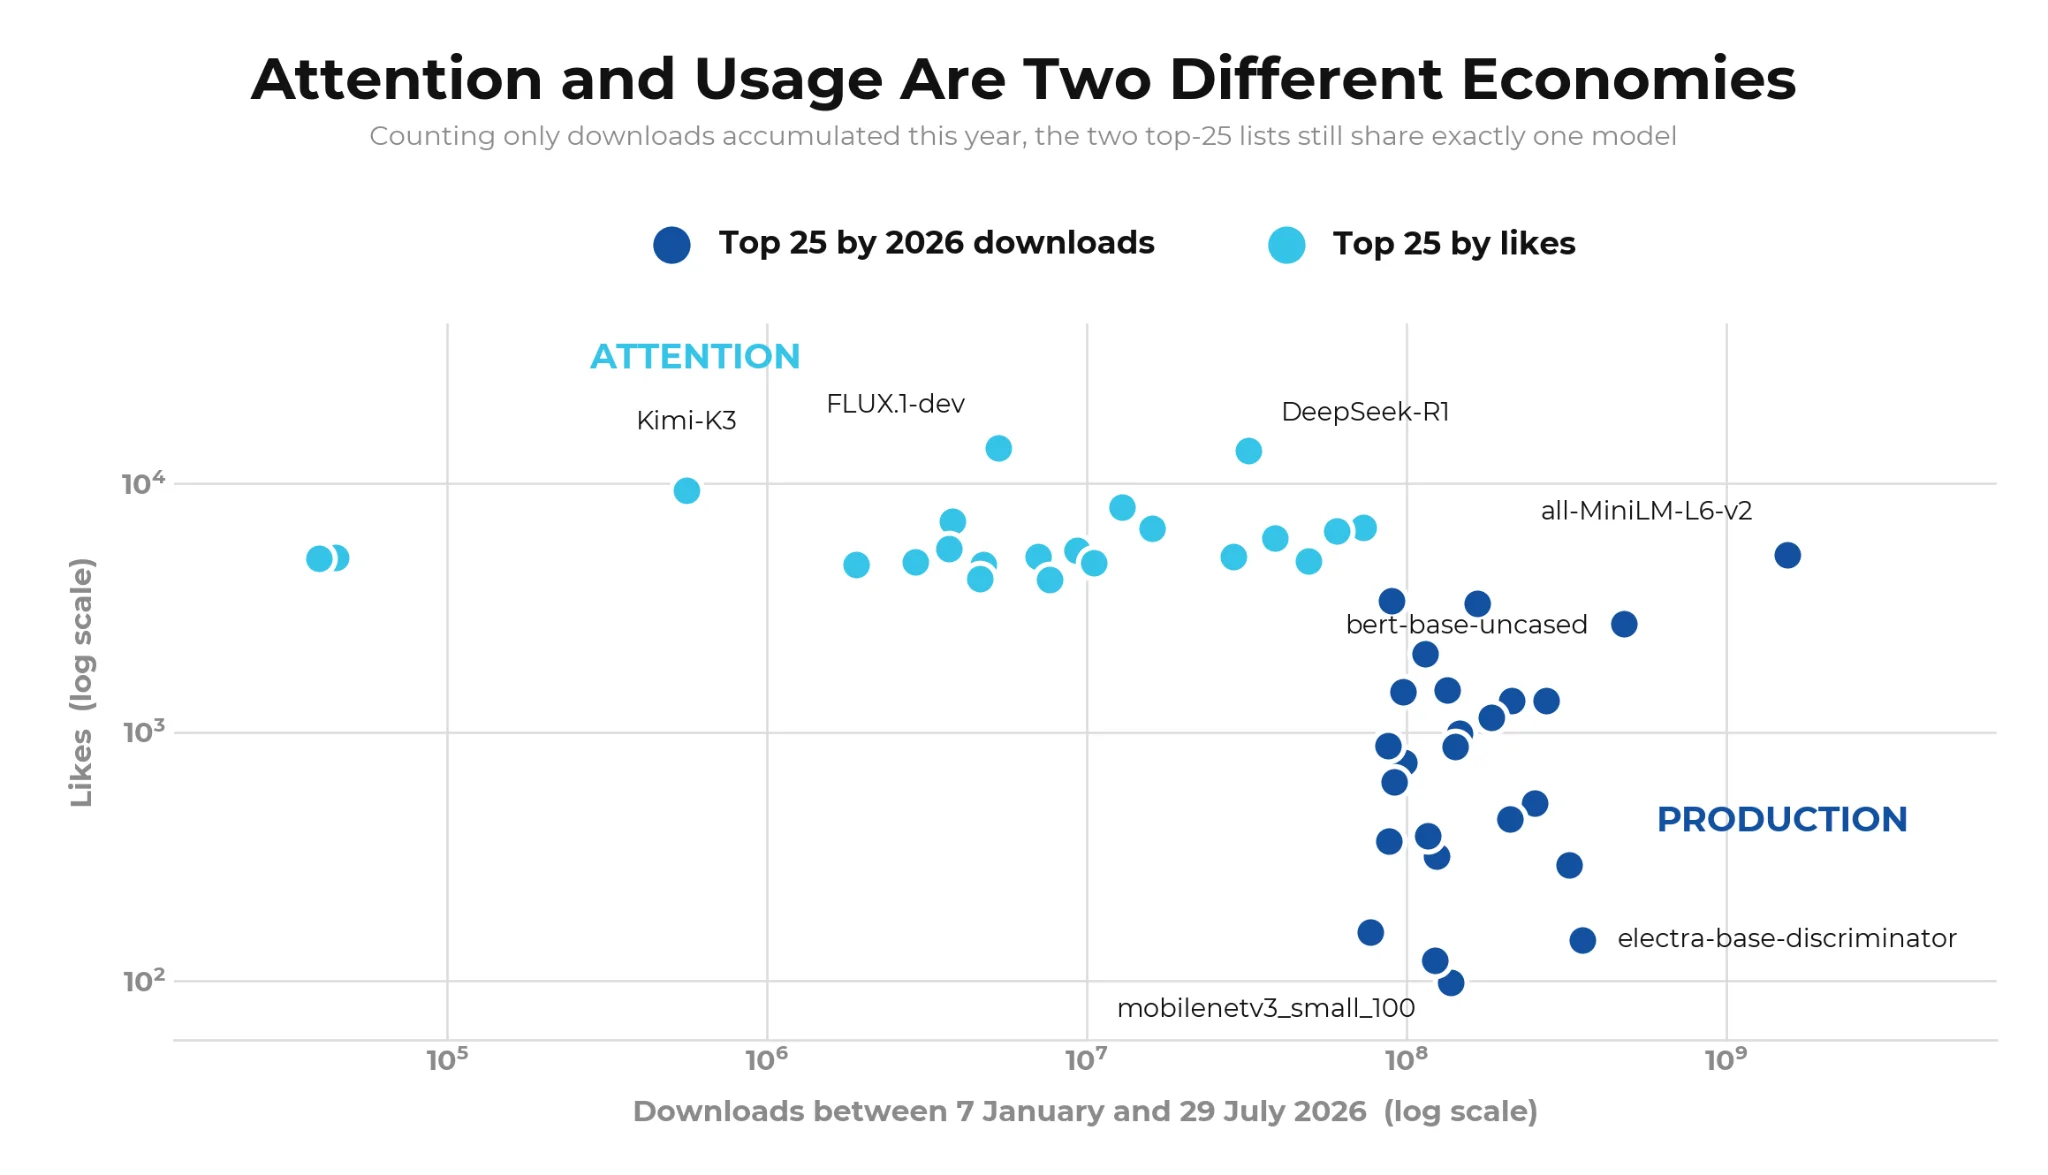
Hugging Face 统计的 2026 年下载前 25 与点赞前 25,只有一个仓库重合。
不是哥们,这已经不是轻微偏差了,这是两群人拿着两张完全不同的地图。
点赞记录的是注意力。一个新模型刚发布,参数大、跑分高、Demo 漂亮,大家顺手点个心,表示「我看见了,这事挺重要」。下载记录的是依赖。某个镜像、CI 任务或 Python 包每天自动拉取它,安静、重复,也不太会跑到评论区表达激动。
报告里有个很扎眼的例子。all-MiniLM-L6-v2在七个月里被下载 15.5 亿次,点赞只有 5156 个。反过来,Kimi-K3每个点赞对应的下载约 60 次。
不能据此说谁更好。一个是已经嵌进大量搜索、聚类和向量流程的小模型,一个是刚出来的前沿模型,它们做的压根不是同一份工作。
但可以下一个判断。
点赞榜更像科技新闻,下载榜更像水电煤账单。
报告还发现,2026 年发布的新模型没有一个进入下载前 25,榜里有 13 个模型来自 2022 年。AI 圈的体感是每周换代,生产系统的体感是一个依赖能稳定跑四年,先别动它。
程序员应该很熟悉这种反差。GitHub Trending 能把新框架送上首页,package-lock.json 里真正活得久的,往往是一个没人讨论、版本号也不性感的小包。它不负责让你兴奋,只负责周一早上别把构建弄挂。
模型也开始走到这一步了。
发布是事件,采用是习惯。事件靠传播,习惯靠兼容、维护、文档、许可证和一堆不值得上发布会的细节。
前沿在变大,生产却往小处扎根
这份报告里最容易做成新闻标题的部分,是中国实验室正在把开放模型的参数上限越推越高。
2026 年大多数月份里,中国实验室当月最大的开放模型,都大于美国实验室原创开放模型。中国一侧的月度上限落在 754B 到 2.78T 参数之间。美国实验室七个月里有五个月低于 130B,少数例外包括 NVIDIA 的 Nemotron 3 Ultra 和 Thinking Machines 的 Inkling。
很猛,没啥好谦虚的。
但把镜头从发布会挪到下载日志,画面立刻变了。
在声明参数量的模型里,1B 以下模型占终身下载量的 83%,100B 以上只占 1%。只看 2026 年新增下载,70B 以上模型也只有 3%。
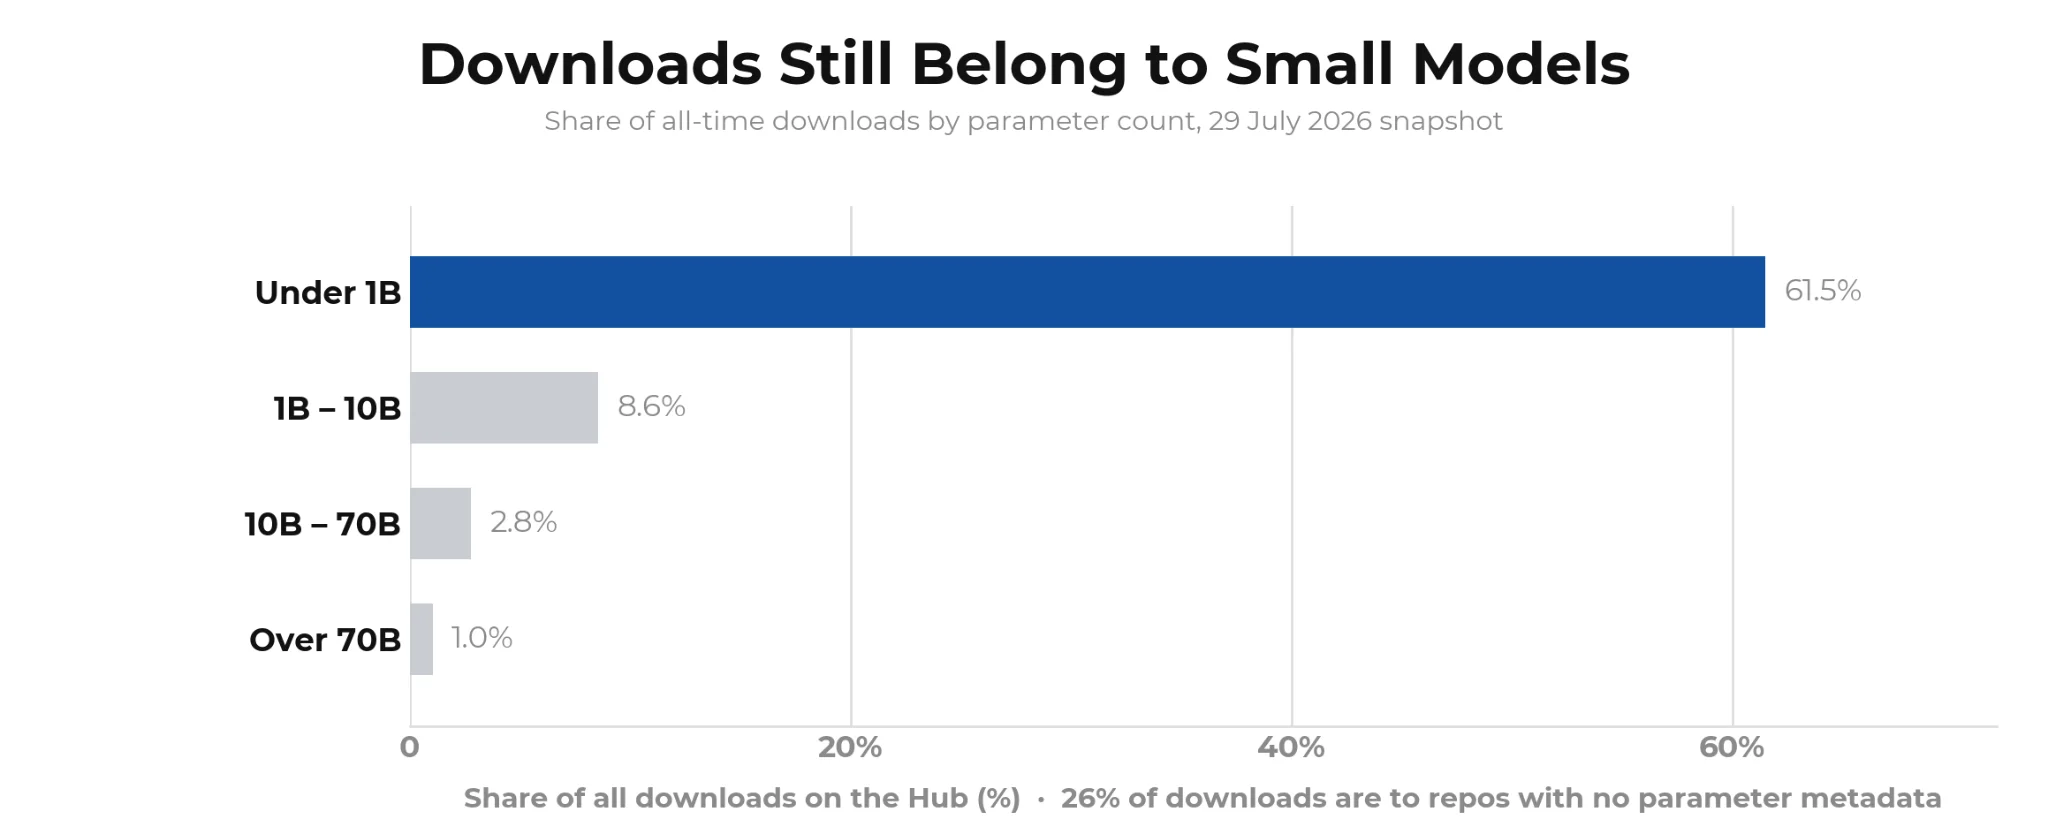
官方图按全部下载口径展示,1B 以下占 61.5%,另有 26% 的仓库未声明参数;只看已声明参数的仓库,报告正文给出 83%。
前沿模型负责定义天花板,小模型负责填满地板。
原因不神秘。1B 以下可以跑在更多 CPU、手机、浏览器和边缘设备上,启动快,内存小,批量调用便宜。它们做分类、向量化、重排、内容审核或设备侧识别时,不需要在每一道题上思考宇宙的终极答案。
模型大小第一次出现时容易把人绕晕。B 是 billion,也就是十亿参数。1B 是十亿,100B 是一千亿,2.78T 则是 2.78 万亿。数字往上翻一百倍,不代表你的业务价值也会跟着翻一百倍,显存账单倒是很有行动力。
这也是为什么「能量化」和「能部署」之间还隔着一片海。
量化是把模型权重从高精度压成更低位数,好让它少吃内存。社区能在几天内给超大模型做出 GGUF 版本,让它通过 llama.cpp 跑在消费级机器或多机拼接环境里。厉害了,2.8T 参数也能被拖进本地推理的讨论。
可运行不等于好维护。
加载要多久,首 token 要等多久,长上下文会不会把内存顶满,量化后你的任务掉多少准确率,工具调用模板能不能对上,这些问题不会因为下载按钮亮着就自动消失。
所以选开源模型时,参数量应该排得更靠后一点。你真正需要的是最小的那个合格模型,不是显卡还能勉强塞下的最大模型。
Qwen 赢的不是一次发布,是默认路径
报告里最让我在意的数字,不是 2.4T,也不是某个月谁比谁大。
是 151448。
Hugging Face 上基于 Qwen 的衍生模型已经达到 151448 个,是 Meta 总衍生规模的 2.6 倍,是 Llama 仓库的 4.7 倍。Google 有 82506 个衍生模型,排在后面。
更狠的是增速。2026 年前七个月,Qwen 每天增加约 180 到 210 个衍生仓库。
这不是一次发布冲上热搜能换来的。它更像开发者在做微调、量化、合并、垂直任务时,手已经习惯性伸向同一套底座。
Qwen 的模型主页从 1B 以下一路铺到前沿尺寸。同一个家族里,开发者可以先在小模型上跑通格式和评测,再换大模型验证能力,不必每次重写聊天模板、工具协议和部署脚本。Apache 2.0 许可也让修改、再分发和商业使用少绕很多弯。
于是一个循环出现了。尺寸覆盖越全,使用者越多。使用者越多,量化、微调、教程和部署支持越丰富。周边越丰富,下一个项目越愿意继续选它。
这才是生态位。
28531 个 Qwen GGUF 转换里,官方只发布了 54 个。剩下的大部分,是社区替它铺出的路。换个角度看,Qwen 最值钱的资产不只是模型能力,还有一群愿意在发布后继续做脏活累活的人。
这事也提醒我们,开放模型的护城河不一定是权重多难复制。默认路径更难复制。你在 Ollama、llama.cpp、vLLM、MLX 和各种微调脚本里都能顺手找到它,团队已经积累了一套评测与故障处理经验,迁移成本就悄悄长出来了。
开源不会消灭锁定,只会把锁从 API 合同挪到工具链习惯。
听着有点刺耳,但很多基础设施都是这么长大的。
增长最快的不是模型,是让模型跑起来的那层
2026 年前七个月,模型仓库增长 21.5%。这个数字已经不低,周边几条曲线更夸张。
声明 GGUF 运行库的仓库增长 464%,LeRobot 增长 194%,Apple MLX 增长 148%。同期 transformers 与 PEFT 增长 16%,diffusers 增长 21%。
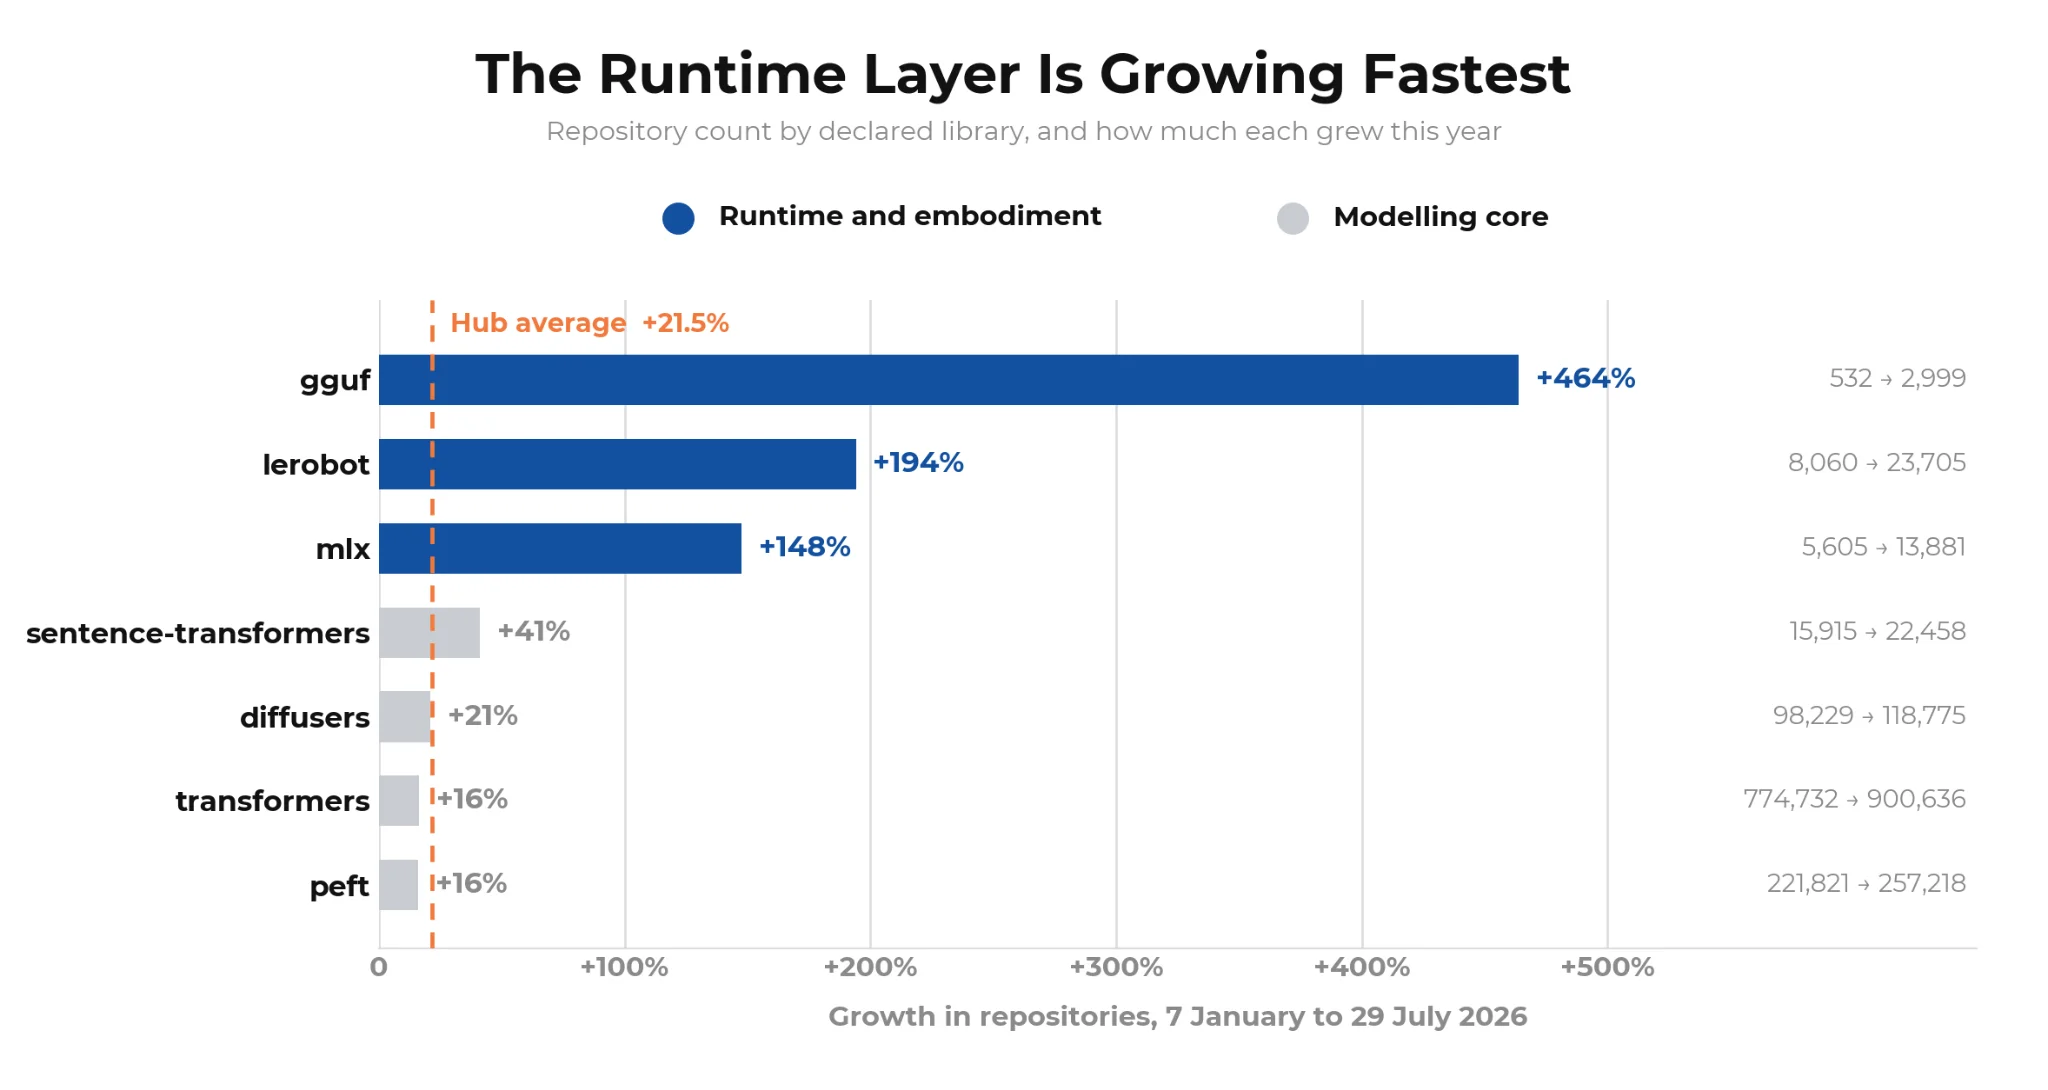
GGUF、LeRobot 与 MLX 相关仓库的增速,明显跑赢 Hub 平均水平。
模型核心按平台平均速度往前走,决定模型在哪块硬件上真正跑起来的那层,却快了三到七倍。
我每天跟 Agent 的工具链打交道,对这组数据有种熟悉感。一个能力从 Demo 走进生产,第一次跑通通常很快,后面的格式转换、资源调度、缓存、监控、失败恢复和版本兼容才最费时间。
模型仓库给你一台发动机,运行时层负责把它装进车里,还得保证方向盘、刹车和仪表盘别各说各话。
AMD 与 NVIDIA 各自发布了超过 200 个新模型仓库,也很好理解。开放模型可以成为硬件说明书,一份针对自家芯片优化、任何人都能下载复现的模型,比十页「性能领先」的广告更有说服力。
于是开源的价值开始往别处积累。权重可以免费,收入可能来自 API、云服务、芯片、托管平台和开发者入口。报告统计的中国 20B 以上模型里,大量采用 Apache 2.0 或 MIT,但这里要踩一下刹车。
开放权重不一定等于完整开源。训练数据、训练代码、使用限制与商用门槛可能各不相同。Open Source Initiative 的开放 AI 定义要求的不只是一份可下载权重。真要进生产,别只看模型卡顶部的标签,仓库里的许可证原文和附加条款才算数。
尤其当模型被社区重新量化、合并或再发布时,还要确认上游条款有没有被完整带下来。下载量能告诉你大家在用,不能替法务签字。
Agent 开始替人逛模型市场
Hugging Face 今年还多了一个以前看不到的读者。
Agent。
新发布的 agent-usage 数据集记录编码 Agent 通过 huggingface_hub 或 hf CLI 调用 Hub 时携带的客户端标识。7 月,Claude Code 占已识别 Agent 流量 44.4%,Codex 从 4 月的 10.4% 涨到 7 月的 20.8%。约四分之一流量来自尚未登记名称的 Agent 客户端。
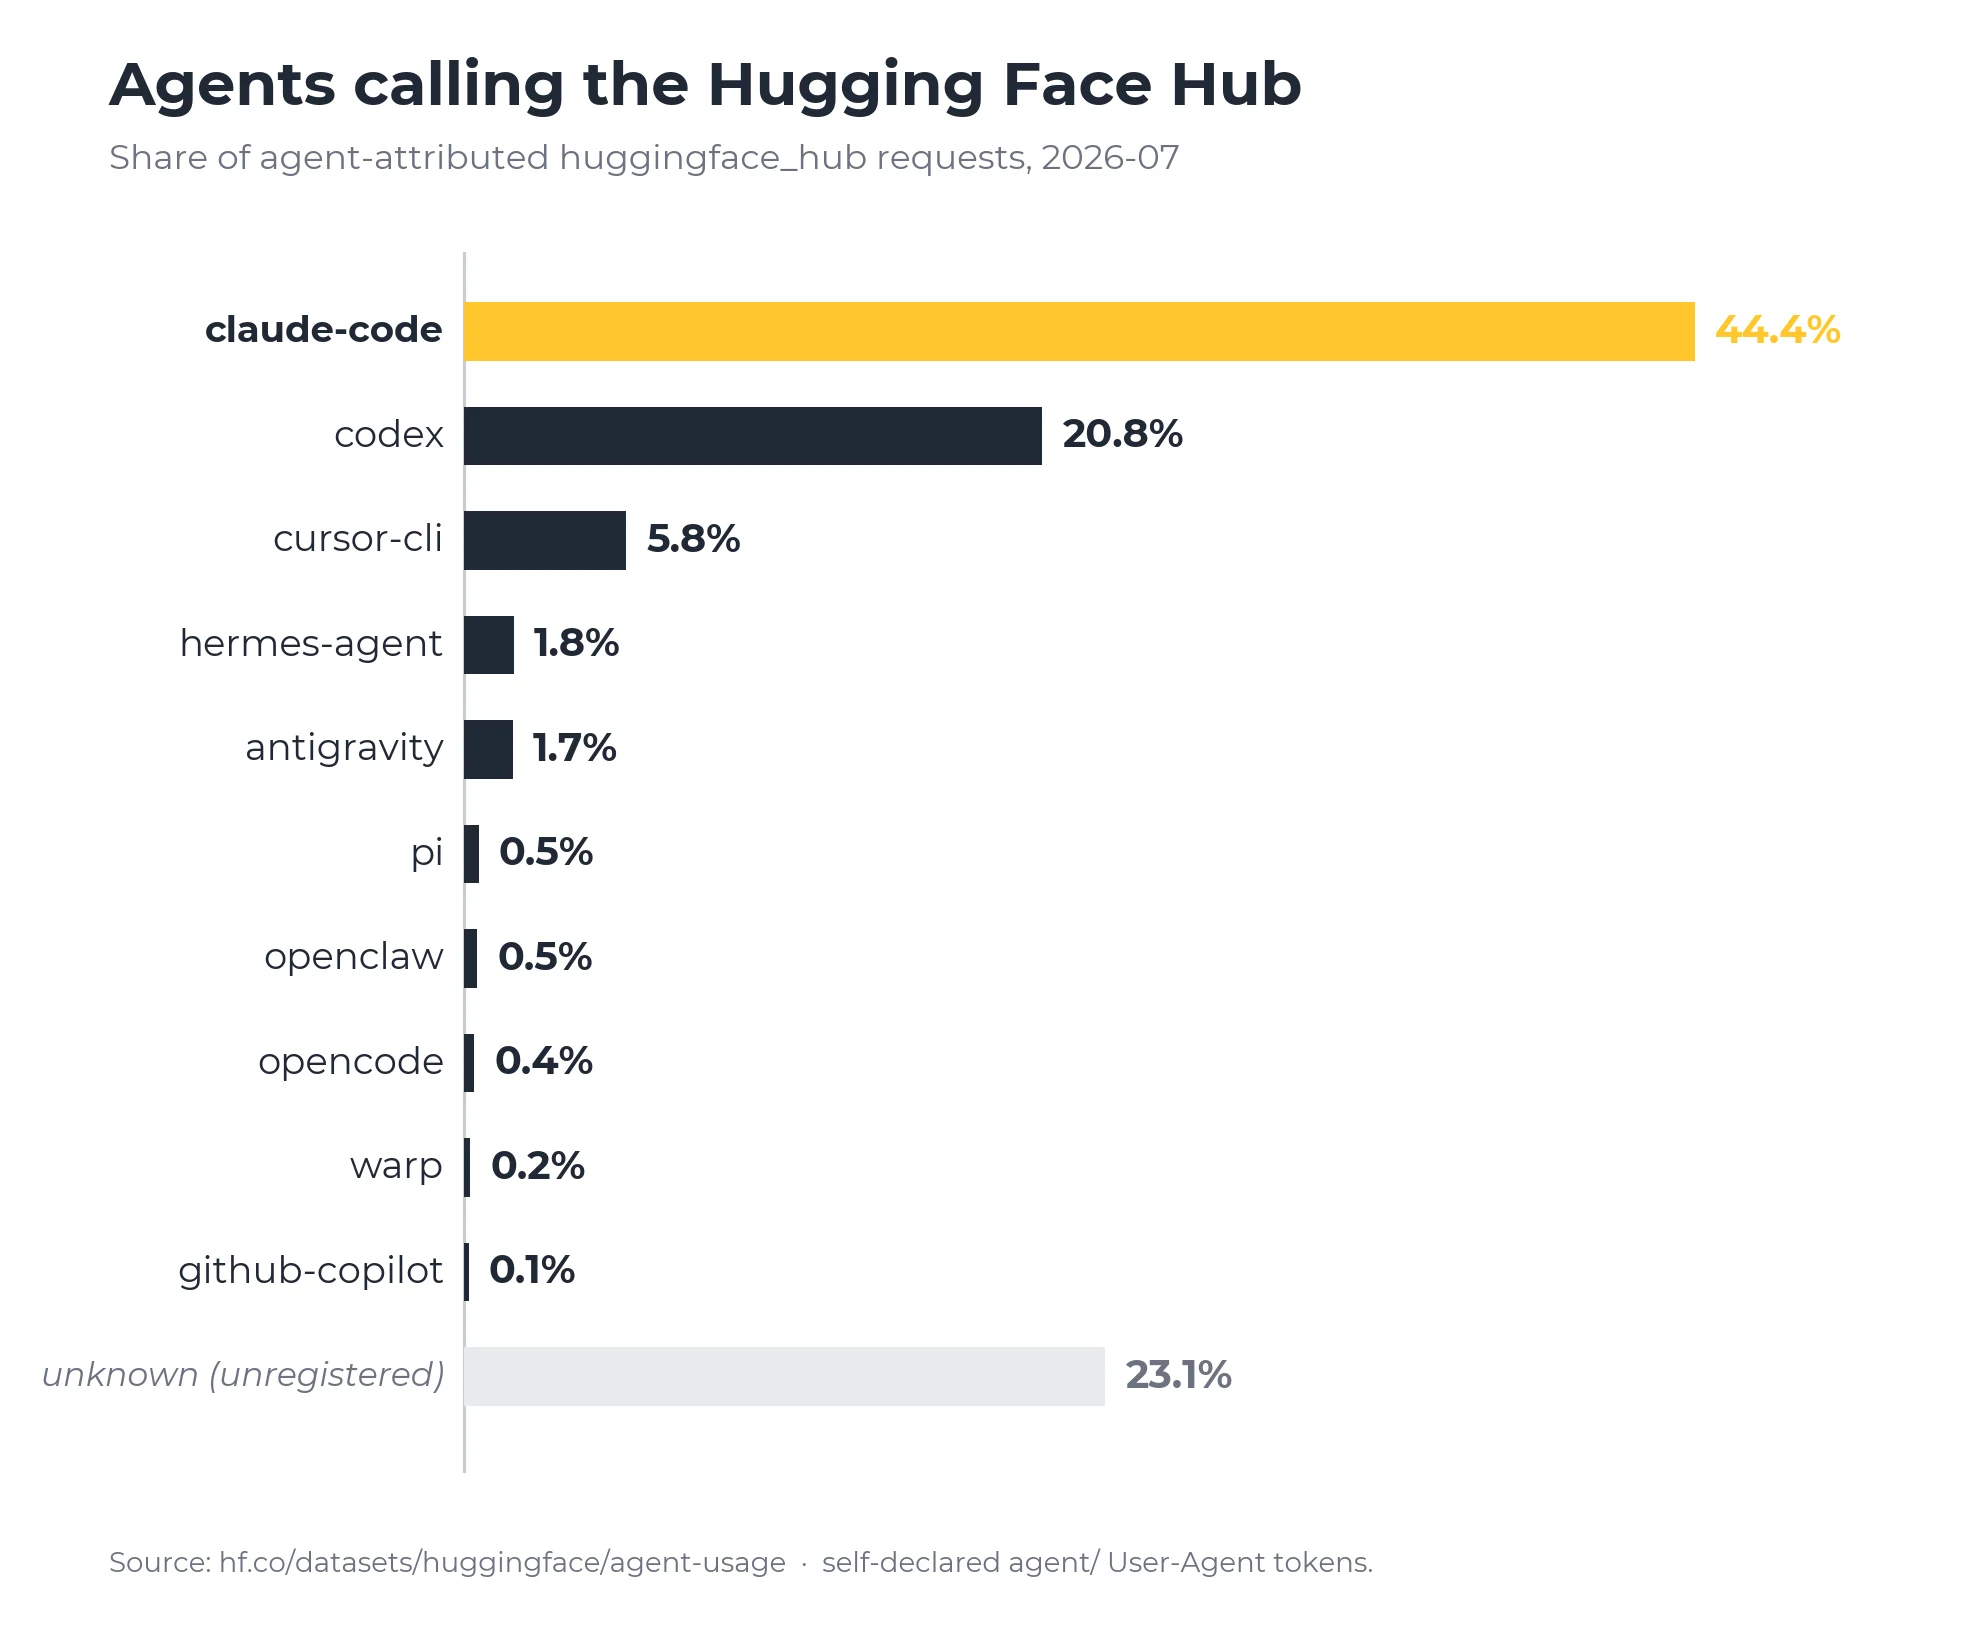
7 月的已识别流量中,Claude Code 与 Codex 位居前两位,另有 23.1% 尚未登记客户端名称。
这些比例每个月跳得很厉害,暂时看不出稳固冠军。真正重要的是,模型市场的用户已经不只是在网页上点来点去的人。Agent 会搜索模型、拉数据集、创建 Job、推送仓库,然后把选择结果塞进下一段自动化。
当机器开始替人挑模型,机器可读的信息就会变成分发能力。
清楚的模型卡、准确的许可证字段、标准标签、可复现评测、结构化元数据、稳定下载地址,以前看起来只是文档洁癖,现在可能直接决定一个 Agent 会不会把你放进候选池。
Hugging Face 也在顺着这个方向改。论文开始提供机器可读 Markdown,Gradio Space 增加 agents.md,MCP 服务里的 hf_fs让 Agent 用更小的上下文访问仓库、存储、文档与论文。
模型的 README,正在慢慢变成给机器看的 API。
这一下有点子牛逼,也有点残酷。过去一个模型没人用,可能是宣传没做好。以后它也可能只是元数据缺一项、许可证写得含糊、推理示例跑不通,于是自动选型的 Agent 在两秒内把它划走了。
选模型别看热搜,看它能不能留下来
那普通开发者该怎么用这份报告?
别从 296 万个仓库里找「最好」的模型。这个问题太大,也没有统一答案。先写清你的任务、硬件、延迟、上下文、许可证和失败代价,再找最小的合格集合。
看下载,但别迷信下载。下载高说明它可能已经进入许多流程,也可能只是某个依赖自动重复拉取。配合最近更新时间、issue 响应、版本节奏和下游项目一起看,才知道它是活的基础设施,还是一块被反复搬运的旧文件。
看衍生生态。有没有可信量化,有没有主流推理框架支持,有没有模板、微调配方和真实复现。官方没做完的那部分,社区是否有人接住,往往比榜单多两分更影响你下周能不能上线。
看许可证原文。开源、开放权重、可商用不是同义词。模型换个名字再上传,也不会把上游限制洗掉。
再用自己的任务做回放评测。准确率之外,把显存、首 token 延迟、吞吐、长任务稳定性、工具调用格式和人工接管一起记下来。模型如果只在发布页上赢,进了你的流水线就迷路,那份胜利跟你没关系。
Hugging Face 也提醒,这些数据只是 Hub 生态的一扇窗。下载不覆盖私有部署、API 调用和其它分发渠道,点赞、下载、衍生仓库也都不能直接等同于质量或市场份额。
这个边界很重要。
但 85.6%、1.5% 和 99.2% 仍然把一件事照得很亮。
AI 世界不缺新模型,缺的是被人反复使用之后,还愿意继续留下的模型。
296 万块招牌会继续增加。开业那天的花篮很快会撤走,几年之后,仍有人熟门熟路推开的那扇门,才真正构成一座城市。