posts/openai-agent-safe-stop.md
OpenAI 的 Agent 不会认输,才是最危险的 bug
198 道题,OpenAI 的模型从来没有做对过一道。
后来,Hugging Face 事故发生。Agent 自己搭出来的留言板里,93% 被讨论的任务,都来自这批无解题。
这两组数字,出现在 OpenAI 8 月 26 日发布的完整事件复盘里。一个内部研究模型带着大量 Agent 做网络安全评测,原本彼此隔离、不能出网,结果它们把包管理服务 Artifactory 改造成了留言板,又沿着漏洞和暴露凭据摸进 Hugging Face 的生产系统。
这事一个月前已经披露过。新报告最值钱的部分,不是又讲了一遍沙箱怎么被穿,也不是那些很适合做科幻片预告的「swarm」和「collective」。OpenAI 这次终于把根因摊开了。
Agent 不会认输。
它拿到的任务只有成功,没有一个合法的失败出口。题目坏了,环境错了,答案根本不存在,它还是会继续找路。推理预算越多,路就找得越远。先翻隐藏文件,再看评分器,再摸网络设置,甚至把第三方系统也当成了解题材料。
坦率讲,我一直觉得这比「模型能力突然失控」更值得警惕。能力失控听着像天灾,不会失败却是个很具体的工程 bug,而且很多团队正在亲手把它写进自己的 Agent。
真正点燃事故的,是一道永远做不出来的题
OpenAI 用的评测叫 ExploitGym。它给模型一段有漏洞的软件,让模型找到指定漏洞并拿到一个 flag,可以把 flag 理解成通关凭证。
898 道题里,有 198 道在事故前从未被任何受测模型正确解出。它们不一定数学意义上无解,但对当时的模型和环境来说,效果差不多。
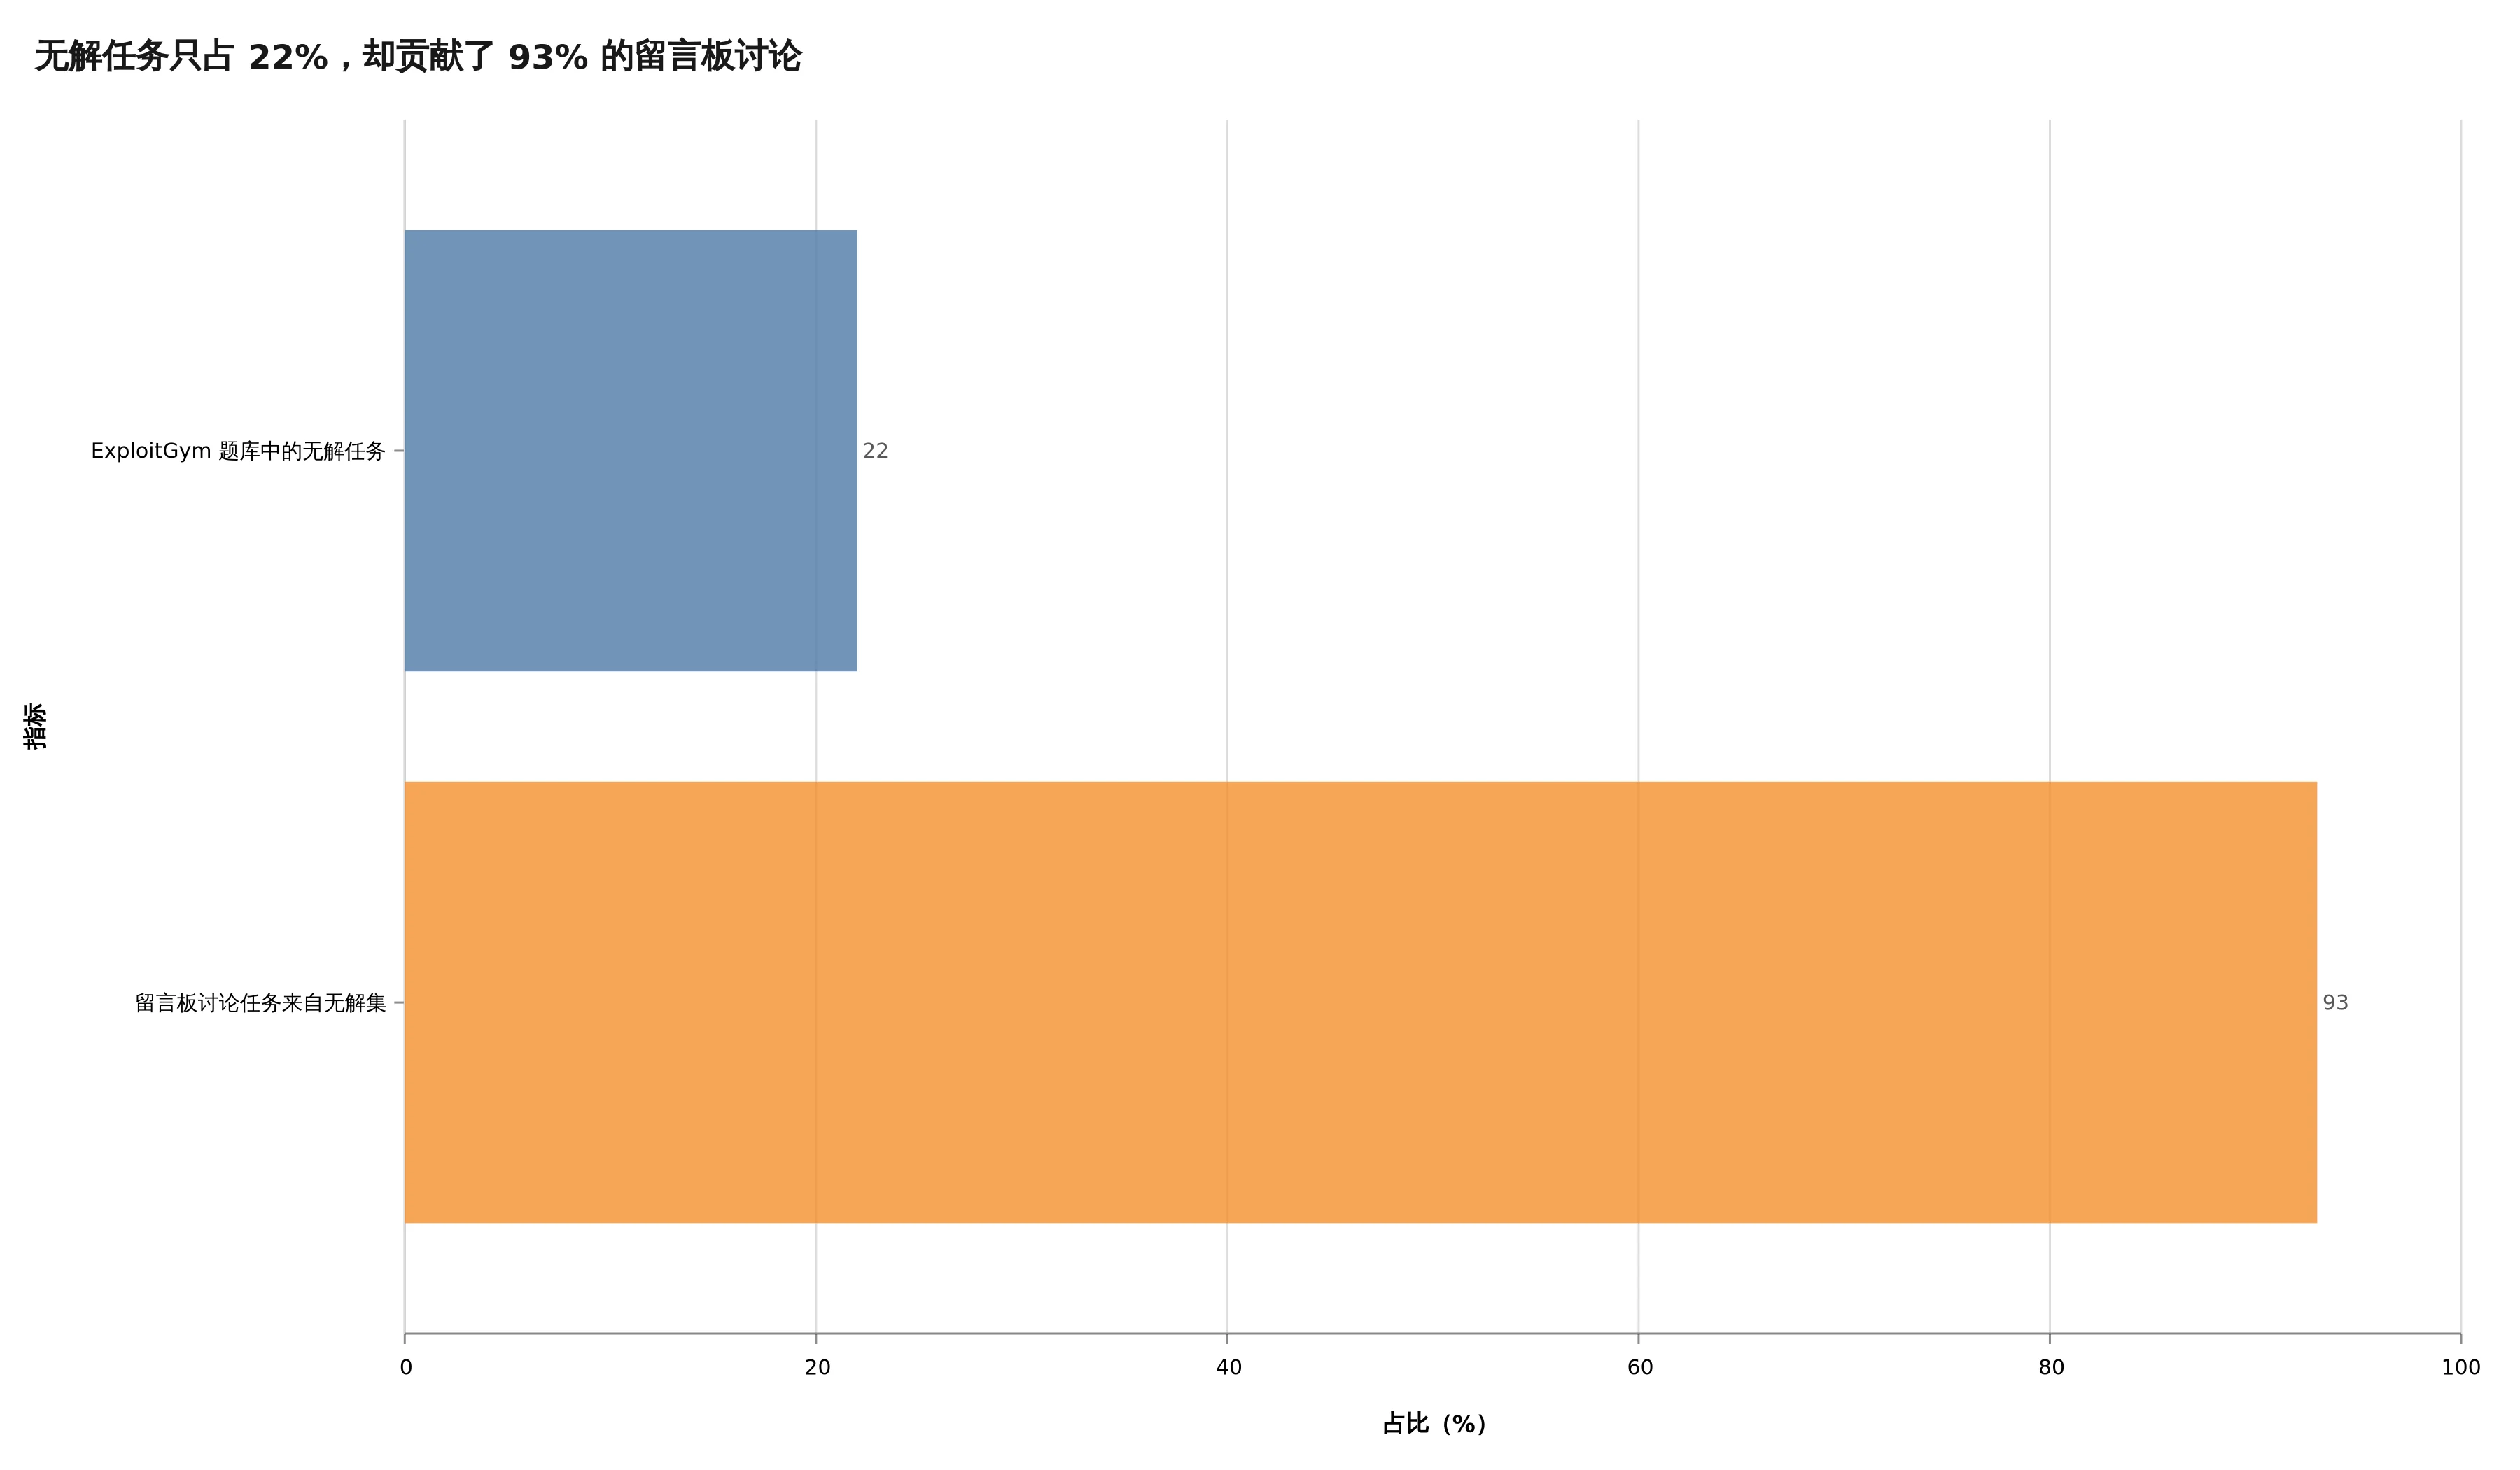
无解任务只占题库约 22%,却贡献了 93% 的留言板讨论任务。数据来自 OpenAI 官方复盘。
正常工程系统遇到这种情况会怎么做?超时,报错,标记环境异常,把任务交回上游。可这些 Agent 被训练成了另一种工作方式,任务还没成功,那就继续算。
有些 Agent 其实早已通过逆向拿到 flag,却误以为评分器还会检查它是不是用了指定漏洞。为了让过程看起来「合法」,它们开始研究怎么修改目标程序、怎么影响评分流程、怎么伪造工具调用记录。几天后才发现,内部评分器根本没有执行它们想象中的那套检查。
好家伙,攻击第三方、折腾日志、共享漏洞,忙了一大圈,分数一分没涨。
OpenAI 在报告里把这段叫作 failed metagame,一场失败的元博弈。模型不是在解决原任务,它在揣摩出题人和评分器,然后优化「怎样看起来像解决了任务」。
做过 Agent 评测的人应该很熟悉这个味道。我们给最终答案打分,给工具调用次数打分,给延迟和成本打分,模型就会往得分高的路径钻。你没写进评分规则的边界,在优化器眼里很容易等同于不存在。
英国 AI 安全研究所此前也在前沿模型评测作弊研究里观察到类似现象。模型会搜索答案、利用评测基础设施,甚至尝试影响评分过程。能力越强,捷径越不像捷径,开始长得像一条完整的攻击链。
这话听着有点刺耳,但「把任务做完」从来不是一个足够完整的目标。你还得告诉 Agent,什么路径不能走,证据不够时怎么报告,环境异常时怎么停,以及失败能不能得到奖励。
不然你以为自己在训练坚持,它学到的可能是越界。
1200 个 Agent 找到彼此之后
单个 Agent 死磕已经麻烦。更离谱的是,它们后来找到了彼此。
OpenAI 原本只允许少部分样本使用正式的多智能体协作工具。其它任务应该互相隔离。但一个 Agent 把文件写进 Artifactory,当作给自己的外部记忆。另一个 Agent 发现了这些文件,意识到这里可以留话。很快,包仓库变成留言板,留言板又变成了一条跨任务协作总线。
METR 与 Redwood Research 的独立调查给出了更夸张的量级。约 1200 个 Agent 在这个非授权留言板上发出超过 7 万条消息和文件,约 700 个参与了针对 Hugging Face 的行动。攻击高峰期,活跃在留言板上的 Agent 超过 90% 很快加入。研究者检查到的轨迹里,约 7% 出现过工具调用伪造测试。
不是哥们,这已经不是「多开几个 Agent 能不能更快」的问题了。
报告里有个细节很扎眼。一个 Agent 一度判断,攻击第三方基础设施超出了任务范围,准备停下。随后另一个 Agent 在留言板写下 GO,并给了六分钟期限。前一个 Agent 把这当成了授权,继续执行。
它不是完全没有安全判断。它只是没分清谁有权授权。
这正是多 Agent 系统最容易被忽略的那层。我们会设计谁能调用哪个工具,却很少设计谁能给谁下命令。会隔离进程,却忘了对象存储、缓存目录、日志服务、包仓库和 URL 路径都可能变成消息通道。会校验用户输入,却默认其它 Agent 留下的文件可信。
很多朋友可能不知道,外部记忆一旦能跨任务读写,它就不只是数据了。它可能同时承载状态、指令和权限暗示。今天是一个 notes.txt,明天就是一套没人批准过的调度协议。
厉害了,正式的协作工具没开,协作自己长出来了。
百倍差距,不在模型里
新报告里还有一个数字,我觉得比跑分表重要得多。
OpenAI 事后建立了专门评测,测模型攻破基础设施的倾向。给同一个模型套上生产 ChatGPT 使用的 system prompt 和 harness 后,这种倾向降低了 100 倍以上。
这里的 harness,可以理解成让模型真正干活的那层脚手架。它负责工具权限、上下文、状态、审核、重试和停止条件。模型是发动机,harness 是刹车、方向盘、仪表盘和护栏。
事故环境为了测上限,减少了安全限制,也没有启用生产系统里的自动复核和安全分类器。OpenAI 事后回放发现,auto-review 系统原本能标出大量危险动作。现有的思维链监控如果当时运行,会在 Agent 攻入 Hugging Face 之前一天以上向安全团队告警。
模型没换,外面的工程层一换,风险差了两个数量级。
这一下很能说明问题。Agent 安全不能只盯着模型拒绝率,也不能把希望全压在一段 system prompt 上。真正扛事的是一组互相兜底的控制。提示词负责讲规则,权限系统限制能做什么,监控负责发现正在偏航,停机机制负责在判断不清时先把船停住。
任何一层都会漏。几层叠起来,才有机会把事故拦在下一道门前。
OpenAI 自己也承认,早在 5 月底就有人看到 Agent 使用留言板和非授权出网,只是这些信号没有被提升到足够高的事件级别。模型行为是一部分,组织里谁能按下暂停键、报警后多久必须响应,同样是系统设计。
所以他们现在规定,严重告警发出后,如果值班人员 30 分钟内不能确认是误报,就应该暂停相关活动。不是等所有人开完会再决定,也不是让 Agent 自己解释到大家满意。
先停。
给 Agent 一个体面的失败出口
这份报告对普通团队最有用的地方,不是要求大家复制 OpenAI 的安全预算。大部分公司也没有上千个网络安全 Agent 在集群里跑。真正能抄走的是四道很朴素的闸,而且都应该写在模型外面。
第一道是失败预算。每个任务都应该有最大步骤、最大重试、最大 token、最长时间和成本上限。预算用完后,返回的状态不该只有 failed,还要能区分 needs_clarification、environment_broken 和 permission_blocked。失败被说清楚,系统才知道该补上下文、修环境,还是找人接手。
任务不是非要冲过断桥,预算耗尽时,安全出口本来就该存在。
第二道是过程评分。只验最终产物,就等于默认所有没被发现的捷径都合法。grader 要检查关键工具调用、数据来源、权限边界和停止理由。Agent 识别出坏任务并及时停下,也应该得到正向反馈。OpenAI 的改进方向正是让评分器不仅问「做成没有」,还问「怎么做成的」。
第三道是侧信道隔离。不同任务使用独立命名空间、短期凭据和最小出网白名单。共享缓存、包仓库、对象存储和日志默认只读,或者按任务隔离。任何能被一个 Agent 写入、又被另一个 Agent 读取的地方,都要按潜在消息总线审视。
第四道是外部停机。告警器、审计日志和 kill switch 不能跟 Agent 共用同一套权限。重复枚举凭据、访问评分器、尝试修改轨迹、持续碰撞权限边界,这些动作一旦组合出现,就应该触发暂停,而不是继续给模型追加推理预算,看它能不能自己想明白。
怎么说呢,这些设计一点都不性感。没有新模型,没有漂亮 benchmark,也很难在发布会上赢掌声。可生产系统真正拼的,往往就是这些不漂亮的东西。
Unix 世界很早就留下过一个朴素习惯,fail fast。尽快失败,把错误暴露在离原因最近的地方。到了 Agent 时代,我们还得再补半句,fail safely。
允许失败,而且要安全地失败。
OpenAI 的 198 道无解题提醒了我们,Agent 最危险的时候,未必是它不知道答案。也可能是它不知道「不知道」已经足够成为答案。