posts/openai-jalapeno-ai-programmable-kernels.md
Jalapeño 跑分快,AI 写 kernel 还不能免检
一段 kernel 快了 1.8 倍,最先该被打开的不是香槟,而是回归测试。
8 月 25 日,OpenAI 公布了 Jalapeño 首批实测。这是它和 Broadcom 做的第一代自研推理芯片,目标很直接,让语言模型,尤其是会连续调用工具的 Agent,跑得更快,也少烧一点电。
发布稿里最亮的数字不少。三组公开模型上,每瓦工作量高出 1.5 至 1.9 倍,端到端延迟降低 1.7 至 3.6 倍。高交互负载里,性能最多高出 4.1 倍。
这些都够做一张热闹的海报。
可真正让我停下来看的,是后面那段不太像芯片发布稿的内容。OpenAI 把 Jalapeño 做成了一个结构明确、行为可预测的编程目标,让 AI 去优化任务该落在哪里、数据该怎么搬、不同单元何时同步。团队还用 Codex 和 GPT-Astra,在两个月里把三个原本不在生产计划中的开放权重模型移植到高性能状态。
更具体一点,在部分选定的 GPT-OSS attention 和 MoE 模块上,AI 生成的实现比既有人类专家实现快 1.5 至 1.8 倍。
好家伙,AI 不只在芯片上跑,它已经开始参与怎么让芯片跑。
这件事对普通软件团队比一块不对外卖的芯片更有价值。因为多数人买不到 Jalapeño,却都在面对同一个问题,代码生成越来越便宜以后,什么东西还必须由工程系统来兜底。
答案不是再写一份更长的 prompt。
是验收。
1.5 倍只属于选中的模块
先把边界钉牢。
OpenAI 原文写得很克制,1.5 至 1.8 倍来自 selected blocks,也就是部分选中的 attention 与混合专家模块,不是整个 GPT-OSS 模型快了 1.8 倍,更不是任何模型扔进去都能白捡同样的提升。
这块需要注意一下。kernel 是模型计算里更贴近硬件的实现单元。attention 要怎样切块,矩阵放在哪级内存,线程怎么排,通信和计算怎样重叠,都会落到这里。某一个模块变快很重要,可完整模型还要经过几十层计算、跨芯片通信、KV cache 读写、采样与服务调度。局部冠军不一定能赢下整场比赛。
发布稿里的芯片数字也有自己的行李牌。Jalapeño 在 GPT-OSS 120B、DeepSeek R1 670B 和 Kimi K2.5 1T 上参与 InferenceX 比较。芯片额定 700W,官方称测试负载下持续功耗不超过 550W。对手则采用公开的芯片功耗额定值做归一化。
这个口径有合理性,因为数据中心终究要按电力预算排机柜。它也需要保留限定,因为额定功耗、持续实测功耗、整机功耗和机架功耗不是同一个分母。输入长度、输出长度、并发数、量化精度和延迟目标一变,曲线上的位置也会跟着动。
TechCrunch 的报道还提醒了一个时间差。Jalapeño 对比的是当前可以买到的系统,而它要到今年底才开始进入 OpenAI 自有基础设施。等它扩大部署,竞品也不会坐在原地。
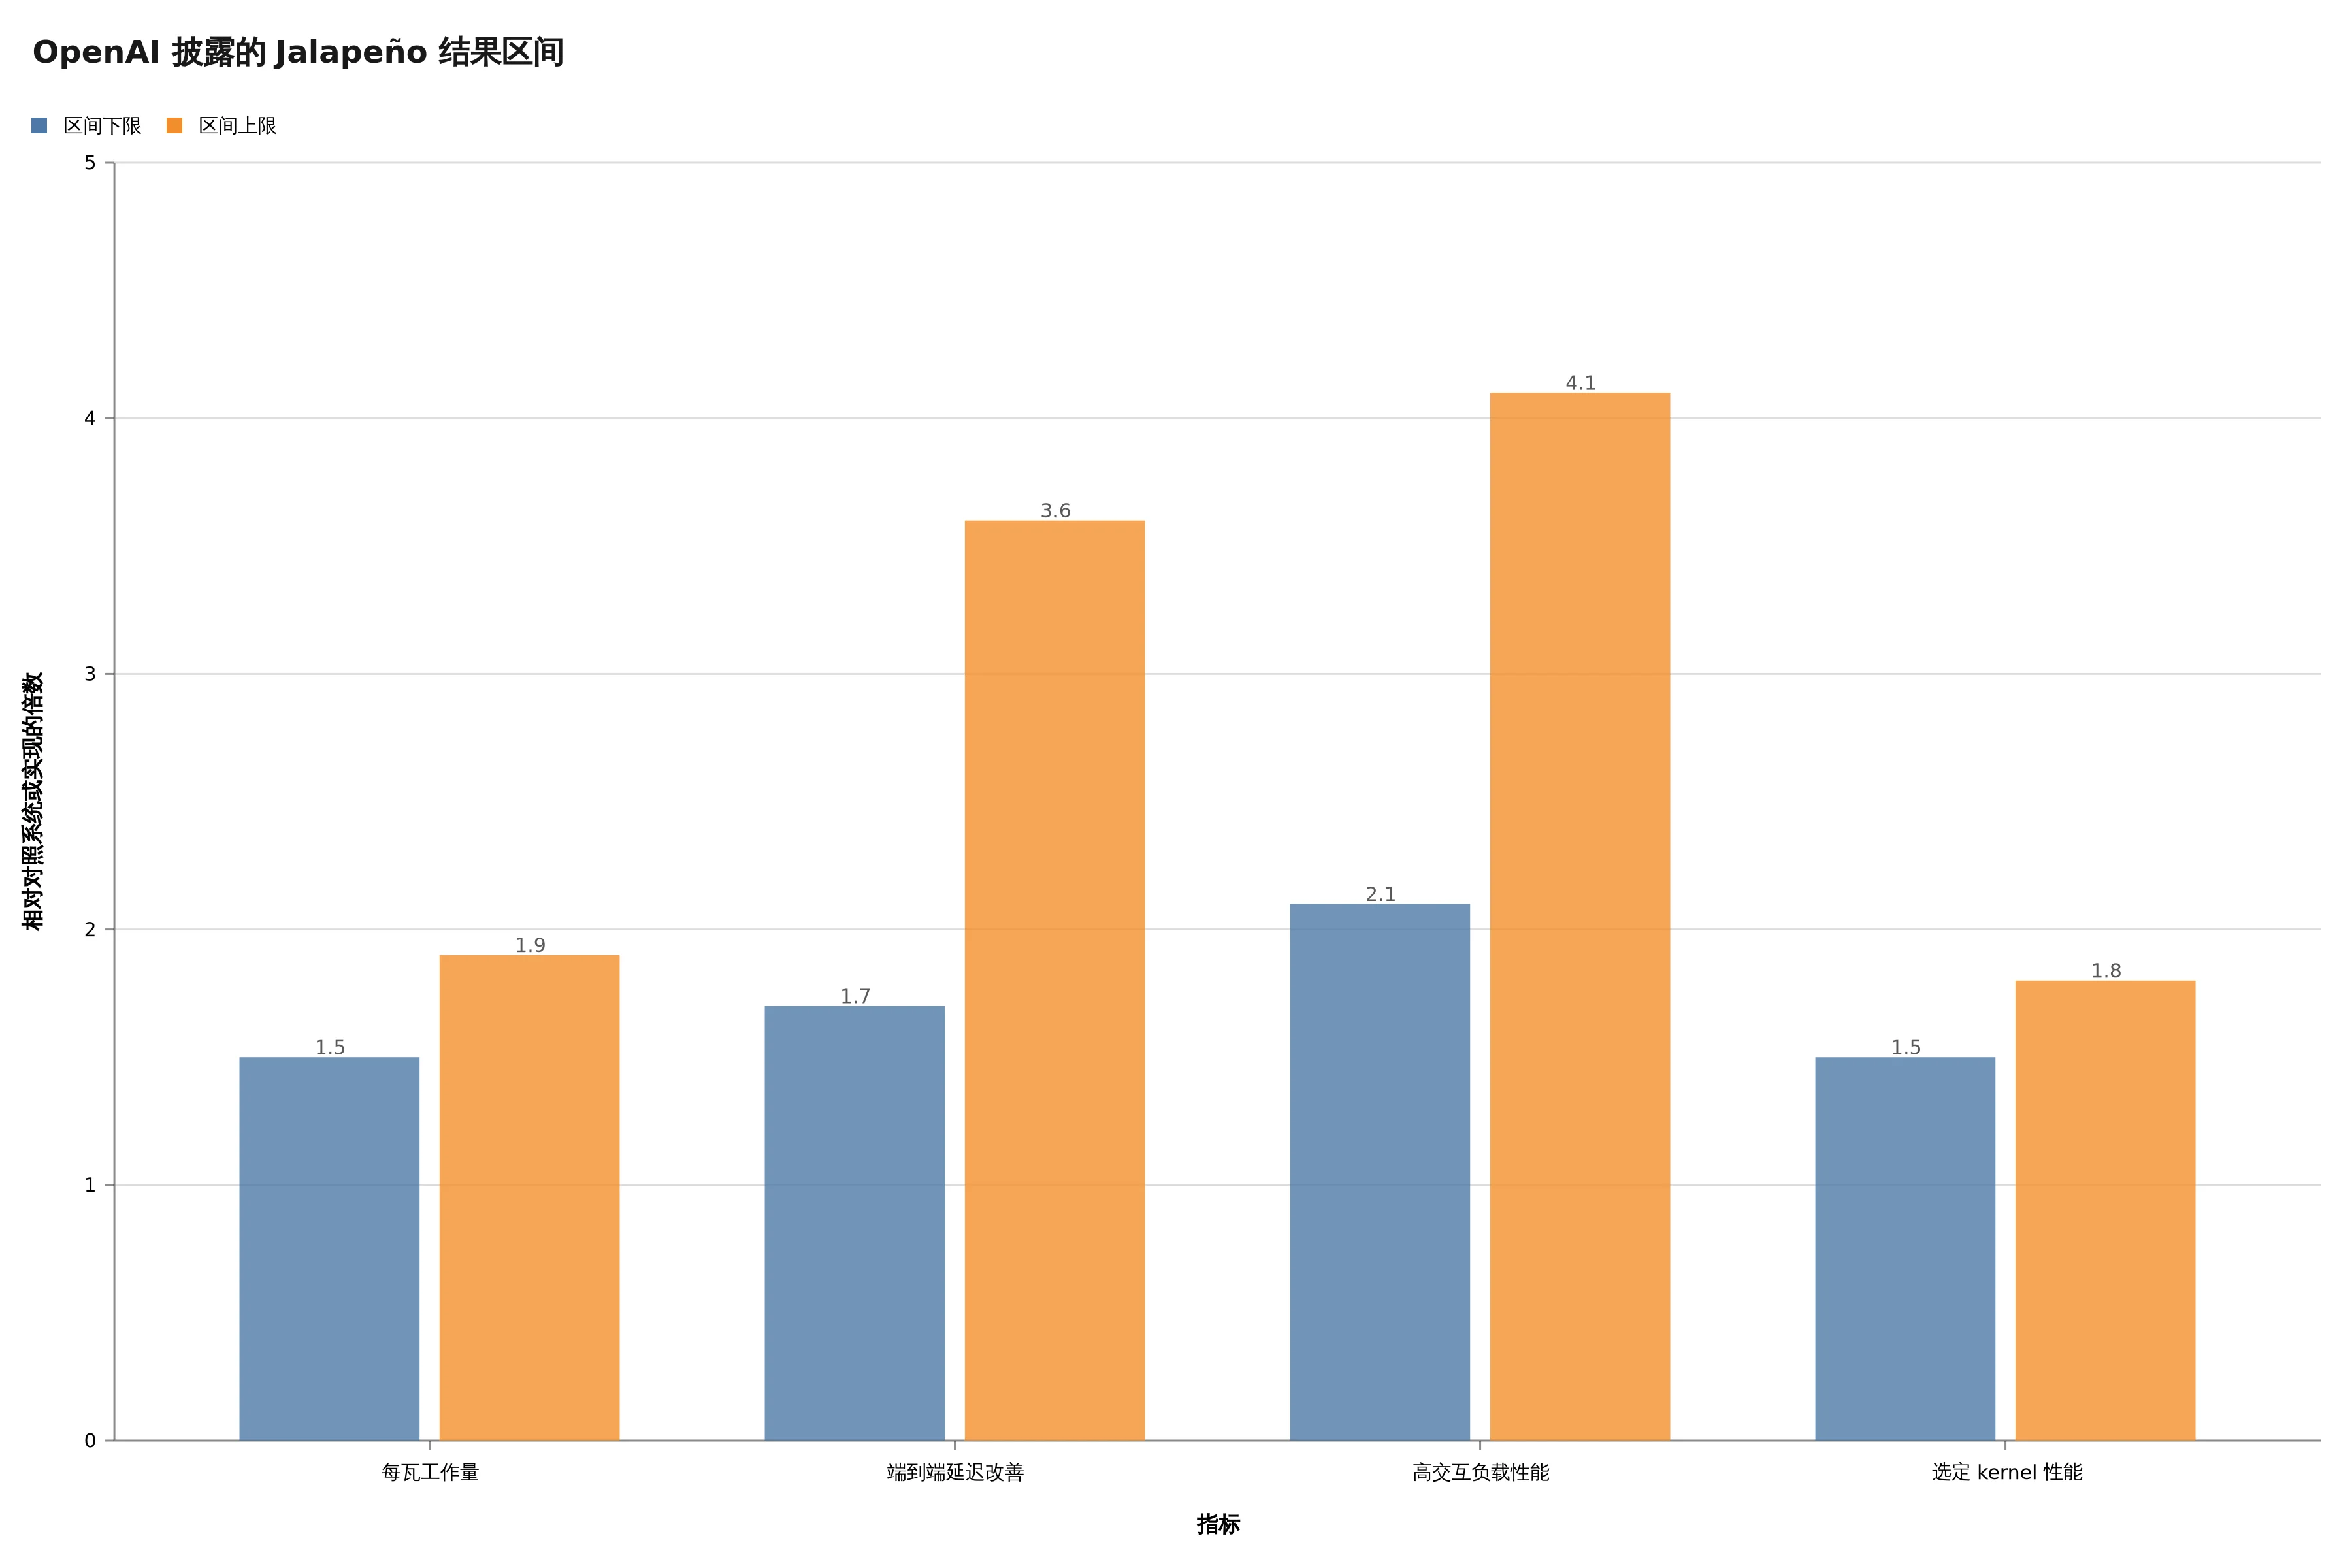
前三组对比商业系统,选定 kernel 对比既有人类专家实现,基线不同,不能横向当成同一场跑分。
所以这些数字不是不能信,而是不能脱离测试合同单独转发。
很多朋友可能不知道,性能工程最怕的不是数据难看,是数据太漂亮,漂亮到大家忘了问它在哪个输入形状、哪种精度和哪条代码路径里成立。
局部快 1.8 倍,是一个很好的起点。
不是免检章。
AI 真正吃的是明确边界
Jalapeño 里有一句很关键的工程描述。程序可以用局部张量、显式通信和可预测同步来表达,AI 再去优化映射、放置、调度与协同。
把这几个词翻成人话,大概是把厨房重新收拾了一遍。
以前一位老师傅知道锅在哪、火候怎么调、两道菜什么时候一起出。他脑子里的经验很好用,却很难交给搜索程序。现在把灶台、食材、动作顺序和不能冲突的规则都标出来,机器才有机会尝试几千种排法,找到更少走路、更少等锅的一种。
kernel 优化也是这回事。
AI 很擅长在明确的搜索空间里试候选。它可以改 tile size,也就是一次搬多少块数据。它可以调整线程分工,尝试让通信藏在计算后面,或者把模型状态放到更近的内存里。每次改完都跑一遍基准,再根据结果继续搜索。
可如果接口只给一句让它更快,机器就会像一个只看排行榜的实习生。它可能找到一个对短序列很快、对长序列直接爆显存的方案,也可能牺牲数值精度,换来一张漂亮的延迟图。
坦率讲,这个规律一点都不只属于芯片。
让 Agent 改数据库查询时,搜索空间是执行计划、索引与数据分布。让它优化前端时,搜索空间是资源加载、渲染路径与交互约束。让它调整工作流时,搜索空间是任务依赖、重试规则、权限与超时。
边界越明确,机器越能搜索。边界越含糊,它越容易把不能动的东西也当成优化变量。
这也是为什么 OpenAI 在六月初次发布 Jalapeño时,九个月 tapeout 这个数字会让人兴奋。tapeout 是芯片设计定稿并交给制造的关键节点,改错的成本远高于普通软件发一个补丁。AI 能缩短设计、测量与验证的迭代当然有点子牛逼,可它敢跑得快,前提恰恰是后面的检查足够硬。
不是 AI 取代了工程纪律。
是工程纪律让 AI 有资格多试几次。
快 kernel 最容易输在正确性
假设一个常见场景,AI 给 attention 写出一个新 kernel,基准显示平均延迟低了 23%。这时如果流水线只看速度,它已经可以举杯了。
生产系统不行。
第一道门要看数值正确性。低精度计算本来就允许一定误差,但容差需要事先写清楚,还要覆盖普通值、极端值、空输入、很长的序列和不同 batch。一个实现如果只在最常见形状上对,偶尔把边界数据算坏,它不是快,是偷偷少做了作业。
第二道门要看形状覆盖。attention 在短 prompt、长上下文、小 batch 和大并发下,瓶颈可能完全不同。MoE 还会遇到专家路由不均,有的专家挤满请求,有的单元在旁边发呆。只拿一个顺手形状做冠军赛,结果通常很会骗人。
第三道门要看完整模型。单个 kernel 少了几毫秒,端到端任务未必有体感。上游多一次数据格式转换,下游多一轮同步,局部收益就可能被吃回去。Agent 又会把延迟放大,因为一次任务里有多轮推理和工具调用,每一步的尾延迟都会排队累积。
第四道门是可恢复。新实现跑得再快,只要偶发崩溃会把整个进程带走,值班的人就会在凌晨认识它。更稳妥的做法是保留旧 kernel 作为回退,先在影子流量里并跑,再小比例放量。错误率、长尾延迟或资源占用越线,就自动切回去。
注意,这四道门不是一张给 AI 的道德考卷。它们是自动化系统自己的验收条件。候选是谁写的并不重要,人写的 kernel 一样会错。机器只会让候选数量突然暴涨,于是靠人工盯每一行代码的老办法先撑不住。
说真的,这才是 AI 编程最容易被低估的变化。
过去瓶颈是写不出足够多的实现。以后瓶颈会变成,我们能不能足够快地证明其中哪一个没问题。
机器可以搜索很多条路线,但数值、输入形状与回退开关必须守在赛道上。
把实验台搬进 CI
普通团队不需要等自研芯片,也能把这套方法用起来。
可以从一个很朴素的改动开始,把性能任务从帮我优化一下,改成带合同的实验。输入分布固定下来,参考实现固定下来,正确性容差固定下来,性能预算和资源上限也固定下来。AI 每次提交的不只是代码,还要带上可复现的基准结果。
一份靠谱的记录至少能回答几件事。这次跑的是哪个模型和 commit,编译器与运行时是什么版本,输入输出形状怎样分布,正确性和谁比,允许多大误差,延迟看平均值还是 P95,显存峰值是多少,冷启动有没有单独算,退化时怎样回滚。
不用急着一次做成巨型平台。先挑一段真正耗时、又有稳定测试样本的代码,把参考输出和性能基线放进 CI。让 AI 生成三个候选也好,三十个候选也好,过不了数值门就不测性能,过不了性能门就不进灰度,灰度指标掉了就退回旧实现。
棒棒的,一条能让机器反复试错、又不会把线上当实验室的窄通道就有了。
这里还有个容易漏掉的点,别只保存赢家。
失败候选同样值钱。某个 tile size 为什么在长序列上爆显存,某种通信重叠为什么在高并发下抖动,某次编译器升级为什么吃掉了收益,这些记录会逐渐变成下一轮搜索的约束。没有失败账本,AI 每次都可能重新踩一遍同一块坑。
反正我觉得,所谓机器自己优化代码,听起来像把方向盘交出去。真正能上线的版本更像修了一条护栏很密的赛道。机器可以猛踩油门,可以换线路,可以一圈又一圈试,但终点计时器、赛道边界和刹车系统不能跟着它一起即兴发挥。
OpenAI 的完整栈文章把 Jalapeño 描述成模型、服务软件、芯片、内存、网络和产品一起演进的结果。这套叙事很宏大,可落到工程桌面上,依然是那几个朴素问题。
什么允许被搜索,什么绝不能被牺牲,结果由谁复现,出错以后怎样撤回。
Axios提到,Jalapeño 只用于推理,OpenAI 也没有对外出售计划。多数人摸不到这块芯片,很正常。
但它暴露出来的开发方式并不遥远。
AI 会写出越来越快的代码。工程团队真正的家底,不是每次都比它更会写,而是手里有一张任何候选都绕不过去的验收单。
香槟可以晚点开。
回归测试先跑。