posts/openrouter-agent-cost-observability.md
Agent 成本只按模型统计,方向就错了
每月 6200 美元,单价大约是团队平均水平的 25 倍,98% 的支出来自同一条批处理流水线。
最终怎么修的?
换了一行模型配置。
这是 OpenRouter 在新发布的 Activity 仪表盘里给出的内部案例。一个预览模型被塞进了根本不需要前沿能力的任务里,费用安安静静地烧了一个月,直到他们顺着用量图钻进 API key 和具体流水线,才把这只吞钱兽揪出来。
好家伙,最贵的事故没有报错,没有宕机,甚至可能每天都按时返回 200。
这类事故很像 agent 时代的新型内存泄漏。代码能跑,结果也能交付,只是成本在后台一点点往上爬。等财务把月账单发过来,工程团队通常会先做那个最顺手的动作,按模型排序,然后问一句,哪个模型太贵了?
我觉得从这一步开始,方向就偏了。
模型当然有价格差,但 agent 的成本很少由模型名单单独决定。更常见的情况是,同一个任务被重试了三次,fallback 又换了两家提供商,工具返回一大坨无用 JSON,下一轮上下文因此多塞了两万 token。缓存原本能命中,偏偏中间插进一个不断变化的时间戳,整段前缀重新计费。
最终账单上只写着某个模型花了多少钱。
可模型只是收银台,不是购物清单。
总账单没撒谎,它只是回答得不够细
OpenRouter 这次把 Overview 做得挺完整。总支出、请求数、token 总量、缓存命中率、每百万 token 综合成本都摆在顶部,下面还能看主要用户、应用、模型、BYOK 支出和缓存情况。
这些数字适合回答管理问题。今天比昨天贵了多少,哪个 workspace 增长最快,某个新模型是不是正在扩散。
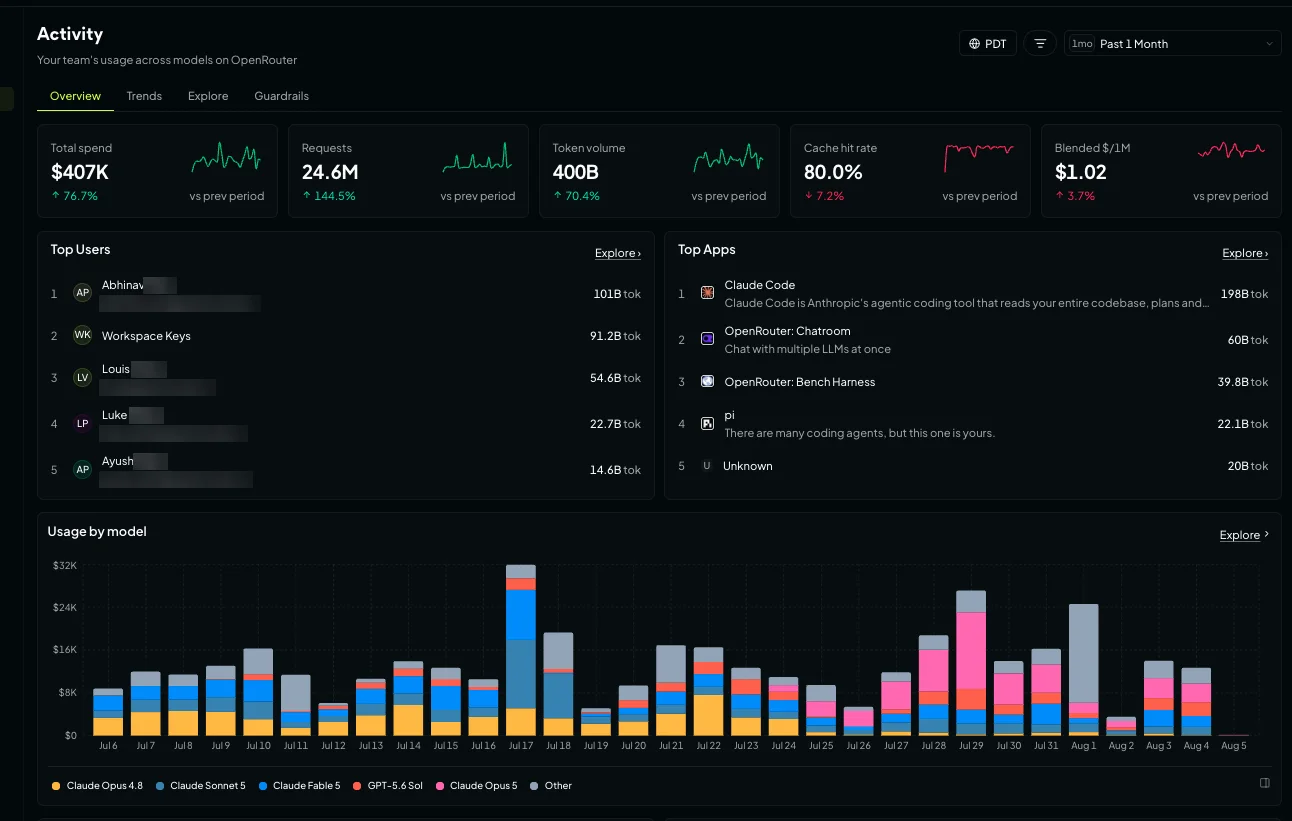
但工程问题通常藏在下一层。
为什么周二的费用突然抬头?为什么同一个模型在客服流水线里很省,到了代码审查流水线就贵三倍?为什么请求量没有明显变化,prompt token 却开始膨胀?
新仪表盘有个关键设计,图表里的任何柱子、切片和排名行都能继续钻到 具体请求日志。单条 Generation 详情会把上游推理、缓存、网页搜索、文件处理、折扣、provider latency、fallback、finish reason、API key、session ID 和 metadata 摊开。
厉害了,这才是能排障的颗粒度。
很多成本看板的问题,不是数据不够多,而是聚合之后回不到现场。它告诉你某模型一天烧了 800 美元,却不告诉你其中 300 美元是超时后自动重试,200 美元来自一次错误的 fallback,剩下那部分又有多少最终产出了用户真正拿到的结果。
不能回到单条请求,成本分析就只能停在猜。
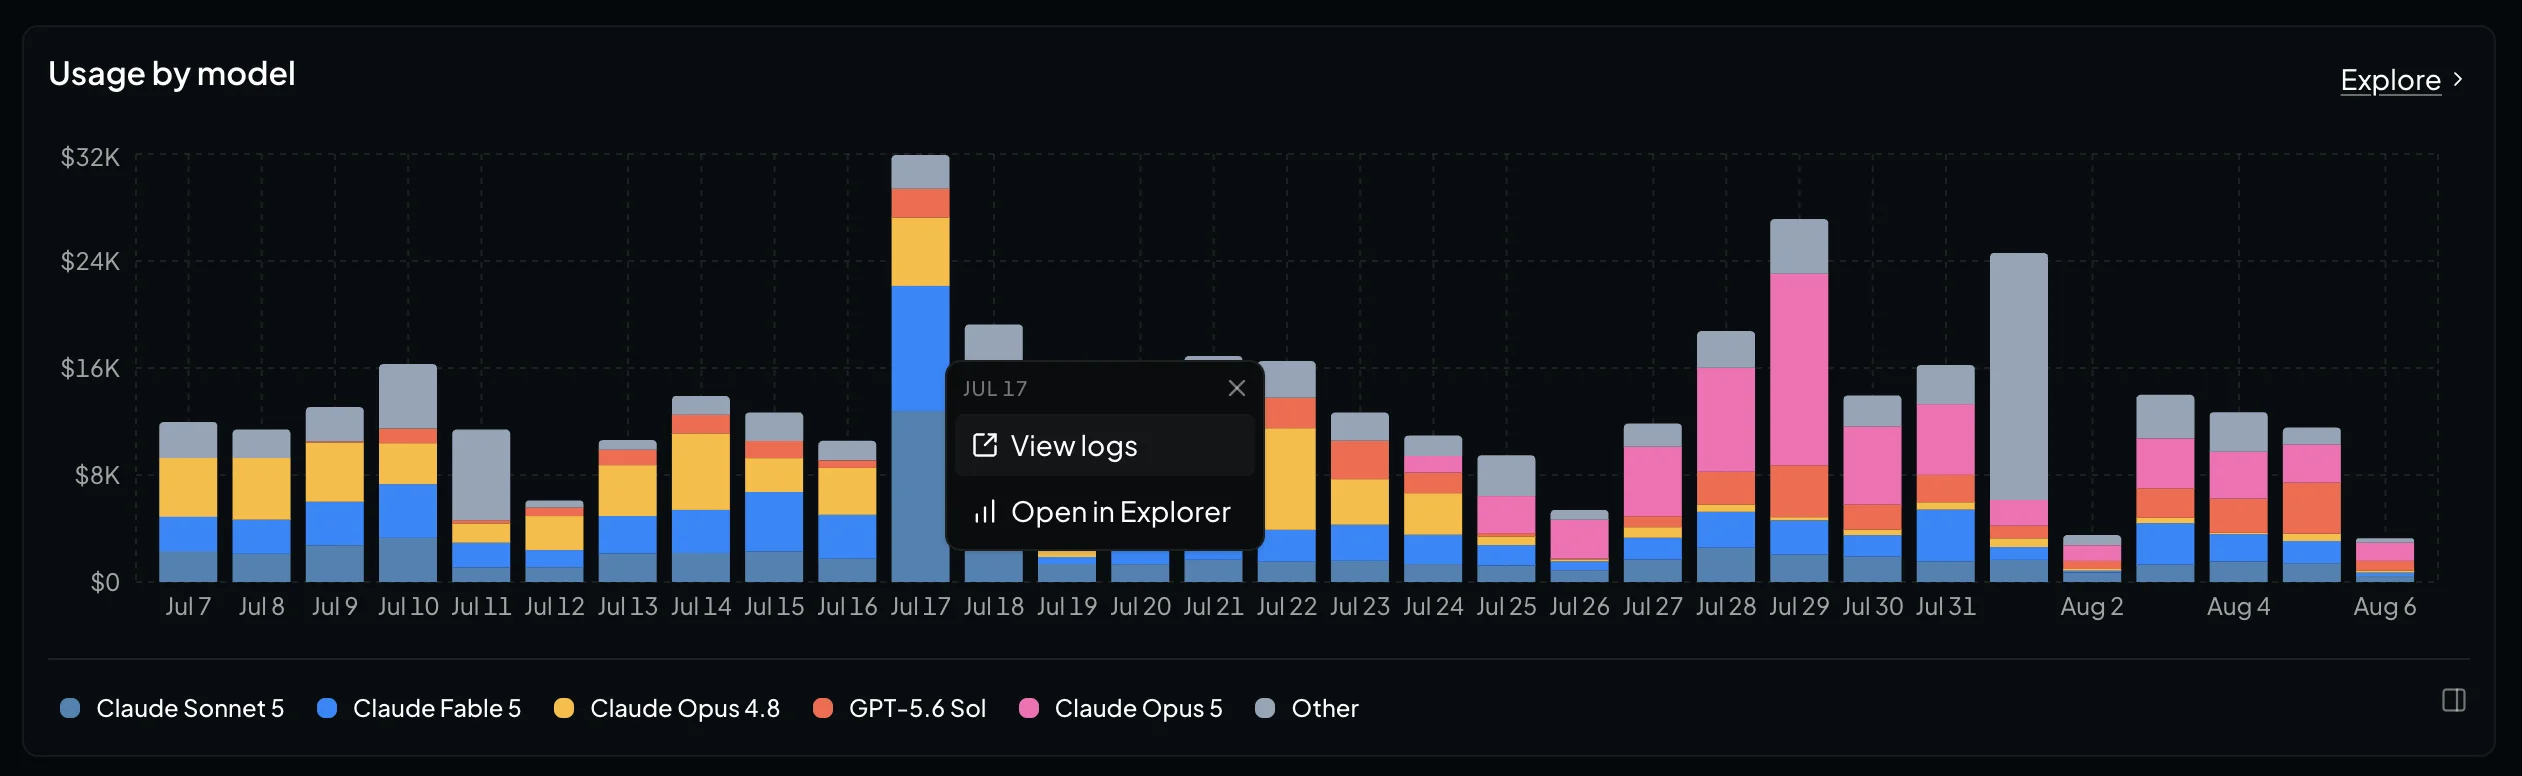
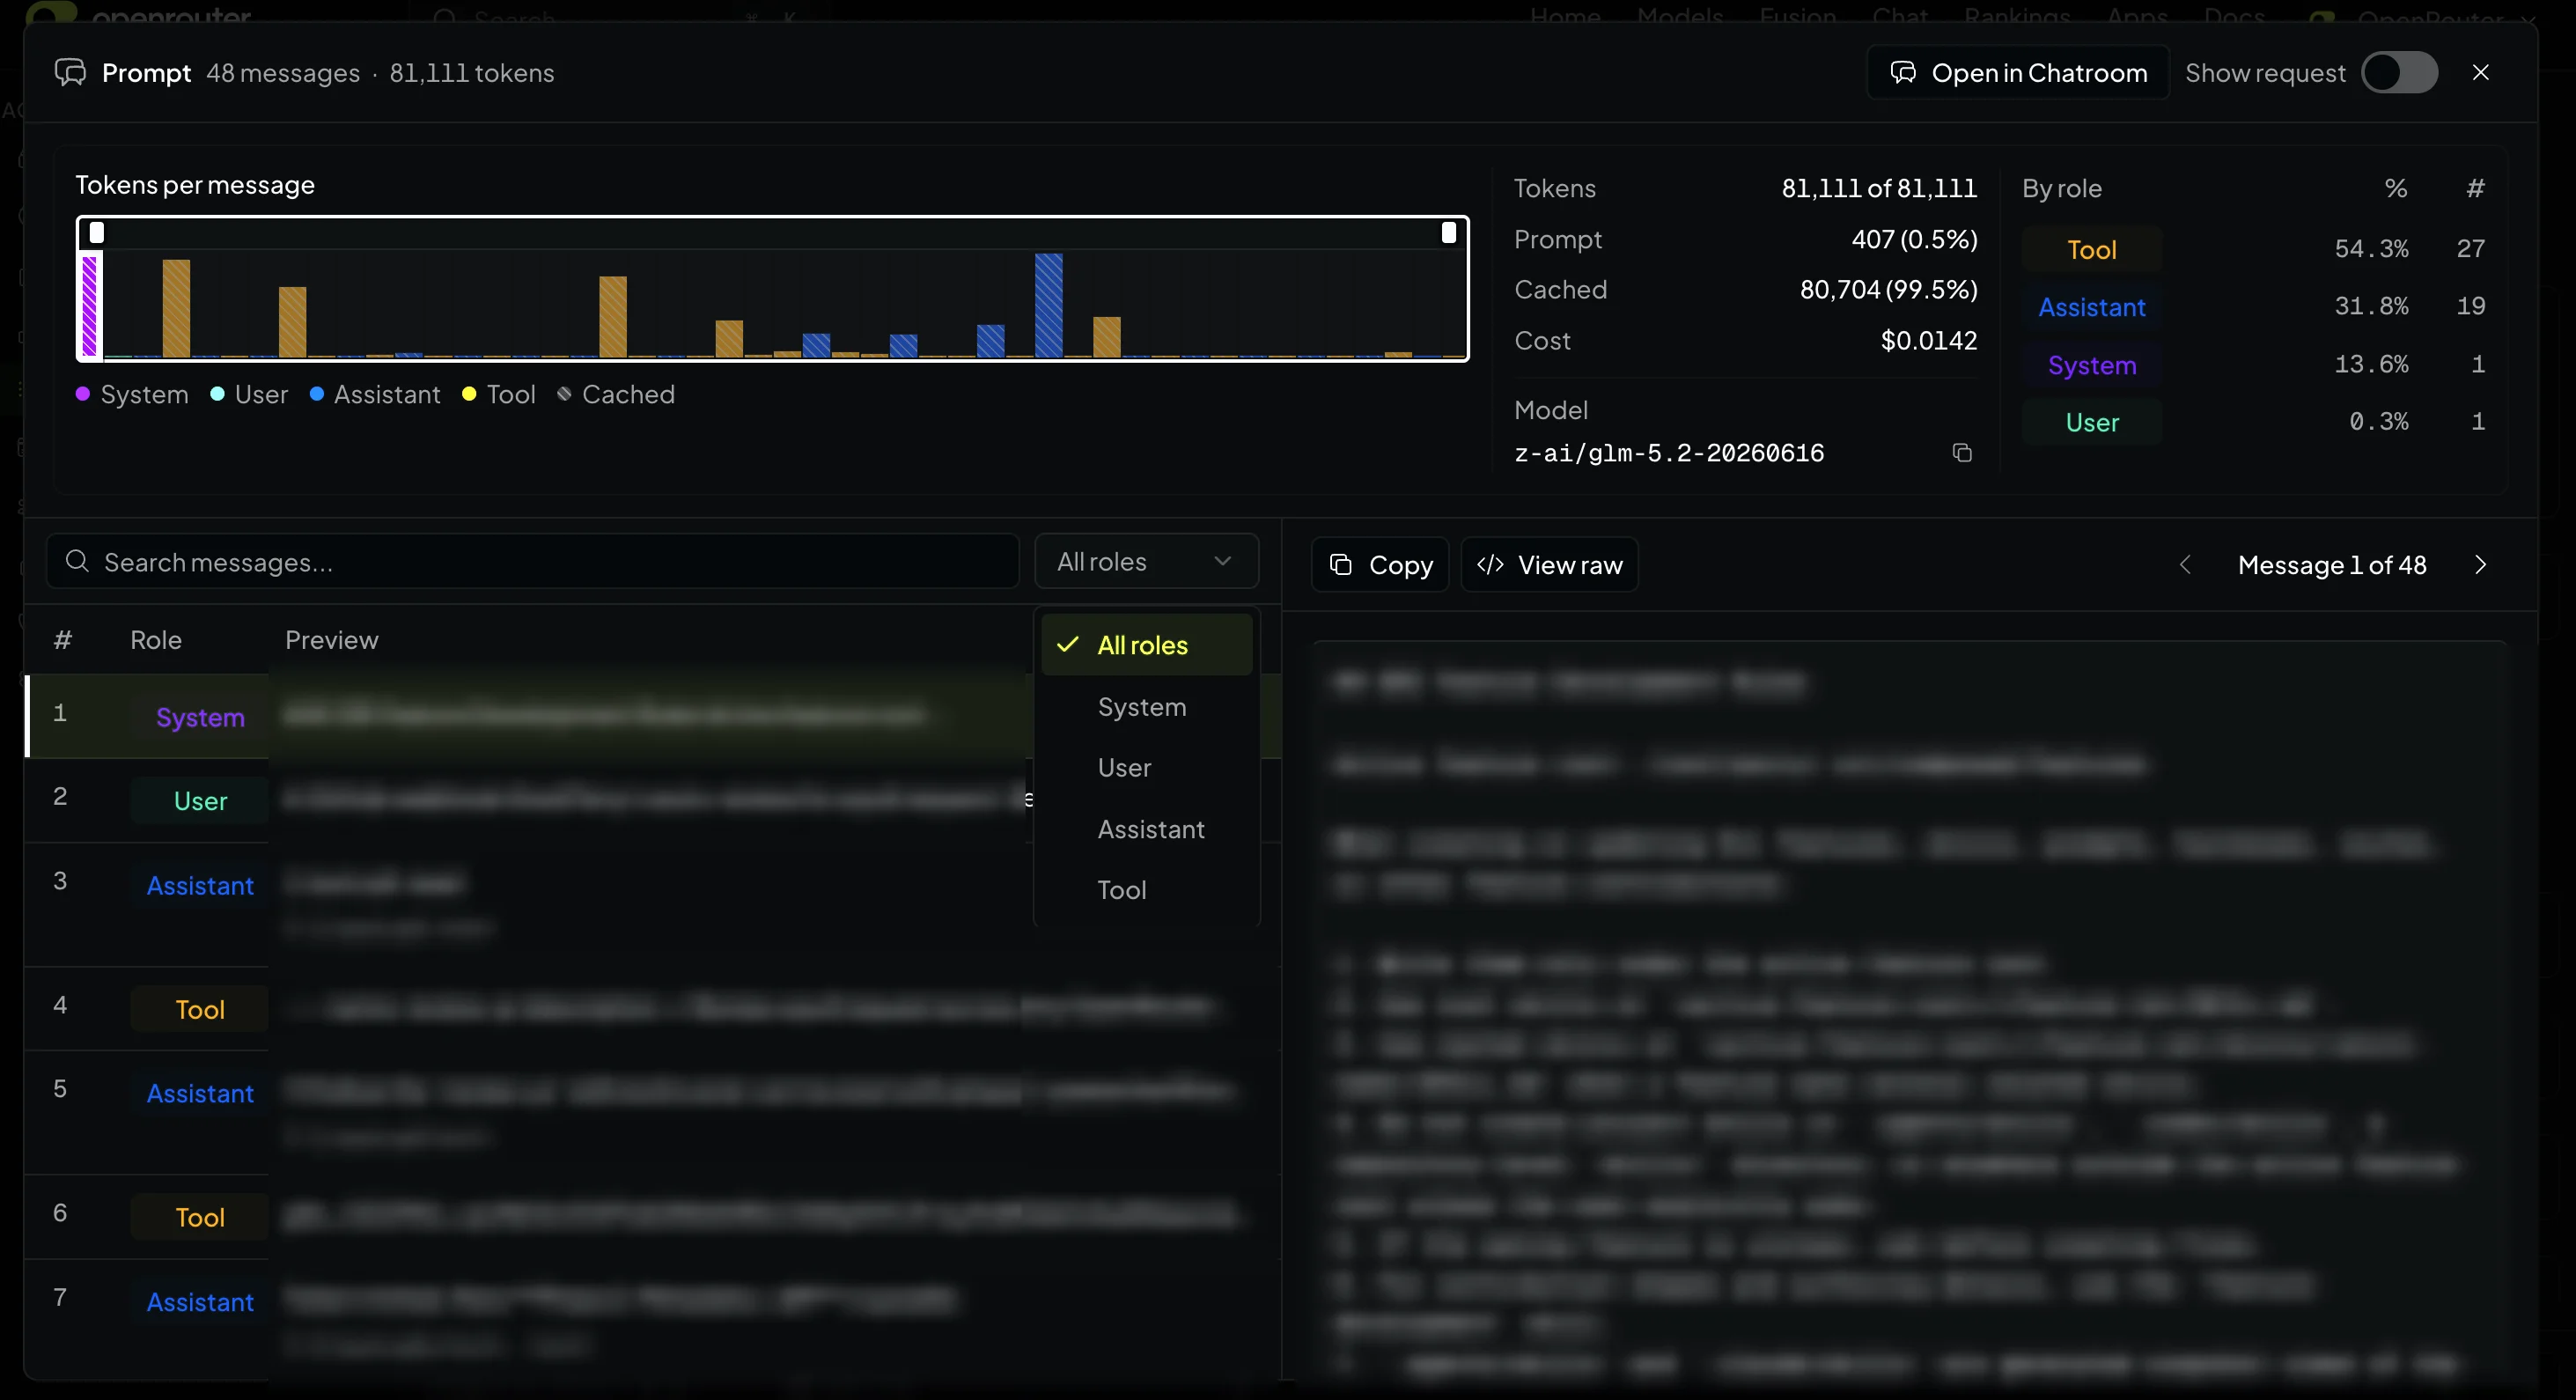
OpenRouter 还给 Prompt 详情加了一个 token 火焰图,把 system、user、assistant 和 tool 消息按宽度摊开,缓存前缀也会单独标出来。官方举的判断很直白,一个对话比预期贵三倍,常常能在图里看到特别宽的工具调用,或者一块胖得离谱的 system prompt。
这类视图对做 agent 的人很有用。上下文窗口的浪费平时看不见,只有 token 真的变成宽度,你才会意识到每轮都把完整数据库 schema 塞回去有多豪横。
不过还有一件更重要的事。
日志能告诉你一笔钱花在哪个请求上,未必能告诉你为什么值得花。
一次请求便宜,不等于一次任务便宜
假设一个常见场景,一个客服 agent 要先判断意图,再查订单,接着生成回复。团队把第一步换成便宜模型后,单次调用成本确实降了。可它的意图分类错误率稍微高了一点,后面的工具调用开始跑偏,整条任务多了两轮纠错。
单看第一步,省钱了。
单看完整任务,反而更贵。
这也是我对很多模型成本榜单没那么兴奋的原因。每百万 token 的价格很好比,但生产环境真正购买的不是 token,是一个成功结果。一次 bug 修复有没有通过测试,一次退款有没有正确完成,一份报告有没有按时交付,这些才是分母。
如果分母仍然是请求数,优化很容易走向奇怪的地方。把大模型换小,图表立刻变绿,失败重试却藏在另一个 key 下面。关掉推理 token,单次账单好看了,人工返工时间又悄悄涨上去。
所以 agent 成本至少要看四条链。
第一条是任务链,一次用户目标到底拆出了多少次模型调用和工具调用。第二条是失败链,超时、限流、解析失败、空结果和 fallback 分别烧掉了多少。第三条是上下文链,哪些消息在反复搬运,哪一条动态内容让缓存失效。第四条是结果链,花完这些钱之后,任务究竟成功、降级、转人工,还是压根没交付。
别急着把它们做成一套大而全的平台。那味儿一上来,三个月后很可能只收获一张没人看的大屏。
先把请求归因做对。
OpenRouter 的 Explore 已经支持按模型、提供商、API key、应用、用户、workspace、session、finish reason、context length 和自定义 classifier 等维度组合查询。它一次最多按两个维度分组,足够把基础账目拆开。
可真正决定分析质量的,是你在业务侧埋了什么 metadata。
一个可以起步的最小集合,大概长这样。
workflow=refund_assistant
stage=eligibility_check
attempt=2
result=tool_error
model_role=planner
cost_center=support
字段不多,但已经能回答一批以前只能靠猜的问题。退款 agent 哪个阶段最贵,第二次及以上重试吃掉多少预算,planner 和 executor 的模型分工是否合理,某个业务线的成本上涨究竟来自流量还是单任务开销。
如果只能选一个指标,我会先盯每次成功任务的 P90 成本。
平均值太会藏事。九十九次几分钱,加一次十几美元的失控长循环,平均下来可能依然人畜无害。P90 会把那些已经开始影响真实用户、却还没坏到极端的任务翻出来。再配一个失败任务成本占比,很多问题会自己浮上来。
看见以后,系统得敢动手
Activity 还有 Trends 页面,专门看哪些模型、用户、API key 和应用正在上涨或下跌。这个入口适合发现变化,但发现只完成了一半。
真正好用的成本系统,下一步应该能触发动作。
某条流水线的每次成功任务成本连续两天超过预算,就把非关键阶段降到便宜模型。fallback 比例突然翻倍,就暂时收紧 provider 路由。缓存命中率从 80% 掉到 20%,先检查 prompt 前缀有没有混入时间戳、随机 ID 或顺序不稳定的工具定义。失败任务已经吃掉当天预算的一成,就暂停自动重试,把样本送去排障队列。
这不是让财务规则直接接管生产系统。自动降级必须有边界,质量敏感任务也得保留人工审批。关键在于,成本异常不能只停在一封周报里。
OpenRouter 同时开放了 beta Analytics API。meta 接口返回当前可用的指标和维度,query 接口执行聚合查询。官方还给了一份 cost control cookbook,演示如何让编程 agent 自己跑成本审查,找出高于团队综合费率的模型,再追到对应 key 和流水线。
让 agent 审计 agent,听着有点套娃。
但这事确实有点子牛逼。前提是给它只读的 management key,限制查询范围,任何模型切换和预算调整都经过确定性规则或人工确认。别为了省 6200 美元,又给成本审计 agent 开一张能改全局配置的万能门票,那就属于修水管顺便把承重墙拆了。
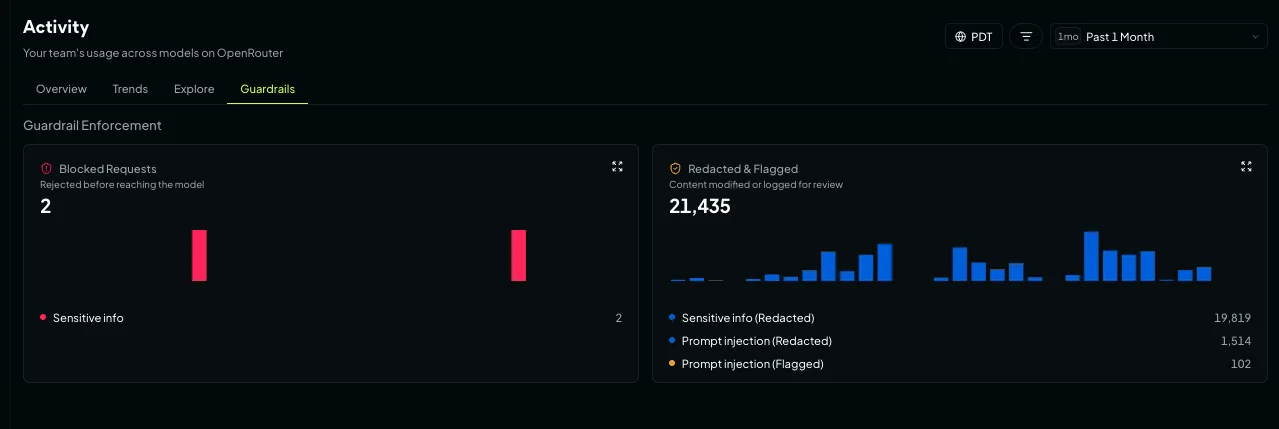
还有隐私这块需要留神。Prompt 和 Completion 详情只有在 workspace 事先开启私有输入输出日志时才存在。日志越细,排障越爽,敏感数据暴露面也越大。OpenRouter 提供的 Guardrails 视图可以看提示注入和敏感信息规则拦截、脱敏或标记了什么,但它不能替团队决定哪些内容根本不该被记录。
成本可观测性和数据最小化得一起设计。
不然账是算清了,合规工单又排到了下个月。棒棒的,省下模型费,交了审计费。
回到开头那笔每月 6200 美元的浪费。
一行模型配置能修掉它,是因为前面已经有人把支出连回了 API key、流水线和具体任务。没有这条归因链,那行配置永远躲在几千个请求后面,看起来每一次都挺正常。
所以 OpenRouter 这次真正值得抄的,不是又多了一张 AI 账单大屏。
是它终于允许你从总账一路走回现场。
模型是收银台,工作流才是购物清单。先把清单看明白,再谈省钱。