
PDF 表格不用手抄:先把 JSON schema 写清
模型能读 PDF,不等于表格就能进 Excel。把字段规则写进 schema,再拦住空结果与截断输出,才是一条能用的抽取链路。
财报、报价单、物流单里的表格,最磨人的往往不是识别出几个字,而是把它们变成能计算、能入库、能追溯的行。6,067.00 是字符串还是数字?(3,878) 是括号还是负数?一张表跨到下一页后,重复表头算不算一行?
OpenRouter 今天给了一个很实在的做法:把 PDF 和一份严格的 JSON schema 一起交给能读文件的模型。schema 不是事后的校验表,它提前规定每一行应该长什么样。字段名、类型和描述写清,模型返回的就是带类型的行,而不是一段等着人工二次清洗的文字。官方教程在五份测试 PDF、共六页 644 个单元格上做了验证,其中两份是扫描件;官方称直接读取 PDF 的模型在这套测试上全部命中。这个结果只说明那套样本,不替代你自己的文件验收。
来源:OpenRouter 官方教程。真正的变化不是“看懂 PDF”,而是把纸面表格收成一组可用的结构化行。
先别问模型选谁,先定义“一行合格数据”
很多抽取脚本一上来就问:“把这个表转成 JSON。”这句话太松了。模型可能保留货币符号和千分位,把数字塞进字符串;也可能把页脚、脚注、重复表头一起带回来。后面再补清洗规则,常常会变成一堆只对某一份文件生效的补丁。
更稳的方式是从业务要用的行开始。拿订单明细举例,数量就该是整数,金额就该是数字,商品描述要明确去掉脚注标记。跨页的行要合并,合并单元格的分类要在每一行重复。这里的规则不需要写成很长的提示词,字段描述已经足够承担大部分脏数据处理。
{
  "rows": [{
    "sku": "string",
    "qty": "integer",
    "unit_price": "number,去掉货币符号和千分位",
    "amount": "number,括号表示负数",
    "category": "string,合并单元格覆盖的每行都重复"
  }]
}
严格 schema 的好处很朴素:下游不必猜类型。(3,878) 在文档里是人能读懂的排版,在数据里应当变成 -3878;否则它一旦进入汇总、排序和告警,问题会晚很多才暴露。OpenRouter 的样例也显示,字段描述可以让带脚注的名称去掉标记,让跨页表格回到同一个列表里。
还有一个容易被忽略的选择:schema 描述的究竟是“视觉上的一行”,还是“业务上的一行”。一张费用表的末尾也许有小计、税额和总计,它们看上去都像表格行,却不该和采购明细一起写进同一张事实表。相反,某些分类名称是合并单元格,只在第一行出现一次,业务上却必须复制到它覆盖的每一条明细。先在 schema 里把这两个例外说出来,比抽完以后靠行号猜要可靠得多。
字段名也别只追求“看起来对”。如果下游要把金额汇进数据库,就用 amount、currency、document_page 这类稳定字段;如果本次只做人工复核,也可以多留一列 raw_text,让人能回看模型看到的原始单元格。schema 不是把所有信息塞满,而是让每一列都知道自己下一站要去哪。
两种最危险的失败,接口都可能告诉你“成功”
真正该在上线前拦住的,不是 400 报错,而是看起来一切正常的空结果。
第一种常见在扫描 PDF。扫描件没有文字层,如果它先被只读文本的解析器处理,模型收到的可能就是一张“没有内容”的文档。官方测试里,免费文本解析路线对两份扫描件返回了零行,但 HTTP 状态正常、finish_reason 也是 stop。没有空行检查,流水线会把“没抽到任何东西”当成完成,继续向后跑。
第二种发生在长表格。每一行都要消耗输出 token,默认上限不够时,模型可能只写到一半。更麻烦的是,某些 JSON 修复能力能把被截断的半段 JSON 修成合法格式;你拿到五行、以为它就是五行,却不知道原表其实有 58 行。
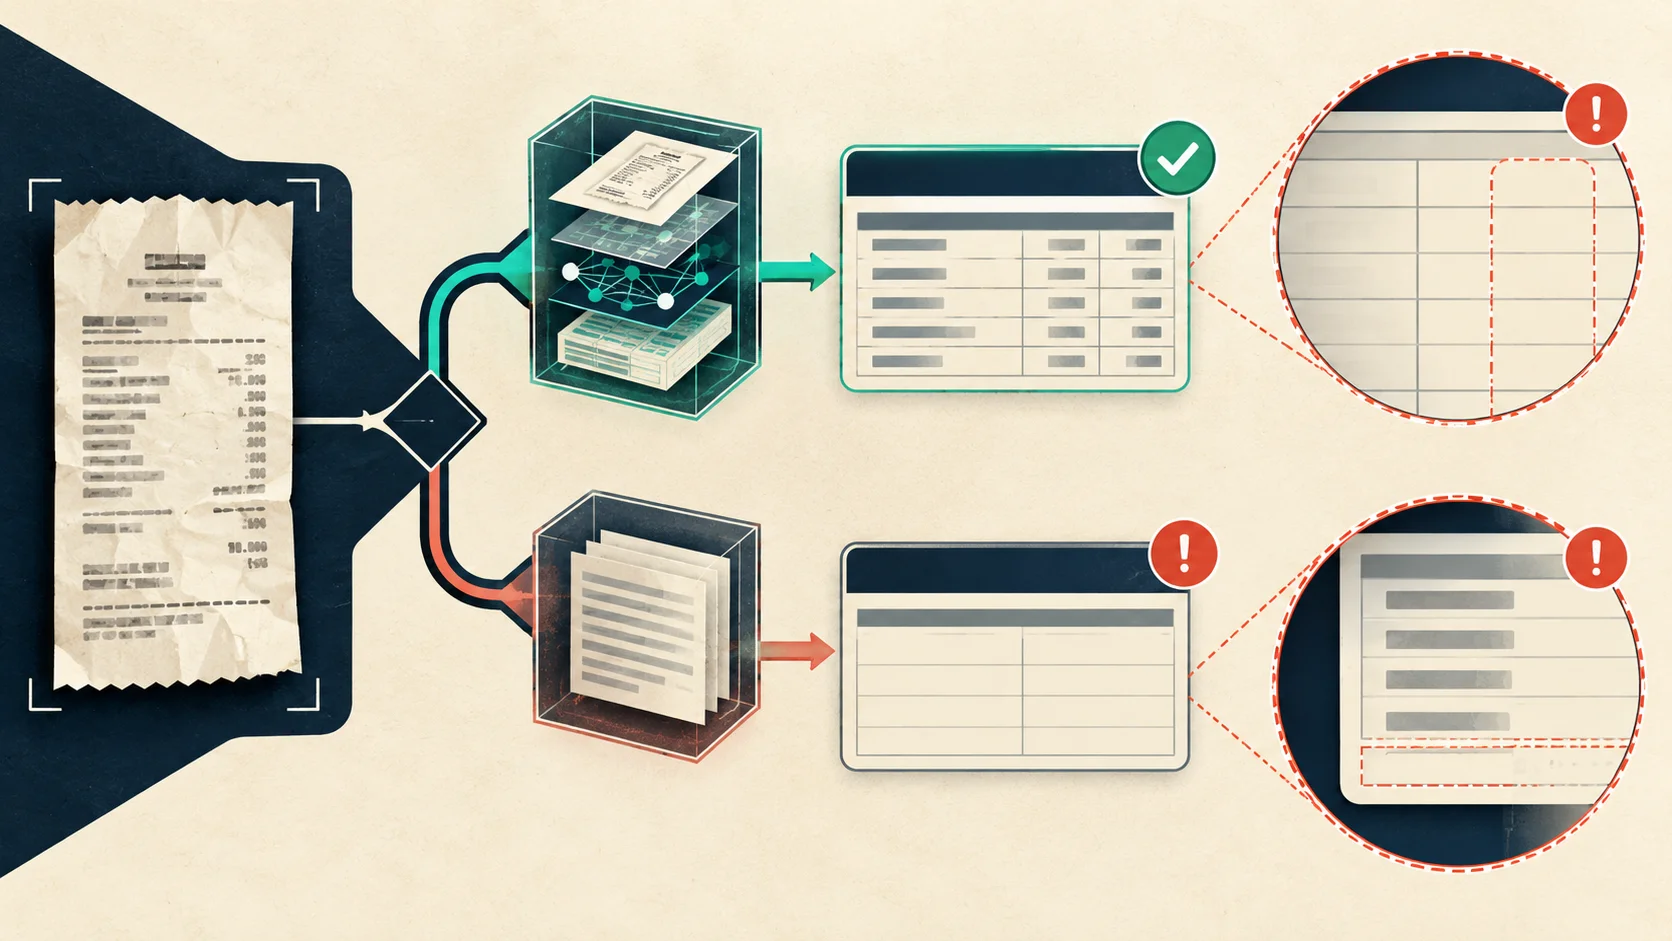
空数组和截断数组都可能长得像一次成功响应。要把它们显式升级为失败。
所以,抽取函数至少要把下面两条写死。它们比换一个“更聪明”的模型更早帮你挡住脏数据。
若 finish_reason 不是 stop:失败,增加 max_tokens 或拆分 PDF
若 rows 为空:失败,检查扫描件、文字层和 OCR 路线
若行数或小计对不上:进入人工复核,不自动入库
第三条是我会额外加的。官方样例用已知数据逐格比对;真实工作里很难有同样理想的金标准,但你至少可以校验页码、表尾小计、行数范围,或者抽几份代表性文件做人工对照。模型没有编造行,不等于它没有漏行。
把这条复核做得再轻一点也行:设定一个金额容差、记录原文页码,并在第一批文件里抽样打开 PDF 对照。目的不是让人工把表再抄一遍,而是尽早发现 schema 对某类单据理解错了。要是同一种模板持续出现异常,再把案例补进回归集;以后换模型、换 OCR 或改字段描述,都拿它重新跑一遍。
路线别混用:数字 PDF、扫描件、长表格是三种题
如果 PDF 原本就是系统导出的,表头简单、每页格式稳定,pdfplumber 这类免费库可能已经够用。OpenRouter 在相同测试里发现,它能找全三份数字 PDF 的表格;代价是单元格仍是字符串,多层表头会拆成多行,跨页表会拆成多张表。
一旦文件里有扫描页、合并单元格、括号负数或跨页续表,直接读取 PDF 的模型或先做 OCR 的路线更省维护。官方的成本换算给了一个量级参考:其六页样本外推到 1,000 页时,GPT-6 Luna 约 0.77 美元、Claude Haiku 5.5 约 1 美元;若额外走 mistral-ocr,还要加约 2 美元。页面越密、schema 越复杂,价格和输出长度都会变,所以第一批请求应记录自己的 usage.cost,别把样例价格当预算。
这也是为什么我不建议把“哪个模型最便宜”写在方案第一页。先拿十几份最难看的真实 PDF 做一个小样本:数字件、扫描件、跨页件各来几张;定义 schema;记录行数、小计、耗时和成本。你最终选的不是某个模型,而是一条在自己文件上能交卷的路线。
PDF 表格抽取最容易被误解成一个单次调用。它其实更像一份小型的数据合同:输入是什么,行应该长什么样,什么结果不能接受,谁来复核例外。把这四件事写下来,模型才会真的替你省掉手抄的时间。
你手里最难抽的 PDF,是扫描件、跨页表,还是那些数字格式乱七八糟的财报?
小岛AI