posts/openrouter-video-job-idempotency.md
OpenRouter 视频 API 最贵的 Bug,不在模型里
状态查询超时了。
工程里最顺手的补救动作,通常是再提交一次。
放在普通查询接口里,这可能只是多打一行日志。放在视频生成 API 里,它可能变成两段都成功的视频,和两笔都真实扣掉的钱。
好家伙,代码只重试了一次,账单却认真执行了两次。
这是我看完 OpenRouter 新发布的视频生成 API 指南后,最想提醒大家的一件事。
官方最显眼的卖点很直白。一套异步 API,可以接 Seedance、Veo、Wan 等多个视频模型。提交、轮询、下载都走同一套生命周期,换模型主要改一个 model 字段。
这当然有价值。以前接三个供应商,往往要维护三套鉴权、三组参数、三种状态名和三条下载路径。现在外围流程终于可以稳下来,模型从架构决策变成配置项。
但我自己的判断是,视频模型越容易切,任务状态越不能随便丢。
真正决定这套东西敢不敢放进生产的,不是演示里那一行模型标识,而是 job ID、状态机、幂等、恢复、限流和成本对账。
模型负责生成画面。
任务控制面负责别把钱烧重了。
一行换模型,只解决了接线问题
视频生成天然比文本响应慢。模型要协调很多帧,维持人物、镜头和运动的一致性,有时还要配音。官方给出的经验范围是几十秒到几分钟。
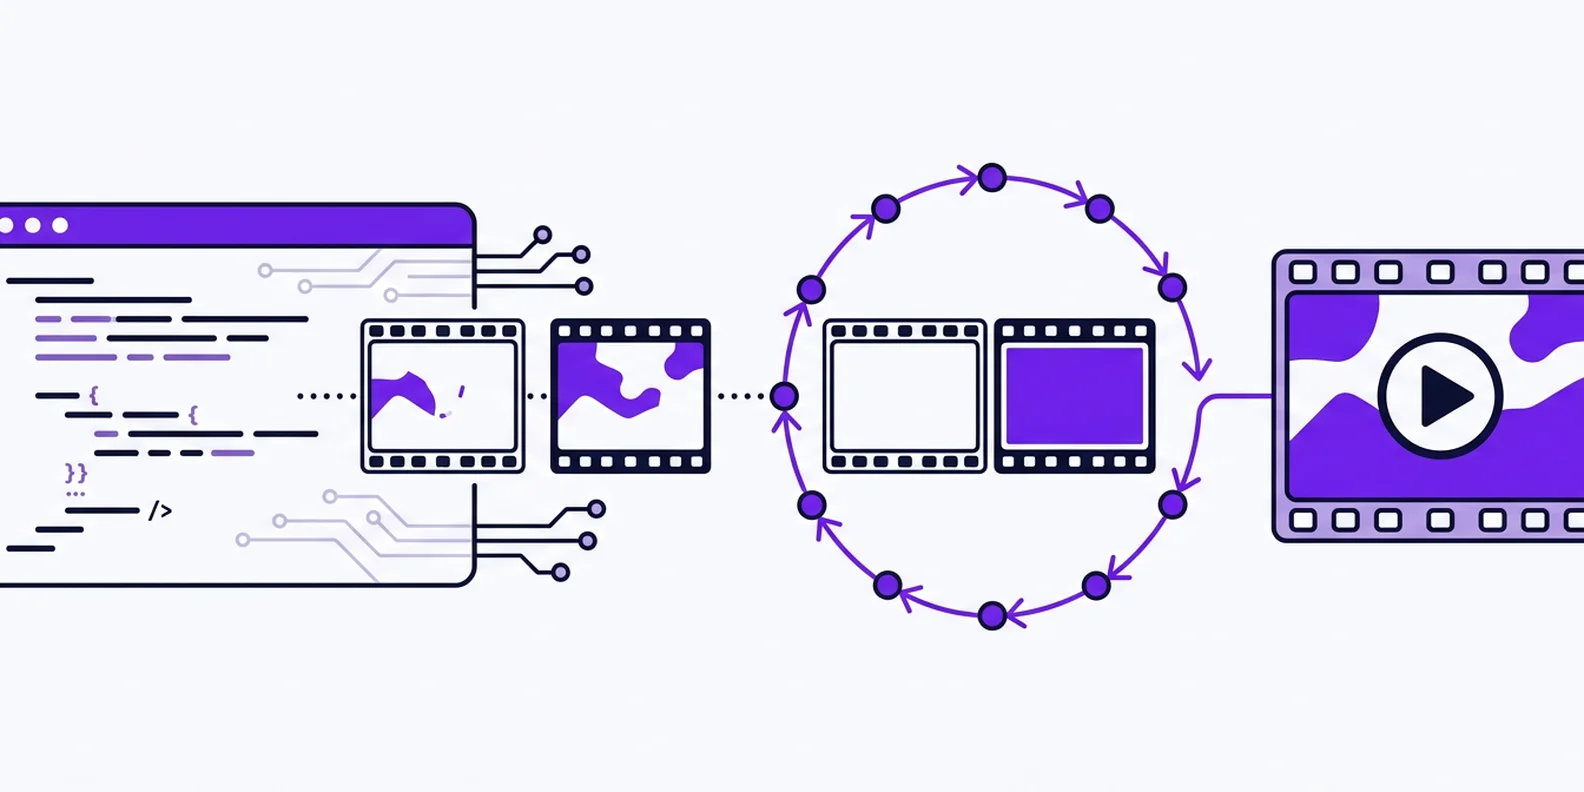
如果让原始 HTTP 请求一直挂着,浏览器可能关掉,serverless function 可能撞上执行时限,代理也可能先超时。于是 OpenRouter 的视频生成流程采用了很标准的异步形状。
客户端提交任务,接口返回 job ID 和 polling_url。应用随后单独查询状态,看到 completed 再下载 MP4。
这套形状厉害的地方,不是它新。队列、转码、导出、批处理系统早就这么干了。它真正省下的是供应商之间最烦人的接线差异。
Seedance、Veo、Wan 可以共用同一个提交端点、鉴权方式、任务状态和下载流程。对业务代码来说,模型终于能被关进一层 adapter 里。
不过,统一入口并不等于能力完全统一。
官方写得很克制。发布时,Seedance 2.0、Veo 3.1 和 Wan 2.7 都接受 4 秒、720p、16 比 9、无音频这组配置。往外走一步,差异马上回来。Veo 3.1 支持 4 秒、6 秒和 8 秒,Seedance 2.0 支持 4 到 15 秒,Wan 2.7 支持 2 到 10 秒,还能选 720p 或 1080p。
所以切换模型虽然只改一行,提交前仍要查 实时视频模型端点,读取时长、分辨率、画幅、音频、价格和允许透传的供应商参数。
接口帮你统一了生命周期,没有替你取消差异。
这点非常关键。否则一行换模型,很快就会变成一屏 if model == ...。
棒棒的,又绕回去了。
最贵的重试,是把查询失败当成任务失败
官方指南专门提醒了一种很容易被忽略的错误。
状态查询请求失败,不代表生成任务失败。
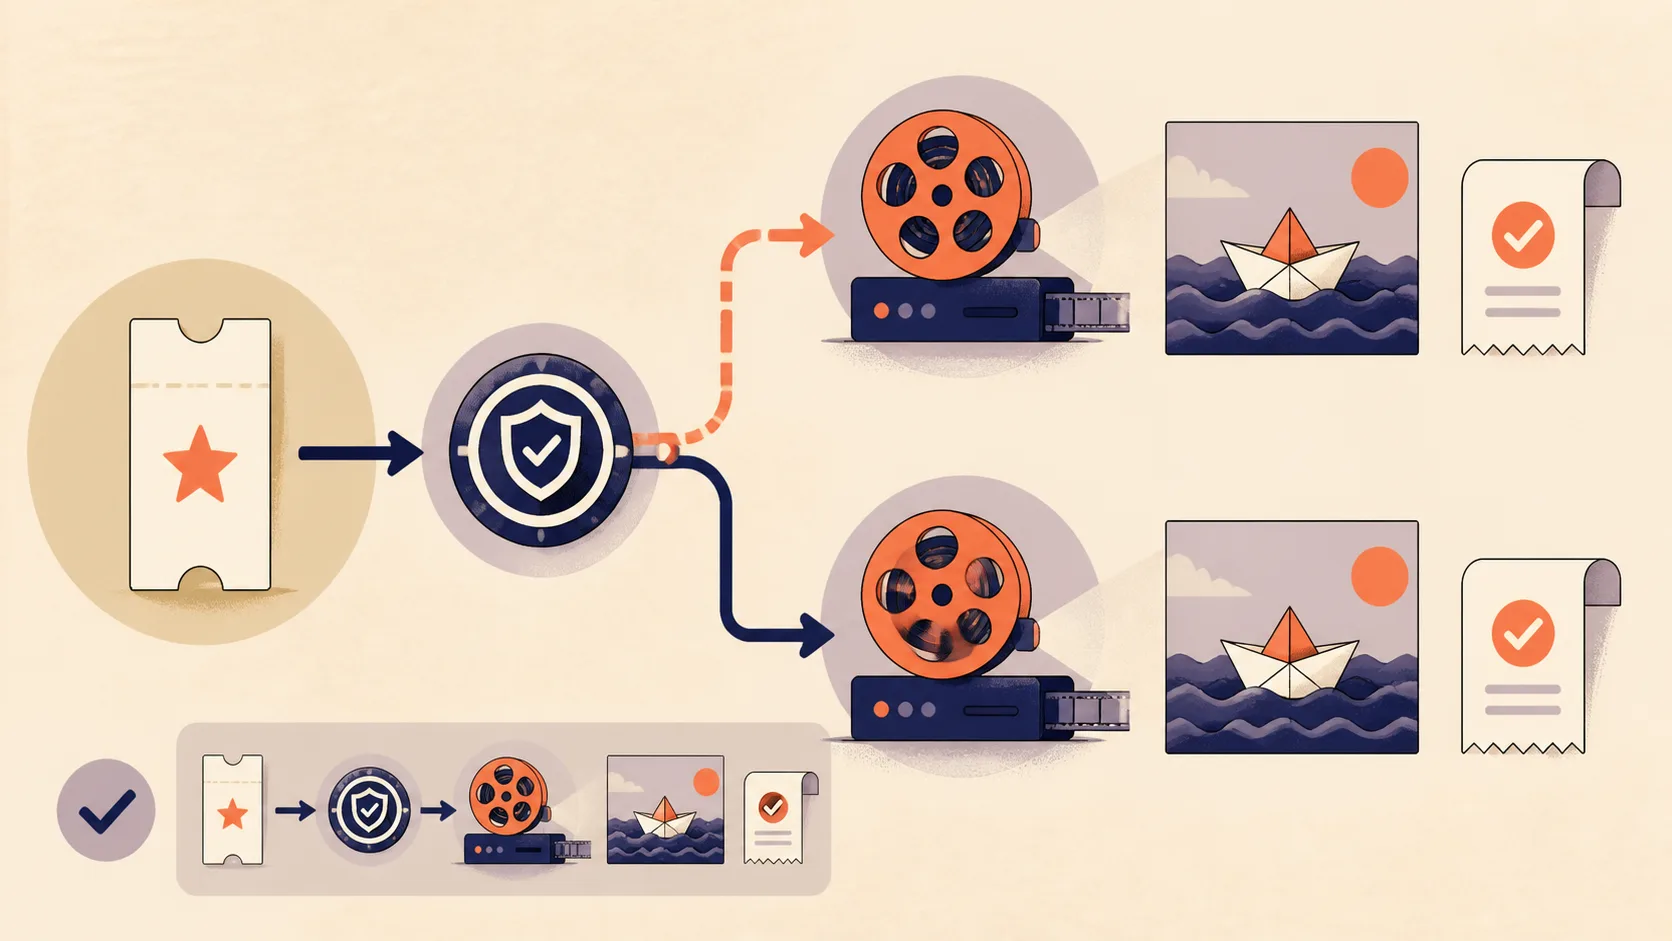
可能只是网络抖了一下,代理超时了,或者你的 worker 在轮询时重启了。远端视频仍在继续生成。此时如果业务代码重新调用创建接口,旧任务不会凭空消失,新任务也会照常开始。
结果两段视频都出来。
两笔费用也都成立。
这种 bug 很讨厌,因为它在日志里看起来像一次成功的自愈。用户只点了一次,系统没有报错,页面也拿到了视频。只有月底对账时,某个同事盯着重复 job 记录沉默半天。
要拦住它,系统里至少要分清三种标识。
业务请求 ID 表达用户只想完成一次生成。OpenRouter job ID 表达远端已经接收了一笔具体任务。Webhook 的幂等 key 表达某次终态通知已经被消费。
它们不是同一个东西。
我很喜欢把 job ID 理解成一张收据。提交成功以后,那笔钱对应的任务已经存在了。进程重启、页面关闭、轮询超时,都不能成为把收据扔掉再买一份的理由。
一个够用的任务记录不需要花活,可以先长这样。
{
  "request_id": "req_9f21",
  "provider_job_id": "job-abc123",
  "model": "bytedance/seedance-2.0",
  "status": "pending",
  "attempt": 1,
  "cost": null,
  "output_location": null
}关键动作发生在创建接口返回之后。先持久化 job ID,再把任务交给轮询 worker。
如果查询接口超时,继续查同一个 job。只有远端任务明确进入 failed、cancelled 或 expired,而且你的业务策略允许再次付费,才创建新的 attempt。
查询重试是在找同一张收据。
生成重试是在买第二份。
别混。
六个状态,比一个 try catch 可靠
视频任务不是成功和失败两个灯泡。OpenRouter 公开了六个状态,pending、in_progress、completed、failed、cancelled 和 expired。
前两个还在路上,completed 可以下载,后三个是不同原因的终止。
很多示例代码只等 completed,其余情况继续睡眠。跑 demo 没事,进生产以后,一个已经 expired 的任务能被轮询到地老天荒。厉害了,GPU 早下班了,worker 还在打卡。
轮询文档建议大约每 30 秒查一次,同时设置总超时。这里的 30 秒是操作建议,不是永远不变的协议。真正该固化的是状态机。
pending -> in_progress -> completed
        \-> failed
        \-> cancelled
        \-> expired
遇到未知状态也不要装作没看见。它可能是服务端新增了状态,而你的客户端还没升级。最稳妥的动作是报警并停止自动推进,别擅自把陌生值归到失败,再触发一次付费重提。
超时也需要分层。
一次状态查询的网络超时,只重试查询。业务等待时间超过上限,可以停止当前 worker 并转入后台恢复队列,但仍保留 job ID。远端任务进入明确失败终态,才进入生成重试策略。
这三层超时如果揉成一个异常处理,账单迟早会替你做集成测试。
Webhook 能少轮询,不能少幂等
十几个任务用轮询没什么。几百个并发任务还给每个 job 启一个无限循环,线程池和连接池就会开始替架构师表达意见。
OpenRouter 支持在创建任务时传 callback_url。任务进入终态后,平台会向你的地址发送 webhook。它能省掉大量空轮询,也更适合把下载、转码和对象存储串到后台队列。
但 webhook 有一个老规矩。
它可能重复投递。
官方 webhook 文档会在每次事件里带 X-OpenRouter-Idempotency-Key。处理器应该先把这个 key 写进数据库,再执行下载、转码或触发下游流程。发现 key 已经存在,就直接确认,不再做第二遍。
如果配置了签名密钥,还要基于原始请求体校验 X-OpenRouter-Signature。注意是原始字节,不是 JSON 解析后又序列化出来的另一份文本。
一个生产回调最好很短。
验签,登记幂等 key,更新 job 状态,快速返回。真正耗时的下载和转码交给有并发上限的 worker。
为什么不在 webhook 请求里直接下载几百 MB 的视频?
因为回调超时后,平台很可能再送一次。然后你得到两个正在下载同一文件的进程,和一段充满竞争条件的下午。
怎么说呢,异步系统最爱用重复通知提醒你,世界并不承诺 exactly once。
统一 API 之后,成本和数据边界更要显式
视频模型的计费维度比文本更花。时长、分辨率、是否生成音频、具体模型和供应商,都可能改变实际价格。
OpenRouter 的模型端点会返回当前的 pricing_skus,完成响应也可能带 usage.cost 和 usage.is_byok。比较稳的做法,是提交前用实时能力数据估价,完成后把实际费用写回 job 记录,再按业务请求 ID 对账。
估价和实付都要留。
只留估价,你看不到配置变化造成的偏差。只留实付,用户点确认时又不知道这次大概会烧多少。
输出文件也不要永远挂在生成接口上。官方建议完成后尽快转存到自己的对象存储,并把最终位置写回任务记录。应用真正拥有的不是一条临时下载 URL,而是从请求、job、费用到成品的完整链路。
还有一个容易被营销页略过去的边界。官方 FAQ 明确写着,视频生成不支持 Zero Data Retention。异步取回要求平台短暂保留生成结果,开启强制 ZDR 的请求不会被路由到视频生成。
如果你的产品处理客户未发布的广告片、内部培训素材或受监管数据,这不是页脚小字。它会直接决定这条供应链能不能用。
有点子牛逼的统一接口,可以把接线成本砍掉。
它砍不掉你的数据责任。
真正该复用的,是任务控制面
看到这里,再回头看一行换模型,味道会有点不一样。
模型标识确实应该可替换。今天用 Seedance,明天试 Veo,下周换 Wan,业务层不该跟着重写一遍。
可真正值得沉淀成公共组件的,是下面这套东西。
创建成功后立即保存 job ID。查询失败时恢复同一任务。六态状态机覆盖所有终态。生成重试和轮询重试分开计数。Webhook 验签并按幂等 key 去重。并发 worker 有明确上限。完成文件转存到自己的存储。估价与实付能按 request ID 对上。数据保留边界在产品入口提前说清。
这些做好以后,模型才真的只是配置。
否则模型虽然一行就换了,生产事故也只需要一行。
submit_video()。
再来一次。
账单会记得比你牢。