posts/openrouter-web-search-budget-router.md
81 次搜索仍然答错,Agent 不是搜得越多越好
一张表,搜了 81 次,还是错的。
这个数字出自 OpenRouter 刚发布的实时网页搜索基准。他们把模型、搜索引擎、搜索方式和搜索轮数拆开,在 BrowseComp、DeepSearchQA、WideSearch、HLE 四套任务上持续跑生产端点。那次 81 轮的记录来自 WideSearch,Agent 一路找,一路补,一路觉得下一次也许就能凑齐证据,最后把预算烧光,答案照样没过。
好家伙,这个画面太像线上 Agent 了。
很多团队给 Agent 接上网页搜索后,第一反应是把 max_tool_calls 往上拧。一次不够就五次,五次不够就二十五次。搜索越深,资料越全,答案自然越准。逻辑听着没毛病,OpenRouter 的数据也确实证明,多搜通常有用。
但真正扎人的地方在后半句。
搜索预算不是一个只管效果的性能滑块,它还是失败任务的成本放大器。 搜得越深,答对的任务更贵,答错的任务往往更贵。到了生产环境,问题就不再是该用 Exa 还是 Perplexity,而是 Agent 什么时候应该继续找,什么时候应该承认找不到。
这才是这组基准最值得开发者抄走的东西。
搜索预算不是性能滑块,是风险阀门
BrowseComp 的初始数据很漂亮。
Claude Opus 5 搭配 Perplexity,搜索预算从 1 轮加到 25 轮,得分从 35.8% 涨到 89.0%,每题成本从 0.14 美元涨到 0.99 美元。GPT-5.6 Sol 从 46.3% 涨到 82.4%,成本从 0.20 美元涨到 0.50 美元。更便宜的 GPT-5.6 Luna 也从 33.7% 涨到 74.0%,成本只从 0.02 美元涨到 0.10 美元。
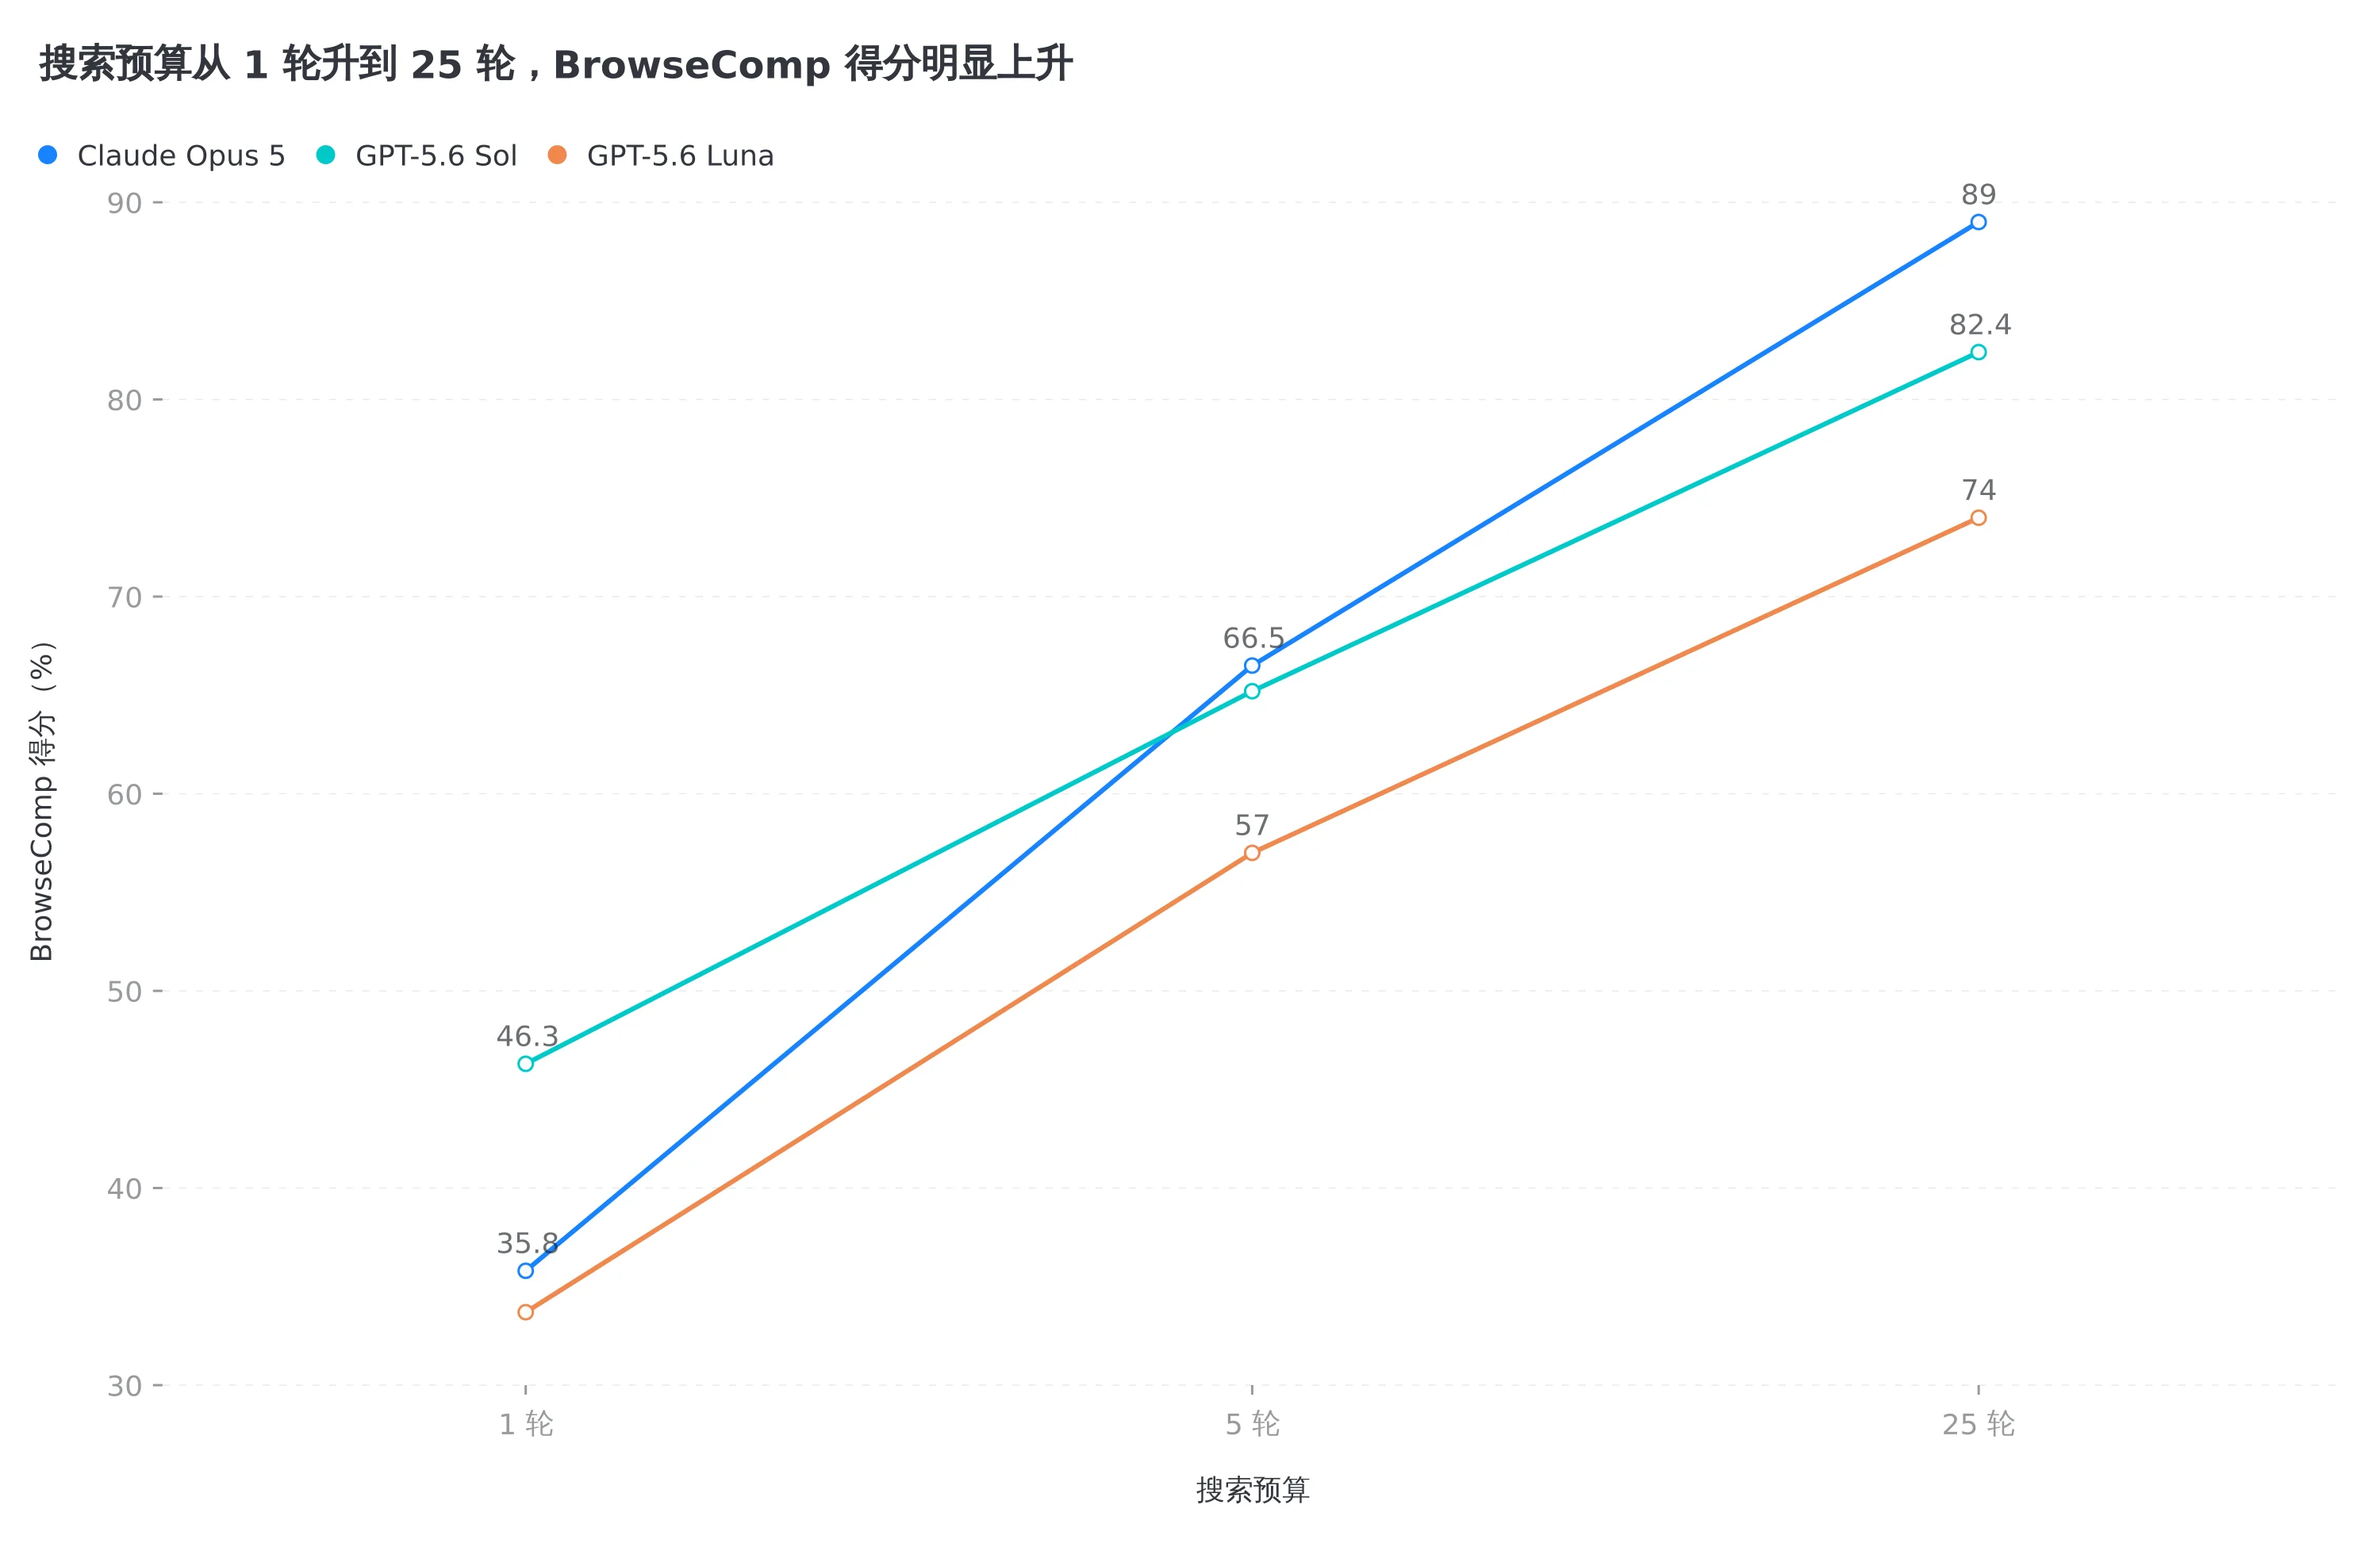
大致算下来,1 轮变 25 轮,质量接近翻倍,成本增加 2.5 到 7 倍。对于本来就需要多跳检索的任务,这笔账甚至挺划算。一次搜索只给你门牌号,后续搜索才能找到楼层、房间和抽屉里的那张纸。
还有个挺有意思的现象,更多搜索不一定更慢。Luna 在 1 轮预算下平均用了 140 秒,25 轮反而只用 111 秒。OpenRouter 测过的 35 组 1 轮与 5 轮配置里,超过三分之一是预算更少时更慢,而且全部来自 OpenAI 模型。预算卡得太死,模型会在脑子里多转几圈,试图用推理补搜索证据的窟窿。
厉害了。你以为省的是搜索调用,模型转头把钱花在了思考 token 上。
可这组数据不能读成默认开 25 轮。HLE 上,GPT-5.6 Sol 搭配 Perplexity 的 1 轮和 25 轮得分接近,后者成本却是前者三倍。原因并不玄,HLE 里有不少问题只需要找到一个可靠事实,继续搜索不会让那个事实更真,只会让上下文更长。
所以搜索预算该跟任务难度绑定,而不是跟团队对质量的焦虑绑定。
一个只问今天某款模型价格的问题,用单次 Web 插件先搜再答,通常就够了。一个需要跨三个来源核对公司并购关系的问题,才值得把服务端搜索工具交给模型,让它自己改写查询、追证据、补缺口。
表面上都叫联网搜索,运行方式完全不是一回事。前者像查快递,后者像查案。
答错的任务,为什么反而最贵
OpenRouter 统计了 25 轮预算下,Agent 答对和答错时分别用了多少次搜索。
BrowseComp 答对平均搜 10.3 次,答错却搜 19.7 次。DeepSearchQA 是 11.7 次对 20.1 次。WideSearch 更狠,答对平均 17.6 次,答错平均 23.4 次。只有相对简单的 HLE 差距小一些,5.2 次对 7.5 次。
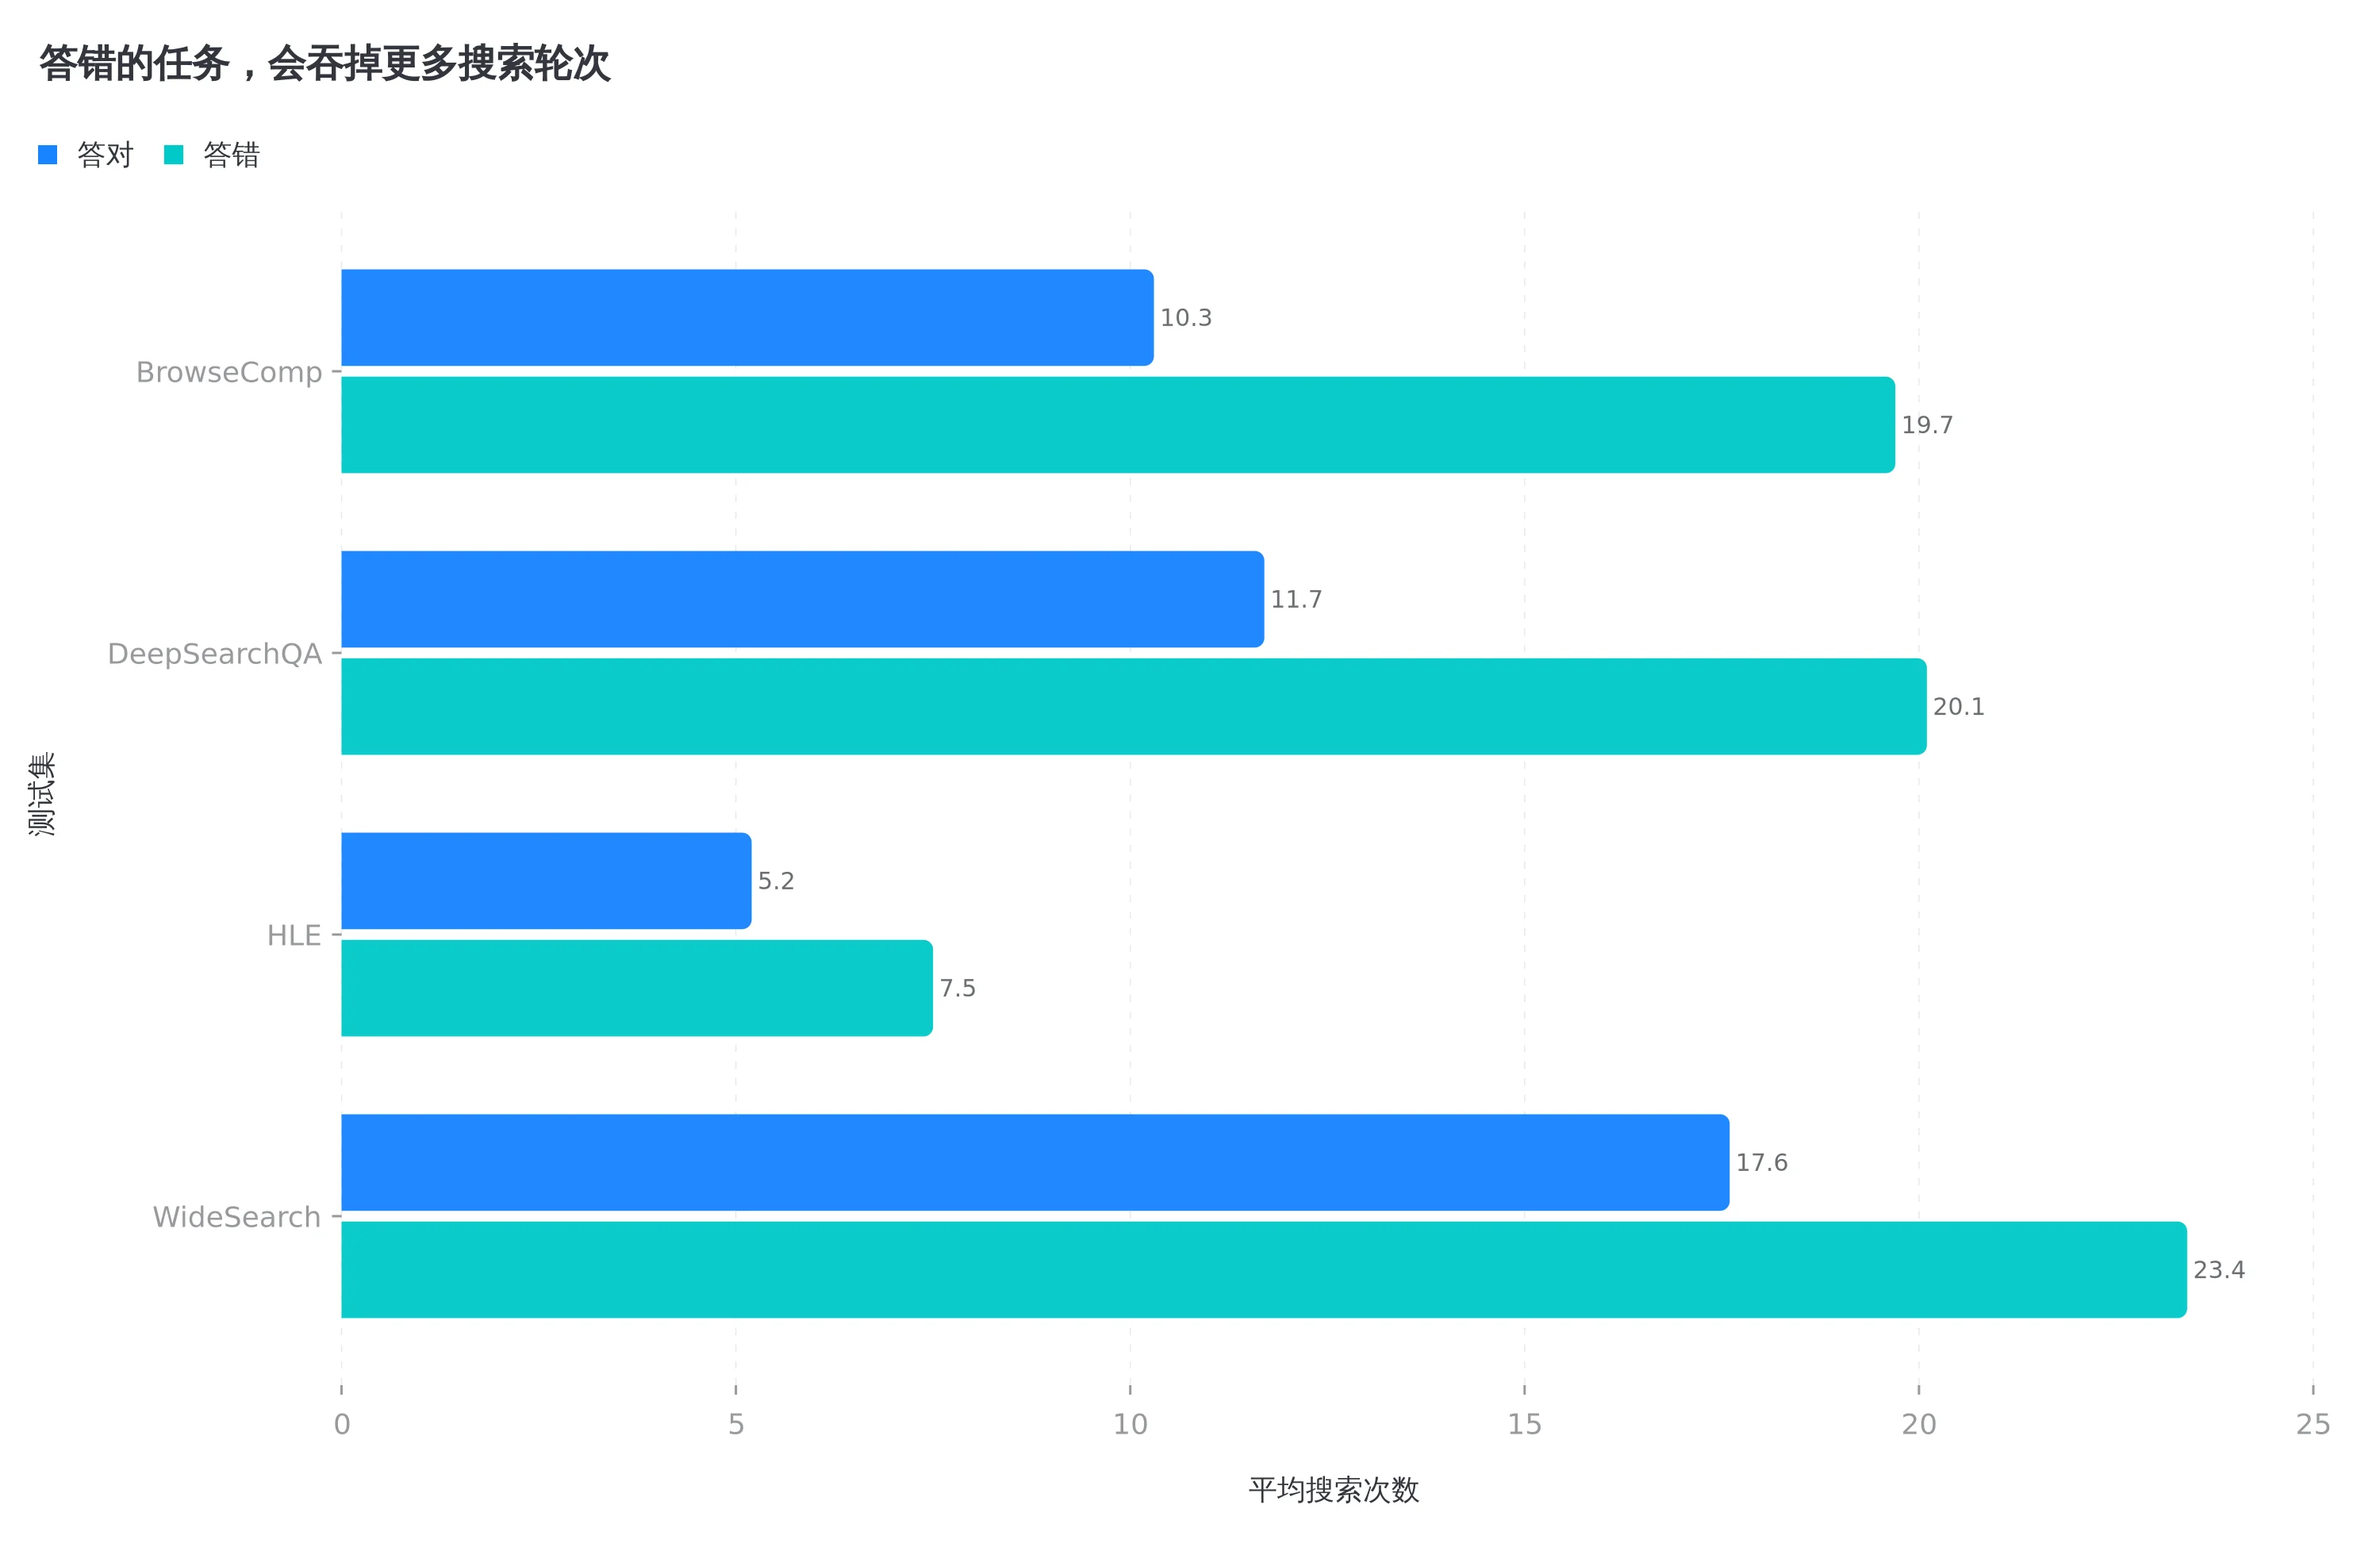
这组数把一个生产问题照得很亮。
模型不会在搜索中途突然获得一种可靠的自知之明。它看到一点相关结果,就觉得再换个关键词也许能找到;新结果又给出半条线索,它再追一次;几个来源互相引用,它误以为证据正在变多。最后发生的不是收敛,而是绕着同一片信息荒地多走了十几圈。
很多朋友可能会把这种行为叫坚持。放进账单里,它叫长尾成本。
你想想看,平均每题 0.20 美元并不可怕。可如果那 5% 最难的问题,每道都耗尽 25 轮搜索、拉进一大坨重复摘要、再触发一次长上下文推理,账单的形状就会被尾巴决定。更麻烦的是,这些最贵的问题还不一定交付正确答案。用户付出了最长等待,系统付出了最高成本,产品最后给了一个最没把握的结论。
三输。
这也是为什么我越来越不喜欢只看平均分和平均成本。平均数会把失败路径压平,看不见 Agent 在错误方向上狂奔。生产系统更该盯的是失败任务的 P95 搜索轮数、重复来源比例、每个正确答案的成本,以及达到成本上限后有多少回答仍敢装得很确定。
搜索 Agent 的风险并不只在搜不到,还在搜不到时不知道停。
生产环境需要的不是 25 轮,是会变档
如果让我把这组数据翻成一套能落地的路由,我不会给所有请求一个统一的 max_tool_calls。那相当于给小区代步和高速长途都塞同一箱油,配置看着整齐,浪费也很整齐。
我更愿意先分三档。
快速档只处理新鲜事实和单点核对,例如版本号、发布日期、价格、某份官方文档里的一个字段。先做一次搜索,要求至少命中一个官方来源。找到了就答,没找到也别自动连搜二十四次,直接进入降级判断。
标准档处理需要两到三个证据拼起来的问题,例如比较产品能力、核实一个变化前后的差异、确认某项更新是否已经普及。预算可以从 5 轮起步,但每一轮都要带着明确的证据缺口。缺的是发布日期,就只追日期;缺的是价格,就别又去搜跑分。
深搜档才配拿 12 到 25 轮,留给真正的多跳研究、宽表收集和互相矛盾的来源。进入这档之前,最好让一个便宜分类器或规则先判断任务是否真的需要深搜。否则每个问天气的问题都走一遍研究员流程,产品很快就会研究出一张很有学术价值的云账单。
路由只是第一层,还得有早停。
一种实用信号是来源饱和。连续两轮返回的核心域名和事实几乎没变化,继续搜大概率只会得到同一批内容的改写版。此时应该停下来整理证据,而不是奖励 Agent 换第九种问法。
另一种信号是问题没有可验证答案。搜索轮数增加了,权威来源数量没有增加,只有论坛转述、聚合站和互相抄写的文章越来越多。这不是快找到了,是信息源本来就没有。系统应该输出证据不足,或者把任务交回人工,而不是用更多低质量来源拼出一种确定感。
还有成本信号。别只限制轮数,同时限制累计 token、搜索费用和墙钟时间。因为一轮搜索可以返回十条短摘要,也可以拉回一堆长文本,轮数相同,成本完全不同。
一个简化后的策略可以长这样。
新鲜单点事实,搜索预算 1 轮
需要交叉核对,搜索预算 5 轮
明确的多跳研究,搜索预算 12 轮起

连续两轮来源高度重复,停止搜索
权威证据不再增长,停止搜索
累计成本或等待时间触顶,降级回答
证据冲突无法消解,转人工复核
这里最重要的不是 1、5、12 这几个数。每个业务的数据分布不同,照抄数字没意义。重要的是预算会随着任务类型升级,也会随着证据状态提前收回。
能继续搜只是能力,能及时停才是工程。
模型比引擎更重要,但别急着换贵的
OpenRouter 的另一组结果也挺有用。固定 25 轮预算后,只换搜索引擎,得分平均相差约 10 分;前沿模型与低成本模型之间,平均差距约 15 分。至少在这套隔离搜索能力的测试里,模型对最终结果的影响,比引擎更大。
但这也不能简单翻译成全量换最贵模型。
Claude Opus 5 搭配 Perplexity 在 BrowseComp 上拿到 89.0%,每题 0.99 美元。DeepSeek V4 Flash 是 77.0%,每题 0.08 美元。12 个百分点的差距,对某些研究任务很值钱;对大量只要核对两三个事实的后台任务,成本差出十二倍,可能就不划算。
更合理的做法,是把模型和预算一起路由。便宜模型先跑快速档和标准档,证据冲突、答案置信不足或任务被判定为高价值时,再升级模型和搜索深度。不要一上来就用最贵模型配最大预算,然后祈祷平均成本能被用户量摊薄。祈祷不是容量规划。
OpenRouter 的基准适合拿来缩短候选名单,不适合替你做采购决策。官方也特意提醒,这些测试只让模型读取搜索结果摘要,关闭了整页抓取和代码执行,测的是搜索配置,不是完整研究 Agent。真实生产里还有网页解析失败、站点限流、动态页面、重复内容、工具超时和提示注入,分数不会原样搬过来。
坦率讲,这反而是它最有价值的地方。变量被拆开后,我们终于能看见钱到底花在模型、引擎还是搜索轮数上。然后再用自己的 50 到 100 道真实任务,跑一条质量、延迟、成本和失败尾巴都能看见的曲线。
OpenRouter 已经把测试工具放进了开源 benchmark-harness。不一定非得复刻它的全部榜单,挑自己最常见的任务就行。每次改模型、引擎或预算时,别只问平均分涨了没有,再多问一句,那些最终答错的请求,一共烧了多少钱。
81 次搜索仍然答错,不是一个笑话,是一个很诚实的告警。
网页越大,Agent 越容易产生一种错觉,好像答案只差下一次查询。可工程系统不能把下一次当信仰。它得有地图,也得有油表,还得知道前面已经没有路了。
然后停下来。