posts/perplexity-amazon-agent-user.md
Perplexity 暂时赢了,法院说 Agent 只是工具
一场关于 AI Agent 能不能替你逛 Amazon 的官司,胜负居然压在了一张网络拓扑图上。
不是模型跑分,也不是 Agent 看起来多像人。
法院盯住的是一个朴素到有点冷的工程问题。
到底是谁发出了访问 Amazon 的请求。
8 月 4 日,美国第九巡回上诉法院撤销了针对 Perplexity Comet 购物 Assistant 的初步禁令。按公开判决里的说法,在目前这份证据记录下,访问 Amazon 的是用户,Assistant 是用户手里的工具,Perplexity 的服务器没有直接进入 Amazon 的系统。
这句话听起来像在玩文字游戏。
再看一遍架构,味道就变了。
Comet 浏览器跑在用户电脑上。用户让 Assistant 找商品时,本地浏览器向 Amazon 请求页面,再把页面显示出来。Assistant 读取本地浏览器已经拿到的内容,必要时把截图和用户指令发给 Perplexity 的服务器。云端模型算出下一步,再把导航动作送回本地。
Amazon 的服务器和 Perplexity 的服务器之间,没有法院在这份记录里认定的直接访问链路。
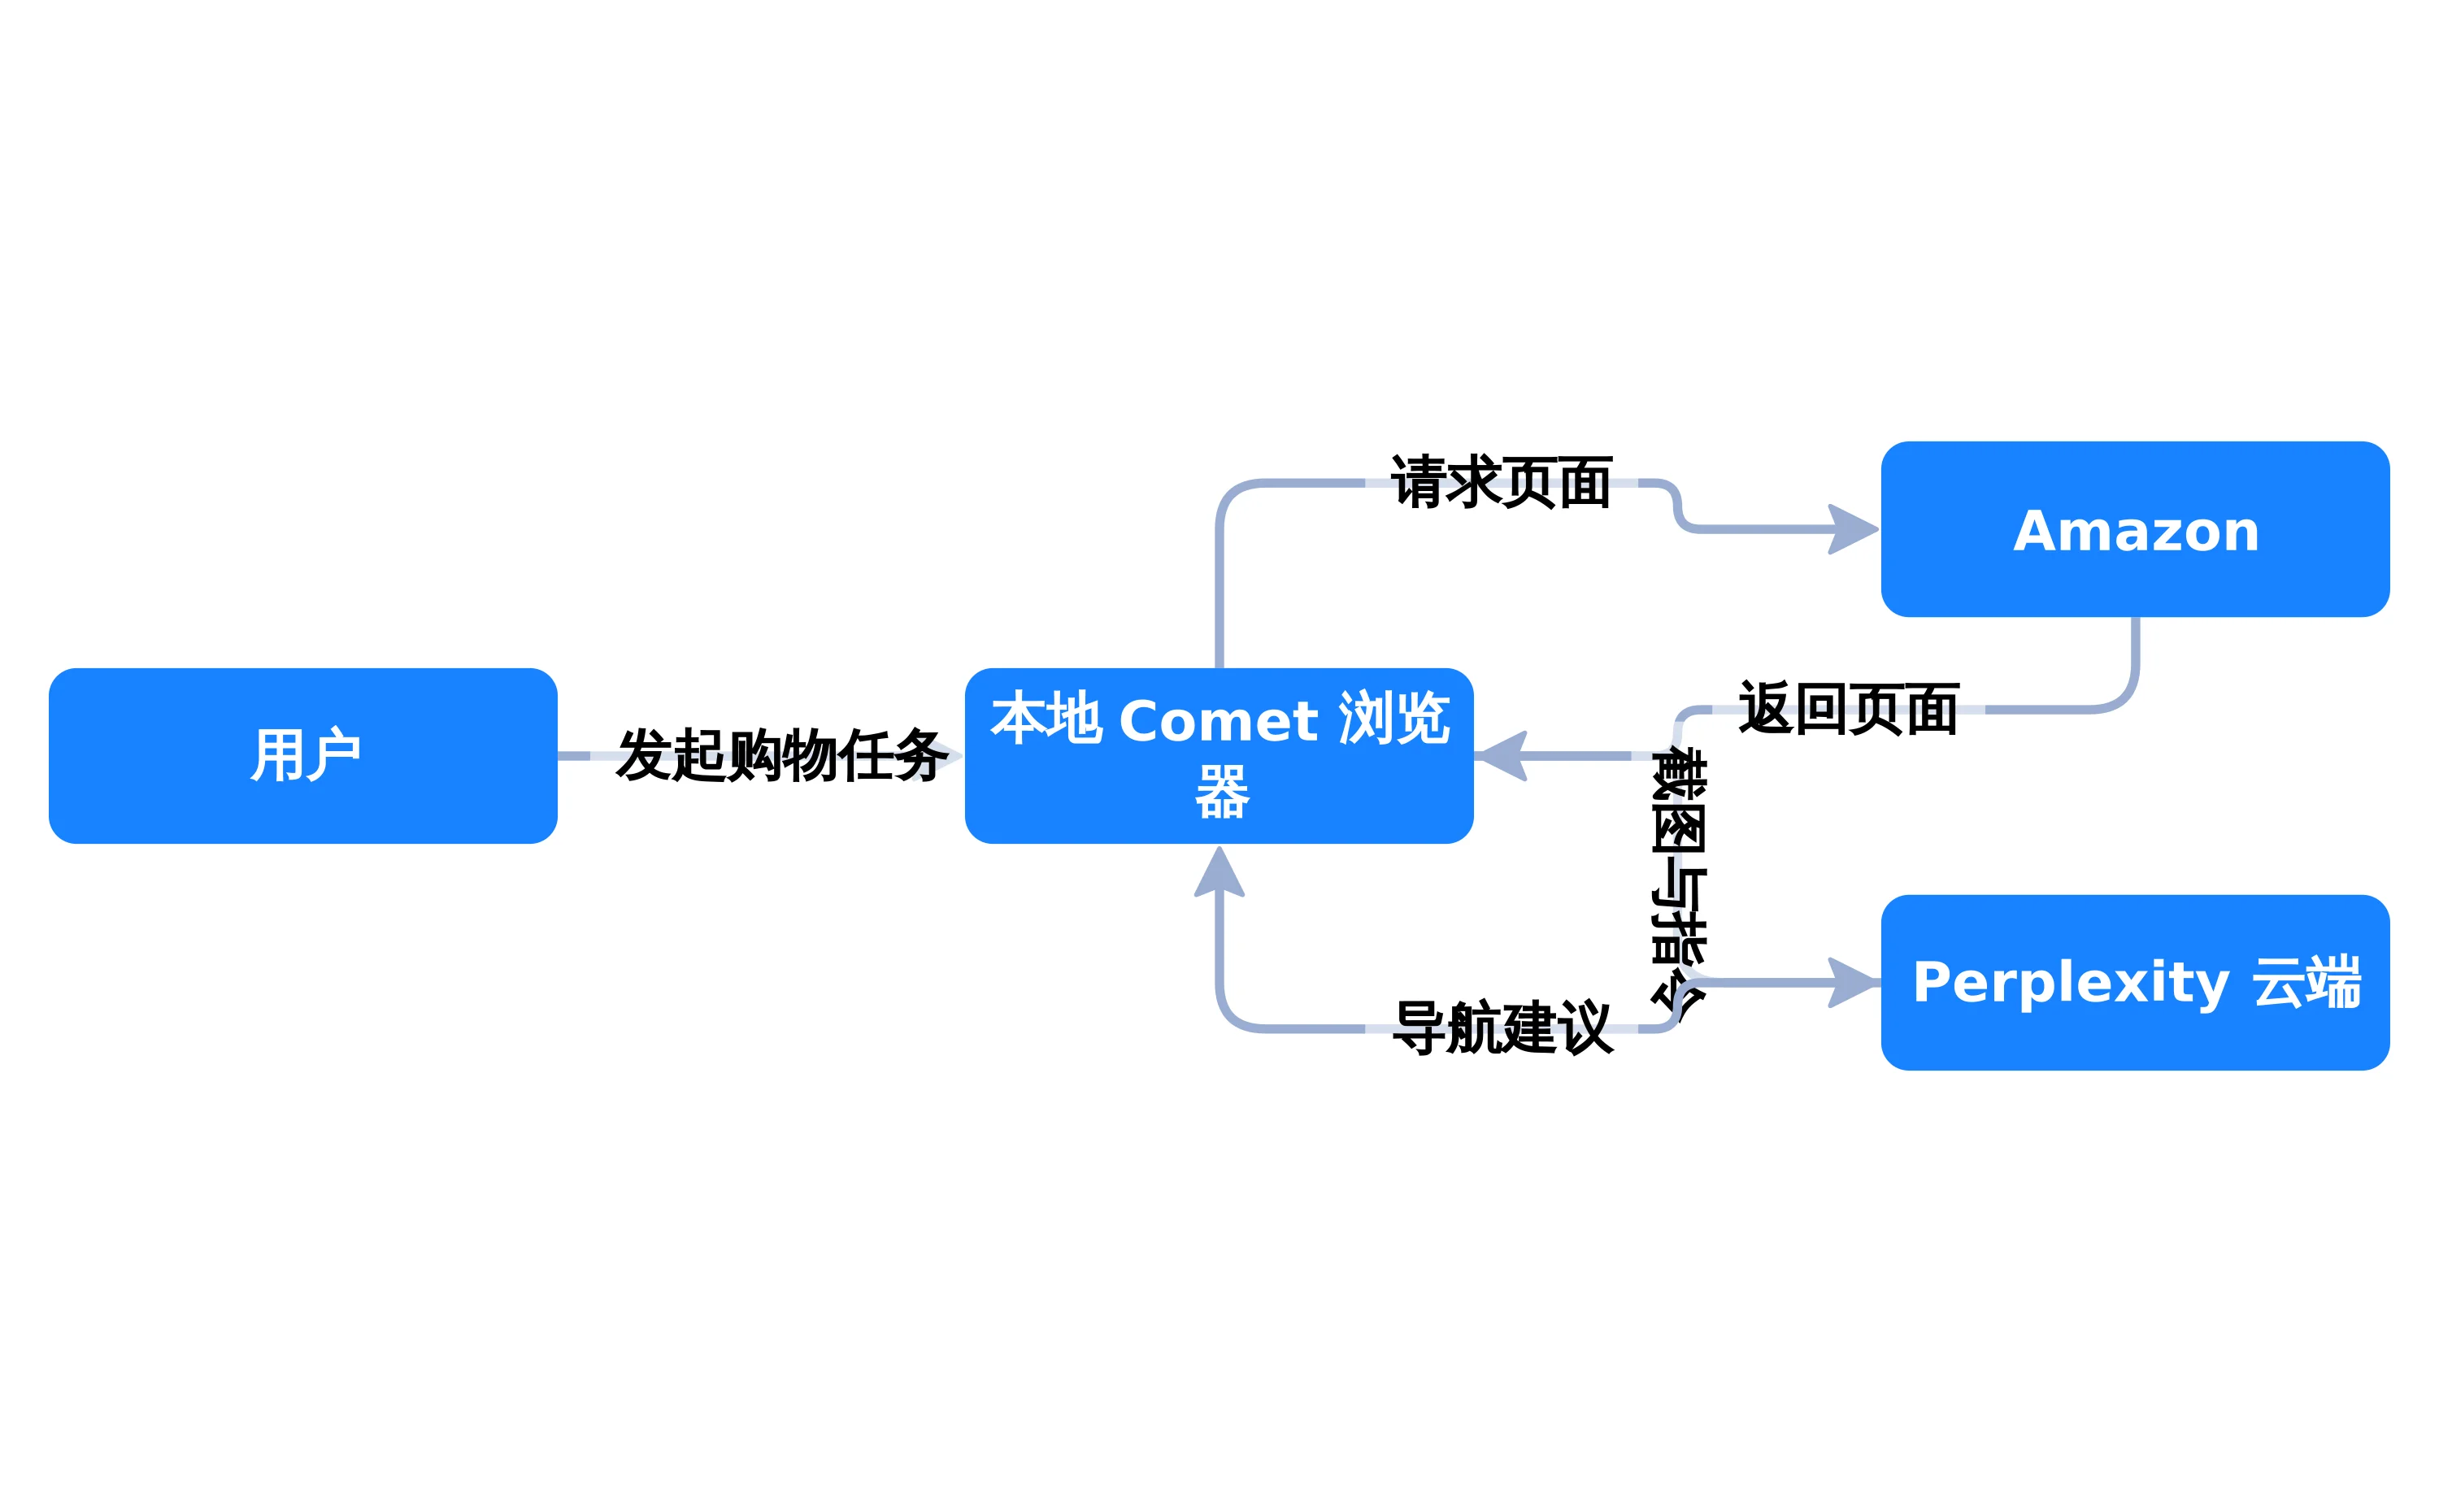
页面请求发生在本地浏览器与 Amazon 之间,Perplexity 云端接收截图并返回导航建议。
好家伙,平时画在技术方案里、经常被大家拖到评审前一晚才补的箭头,这回成了判决的支点。
先把一件事说清楚。Perplexity 这次只是赢下了初步禁令这一轮,不是整场官司已经大结局。法院撤销禁令,把案件发回继续处理,还专门提醒这份意见没有给所有 AI Agent 创造一套通用法律。换一组事实,换一种控制方式,结论都可能变。
但对做 Agent 的人来说,它依然很重要。
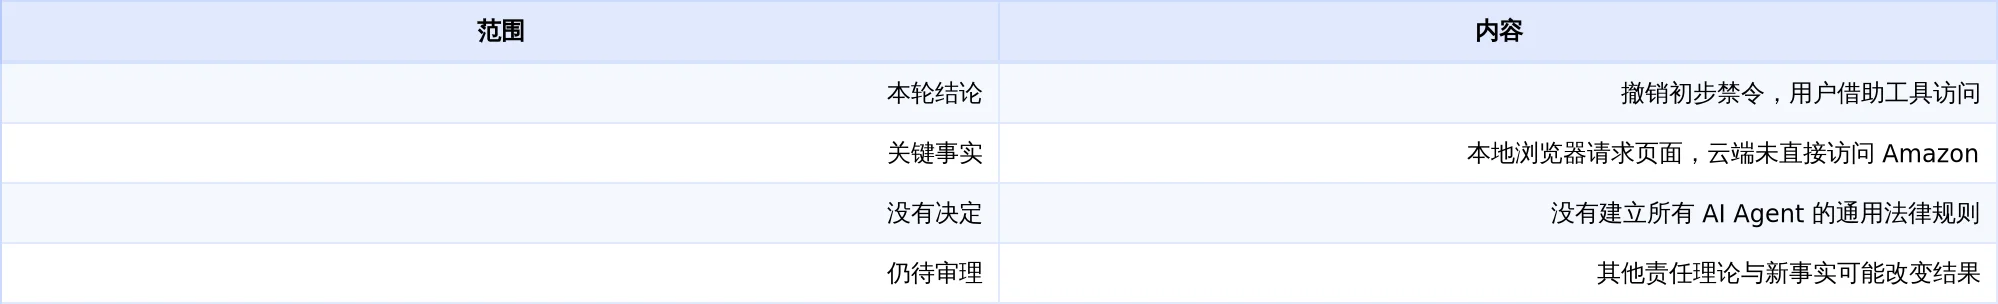
这轮判决撤销的是初步禁令,没有替所有 AI Agent 写一套通用规则。
因为法院第一次非常具体地告诉我们,Agent 的责任边界,不会只看产品文案里写了多少次「自主」,而会看请求从哪台机器发出、谁触发动作、云端控制到哪一步、日志能不能还原整条链。
Agent 看起来像谁,不如它实际上连了谁
AI 行业特别爱给软件加人格。
会思考,会规划,会自己逛网页,会替你做决定。发布会里多写两个「自主」,PPT 顿时就有了生命。棒棒的,仿佛再给它配个工牌,第二天就能去人事系统报到。
法院没跟这套叙事走。
判决把 Assistant 视作工具,然后把「访问」这个动作拆回网络与控制事实。Amazon 认为,Assistant 会接收 Perplexity 云端的指令,也能像熟练买手一样自己导航,因此它的行为应该算在 Perplexity 头上。Perplexity 则把它类比成浏览器自动填地址和付款信息,软件只是帮助用户完成已经授权的动作。
法院在这轮里接受了后一个方向。
它关注到,页面先由本地浏览器从 Amazon 取回,截图再从用户电脑发往 Perplexity。云端参与了决策,却没有因此自动变成直接访问 Amazon 的那一方。
这里有个很容易被忽略的区别。
控制一个工具,不等于已经进入另一个系统。
当然,控制强到什么程度会越过这条线,判决没有替行业画死。法院反而明确留了口子,如果未来证据显示 Perplexity 通过 Assistant 对远端系统施加了不同程度的控制,分析可能改变。
所以这不是「本地跑就永远安全」的免死金牌。别高兴太早。
它更像一次公开的架构评审。评审人拿着一部上世纪八十年代诞生的反黑客法律,顺着数据流一根线一根线地问。
请求是谁发的。
页面先到了哪里。
模型看见了什么。
动作由谁确认。
厂商能不能绕过用户单独行动。
这些问题,做生产 Agent 的团队迟早都得回答。
本地执行从产品卖点变成了证据
过去一年,很多 Agent 产品都喜欢强调「本地优先」。大家通常从隐私、延迟和成本理解它。
这份判决又加了一层。
本地执行还可能决定,系统在事实层面是谁的延伸。
如果浏览器真实运行在用户设备上,远端网站把响应发给用户,用户再选择把页面内容交给模型,这条链更接近「用户借助软件操作」。如果厂商在自己的云里登录用户账号,直接请求第三方服务,再把结果吐给用户,它就更像「厂商替用户操作远端系统」。
两种方案在产品页面上都可以叫购物 Agent。
在网络层,它们不是一回事。
在权限层,它们不是一回事。
现在看来,在争议发生后,它们也可能不是同一类证据。
我一直觉得,Agent 架构里最危险的词不是 autonomous,而是 seamless,也就是无缝。无缝意味着产品把边界藏得很好,用户感觉不到浏览器、云端模型、第三方网站和支付账户之间发生了几次权限交接。
体验确实顺了。
出事以后,所有人一起对着日志发呆。
一个真正能进生产的 Agent,不该只有漂亮的任务完成轨迹。它还要保留可还原的控制轨迹。用户什么时候发起任务,哪一步由本地执行,哪一步调用云端,模型返回了什么建议,真正的点击由谁提交,哪个动作不可逆,这些都得留下来。
不是为了把日志攒成一座没人看的数据坟场。
是为了有一天有人问「到底是谁做的」时,团队不用靠记忆和公关稿回答。
透明并没有因为胜诉变得不重要
这场案子里还有个很微妙的细节。
双方争议的一部分,是 Assistant 有没有用能够表明 AI Agent 身份的 user-agent string。user-agent string 可以理解成浏览器访问网站时递上的一张名片,告诉对方自己大概是什么客户端。Amazon 认为,如果 Agent 老实亮身份,平台就能识别并阻止它。
法院这次没有因为这件事把「访问」归到 Perplexity 头上。
但工程团队千万别读成「隐藏身份也没关系」。
法律上的访问主体是一条线,平台规则、合同、用户信任和安全治理是另外几条线。某一条暂时没把产品拦住,不代表剩下几条都消失了。
坦率讲,Agent 想被当成用户的工具,就更应该让用户知道它在做什么,也让被访问的平台看见这是不是自动化请求。你不能一边说「我只是用户手里的螺丝刀」,一边又把螺丝刀涂成手指的颜色,生怕门禁看出来。
这话听着有点刺耳,但长期看,Agent 生态需要一套比传统 user-agent 更细的身份与委托协议。
网站至少应该能知道,当前请求是人直接发起、传统脚本执行,还是由模型动态规划。Agent 也应该能证明,它拿到了哪个用户对什么任务、在多长时间内的授权。涉及付款、发信、删除数据这类高风险动作时,授权还得收窄到具体对象和金额,不能拿一句「帮我处理一下」当无限通行证。
现在这些信息常被塞进各家的私有日志里。
然后大家期待平台凭感觉判断。
有点子牛逼,也有点子危险。
美国《计算机欺诈与滥用法》原本是为了对付未经授权进入计算机系统的行为。第九巡回法院担心,如果把普通用户借助 Agent 浏览网站也扩成黑客行为,日常使用软件的人可能被卷进刑事责任理论。这个担心不难理解。
可平台也有真实问题。自动化流量会制造成本,Agent 可能误购商品,用户会把售后责任推回平台,厂商还可能故意伪装流量。
两边都不是纸老虎。
因此,下一阶段不会是 Agent 赢、平台输这么简单。更可能出现的是身份声明、委托凭证、动作分级、平台能力接口和审计记录一起长出来。浏览器 Agent 若继续靠模拟点击和隐藏身份穿过网页,冲突只会换个法院再来一遍。
做 Agent 的人现在该补哪几张图
我看完21 页判决 PDF,脑子里一直是那条截图回传链路。
它太像我们平时做系统设计时会一笔带过的部分。
前端截图交给模型,模型返回动作,本地执行器点一下。能跑,演示也顺,大家就去做下一项功能。直到安全评审问数据去哪了,法务问谁在访问,客服问误操作算谁的,才发现同一条链路有四种答案。
如果你也在做浏览器 Agent,我建议把现有架构图重新画一遍。不是画服务名,而是画「主体」。
每个外部请求旁边标清发起设备与账号。每次模型决策旁边标清它是建议还是可直接执行的命令。每个不可逆动作旁边标清是否需要用户再次确认。每段数据流旁边标清原始内容、截图、结构化结果和日志各自保留多久。
再做一个残酷的小测试。
假设三个月后只剩审计日志,没有任何开发者记得当时发生了什么。一个陌生人能不能从日志里回答,谁让 Agent 做了这件事,Agent 看到了什么,云端给了什么指令,真正的动作从哪台机器发出。
答不出来,说明系统现在靠的是团队记忆,不是工程证据。
这场官司的案卷还在继续。Amazon 也明确表示不同意判决,后面还会有新的事实与争论。The Decoder 的报道把它称作联邦上诉法院第一次处理 AI Agent 合法性的判决,这个标签很大,判决自己却写得很克制。
我反而喜欢这种克制。
它没有宣布 Agent 成了电子人,也没有假装旧法律已经理解所有新技术。它只是低头看了一眼线路,然后说,在目前这套系统里,访问者还是那个坐在电脑前的人。
模型可以越来越像同事。
责任边界不能靠拟人化来画。
把箭头画清楚,把权限留痕,把用户的委托做成可以验证的东西。浪潮再大,船是谁在开,至少别等撞上礁石才去翻日志。