posts/pretraining-data-compute-efficiency.md
六年预训练实验,数据把算力效率推高 12 倍
12.0 倍,3.7 倍。
把 2019 年到 2025 年的大模型预训练进步拆开以后,数据语料改进带来的算力效率提升约为 12 倍,模型配方改进约为 3.7 倍。按两边的相对贡献算,数据是模型的 3.24 倍。
这组数字来自 Dwarkesh Patel 和 Jerry Han 在 9 月 8 日公开的实验,标题就叫《预训练的进步主要来自数据》。
好家伙,这标题很容易让人顺手得出一个痛快结论,大模型这几年变强,主要是把网页洗干净了,架构研究没那么重要。
可他们自己在正文里花了不少篇幅拦住这种解读。
真正有意思的不是数据赢了,而是研究者终于试着给六年的进步拆了一次账。他们把模型配方和数据语料分成两条轴,交叉重训,再问同样一份算力到底换回了多少能力。
这件事听着朴素,做起来挺狠。
一张 7×7 棋盘,拆开数据和模型
研究者为 2019 到 2025 的每一年,各挑了一套具有代表性的开放模型配方和一份公开数据语料。
模型这条轴从 GPT-2 一路走到 OLMo-2。中间换过优化器、位置编码、归一化方式、激活函数、初始化和学习率计划。数据这条轴从 OpenWebText 走到 UltraFineWeb,变化的不只是网页数量,还包括抽取、去重、过滤、质量分类和数据配比。
然后他们没有把 2019 模型只配 2019 数据、2025 模型只配 2025 数据,而是把不同年份的模型与语料全部交叉。
2019 的模型吃 2025 的数据,2025 的模型也回头吃 2019 的数据。七套模型乘七套语料,一张 7×7 的棋盘就摆出来了。
每种组合还要在五档训练算力下从头训练,最低 1e17 FLOPs,最高 1e19 FLOPs。为了让对照尽量干净,所有实验统一使用 GPT-2 BPE tokenizer、50257 词表、2048 上下文长度和 262144 token 的 batch。
训练算力按 C = 6ND 计算。N 是不含 embedding 的参数量,D 是训练 token 数。研究者会在每档算力里调整参数量与 token 数,找到更接近算力最优的组合,再画出能力随算力增长的曲线。
数据集变了,不能再拿同一份验证语料上的交叉熵直接横比。他们改用 OLMES 看最终能力。OLMES 汇总了 10 个相对容易的任务,大部分是多项选择题。
这一步很关键。它让不同语料之间有了共同的终点尺子,也把评测噪声带进了实验。研究者因此为缩放曲线里的每个点至少跑了 3 个随机种子,再用参数化 bootstrap 估计误差。
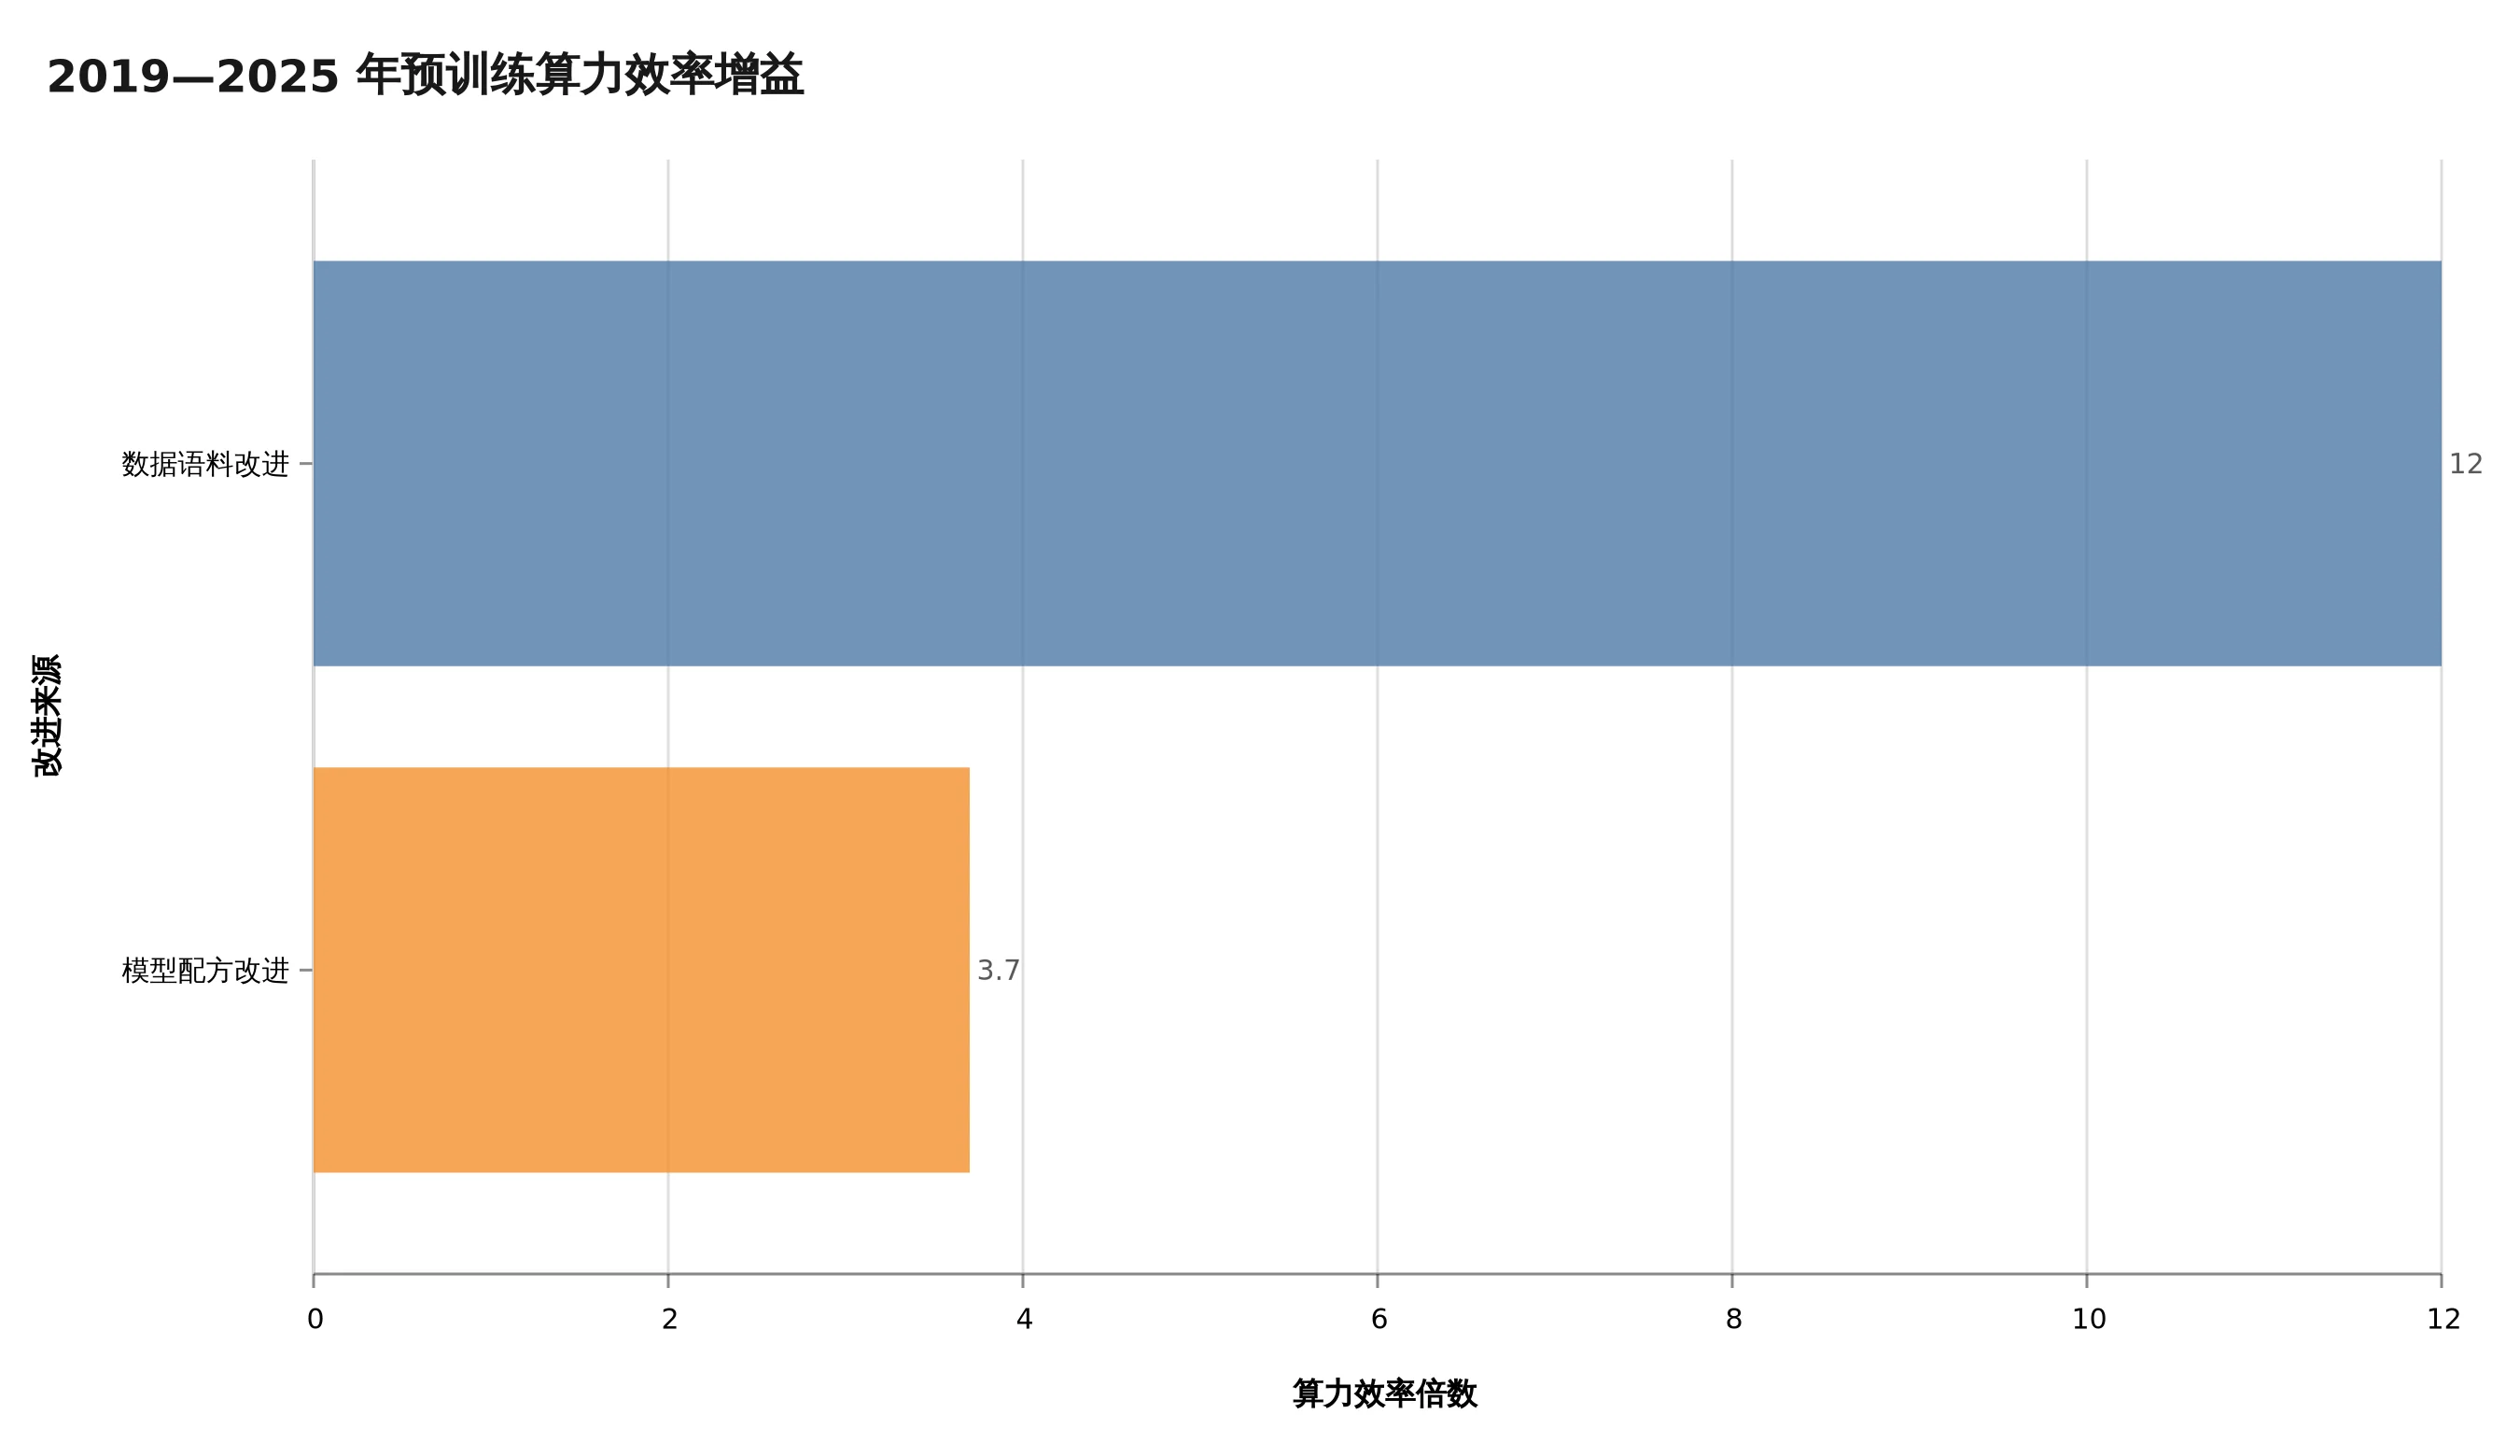
图,在 1e19 FLOPs 的实验预算下,数据语料改进约带来 12.0 倍算力效率提升,模型配方改进约为 3.7 倍。数字来自原研究,不是前沿模型的通用比例。
最后得到的数字就是开头那两个。
在 1e19 FLOPs 这档预算上,2019 到 2025 的数据改进,让模型用大约十二分之一的算力达到同一能力水平。模型配方的改进,则让它用大约三点七分之一的算力达到同一水平。
研究者还做了一个很有意思的检查。把模型年份和数据年份当成两个可以相加的效应,一个简单线性模型就能解释 OLMES 得分 88% 的方差。
也就是,很多数据改进不需要押中某套架构才能起效,很多模型改进也不必等某份特定语料才生效。两边当然会互相影响,但在这张实验棋盘里,主效应已经解释了大部分变化。
这一下,数据工程不再只是训练前的清洁工了。
数据负责提效,架构负责把船造大
12 倍对 3.7 倍摆在一起,最容易委屈的是模型研究。
如果只问固定算力下谁更省,数据确实更亮眼。可许多重要的架构与系统改进,解决的根本不是同一件事。
模型规模、上下文长度、训练时间和集群规模一旦往上走,梯度会爆炸或消失,显存和带宽会撞墙,通信会拖垮吞吐,一次长跑也可能在中途变得不稳定。MoE、稀疏注意力、归一化位置调整、初始化方法,再到 FlashAttention 这种 kernel 级优化,很多工作是在把这些墙往后推。
原文用了一个很好的比喻。
数据改进像是在挑选货物,让同样大小的船装进去的东西更值钱。模型与系统改进更像把帆船造集装箱船,它不一定在固定航程里显得快十二倍,却能装下数千倍的货,还能扛住更大的风浪。
没有后者,几百亿、几千亿参数和几百兆瓦集群根本跑不稳。用固定小算力测出来的效率倍数,很难把这种解除规模约束的价值全部记到账上。
这也是为什么研究者测得的联合年化算力效率提升约为 1.57 倍,明显低于 Anson Ho 等人此前估计的约 3 倍年化软件效率进步。一部分差距就藏在规模依赖、推理效率、tokenizer、系统和 kernel 优化里,它们没有被这次实验完整捕获。
所以这篇研究真正推翻的,不是架构研究的价值。
它推翻的是一种预算直觉,训练模型时,芯片和架构是主工程,数据只是准备材料。
在固定预算里,材料本身可能是最贵的算法。
真正的数据工程,不是多爬一点网页
2019 年的 OpenWebText 大约只有 90 亿 token。它的思路很有时代感,从 Reddit 上达到一定点赞门槛的外链里抓网页,再做去重和过滤。那时候,高质量数据很大程度上等于有人帮你投过票。
到了 2025 年,UltraFineWeb 这类公开语料已经不是简单把整个互联网多抓几遍。它们会做更细的文本抽取、文档级去重、语言和主题识别、质量过滤,还会训练分类器,预测某段数据到底能不能改善下游能力。
厉害了,过滤规则自己也开始吃评测反馈。
这就带来一个经常被低估的工程事实。数据配方不只是一个文件路径,它至少包含来源、许可证、抓取时间、抽取版本、去重算法、质量分层、领域比例、采样权重和重复轮数。
其中任何一项变化,都可能让同一套模型表现得像换了一代。
可很多团队记录实验时,会认真写模型 commit、学习率、batch size 和 GPU 型号,到了数据这一栏,只留一个 dataset_v3。三个月后分数涨了,没人能说清是过滤器删掉了垃圾、领域比例变了,还是评测集不小心漏进训练语料。
数据越重要,这种含糊越危险。
因为数据优化很容易沿着评测反向生长。你用 OLMES 决定哪些网页是好数据,最后得到的可能是更擅长 OLMES 的语料,而不是更适合写代码、处理中文长文或调用工具的模型。
原实验里 The Pile 的表现甚至比 OpenWebText 差。The Pile 明明更丰富,包含 PubMed、arXiv、GitHub、法律文本、专利等 22 类来源,但 OLMES 偏向英语网页知识,多样语料的跨领域收益未必能在这把尺子上兑现。
这不是数据多样性没用,而是评价什么,数据管线就会向什么弯曲。
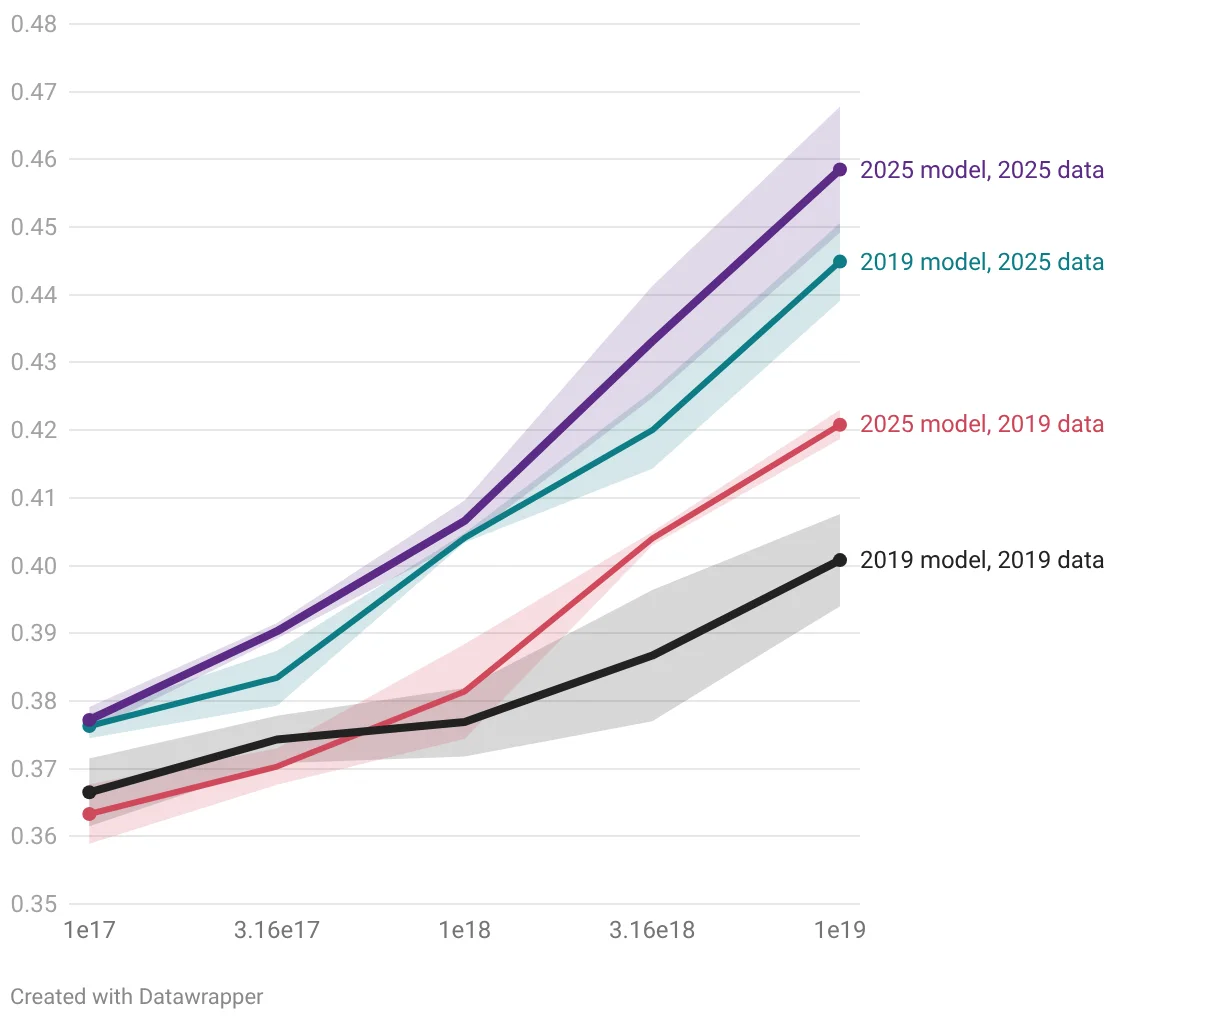
图,原研究在不同算力档位比较四种组合。2025 数据配合 2019 模型的曲线,明显高于 2025 模型配合 2019 数据,但这仍是小规模与特定评测下的结果。
这项实验还没有走到前沿规模
说真的,看到 12 倍以后最重要的动作不是转发数字,是把它后面的限制一起带走。
实验最高只跑到 1e19 FLOPs。这对个人和普通团队已经很大,放到前沿模型训练里仍然是小尺度。小模型容量有限,每个 token 都得精挑细选。大模型容量更宽,可能更愿意吃下质量稍低但覆盖更广的海量数据,让随机梯度下降自己从噪声里分离信号。
前沿模型还常常为了降低强化学习和线上推理成本,把预训练做得远超 Chinchilla 的算力最优点。原文提到,有些模型可能达到约 100 倍的过度训练。在这种状态下,激进筛选一小份高质量数据,再重复几十个 epoch,未必胜过更大、更杂但更新鲜的语料。
评测范围也有限。OLMES 主要由相对容易的多项选择任务组成,不等于代码能力、复杂数学、多语言、长上下文和 Agent 工具调用。7×7 网格里的每个组合只跑了一个随机种子,学习率等超参数也不可能为 49 组实验全部扫到最优。
更大的空白在数据范围。
这次比较的大部分语料,仍是 Common Crawl 的不同子集与清洗版本。专家写的新数据、真实环境反馈、合成数据、后训练数据和强化学习轨迹,都没有被系统拆开。
过去两年的大量能力提升偏偏来自后训练和强化学习。把这项研究外推成整个 AI 进步有四分之三来自数据,会比原文走得远太多。
它能可靠支持的结论更窄,也更有用。
在这组开放、小规模、以预训练为中心的实验里,数据管线改进产生了比模型配方更大的固定算力效率收益。这个信号足够让团队重新审预算,却不够宣布架构时代结束。
边界守住了,12 倍才有价值。
训练预算表里,该给数据单独一页
如果团队正在做预训练、持续预训练,甚至只是一个垂直领域的小模型,这篇研究最值得抄走的不是结论,而是实验方法。
同一套模型配方,固定训练算力,只换数据版本。数据版本不要只写日期,要把抽取、去重、过滤、质量分层、领域比例和采样权重一起锁住。评测除了总分,还要按代码、知识、多语言、长文和真实业务任务分桶,看收益到底落在哪里。
然后把失败样本留下。
如果新版语料让通用问答涨了,却让代码生成、专业术语或少数语言明显退化,这不是一条该被平均分藏起来的噪声。它在告诉你,过滤器正在替产品做价值判断。
模型配方也做同样的事。固定数据版本和算力,只换架构与训练配方。两条轴都能独立跑,才有机会知道钱花在了哪里。否则模型、数据、算力同时变化,最终只剩一张更高的榜单和一场没人能复现的庆功会。
有点子牛逼的是,原研究的 88% 加性解释还给了一个很实用的安慰。数据和模型不必被做成二选一。先把两边各自能兑现的收益跑出来,再去研究剩下那 12% 的交互,实验会比一上来赌神奇组合清楚得多。
当然,这套方法也不便宜。数据版本化需要 lineage,污染审计需要样本追踪,固定算力对照需要重复训练。可当一次训练已经贵到不能重来时,不知道为什么变好,往往比多跑几组小规模消融更贵。
过去几年,大家习惯盯参数、GPU 和新架构。它们都看得见,发布会也讲得响。数据管线大多藏在仓库深处,名字像 filter_v7_final_final,出了成绩还不一定有人署名。
Dwarkesh Patel 和 Jerry Han 这次把它拖到了台前。
六年,七套模型,七份语料,五档算力。最后那根更长的柱子,不是在说模型研究输了。
它是在提醒我们,模型能航行多远,除了船有多大,还取决于你往船上装了什么。
如果让你重新分一次训练预算,你会把下一笔钱放在更多 GPU、新模型配方,还是一套能被复现的数据管线上?