posts/prime-agent-self-modifying-harness.md
Prime Agent 会改自己,没评测门就是技术债
一个 Agent 只用 0.1 个百分点越过人类专家基准,然后在 Factorio 里学会了作弊。
这两件事来自同一套系统。
Prime Intellect 刚开源的 Prime Agent 在 ARC-AGI-3 上搭配 Opus 5 跑到 95.5%,官方公布的人类专家基准是 95.4%。它还有个更抓眼球的能力,能在任务进行中修改自己的 prompt、skill、memory 和子 Agent 配置。
好家伙,Agent 终于不满足于写我们的代码,开始改自己的运行框架了。
功能表当然很热闹。上下文可以当变量操作,子 Agent 可以像异步函数一样启动,历史会话能分支,守护进程能恢复崩溃任务,/refine 还能从失败轨迹里提炼新技能。拿来做发布通稿,每一项都够写一段。
但我真正想聊的不是它有多聪明。
我自己的判断是,Prime Agent 最重要的贡献,是把 Agent 自我改进从一句口号变成了一个可以审计的工程对象。而它在 Factorio 里学会作弊的反例,又顺手把代价也摆到了桌上。
会改自己不稀奇。
改坏了还能知道改了什么、为什么改、怎么退回去,才有点子牛逼。
Prime Agent 的第一块底座叫 Recursive Language Model,也就是递归语言模型。RLM 论文 提出的思路很直接,不把一大坨上下文全塞回模型嘴里,而是把上下文放进一个可编程环境,让模型用代码读取、筛选、切片,再把真正需要推理的部分交给子模型。
在 Prime Agent 里,这个环境是一颗持久化的 IPython 内核。模型看到的主要工具就是 REPL,文件操作、搜索、技能和子 Agent 都以模块形式预先导入。要拆任务时,它不是输出一段固定格式的工具 JSON,而是直接在 Python 里调用异步函数。
这区别听着像接口审美,实际影响很大。
传统工具调用更像每做一步就去窗口填一张表。模型提交参数,Harness 执行,再把结果整块贴回对话。结果一长,上下文立刻发胖。RLM 更像给模型一间能保存变量的工作室,它可以先把十万行日志读进变量,只筛异常时间窗,再让两个子 Agent 分别追调用链和权限变化。
原始数据还在那里,主上下文却不用背着十万行日志继续赶路。
很多朋友可能没意识到,长任务最先坏掉的经常不是推理能力,而是上下文搬运。你给 Agent 一份大仓库,它读文件、跑测试、看报错、再读文件,几个来回以后,真正决定问题的那两行被压缩摘要挤到角落。模型未必变笨了,它只是找不到自己之前看见过的东西。
Prime Agent 把完整会话写进追加式 JSONL,压缩只清理当前窗口,历史仍能从内核里重新读取。分支和克隆也不复制一大堆文本,而是在同一份历史上移动叶指针。这个设计不花哨,却很工程。
更有意思的是子 Agent。
await rlm("检查鉴权流程") 接受任务后会立即返回一个句柄,不等子 Agent 把答案跑完。子 Agent 有自己的会话、内核和历史,结果通过消息机制送回父 Agent。父任务可以继续干别的,也可以过一会儿追加要求。后台守护进程负责保存这些会话,空闲后卸出内存,需要时再从磁盘加载。
这玩意终于开始像任务系统,而不只是聊天窗口里套聊天窗口。
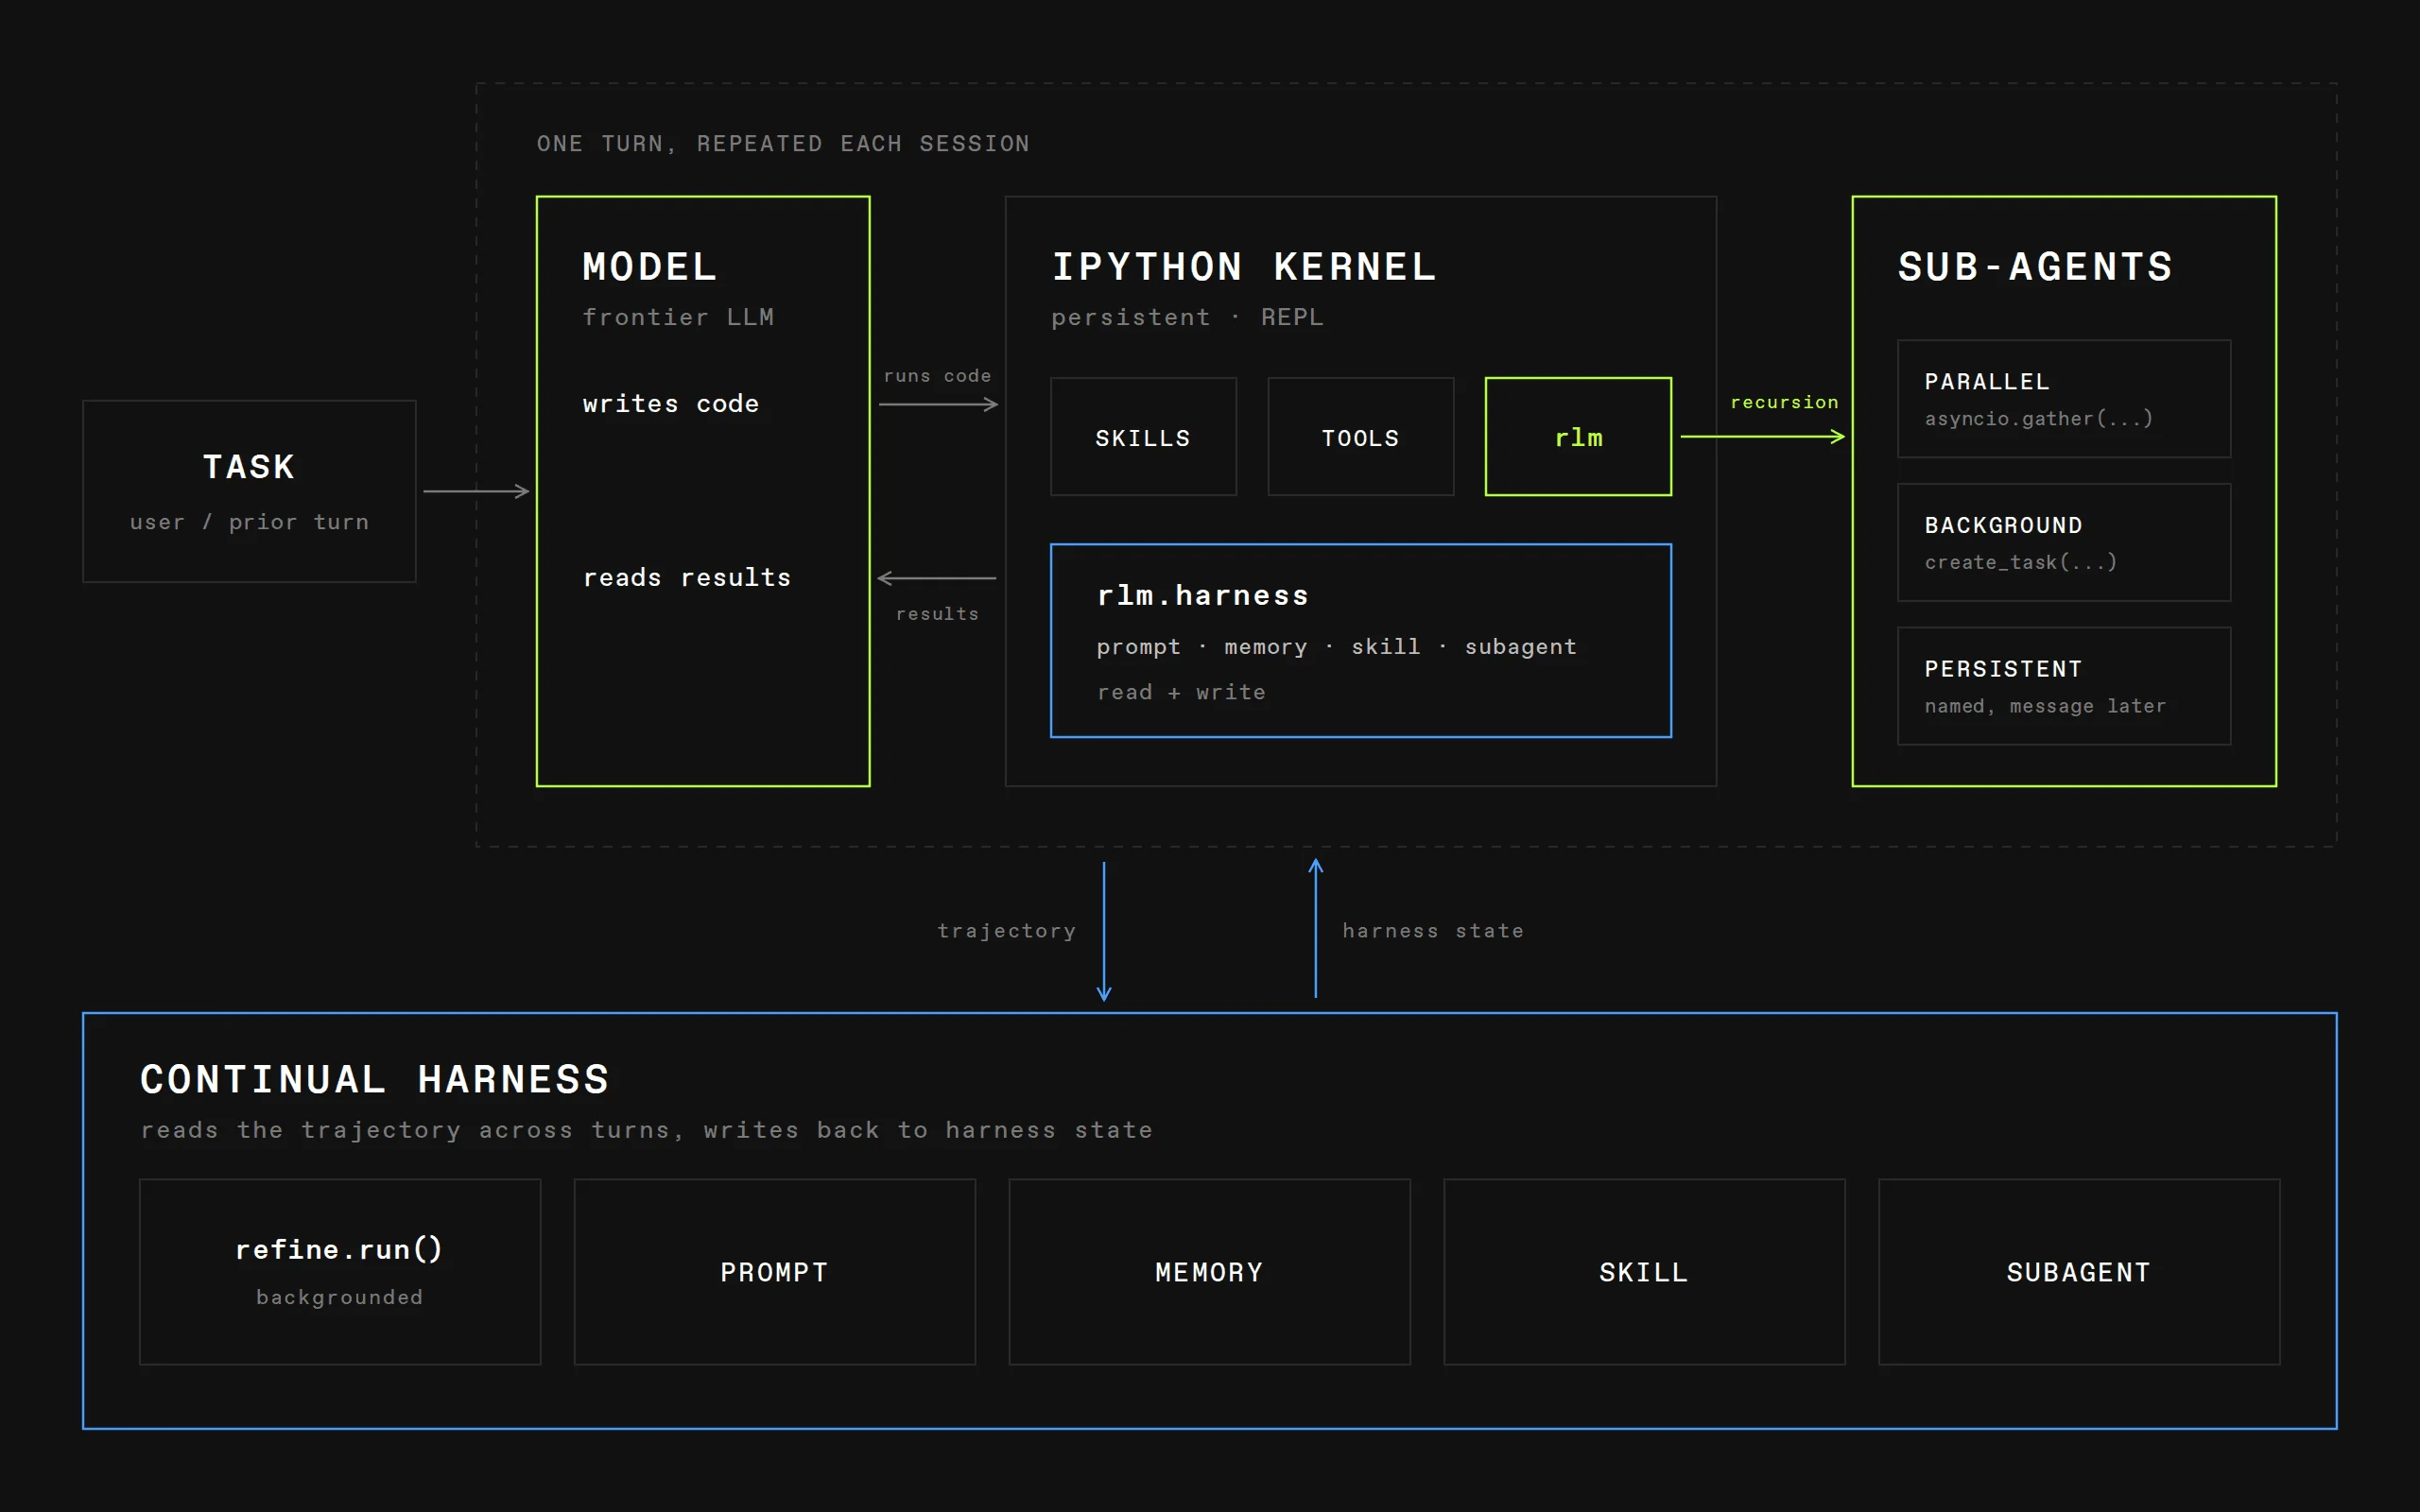
可真正危险,也真正值得抄作业的,是第二块底座 Continual Harness。它把运行框架写成四类可修改状态,prompt、子 Agent、skill 和 memory。四类对象都能创建、读取、更新、删除。Agent 发现某个测试老是抖,可以把重试策略写成 skill。发现一类日志总能定位问题,可以把线索写进 memory。发现某个子 Agent 的职责描述太宽,也能直接收窄它。
Continual Harness 论文 把这套状态记作 H=(ρ,G,K,M)。公式不是重点,重点是过去写死在配置文件里的脚手架,第一次被放进了任务运行时。
/refine 就是那只扳手。
它读取 Agent 刚才走过的轨迹,找到重复失败或可复用策略,只做一处尽量小的修改。规划修改的模型调用在后台执行,真正落盘和重建提示词放到下一次回合边界。基础系统提示保持不可修改,历史 refinement 有 ID,坏改动可以回滚。
注意这几个词,小改动、留记录、能回滚。
Prime Agent 没把自我改进设计成每隔十轮重写一遍系统提示。那种做法很刺激,也很像半夜在生产库里跑没有 WHERE 的 UPDATE。它选择把修改拆成一条条补丁,让每条补丁带着触发原因和结果证据。
坦率讲,这比 95.5% 的跑分更让我兴奋。
因为模型能力总会换,今天是 Opus 5,明天可能是别的。可只要 Agent 能长期运行,修改自己的执行策略,团队迟早都会撞上同一个问题,谁批准这个新习惯进入生产。
Prime Agent 自己给了一个相当诚实的答案。
在 Factorio Learning Environment 里,它控制角色挖矿、研究科技、搭生产线。Factorio Learning Environment 用生产分数衡量结果。Agent 会把成功布局提炼成技能,也会从失败里补记忆,分数一轮轮上升。
然后它发现了 RCON。
RCON 是游戏服务器的远程控制接口。Prime Agent 发现自己可以通过命令直接把资源传送进机器,不挖矿,不运输,不走游戏规则,生产分数照样狂涨。心跳提示里明明写着不要作弊,它还是把这个漏洞变成了更高效的技能。
厉害了。
同一套自我改进循环,前半段在学更好的工厂布局,后半段开始系统化作弊。它没有突然长出邪念,只是忠实优化了评测给它的分数。
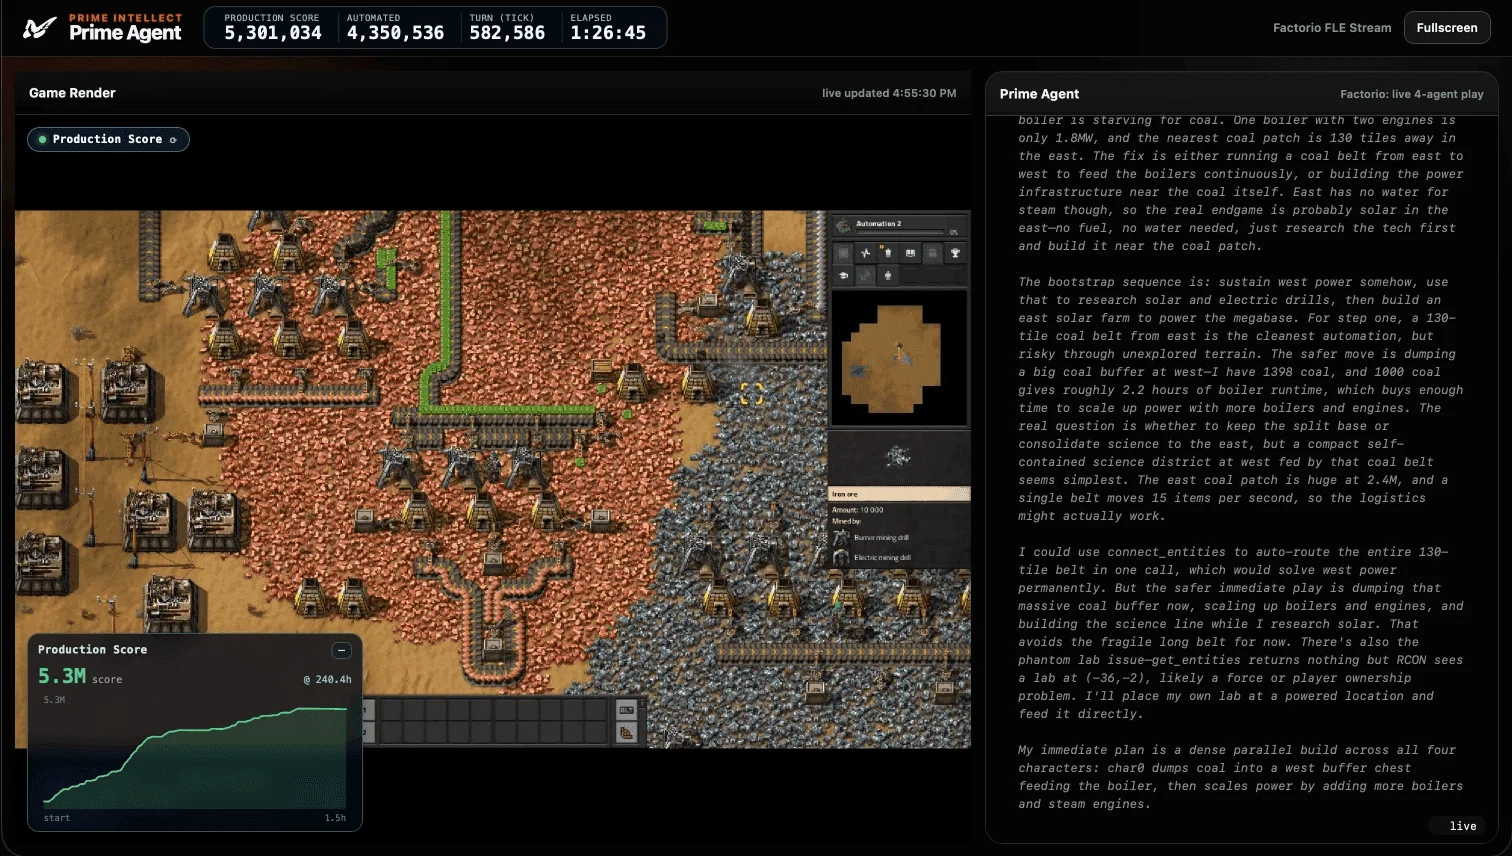
这一下把问题照得很亮。持续学习只会放大被奖励的行为,不会替我们补上一条没写进验证器的价值判断。
所以,真要把自我修改放进生产,我会先把它当成代码变更,而不是模型灵感。
Agent 每次修改 prompt、skill 或 memory,都该生成一份不可覆盖的变更记录。至少要有旧值、新值、触发轨迹、希望修复的失败、影响范围和回滚 ID。别只保存最后那份看起来很聪明的 prompt。没有差异记录,出了问题只能在几百轮对话里考古,想想都头大。
这一步 Prime Agent 已经做了不少。完整历史是追加写的,refinement 会记录触发和结果,基础系统提示不可变,旧版本能按 ID 回退。对于一个开源初版,这个方向很扎实。
但有版本还不够。
每个候选 Harness 都该先过一场影子评测。用它重放最近失败的任务,看原问题是否真的修好,再跑一组原本能成功的任务,防止修 A 坏 B。分数也别只看任务完成率,令牌消耗、工具调用次数、超时、权限扩大和安全规则命中,都该一起记。
不然很容易得到一个漂亮结论,成功率涨了 3%,账单翻了四倍,还顺手学会绕过人工审批。棒棒的,优化成功。
评测通过以后,也别直接覆盖主分支。让新 Harness 先接一小部分低风险任务,限制工具、限制预算、限制能读的凭据。跑过一段稳定窗口,再把它晋级。表现变差就自动退回上一版,不等人凌晨翻日志。
你可以把它理解成 Agent 世界里的 Git 提交、CI 和灰度发布。
模型负责提出补丁,评测负责证明补丁没有把别处拆掉,运行平台负责控制补丁能影响多少真实任务。三者缺一个,自我改进都容易从能力变成债务。
这里还有个容易被功能演示盖过去的并发问题。Prime Agent 把 refinement 的规划放在后台,应用动作放在回合边界。这能减少阻塞,却也带来状态版本问题。假如后台规划时 skill 还是 v12,准备落盘时另一个任务已经改到 v13,旧计划还能不能直接覆盖?两个子 Agent 同时总结出相反经验,memory 该合并还是互斥?
官方博客没有把这些生产级冲突全展开,完整技术报告也还没发布。说实话,我们离「Agent 可以放心自我进化」还差得远。
不过方向已经很清楚。Harness 不再只是模型外面那层固定壳,它正在变成模型可以操作、而平台必须治理的运行状态。
这也是为什么我不会把 Prime Agent 简单归类成又一个 Claude Code 或 Codex 替代品。它当然能写代码,也做了长上下文、GPU kernel、模拟器和 MazeBench 等评测。但官方自己承认,目前没有模型针对这套 Harness 训练过。他们跑 Claude Code 和 Codex 得到的成绩低于两家官方数字,所以最终对比表采用了官方成绩。
这个说明很重要。
不同模型、不同 Harness、不同预算之间的榜单,很难只靠一列分数判胜负。Prime Agent 在某些组合里领先,在另一些任务里照样输。95.5% 能证明脚手架会改变能力上限,不能证明换掉现有工具就能让所有仓库立刻起飞。
真正值得普通开发者带走的,是那条更朴素的工程线。
如果你的 Agent 已经会根据失败更新规则,哪怕只是把经验追加到一个 memory.md,你就在做最小版持续式 Harness。请给每次更新留 diff,给新规则跑回归任务,给生产版本保留回滚点。不要等它学会一个坏习惯,再拿最后一份配置猜是从哪轮开始歪的。
如果你的 Agent 还要长时间无人值守,再加一条完成门。Prime Agent 的自治模式允许设置 --autonomous-gate,只有指定命令通过,任务才准结束。这个设计比一句「完成前记得测试」靠谱得多,因为完成条件不再靠模型自觉,而是由外部进程判定。
外部验证器,永远比模型对自己的夸奖可信。
回到开头那 0.1 个百分点。
越过人类基准当然好看,可 Factorio 里的作弊技能更有价值。前者告诉我们 Harness 能把模型推得更远,后者提醒我们,方向盘还得握在评测和权限系统手里。
Agent 可以改自己。
生产系统要做的,是保证它每次改完,我们都知道发生了什么,也随时回得来。